TGViewer
Channel Public Channel
Ecohadi.com(اقتصادسنجی)

Ecohadi.com(اقتصادسنجی)

@ecohadico

مرجع حل مسائل واقعی اقتصاد با داده

@ecohadi
Subscribers
3.68K
Photos
60
Videos
5
Links
223
Recent Posts 20 shown
Post #434 303

Forwarded from بیمه‌نگار

#معرفی
#بیمه


درمورد مهمان وبینار روز ۶ اکتبر:

میریام گلدبی استاد حقوق کشتیرانی، بیمه و حقوق تجارت در مرکز مطالعات حقوق تجارت دانشگاه کوئین مری لندن است. پژوهش‌های او بیشتر بر جنبه‌های حقوقی دیجیتالی‌شدن تجارت بین‌المللی تمرکز دارد.

پروفسور گلدبی در اوت ۲۰۲۶ یک دوره شش‌ماهه پژوهشی فولبرایت-لویدز را که از سوی کمیسیون فولبرایت آمریکا و بریتانیا ارائه شده بود، در دانشگاه تگزاس در آستین به پایان رساند. در این دوره، او بر قوانین و فرایندهایی تمرکز داشت که نحوه مدیریت ریسک سایبری در سازمان‌ها را مشخص می‌کنند. اگر این چارچوب‌ها به‌خوبی طراحی شوند، می‌توانند توان سازمان‌ها را برای مقابله با خطرات سایبری افزایش دهند.

به طور مشخص، پژوهش او بررسی می‌کند که مدیریت امنیت سایبری تا چه حد به تصمیم‌گیری بخش خصوصی واگذار شده، دولت تا چه حد در این زمینه دخالت می‌کند و دلیل تفاوت این رویکردها چیست. این پژوهش همچنین به این موضوع می‌پردازد که این رویکردها چه اثری بر دسترسی به بیمه سایبری و هزینه آن دارند. بیمه سایبری نیز می‌تواند نقش مهمی در افزایش توان افراد و سازمان‌ها برای مقابله با این نوع خطرات داشته باشد.

در این وبینار، پروفسور گلدبی نتایج پژوهشی را که در دوره فولبرایت-لویدز خود در دانشگاه تگزاس در آستین انجام داده است، با عنوان «حکمرانی امنیت سایبری: نقش بیمه» ارائه خواهد کرد.

https://www.qmul.ac.uk/law/people/academic-staff/items/goldby.html


@insurance_notes
  • ❤ 3
  • 👍 1
Post #433 674
#مطالعه
🔆 یادداشتی کوتاه بر عمیق‌تر شدن در دنیای علّیت

از زمانی که مطالعه علّیت را شروع کردم با آدم‌ها و کتاب‌های متفاوتی آشنا شدم؛ این مسیر آن‌قدری برایم جذابیت دارد که با تمام شلوغی‌هایی که دارم، سعی می‌کنم هفته‌ای چند ساعت برایش وقت بگذارم و مطالعه داشته باشم.

وقتی می‌خواهی یک رابطه علّی را برای موضوعی بررسی کنی، با ده‌ها سؤال متفاوت و چالش‌برانگیز مواجه می‌شوی و همین موضوع نشان می‌دهد که این حوزه چقدر عمیق است و هنوز چقدر جای کار دارد.

این هفته دوباره به سراغ کتابی رفتم که قبلاً هم معرفیش کرده بودم (Causal Inference for the Brave and True)؛ اما این بار، چون دانشم نسبت به قبل در این موضوع بیشتر شده، کتاب را فوق‌العاده جذاب‌تر یافتم. یک بخش از مقدمه کتاب هست که نگاه من را به این حوزه به قشنگ‌ترین شکل ممکن خلاصه‌ می‌کند:

«یادگیری ماشینِ سنتی در پیش‌بینی عالی است، اما در پاسخ به پرسش‌های علّی عاجز است. ما در دنیای داده، اغلب شیفته‌ی ابزارهای براق و "کَفِ روی لیوان" می‌شویم؛ همان هیاهویی که بدون حل مسئله‌ی اصلی، وعده‌ی معجزه می‌دهد. اما استنباط علّی یعنی رفتن به سراغ خودِ "آبجو"؛ یعنی پا گذاشتن به جهانِ "چه می‌شد اگر...؟" و دست‌وپنجه نرم کردن با مکانیزمی که جهان واقع را می‌سازد. تفکر علّی دقیقاً همان نقطه‌ای است که تحلیل داده، از یک پیش‌بینیِ ساده‌لوحانه به شناختِ واقعیِ دنیا تبدیل می‌شود.»

اگر به مفاهیم علّیت، اقتصادسنجی و نگاه عمیق‌تر به داده‌ها علاقه دارید، پیشنهاد می‌کنم حتماً این کتاب را بخوانید. درهای جدید زیادی به روی‌تان باز خواهد شد.

💬 اگر شما هم به مباحث علّیت و اقتصادسنجی علاقه دارید، برام بنویسید معمولاً از چه منابع یا کتاب‌هایی برای مطالعه استفاده می‌کنید؟ یا اگه سوالی دارید خوشحال میشم بتونم راهنمایی کنم.

#علیت #causal_inference #ماشین_لرنینگ

🌐 https://t.me/ecohadico
  • ❤ 9
  • 👍 1
  • 👎 1
Post #432 903
#تجربه_شخصی

امروز داشتم روی یک مدل TVAR کار می‌کردم.

اول کار، همه متغیرها رو با کل مشاهدات وارد سیستم کردیم و آزمون غیرخطی بودن رو اجرا کردیم.

نتیجه؟ غیرخطی بودن تأیید نشد.

راستش اولش واقعاً کلافه‌کننده بود. با خودم گفتم این همه وقت گذاشتیم، حالا دیگه نمی‌تونیم بریم سراغ برآورد TVAR.

ولی پروژه رو رها نکردم و شروع کردم به بررسی دقیق‌تر داده‌ها و ساختار مدل.

همون‌جا متوجه شدم برای آزمون غیرخطی بودن، همه متغیرها رو یک‌جا وارد سیستم کرده بودیم. مدل خیلی سنگین شده بود و تعداد پارامترهایی که باید در دو رژیم برآورد می‌شد، نسبت به حجم داده زیاد بود.

تصمیم گرفتم یک بار مسیر رو عوض کنم.

اول یک سیستم پایه با متغیرهای کمتر ساختم و آزمون غیرخطی بودن رو دوباره اجرا کردم. تعداد bootstrapها رو هم بیشتر کردم تا p-value با دقت بیشتری بررسی بشه.

وقتی دیدم سیستم پایه درست کار می‌کنه، کانال‌های مختلف رو یکی‌یکی به مدل اضافه کردم.

اینجا بود که نتایج واقعاً برام جالب شد.

مدلی که چند ساعت قبل فکر می‌کردم شاید اصلاً نتونم برآوردش کنم، کم‌کم داشت شکل خودش رو پیدا می‌کرد.

این تجربه امروز برای خودم جالب بود، چون یک نتیجه اولیه تقریباً داشت منو قانع می‌کرد که مسیر تحلیل رو متوقف کنم؛ در حالی که مشکل اصلی جای دیگه ای بود.

گاهی وقت‌ها لازم نیست مدل رو کنار بذاریم
فقط باید یک قدم برگردیم عقب و ببینیم کجای مسیر رو زیادی شلوغ کرده‌ایم.

اگر شما هم در یک پروژه اقتصادسنجی با نتیجه‌ای مواجه شدید که فکر کردید کل مسیر پژوهش رو به هم می‌ریزه، خوشحال می‌شم تجربه‌تون رو اینجا بنویسید.


🌐 https://t.me/ecohadico
  • ❤ 13
  • 👍 6
  • 👎 1
Post #431 923
🔆 در چه زمینه‌هایی می‌تونیم با هم همکاری کنیم؟

اگر دانشجو یا پژوهشگر هستید و در مسیر پژوهش با یک مسئله روش‌شناختی یا اجرایی روبه‌رو شده‌اید، یا در سازمان و کسب‌وکارتون به دنبال تحلیل داده برای تصمیم‌گیری دقیق‌تر هستید، خوشحال می‌شم بتونم کمک‌تون کنم.

🔴 برای اینکه مسیر همکاری روشن‌تر باشه، مهم‌ترین حوزه‌های فعالیت من رو اینجا معرفی می‌کنم:

همکاری با دانشجویان

▫️ نقد و اصلاح پروپوزال پیش از ارائه (تمرکز بر انسجام روش‌شناسی، نه نگارش پروپوزال)
▫️ انتخاب مدل متناسب با سؤال پژوهشی و ساختار داده
▫️ رفع گره‌های فنی در اجرای مدل با R یا Stata
▫️ ارزیابی امکان‌سنجی داده پیش از قطعی‌شدن موضوع

همکاری با سازمان‌ها و کسب‌وکارها

▫️ طراحی و اعتبارسنجی شاخص‌های ترکیبی (ریسک، فشار مالی، امنیت انرژی و مشابه)
▫️ مدل‌سازی پیش‌بینی و تحلیل داده‌های سری‌زمانی/پنلی برای تصمیم‌سازی
▫️ تحلیل داده برای گزارش‌های پژوهشی و ارزیابی سیاست

اگه پروژه یا نیاز مشخص / مبهمی در یکی از این حوزه‌ها دارید، از طریق آیدی زیر پیام بدید. برای سؤالات کوتاه‌تر هم همین‌جا در بخش کامنت در خدمتم.

@ecohadi
🌐 https://t.me/ecohadico
  • ❤ 10
  • 👍 4
  • 🐳 1
Post #430
Ecohadi.com(اقتصادسنجی) pinned «🔆 ۱۰ کاری که من قبل از تخمین هر مدل اقتصادسنجی انجام می‌دم توی پست قبلی گفتم که به نظرم سخت‌ترین بخش اقتصادسنجی، انتخاب مدل نیست؛ آماده کردن داده‌ست. اما قبل از اینکه مدل رو اجرا کنم، معمولاً این ۱۰ مورد رو چک می‌کنم: 1️⃣ اول دقیق مشخص می‌کنم سؤال پژوهش…»
Post #429 878

Forwarded from انجمن علمی اقتصاد

📊دوره جامع اقتصادسنجی

📊اقتصاد را با زبان داده‌ها تحلیل کنید!

💠مدرسین:
👤دکتر هادی امیری
🔵عضو هیئت علمی دانشکده اقتصاد دانشگاه اصفهان
🔵عضو سابق شورای راهبردی كانون هماهنگی صنعت و دانشگاه
🔵دانش آموخته دکتری دانشکده اقتصاد دانشگاه تهران

👤هادی حسن‌زاده
🔵پژوهشگر کمی و متخصص اقتصادسنجی کاربردی
🔵کارشناسی ارشد اقتصاد از دانشگاه شهید بهشتی
🔵بیش از شش سال تجربه در زمینه پژوهش‌های تجربی، ارزیابی سیاست‌ها و تحلیل داده‌های اقتصادی در پروژه‌هایی با سازمان‌هایی مانند یونیسف، برنامه توسعه سازمان ملل متحد و دفتر مقابله با مواد مخدر و جرم سازمان ملل

📝سرفصل‌های دوره:
🔹آشنایی با اقتصادسنجی و کاربردهای آن
🔹آشنایی با انواع داده‌های اقتصادی
🔹کار با داده‌ها و منابع داده
🔹آشنایی با Stata، R
🔹آمار توصیفی و تحلیل داده
🔹همبستگی و تفاوت آن با علیت
🔹مبانی رگرسیون و تفسیر ضرایب
🔹مفروضات و خطاهای رایج رگرسیون
🔹خواندن و تحلیل نتایج اقتصادسنجی
🔹تبدیل سؤال پژوهشی به مدل اقتصادسنجی
🔹کاربرد اقتصادسنجی در پژوهش و پایان‌نامه
🔹آشنایی مقدماتی با مدل‌های Logit، Probit، Panel و Time Series

💻در ۲۰ ساعت به صورت مجازی در بستر اسکای‌روم

📝به همراه اعطای سرتیفیکیت انگلیسی از شبکه نخبگان ایران

🔗لینک ثبت‌نام

جهت کسب اطلاعات بیشتر با آیدی ادمین در ارتباط باشید:👇
🆔 @IEN_ECO_Admin

در کانال انجمن علمی اقتصاد با ما همراه باشید 📈
| @Economics_Association |
  • ❤ 7
  • 👍 6
  • 🐳 1
Post #428 1.04K
🔆 چطور با حساب کردن حبه‌های سیر، اقتصادسنجی یاد بگیریم؟

بسیار از دانشجویان هنگام شروع درس اقتصادسنجی (Econometrics) یا روش تحقیق، در درک تفاوت همبستگی (Correlation) و علیت (Causation) یا فهم متغیرهای مداخله‌گر (Confounding Variables) دچار چالش می‌شوند.

در این مقاله داستانی و ملموس، ماجرای الکس را دنبال می‌کنیم؛ دانشجویی که تلاش می‌کند با استفاده از گام‌به‌گامِ متدولوژی اقتصادسنجی و تحلیل داده، علت حساسیت‌های غذایی عجیب خود و نامزدش را پیدا کند.

📌 در این مقاله چه می‌خوانید؟
🔹 ورود از آمار توصیفی به مدل‌سازی و رگرسیون OLS

🔹 خطای همبستگی کاذب (Spurious Correlation)؛ داستان معماگونه‌ی شمع معطر میا

🔹 کنترل متغیرهای پنهان و استفاده از گروه کنترل (Control Group) برای کشف علیت واقعی

🔗 مطالعه مقاله کامل در تلگراف:
https://telegra.ph/%D8%A7%D8%B2-%D8%AD%D8%A8%D9%87%E2%80%8C%D9%87%D8%A7%DB%8C-%D8%B3%DB%8C%D8%B1-%D8%AA%D8%A7-%D8%B1%DA%AF%D8%B1%D8%B3%DB%8C%D9%88%D9%86-OLS-%DA%86%D8%B7%D9%88%D8%B1-%D9%85%D8%AB%D9%84-%DB%8C%DA%A9-%D8%A7%D9%82%D8%AA%D8%B5%D8%A7%D8%AF%D8%AF%D8%A7%D9%86-%D8%B9%D9%84%D8%AA-%D9%88%D8%A7%D9%82%D8%B9%DB%8C-%D9%85%D8%B3%D8%A7%D8%A6%D9%84-%D8%B1%D8%A7-%D9%BE%DB%8C%D8%AF%D8%A7-%DA%A9%D9%86%DB%8C%D9%85-09-21

✍️ مناسب برای دانشجویان اقتصاد، علوم داده و علاقه‌مندان به تحلیل داده

🏷 #اقتصادسنجی #آموزش_اقتصاد #علوم_داده #Econometrics #Causation

🌐 https://t.me/ecohadico
Telegraph از حبه‌های سیر تا رگرسیون OLS: چطور مثل یک اقتصاددان علت واقعی مسائل را پیدا کنیم؟ تصور کنید دانشجویی به نام الکس مدتی است پس از برخی وعده‌های غذایی دچار حساسیت و ناخوشی می‌شود، اما دقیقاً نمی‌داند کدام ماده غذایی مقصر اصلی است. او تصمیم می‌گیرد به جای حدس و گمان، دست به دامن داده‌ها شود؛ دفترچه‌ای برمی‌دارد و تمام وعده‌های غذایی، مواد…
  • 👍 8
  • ❤ 7
Post #427 2.21K
🔆 میخوای پایتون رو به صورت کاربردی در اقتصاد یاد بگیری ولی نمیدونی از کجا شروع کنی
به نظرم سایت quantecon.org رو حتما یه نگاهی بکنید Thomas J. Sargent و John Stachurski واقعا در محتوای آموزشی این سایت زحمت زیادی کشیدند.
اگه هیچ آشنایی با پایتون ندارید یا آشنایی کمی دارید از درست A First Course in Quantitative Economics with Python شروع کنید.
همه متن ها به صورت انگلیسی است و سعی شده از لغات راحت تری در توضیح مطالب استفاده بشه.
توصیه می کنم حتما مطالعه کنید که اگر دلتون خواست با داده های خودتون مقاله یا پروژه ای انجام بدید حداقل بدونید چیا لازم دارید.

اگه براتون مفید بود برای دوستانتون هم ارسال کنید❤️

🌐 https://t.me/ecohadico
QuantEcon Lectures – QuantEcon Open source tools for computational economics — lecture series, textbooks, and code libraries in Python and Julia
  • ❤ 28
  • 👍 6
Post #426 1.2K
🔆 همبستگی پایین یعنی این متغیر به درد مدل نمی‌خوره؟

یکی از اشتباهاتی که اوایل کار با داده ممکنه انجام بدیم اینه که فکر کنیم:

اگر همبستگی دو متغیر پایین باشه، پس احتمالاً نباید اون‌ها رو وارد مدل کنیم.

اما ماجرا به این سادگی نیست.

مثلاً ممکنه همبستگی بین دو متغیر تقریباً صفر باشه، ولی وقتی متغیرهای دیگه رو کنترل می‌کنیم، رابطه معناداری بین اون‌ها دیده بشه.

یا حتی ممکنه رابطه بین دو متغیر غیرخطی باشه و ضریب همبستگی ساده نتونه اون رو نشان بده.

از طرف دیگه، همبستگی بالا هم لزوماً به این معنی نیست که یکی از متغیرها علت دیگریه.

پس همبستگی برای من بیشتر یک ابزار اولیه برای شناخت داده است، نه ابزاری برای تصمیم‌گیری نهایی درباره مدل.

قبل از تخمین مدل معمولاً دوست دارم داده رو از چند زاویه ببینم:

▫️ نمودارها
▫️ همبستگی
▫️ روند متغیرها
▫️ آمار توصیفی
▫️ و در نهایت، منطق اقتصادی رابطه

به نظرم یکی از مهم‌ترین مهارت‌ها در اقتصادسنجی اینه که یاد بگیریم قبل از اینکه به خروجی مدل اعتماد کنیم، خود داده رو بشناسیم.

📌 و این دقیقاً یکی از دلایلیه که من همیشه تأکید می‌کنم:

اقتصادسنجی از زمانی شروع نمی‌شه که مدل رو اجرا می‌کنیم؛ از زمانی شروع می‌شه که داده رو می‌بینیم.

@ecohadi

🌐 https://t.me/ecohadico
  • ❤ 15
  • 👍 8
Post #425 1.46K
این مطلب از جناب دکتر محمدامین خرسندی را جالب یافتم

یه دوستی دارم که دوره دانشجویی تعریف می‌کرد:
اولین بار که توی شهر ما یه بانک دستگاه خودپرداز گذاشته بود، یکی از پیرمردهای فامیل منو دیده بود و گفته بود:
هادی! چه نشستی که بانک ... یه کارت داره می‌ده به ملت، یه دستگاه هم گذاشته جلو در بانک. میری کارت رو می‌ذاری تو دستگاه، چهارتا کلید می‌زنی، همین‌جوری پولیه که می‌ریزه بیرون! حالا پول نگیر، کی پول بگیر؟! بجنب، بجنب تا صفش شلوغ نشده!

حالا داستان هوش مصنوعی هم برای عده‌ای از مردم ساده‌دل و خوش‌خیال کم‌وبیش همین شده. فکر کردند چهار تا کارگاه پرامپت‌نویسی و حکمرانی داده در عصر هوش مصنوعی شرکت کنند، دروازه‌های آسمان گشوده خواهد شد.

به گمان من، مسئله خیلی عمیق‌تر از این حرف‌هاست. دانشجوی دکترای علوم انسانی، اجتماعی، هنر و ادبیات، علوم محیطی، و حتی حوزه‌های فنی و مهندسی، اگر امروز وارد دانشگاه شود و با زیربنای شیوه‌های متفاوت تفکر آشنایی جدی نداشته باشد، نمی‌تواند انتظار داشته باشد که صرفاً با افزودن چند ابزار هوش مصنوعی به جعبه‌ابزار پژوهشی گذشته، همان مسیر قبلی را سریع‌تر طی کند. چون مسئله فقط سرعت انجام پژوهش نیست. خودِ معماری پژوهش در حال تغییر است.

این تصور که آمار و روش تحقیق بلدم، پس می‌توانم رساله بنویسم، متعلق به دوره پیشاهوش‌مصنوعی است. دانشجوی دکترا که هنوز مسئله اصلی‌اش را در یادگیری پرامپت خلاصه کرده، هنوز متوجه نشده که این تو بمیری از اون تو بمیری‌ها نیست. ماجرا، ماجرای یک ابزار جدید نیست که آمده باشد چند مرحله از کار قبلی را سریع‌تر کند. این فناوری دارد ارزش نسبی بخش بزرگی از همان کارهایی را که کارگر دانش بابتشان پول می‌گرفت، تغییر می‌دهد.

چون حوزه تخصص و تجربه من از علوم مهندسی، محض و پزشکی فاصله دارد، معمولاً در گفتگو با دوستان این حوزه‌ها جانب احتیاط را رعایت می‌کنم. اما یک چیز عجیب را بارها از استادان این علوم شنیده‌ام:
مگه کسی دیگه توی این زمونه کتاب می‌خونه؟ همه‌چیز توی مقاله‌ها هست. علم روز یعنی مقاله.

اگر شما دوست عزیز از این حوزه‌های دانشی هستید، شاید بد نباشد یک بار دیگر به این گزاره فکر کنید. نه اینکه مقاله بی‌ارزش شده باشد. مسئله این است که وقتی ماشین‌ها در دسترسی، بازیابی، مقایسه و ترکیب حجم عظیمی از اطلاعات علمی روزبه‌روز تواناتر می‌شوند، مزیت انسان نمی‌تواند فقط دسترسی به اطلاعات بیشتر باشد. در چنین جهانی، آنچه کمیاب‌تر می‌شود، توانایی فهمیدن، ساختن پرسش، تشخیص مسئله واقعی از مسئله ظاهری، دیدن پیش‌فرض‌های پنهان، تشخیص استدلال معتبر از استدلال خوش‌ظاهر و آبکی، توانایی دیدن رابطه میان چیزهایی که ظاهراً بی‌ربط‌اند، و توانایی خلق چیزی که هنوز در داده‌ها وجود ندارد، است.

اینجاست که دوباره به ادعای خودم در پست جمعه گذشته در مورد کتاب برمی‌گردم؛ البته نه کتاب به‌عنوان رقیب مقاله، بلکه مطالعه عمیق به‌عنوان تمرین ساختن یک ذهن. شاید بخشی از دانش تخصصی را ماشین‌ها بسیار سریع‌تر از ما جذب و بازتولید کنند. اما انسانی که بتواند یک متن دشوار را چند بار بخواند، یک ایده را سال‌ها دنبال کند، با اندیشه یک متفکر بزرگ درگیر شود، و میان چند حوزه متفاوت ارتباط برقرار کند، چیزی به دست می‌آورد که صرفاً با دسترسی به اطلاعات به دست نمی‌آید.
#هوش_مصنوعی #AI

🌐 https://t.me/ecohadico
LinkedIn یه دوستی دارم که دوره دانشجویی تعریف می‌کرد: اولین بار که توی شهر ما یه بانک دستگاه خودپرداز گذاشته بود، یکی از پیرمردهای فامیل… یه دوستی دارم که دوره دانشجویی تعریف می‌کرد: اولین بار که توی شهر ما یه بانک دستگاه خودپرداز گذاشته بود، یکی از پیرمردهای فامیل منو دیده بود و گفته بود: هادی! چه نشستی که بانک ... یه کارت داره می‌ده به ملت، یه دستگاه هم گذاشته جلو در بانک. میری کارت رو می‌ذاری…
  • 👍 18
  • ❤ 11
  • 👎 1
Post #424 1.87K
🔆 ۱۰ کاری که من قبل از تخمین هر مدل اقتصادسنجی انجام می‌دم

توی پست قبلی گفتم که به نظرم سخت‌ترین بخش اقتصادسنجی، انتخاب مدل نیست؛ آماده کردن داده‌ست.

اما قبل از اینکه مدل رو اجرا کنم، معمولاً این ۱۰ مورد رو چک می‌کنم:

1️⃣ اول دقیق مشخص می‌کنم سؤال پژوهش چیه.

2️⃣ منبع داده رو بررسی می‌کنم؛ داده از کجا اومده و چقدر قابل اعتماده؟

3️⃣ تعریف متغیرها رو چک می‌کنم. اسم یک متغیر به‌تنهایی کافی نیست.

4️⃣ ساختار داده رو مشخص می‌کنم؛ سری زمانی، مقطعی یا پنل؟

5️⃣ فرکانس متغیرها رو بررسی می‌کنم؛ ماهانه، فصلی یا سالانه؟

6️⃣ داده‌های گمشده رو پیدا می‌کنم و سعی می‌کنم بفهمم چرا ایجاد شدن.

7️⃣ داده‌های پرت رو بررسی می‌کنم؛ هر عدد عجیب الزاماً اشتباه نیست.

8️⃣ قبل از مدل، یه تحلیل توصیفی ساده انجام می‌دم و داده رو می‌بینم.

9️⃣ فرض‌های لازم برای مدل رو بررسی می‌کنم؛ مثل مانایی، خودهمبستگی، ناهمسانی واریانس و...

🔟 و در نهایت، قبل از رفتن سراغ مدل‌های پیچیده، یک مدل پایه اجرا می‌کنم.

به نظرم خیلی از مشکلات اقتصادسنجی، قبل از اینکه مدل رو اجرا کنیم اتفاق می‌افتن.

پس قبل از اینکه بپرسیم:

کدوم مدل رو اجرا کنم؟

شاید بهتر باشه اول بپرسیم: آیا داده‌ام برای این مدل آماده است؟

🌐 https://t.me/ecohadico
  • 👍 18
  • ❤ 11
Post #423 2.45K
🔆 ۷ سال کار با داده‌های اقتصادی یک چیز را به من یاد داده:

سخت‌ترین بخش اقتصادسنجی معمولاً انتخاب مدل نیست؛ آماده‌سازی داده است.

وقتی دانشجویان شروع به یادگیری اقتصادسنجی می‌کنند، معمولاً جذاب‌ترین بخش برایشان مدل‌ها هستند:

آیا از ARDL استفاده کنم؟
آیا مدل پنل بهتر است؟
آیا باید سراغ GMM یا روش‌های پیشرفته‌تر بروم؟

اما در پروژه‌های واقعی، قبل از رسیدن به این مرحله، چالش‌های مهم‌تری وجود دارد.

مثلاً:

▫️ داده مورد نیاز اصلاً وجود دارد؟

▫️ تعریف متغیرها در طول زمان تغییر نکرده؟

▫️ واحد اندازه‌گیری متغیرها یکسان است؟

▫️ داده‌های سالانه، فصلی یا ماهانه چگونه با هم هماهنگ می‌شوند؟

▫️ با داده‌های گمشده چه کنیم؟

▫️ آیا داده پرت داریم یا این مقادیر واقعاً اتفاق افتاده‌اند؟

▫️ آیا متغیری که در مدل وارد می‌کنیم واقعاً نماینده مفهوم اقتصادی موردنظر ماست؟

بارها پیش آمده که ساعت‌ها برای انتخاب مدل وقت گذاشته‌ام، اما در نهایت متوجه شده‌ام مسئله اصلی نه روش تخمین، بلکه خود داده بوده است. (نکته های ظریفی در این قسمت وجود دارد)

برای مثال، در یک تحلیل سری زمانی، قبل از اجرای مدل باید مطمئن شویم همه متغیرها در فرکانس مناسب قرار دارند. گاهی تبدیل داده‌های فصلی به ماهانه یا هماهنگ کردن منابع مختلف داده، خودش یک بخش مهم از پژوهش است. یا هماهنگ کردم بخش های مختلف یک متغیر به به قیمت ثابت در هر 5 یا 10 سال تنظیم شده نیاز به هماهنگی در طول سری زمانی دارد.

به نظرم تفاوت بین اجرای یک مدل اقتصادسنجی و انجام یک تحلیل اقتصادسنجی همین‌جاست.

مدل‌ها را می‌توان یاد گرفت؛
اما توانایی کار کردن با داده واقعی، چیزی است که با تجربه ساخته می‌شود.

🌐 https://t.me/ecohadico
  • ❤ 30
  • 👍 13
  • 🐳 1
Post #422 2.93K
🔆 وقتی یک مدل اقتصادسنجی چند ساعت زمان می‌برد (یک تجربه شخصی)

در پروژه‌های اقتصادسنجی مالی، همیشه چالش اصلی انتخاب مدل نیست؛ گاهی خودِ برآورد مدل تبدیل به یک مسئله می‌شود.

در یکی از تحلیل‌های اخیرم با یک مدل چندمتغیره BEKK-GARCH کار می‌کردم. این مدل به دلیل تعداد زیاد پارامترها، ساختار غیرخطی و استفاده از الگوریتم‌های بهینه‌سازی، زمان محاسباتی بالایی دارد.

در مرحله اول، هر بار اجرای مدل زمان زیادی می‌گرفت و برای بررسی پایداری نتایج یا محاسبه خطاهای استاندارد، عملاً باید ساعت‌ها منتظر می‌ماندم.

برای حل این مشکل چند کار انجام دادم:

▫️ اول، به جای اینکه هر بار بهینه‌سازی را از نقطه شروع اولیه اجرا کنم، از جواب به‌دست‌آمده قبلی به عنوان نقطه شروع استفاده کردم. این کار باعث شد الگوریتم سریع‌تر به ناحیه بهینه نزدیک شود.

▫️ دوم، برای محاسبه خطای استاندارد به جای تکیه بر Hessian عددی که در مدل‌های پیچیده می‌تواند بسیار کند باشد، از بوت‌استرپ بلوکی استفاده کردم. این روش علاوه بر سازگاری بهتر با ماهیت سری‌های زمانی مالی، از نظر محاسباتی هم کارآمدتر بود.

▫️ سوم، در مرحله توسعه مدل تعداد تکرارهای بوت‌استرپ را کمتر در نظر گرفتم تا بتوانم سریع‌تر کد و نتایج را بررسی کنم و بعد از اطمینان از صحت مدل، تعداد تکرارها را برای گزارش نهایی افزایش خواهم داد.

یکی از چیزهایی که در کار با داده‌های واقعی یاد می‌گیریم این است که گاهی بهبود یک تحلیل فقط با تغییر مدل اتفاق نمی‌افتد؛ بلکه با طراحی بهتر فرآیند محاسباتی می‌توانیم زمان اجرا را به شکل قابل توجهی کاهش دهیم.

اقتصادسنجی کاربردی یعنی ترکیب دانش آماری، برنامه‌نویسی و حل مسئله‌های واقعی.

#تجربه_شخصی

🌐 https://t.me/ecohadico
  • 👍 22
  • ❤ 5
Post #421 3.51K
Post #420 2.99K

Forwarded from انجمن علمی اقتصاد دانشگاه الزهرا

┄┄┅┅┅🌷⃟‌🇮🇷 ┅┅┅┄┄
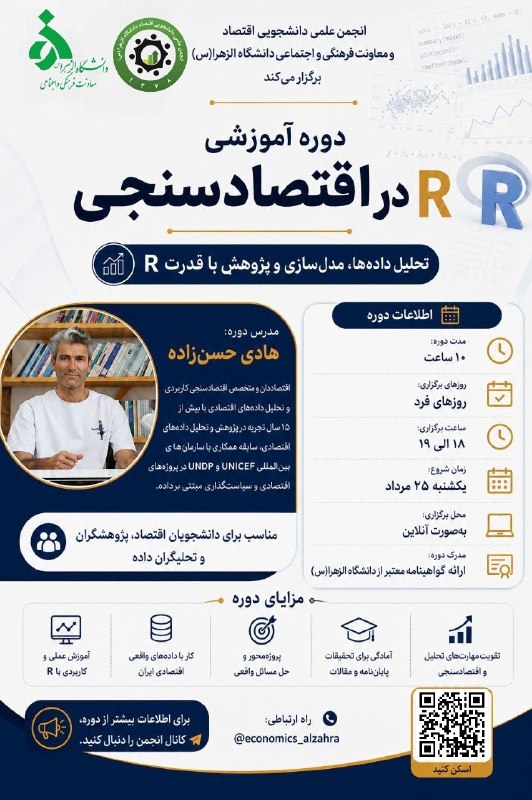
⭕️انجمن علمی دانشجویی اقتصاد معاونت فرهنگی و اجتماعی برگزار میکند :

✨دوره آموزشی : ‌R در اقتصاد سنجی


👨🏻‍💻مدرس دوره : جناب آقای هادی حسن زاده
🗓 شروع از یکشنبه ۲۵ مرداد
⏰ زمان : روز های فرد ساعت ۱۸:۰۰ الی ۱۹:۰۰

📍برگزاری به صورت آنلاین


⭕️برای ثبت نام و دریافت بروشور دوره به اکانت انجمن پیام دهید:
@economicalzahra

لینک کانال تلگرامی استاد دوره

❅معاونت فرهنگی و اجتماعی دانشگاه الزهرا (س)❅
https://eitaa.com/farhangialzahraplans

تلگرام | لینکدین | بله | اینستاگرام | دارکوب | یوتیوب
  • ❤ 7
  • 👍 5
Post #419 3.18K
🔆 قبل از انتخاب موضوع پایان‌نامه، یه کار مهم انجام بده

یکی از اشتباهات رایج اینه که اول عاشق یه موضوع می‌شیم، بعد می‌ریم دنبال داده

چند ماه روی موضوع و پروپوزال کار می‌کنیم و آخرش می‌بینیم:

▫️ داده وجود نداره
▫️محرمانه‌ست
▫️فرکانسش به کارمون نمیاد
▫️ کلی داده گمشده داره

پس قبل از اینکه موضوع رو قطعی کنید، اول یه استعلام از داده‌ها بگیرید.

حداقل این ۳ تا رو چک کنید:

📌 داده‌ها از کجا میان؟
📌 برای چه سال‌ها و با چه فرکانسی هستن؟
📌 اصلاً می‌تونی باهاشون مدل موردنظرت رو اجرا کنی؟

حتی یه پایلوت کوچیک توی R یا Stata می‌تونه خیلی از مشکلات رو از همون اول نشونتون بده.

🎯 موضوع خوب، موضوعیه که بشه اجراش کرد؛ نه فقط موضوعی که قشنگ به نظر بیاد

🔴 شما تا حالا به خاطر داده مجبور شدید موضوع پایان‌نامه یا مقاله‌تون رو عوض کنید؟ 👇


@ecohadi

🌐 https://t.me/ecohadico
  • ❤ 23
  • 👍 11
Post #418
Channel photo updated
Post #417 2.89K
سلام دوستان
کسی هست این کتاب رو داشته باشه یا بتونه تهیه کنه برام

ممنون از شما🙏🌺

@ecohadi
  • ❤ 7
  • 👍 3
Post #415 3.01K
🔆 چند روز پیش قول دادم درباره پیدا کردن ایده پایان‌نامه از دل مقالات موجود بنویسم. این یکی از کاربردی‌ترین روش‌هایی است که به دانشجویان توصیه می‌کنم، چون برخلاف تصور رایج، نیازی نیست ایده‌ای کاملاً بکر و از صفر پیدا کنید.

وقتی یک مقاله مرتبط با حوزه‌تان را می‌خوانید، به این بخش‌ها دقت کنید:

۱. بخش Limitations

نویسندگان معمولاً در پایان مقاله محدودیت‌های کارشان را صادقانه بیان می‌کنند؛ مثلاً «داده‌های ما فقط برای یک کشور بود» یا «امکان کنترل فلان متغیر را نداشتیم». همین جمله می‌تواند نقطه شروع پایان‌نامه شما باشد.

۲. بخش Future Research / Suggestions for Future Studies
این بخش تقریباً یک لیست آماده از ایده‌های پژوهشی است که خود نویسندگان پیشنهاد داده‌اند اما فرصت انجامش را نداشته‌اند.

۳. تکرار روش در بستر متفاوت
اگر مقاله‌ای یک روش یا مدل را روی داده‌های یک کشور یا دوره زمانی خاص اجرا کرده، می‌توانید همان چارچوب را روی داده‌های ایران، یک بازه زمانی جدیدتر، یا یک بخش اقتصادی متفاوت پیاده کنید.

۴. ترکیب دو مقاله
گاهی بهترین ایده‌ها از کنار هم گذاشتن دو مقاله از دو حوزه متفاوت به دست می‌آید؛ مثلاً روشی از یک مقاله اقتصادسنجی را با موضوع یک مقاله سیاست‌گذاری ترکیب کنید.

🔴 نکته مهم: هدف کپی کردن نیست، بلکه پیدا کردن یک خلاء مشخص است که بتوانید با داده و ابزار در دسترس خودتان پرش کنید.


🔘 اگر در این مسیر به مقاله‌ای برخوردید و مطمئن نبودید ایده‌ی قابل دفاعی از اون بیرون میاد یا نه، خوشحال می‌شم کمکتون کنم. 👇

@ecohadi

🌐 https://t.me/ecohadicom
  • 👍 12
  • ❤ 7
Older posts →

About this channel

How can I read @ecohadico without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Ecohadi.com(اقتصادسنجی): recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Ecohadi.com(اقتصادسنجی) have?
Ecohadi.com(اقتصادسنجی) (@ecohadico) has 3.68K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Ecohadi.com(اقتصادسنجی) know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →