TGViewer
Channel Public Channel
Книжный куб

Книжный куб

@book_cube

Канал Александра Поломодова (@apolomodov), cto & technical fellow.

https://polomodov.tech - сайт со всеми материалами
youtube.com/@tellmeabouttech - канал со всеми видео
Subscribers
15.7K
Photos
3K
Videos
6
Links
2.5K

Showing posts older than #4905 · Back to latest

Older Posts 20 shown
Post #4904 2.65K
Code of Leadership S2E17: Как действовать среднему бизнесу с AI, которому «по-науке» дорого? (Рубрика #AI)

У среднего бизнеса с AI есть неприятная развилка. Лаборатория, платформа и команда редких специалистов — тяжёлый входной билет. Но личные подписки, разрозненные демо и один «AI-волшебник», работающий по вечерам, ещё не складываются в практику.

Сегодня в 17:00 проведем прямой эфир и обсудим это вместе с Александром Воронцовым, партнером @revelio_tech и автором канала AI Subjects (@aisubjects, изучает когнитивные ошибки при работе с ИИ). В прошлом разговоре мы дошли до важной точки: внешний эксперт уйдёт, а внутри должен остаться человек, который понимает задачу, проверяет результат и продолжает изменение. Теперь разбираемся, как получить и удержать эту способность, если сильные люди заняты основной работой, а нанимать AI-департамент рано.

Мы обсудим:
— как отличить задачу для AI от сломанного процесса, плохих данных и управленческого долга;
— как выбрать первый сценарий, снять исходную метрику и заранее определить критерии приёмки и остановки;
— кого растить внутри, кого нанимать или временно брать с рынка и что покупать готовым;
— как освободить время доменного эксперта и не превратить AI в его вторую смену;
— что нужно кроме учётных записей: доступы, тестовые примеры, журнал ошибок, ручное подтверждение и откат;
— как считать входной билет: лицензии, интеграции, внутреннее время, контроль качества, поддержку и цену ошибки;
— когда понравившийся сотрудникам пилот всё равно нужно закрыть.

#CodeOfLeadership #AI #Consulting #Leadership #Management #DigitalTransformation
YouTube Code of Leadership S2E17: Как действовать среднему бизнесу с AI, которому «по-науке» дорого? У среднего бизнеса с AI есть неприятная развилка. Лаборатория, платформа и команда редких специалистов — тяжёлый входной билет. Но личные подписки, разрозненные демо и один «AI-волшебник», работающий по вечерам, ещё не складываются в практику. Сегодня в…
  • ❤ 9
  • 👍 5
  • 🔥 4
Post #4903 2.59K
An Illustrated Guide to AI Agents: полное издание (Рубрика #Agents)

В марте я уже рассказывал про "An Illustrated Guide to AI Agents". Тогда это был Early Release: готовы были шесть глав, а я обещал следить за продолжением. Теперь издательство O'Reilly выпустило полное издание — 450 страниц и 10 глав. Вернуться к книге стоит не только из-за новых страниц: она перестала выглядеть как сильная половина будущего учебника и наконец собралась в цельный маршрут — от устройства LLM до проверки и эксплуатации агентной системы.

Если сравнить финальное оглавление с тем, что было готово весной, доехали четыре большие главы.

1️⃣ Large Language Models делает книгу самодостаточной. Здесь есть tokens, system prompt, tool calls, pre-training и post-training, Transformer, context length, KV cache и Mixture of Experts — причем всё это привязано к поведению, задержке и стоимости агента. Становится понятнее, как сама модель, длина контекста и KV cache влияют на всю систему.
2️⃣ Evaluating Agents — пожалуй, самая важная новая глава. Авторы разбирают public benchmarks, outcome и trajectory evaluation, LLM-as-a-judge, rubrics, reliability, safety и собственные evals. Особенно полезна пара метрик: pass@k отвечает на вопрос «получилось ли у агента хотя бы раз за k попыток», а pass^k — «успешны ли все k попыток». Для эффектного демо часто хватает первого, для рабочего процесса гораздо важнее второе.
3️⃣ Multi-Modal Understanding объясняет, как агент начинает видеть изображения, слышать аудио и разбирать видео: encoder переводит вход в embeddings, connector приводит их к формату LLM, дальше модель использует их как контекст. Заодно хорошо показаны компромиссы: простой projection дешевле, query-подход лучше сжимает длинный вход, fusion обычно выразительнее, но сложнее и дороже.
4️⃣ Code Agents and Code LLMs доводит тему от генерации функции до работы внутри репозитория. Здесь есть инструменты для файлов и терминала, SQL, песочницы для исполнения кода, карты репозитория, кэширование и сжатие контекста, планирование, тесты и ручное подтверждение. Важная мысль: иногда фиксированный workflow надежнее полноценного агента, а доступ к shell — это не удобная галочка, а граница безопасности, от которой зависит масштаб возможного ущерба.

Кстати, финальная версия уже знакомой главы про Multi-Agent Systems включает orchestration patterns, communication protocols, deep research agents и сценарии вроде AI co-scientist. Но цельность книги создаёт сквозная конструкция. В первой части авторы последовательно собирают одного TinyAgent: LLM → reasoning → memory → tools → planning → evals. Во второй показывают, как та же архитектура специализируется в multi-agent, multi-modal и coding systems. Получился уже не каталог модных фреймворков, а понятный инженерный цикл.

Для инженера это закрывает несколько конкретных сценариев:
- спроектировать внутреннего исследовательского агента или агента поддержки и понять, где хранить контекст и какие инструменты ему дать;
- проверять изменения промпта, модели и памяти через регрессионные evals не только по ответу, но и по траектории;
- собрать code agent с поиском по репозиторию, тестами и песочницей;
- добавить изображения, звонки или видео туда, где текстовый агент просто не видит часть задачи.

Для техлида или руководителя сценарии другие:
- решить, где нужен агент, а где достаточно детерминированного workflow;
- выбрать single-agent или multi-agent архитектуру и посчитать цену координации;
- сравнить поставщиков на собственных задачах как связку «model + harness», учитывая надёжность, задержку и стоимость;
- задать границы автономности — права, необратимые действия, сценарии безопасности и места, где обязательно ручное подтверждение.

Если первые главы уже читали весной, начинать заново необязательно: главу 2 можно пробежать для связки с экономикой агента, главу 7 я бы точно не пропускал, а дальше — главы про мультимодальность и кодинговые агенты. Именно эта связка превращает ранний набор хороших объяснений в законченную инженерную книгу.

#Agents #Books #AI #Engineering #Architecture #Management #Software
Telegram Книжный куб An Illustrated Guide to AI Agents (Рубрика #Agents) Пока летел обратно из Лондона в Москву успел прочитать эту книгу и могу ее рекомендовать всем. Ее пишут Jay Alammar и Maarten Grootendorst - авторы крутой книги "Hands-On Large Language Models", о которой…
  • 🔥 11
  • ❤ 6
  • 👍 6
Post #4902 2.54K
Post #4901 2.38K
NVIDIA договорилась купить Hugging Face: проверка на нейтральность (Рубрика #AI)

После разбора стратегии NVIDIA эта сделка выглядит почти неизбежным следующим ходом. Только цена в $12,93 млрд немного отвлекает: NVIDIA договорилась купить не очередную модельную лабораторию и не новый тип ускорителя. В случае закрытия сделки она получит место, где разработчики находят, сравнивают, скачивают и запускают открытые модели — одну из главных точек выбора во всём AI-стеке.

Сначала аккуратно со статусом. 2 сентября 2026 года NVIDIA подписала definitive agreement, 3 сентября опубликовала анонс и форму 8-K. По документу для SEC, примерно $11,9 млрд предназначены акционерам Hugging Face, ещё до $1 млрд — retention-программа в акциях для сотрудников, которые перейдут в NVIDIA. Закрытие ожидается в первой половине 2027 года и зависит в том числе от регуляторных согласований. То есть сделка предложена, но пока не закрыта.

Почему Hugging Face стоит рассматривать не как «GitHub с весами»?

По данным самой NVIDIA, на платформе больше 18 млн разработчиков и исследователей, 3 млн моделей, 500 тысяч датасетов и 1 млн приложений. Но важнее сам механизм. Inference Providers даёт один API к Baseten, Cerebras, Groq, Nscale, Together и другим поставщикам, а без явного выбора автоматически направляет запрос к самому быстрому доступному provider. Dedicated endpoints можно разворачивать в AWS, Azure и Google Cloud. Получается уже не просто хранилище артефактов, а слой discovery, distribution и routing: что разработчик увидит, какую модель попробует и где её запустит.

Для NVIDIA логика понятна. Компания уже контролирует популярный compute/runtime-слой через GPU и CUDA и, по собственным данным, выложила на Hugging Face больше 500 моделей и 250 датасетов. Теперь к железу и software stack добавляется канал дистрибуции. Открытые модели удешевляют и ускоряют создание AI-продуктов, а каждый такой продукт всё равно создаёт спрос на inference. Плюс платформа даёт раннюю агрегированную картину того, какие модели, архитектуры и способы запуска набирают популярность. Последний пункт — интерпретация аналитиков, а не раскрытая цель сделки.

NVIDIA обещает сохранить Hugging Face открытой: её железо не будет обязательным, разработчики смогут выбирать модели, frameworks, clouds, inference providers и compute platforms. В 8-K обещание сформулировано чуть уже, но всё равно предметно: сохранить возможность загружать и скачивать выбранные модели и датасеты и продолжать поддержку других производителей чипов.

Это сильнее обычного «бренд останется прежним». Но открытость артефактов ещё не равна нейтральности платформы. Публичные документы пока не отвечают на четыре практических вопроса:

1️⃣ Кто и по каким правилам управляет ранжированием и рекомендациями моделей;
2️⃣ Как выбираются дефолты в маршрутизации инференса и какие провайдеры получают приоритет;
3️⃣ Будет ли одинаковой скорость интеграции и оптимизации для CUDA, ROCm, Trainium, TPU и CPU;
4️⃣ Где пройдёт граница использования телеметрии и данных о поведении разработчиков.

Сейчас нет доказательств, что NVIDIA собирается подкручивать эти механизмы в свою пользу. Но именно здесь и будет проходить настоящая проверка, а не в возможности скачать файл с весами. Поэтому обещание «Hugging Face останется открытой» — не сноска к пресс-релизу, а главный критерий приемки сделки. Если после закрытия конкурирующее железо и независимые провайдеры инференса будут появляться в роутинге, документации и оптимизациях на равных, а правила ранжирования и использования данных станут прозрачнее, ресурсы NVIDIA действительно могут усилить экосистему. Если нет, веса останутся открытыми, но площадка, на которой все их выбирают, перестанет быть нейтральной.

#AI #PlatformEngineering #OpenSource #Architecture #Infrastructure #Bigtech
NVIDIA Blog NVIDIA to Acquire Hugging Face NVIDIA has agreed to acquire Hugging Face. Together, we will scale Hugging Face’s platform, strengthen its infrastructure and expand access to AI for developers and institutions worldwide.
  • ❤ 5
  • 🔥 2
  • 🍾 2
Post #4900 2.54K
Stanford MS&E435: Sachin Katti о том, когда человек становится bottleneck AI-системы (Рубрика #AI)

В этой лекции есть тезис, который для инфраструктуры звучит как победа, а для человеческой работы — почти как предупреждение. Sachin Katti говорит: OpenAI добьётся успеха в compute, когда bottleneck станет человек. Агент будет заканчивать шаги так быстро, что мы перестанем ждать и останемся в flow.

На встрече курса Stanford MS&E435 «Economics of the AI Supercycle» Apoorv Agrawal беседует с Sachin Katti. На момент записи Katti руководил Industrial Compute в OpenAI — compute для training и inference. Сейчас он VP, Compute Strategy & GPT-Infra в OpenAI; ранее был CTO Intel и преподавал в Stanford. Это не нейтральный обзор рынка, а взгляд оператора frontier-лаборатории.

Сильная часть лекции — агент как новый тип workload.
У чат-бота был короткий путь: пользователь → один inference call → ответ
Агент замыкает цикл: inference → поиск или база → tool call → VM или приложение → наблюдение и оценка результата → новый inference

Katti описывает execution как DAG; управляющая логика может оставаться циклической. Узлам нужны разные ресурсы:
» Ускорители для model inference
» CPU-backed runtimes и VM для инструментов и тестов
» Системы с большой памятью для длинного контекста
» Сеть и orchestration для сборки маршрута
Поэтому model + runtime + accelerators + network + data center + power приходится оптимизировать как одну систему.

Это продолжает два сюжета канала: hardware-software co-design у Dylan Patel и дерево агентных вызовов, превращающее бизнес-процессы в спрос на GPU. Новое — операторский взгляд OpenAI: куда поместить каждый узел и как latency всего графа влияет на human flow. Из этого я бы мерил не только tokens/s, а time to first useful action, время до проверенного артефакта и стоимость задачи. У Katti три рычага: более дешёвый токен, более умный токен и меньше токенов на результат.

Есть и большие числа. По прогнозу Katti, более 80% compute будет уходить на inference — включая synthetic data и часть post-training. Цель OpenAI в 30 ГВт он называет aspirational, а 1 ГВт грубо приравнивает к 500 тысячам GPU. Это оценки спикера. И утроение compute вместе с выручкой за три года показывает корреляцию, но не доказывает причинность.

Здесь появляется напряжение. Для Katti человек как bottleneck — признак успеха compute-инфраструктуры: сегодня агент выполняет задачу с инструментами минуты или часы, человек переключается, а затем заново загружает контекст. Быстрый AI должен вернуть интерактивность.

В канале мы уже смотрели на ту же картину с другой стороны. В Your Attention Is the Bottleneck человек превращается в диспетчера множества циклов: ставит задачи, снимает блокировки, проверяет и выгорает от переключений. А в посте про понимание как новое узкое место изменения производятся быстрее, чем команда успевает обновлять модель системы в голове. Возникает когнитивный долг: код работает, но отвечать за его развитие уже некому.

Ускорение агента не устраняет эту проблему и может повысить частоту решений, прилетающих человеку. Если разогнать конвейер, не усилив контроль качества, могут расти незавершённая работа, пропущенные дефекты и переделки. У человеческого bottleneck как минимум четыре ограничения: внимание, понимание, проверка и ответственность. Ни одно из них не масштабируется вместе с tokens per second.

Поэтому agentic UX стоит проектировать не только вокруг быстрого ответа. Агенту нужно собирать вопросы пакетно, возвращать компактный контекст, показывать evidence, тесты и неопределённость, а человека подключать там, где высока цена ошибки. И мерить время до понятого и проверенного результата вместе с числом steering points, переключений и переделок.

Я бы смотрел отрезок 18:05–24:40 про agentic graph и human flow, а затем 29:05–33:05 про latency. После него остаётся хороший вопрос: сколько параллельных агентных циклов человек способен не просто направить, а понять и ответственно закрыть?

#AI #Agents #Engineering #Architecture #Infrastructure #AI4SDLC
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Infrastructure, Capstone Case For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education This seminar covers infrastructure and a capstone case on a frontier lab. Follow along with the course schedule: https://mse435.stanford.edu/…
  • ❤ 6
  • 🔥 4
  • 👍 1
Post #4899 2.87K
Только что рассказал про первые 90 дней CTO на мероприятии Стратоплана
Вот слайд-дека - https://polomodov.tech/2026-09-03-first-90-days-cto/
Вот лонгрид - https://polomodov.tech/2026-07-31-first-90-days-cto/

Если мы набьем 50👌, то я сделаю режиссерскую версию этого доклада в виде прямого эфира.
polomodov.tech Первые 90 дней CTO — Стратоплан · программа CTO Как начать переход до первого дня, исследовать компанию, договориться о мандате, провести первый месяц без резких движений и пройти испытательный срок с измеримым…
  • 👌 95
  • 🔥 14
  • 👍 8
  • ❤‍🔥 1
Post #4898 2.85K
Первые 90 дней CTO начинаются до первого рабочего дня - Менеджмент 360 (Рубрика #Management)

Сегодня я выступлю в 19:35 на «Менеджменте 360» от Стратоплана - буду рассказывать про первые 90 дней технического директора. Начну с небольшого переворота: первый рабочий день — уже середина перехода. В докладе разберу весь маршрут:

- Как выбирать задачу, а не красивый шилдик;
- Зачем до выхода договориться о полномочиях, ресурсах и критериях успеха;
- Почему первый месяц лучше потратить на сбор реальной карты компании, а не на формирование портфеля изменений;
- Как к 90-му дню выбрать одну-две системные ставки, показать первый результат и не пропустить красные флаги.

Это не универсальный чек-лист «успешного успеха», а практическая модель: исследование → взаимный контракт → диагностика → первые изменения. И ещё: компания в эти три месяца тоже проходит испытательный срок.

Регистрация бесплатная при подписке на Telegram-каналы спикеров. Есть и платный вариант без подписок — с именным сертификатом и курсами «Менеджмент 101» и «Директор 101». 👉 Регистрация

#Management #Leadership #CTO #Conference
  • 🔥 16
  • ❤ 12
  • 👍 11
Post #4897 2.53K
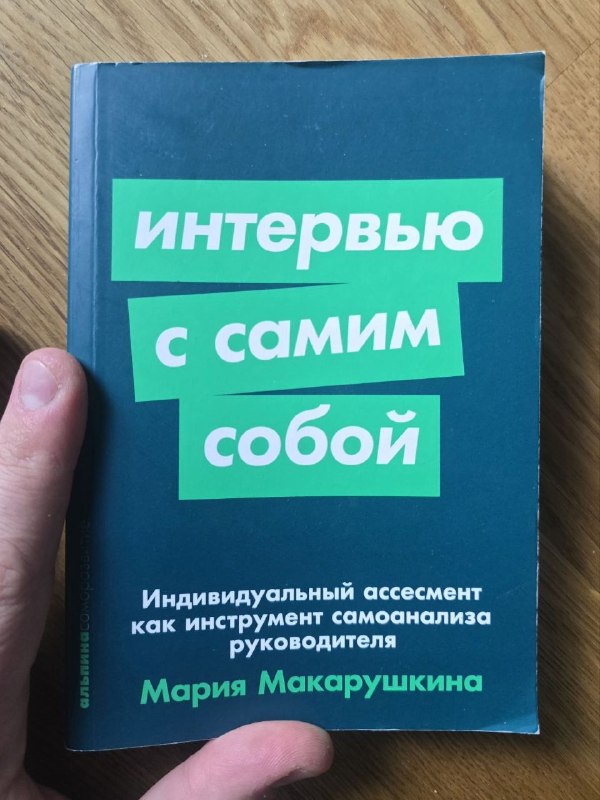
Интервью с самим собой: гипотеза, вердикт и синяя борода (Рубрика #Books)

Прочитал книгу Марии Макарушкиной «Интервью с самим собой. Индивидуальный ассесмент как инструмент самоанализа руководителя». Для меня она оказалась интересна прежде всего тем, что приоткрывает кухню индивидуального ассесмента: как консультант слушает биографию человека, замечает повторяющиеся мотивы и собирает из них гипотезы о характере, мотивации и управленческом поведении.

Но ровно здесь у меня появилось и главное сомнение. В некоторых историях автор, как мне показалось, слишком широко интерпретирует биографические детали. Если довести этот ход мысли до карикатуры, получится примерно так: человек в детстве любил синий цвет — и поэтому вырос с синей бородой. Такого примера в книге, конечно, нет; это моя метафора. Но проблема реальная: психологическая история может звучать очень складно и при этом не быть единственным — или вообще верным — объяснением.

В какой-то момент я понял, что граница проходит между гипотезой и вердиктом.
- Гипотеза звучит так: «Возможно, ранняя необходимость отвечать за других связана с тем, что сегодня я всё контролирую». С ней можно пожить, проверить её на разных ситуациях, спросить коллег и в итоге отбросить.
- Вердикт звучит почти так же, только слово «возможно» исчезает: «Вы всё контролируете, потому что в детстве вам пришлось рано повзрослеть». Объяснение стало увереннее, хотя данных больше не появилось. Но надо отдать должное, автор в книге всегда делает ремарку про важность дополнительных данных для проверки гипотезы (хотя выводы часто безапеляционны и дальше сопровождаются тезисами в стиле: прошло время и конечно так все и разрешилось).

Отсюда для меня возникло ещё одно разделение — ассесмент для себя и внешний ассесмент.
🤔 В самоассесменте даже неточная гипотеза может оказаться полезным вопросом. Интерпретация остаётся у меня: её можно проверить и отбросить, не превращая в чужое кадровое решение. Хотя и здесь легко сочинить себе удобную историю: назвать контроль ответственностью, а избегание конфликтов — эмпатией.
↗️Во внешнем ассесменте та же гипотеза способна стать ярлыком и повлиять на найм, назначение или карьеру. Поэтому одной правдоподобной связи с биографией мне уже недостаточно. Нужны наблюдаемое поведение, конкретные рабочие ситуации, обратная связь окружающих, несколько независимых источников и понятный ответ на вопрос: «Что могло бы опровергнуть этот вывод?»

Сама книга построена в трёх частях
1️⃣ В первой читатель проходит по собственной биографии: раннее детство, родители, семейные установки, первая работа и значимые события
2️⃣ Во второй автор разбирает личностный портрет — особенности мышления и речи, мотивацию, ответственность, коммуникацию и самооценку
3️⃣ В третьей собраны жизненные сценарии из консультационной практики
Всё это перемежается историями руководителей и упражнениями для самодиагностики.

В итоге книгу я бы рекомендовал руководителям и всем, кому интересно посмотреть за кулисы индивидуального ассесмента. Из неё можно забрать хорошие вопросы к себе и лучше понять логику оценщика. А вот ответы полезно держать в статусе гипотез подольше:)

#Books #Management #Leadership #HR #Psychology
  • 👍 9
  • ❤ 3
  • 🔥 2
  • 🤝 1
Post #4896 2.48K
Stanford MS&E435: Али Годси говорит, что AGI уже здесь, а компания — ещё нет (Рубрика #AI)

Редкий случай, когда одна 39-минутная запись собирает в одну картину темы, о которых я писал по отдельности: корпоративную память, AI-native организацию, судьбу SaaS и перенос ценности вверх по стеку. Это встреча Stanford MS&E435: преподаватель Apoorv Agrawal разговаривает с Али Годси, сооснователем и CEO Databricks.

Годси начинает с провокации: «AGI уже здесь». Это его рабочая рамка, не консенсус. Полезнее следующий тезис: модели уже достаточно умны для многих корпоративных задач, но не знают контекста компании. Отсюда ссылка на "GenAI Divide": предварительный отчёт утверждал, что лишь около 5% специализированных enterprise GenAI-инициатив дошли до устойчивого измеримого эффекта. Авторы предупреждали, что оценки показывают скорее направление, а Годси оговаривается, что точная доля может быть другой.

Почти в каждой организации, говорит он, есть свой John или Jane: человек, который помнит, почему процесс устроен именно так, где лежат исключения и к кому идти за решением. Модель этого не знает и потому делает глупые ошибки. Это почти тот же «мозг компании», о котором я писал после доклада Гарри Тана: преимущество создаёт не только модель, но и способность дать ей правильную память.

Самый сильный фрагмент начинается на двадцатой минуте. По рассказу Годси, production-коннектор Databricks к Salesforce или Workday занимал девять месяцев. По оценке команды, использование AI сокращало цикл лишь до семи с половиной. Тогда процесс перепроектировали: квартал сбора требований превратили в неделю с быстрыми итерациями, тестовые окружения отдали внешним исполнителям и запускали параллельно, а семь инженеров стали вместе вести семь коннекторов вместо модели «один человек — один проект». Результат, по словам Годси, — семь коннекторов за квартал.

Ни GPT-7, ни следующая Claude не сняли бы эти блокировки: это был рефакторинг организации. Та же мысль соединяет мой текст про AI-native организацию и разбор "перестройки McKinsey": LLM поверх старого процесса даёт локальное ускорение, но не новый throughput. Аналогия с электрификацией похожа: фабрика стала продуктивнее не после установки одного электромотора, а после новой планировки вокруг независимых приводов.

Вторая линия — «software умер». Годси с этим спорит, но считает, что AI снижает барьер входа и switching costs. Если пользователь разговаривает с агентом, ему уже не так важно, какой GUI тот нажимает — Salesforce или продукт конкурента. Это очень близко к моему тезису, что "умирает монополия GUI, а не software".

При этом дешёвый код не отменяет данные, масштаб, бренд, доверие, сертификацию и process power. Годси прямо рекомендует Hamilton Helmer и его Seven Powers. А дальше прогнозирует, что модельный слой превратится в низкомаржинальные «фабрики токенов», а большая ценность уйдёт в приложения. Мы уже видели ту же логику в разговоре про коммодитизацию моделей. Правда, это прогноз заинтересованного инфраструктурного вендора, но направление выглядит правдоподобно.

И всё же «скачать мозг компании в silicon» — только половина задачи. Если контекст получит агент, а люди перестанут понимать систему, мы просто ускорим накопление когнитивного долга. Исполнение можно делегировать; ответственность за устройство процесса и способность его перепроектировать остаются у команды.

Если времени мало, то посмотрите отрывки "20:23–24:43" — кейс с коннекторами и "26:04–28:44" — история о том, как дефицит bandwidth сделал multicast модной научной задачей, а дешёвое оптоволокно обесценило её и открыло дорогу странным тогда приложениям вроде Amazon, Uber и Airbnb. Хорошее напоминание: главный продукт следующего цикла редко похож на модный инфраструктурный вопрос текущего.

#AI #Agents #Engineering #Software #Management #Strategy
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Infrasctructure, Enterprise AI, SaaS For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education This seminar covers applications, coding AI, and the future of software. Follow along with the schedule: https://mse435.stanford.edu/ Guest Speaker:…
  • 🔥 6
  • ❤ 2
Post #4895 2.5K
Code of Leadership S2E18: Продуктовый инженер — как изменится роль программистов в ближайшие 3 года

Код писать становится заметно быстрее. Но если всё большую часть реализации можно делегировать AI-инструментам, что тогда остаётся ядром работы программиста: знание синтаксиса, инженерное суждение или ответственность за продукт целиком?

В новом выпуске Code of Leadership во вторник, 8 сентября, в 19:00 попробуем разобраться в этом вместе с Глебом Михеевым — CPO ГигаАгента в Сбере. Глеб в коммерческой разработке с 2003 года: работал в NVIDIA и Skillbox, основал и девять лет развивал студию заказной разработки, восемь лет отвечал за программу FrontendConf, а сейчас руководит программными комитетами AgenticDevConf и AI Native Conf.

Ещё Глеб ведёт отличный Telegram-канал «Уставший техдир», где пишет про агентную разработку, инженерную культуру, управление командами и продукт.

Поговорим о том:

- какие изменения уже происходят в разработке ПО, а что пока остаётся красивым прогнозом;
- чем эти изменения обусловлены и почему дело не сводится к появлению ещё одного инструмента;
- как меняются требования к разработчику и чем продуктовый инженер отличается от человека, который просто закрывает задачи;
- что делать с джунами, если типовые стартовые задачи всё чаще автоматизируются, и как готовить молодых инженеров без искусственной «теплицы»;
- как опытному разработчику учиться, пробовать новые подходы, сохранять техническую глубину и не отставать от прогресса;
- какой может стать роль программиста в ближайшие три года — и что здесь пока слишком рано выдавать за факт.

Отдельно хочу проверить границу здравого продуктового мышления. Продуктовый инженер — это специалист, который понимает проблему пользователя и отвечает за результат, или просто удобное название для человека, которому предлагают одновременно побыть продактом, аналитиком, архитектором и разработчиком?

Если у вас есть вопросы к Глебу или собственные примеры того, как уже меняется работа разработчика, приносите их в комментарии.

#CodeOfLeadership #AI4SDLC #Engineering #Leadership #Product #Career
YouTube Продуктовый инженер — как изменится роль программистов в ближайшие 3 года Код писать становится заметно быстрее. Но если всё большую часть реализации можно делегировать AI-инструментам, что тогда остаётся ядром работы программиста: знание синтаксиса, инженерное суждение или ответственность за продукт целиком? В новом выпуске Code…
  • 🔥 7
  • 👎 6
  • ❤ 2
  • 👍 2
Post #4894 2.47K
Материалы Code of Leadership S2E15: последние 90 дней в компании (Рубрика #Management)

Готовы материалы сольного выпуска Code of Leadership S2E15, который вышел 31 августа. В общей нумерации подкаста это выпуск №73.

Он получился личным: после почти десяти лет в одной компании я разбираю обратную сторону первых 90 дней — как осознанно завершить прежний этап. Заявление здесь не начало процесса, а трудно обратимая точка; до неё стоит понять, что именно перестало работать, проверить варианты и выбрать один из трёх исходов: пересобрать текущую роль, перейти внутри компании или уйти.

Это практическая модель, а не исследование: 90 дней — горизонт проектирования перехода, а не универсальный срок уведомления.

В выпуске разобрал:

- Как дневник энергии помогает отличить системную неудовлетворённость от одной плохой недели, месяца или проекта;
- Где проходит граница между тем, что можно изменить в роли, — задачами, полномочиями и рабочими ритмами — и ограничениями самой компании или рынка;
- Как провести карьерную ретроспективу и описать следующую роль через ответственность, решения и результат, а не название должности;
- Как до окончательного выбора прототипировать роль через внутренние интервью и пробные проекты, параллельно проверяя ожидания на внешнем рынке;
- О чём договориться на входе в новую роль: мандат, ресурсы, границы и критерии оценки;
- Почему документ не равен переданному знанию: сначала преемнику нужно отдать право принимать решения, затем — контекст, отношения, ритмы и доступы. Передача завершена, когда команда может действовать без прежнего владельца.

Все материалы выпуска:

- Страница выпуска: конспект, таймлайн и ссылки
- Интерактивная дека и полный лонгрид
- Видео: YouTube, VK Видео
- Аудио: Podster, Яндекс Музыка, Apple Podcasts

Если вы проходили такой переход, расскажите в комментариях, что оказалось труднее: понять причину, выбрать следующий шаг или действительно передать ответственность.

#Management #Leadership #Career #Strategy #Engineering #Podcast
polomodov.tech Последние 90 дней в компании — Code of Leadership Сольное выступление о диагностике карьерного перехода, внутренней мобильности, выборе следующей роли и передаче ответственности без потерь.
  • 🔥 5
  • ❤ 3
  • 👍 3
Post #4893 2.3K
NVLink Fusion: свой XPU, стойка NVIDIA и причем здесь Mediatek (Рубрика #AI)

Когда я рассказывал про эволюцию Google TPU, логика была понятной: крупный облачный провайдер создаёт собственный ускоритель, чтобы точнее подогнать железо под свои модели и меньше зависеть от универсальных GPU.

Ответ NVIDIA на этот тренд выглядит довольно красиво: хорошо, делайте свой XPU — а стойку вокруг него мы поможем собрать на нашей архитектуре.

31 августа 2026 года NVIDIA и MediaTek объявили о расширении партнёрства. NVIDIA приобрела конвертируемые облигации MediaTek на $3,5 млрд — долговые бумаги, которые при предусмотренных условиях можно обменять на акции. Но технически интереснее другая часть анонса: MediaTek будет помогать заказчикам проектировать и интегрировать заказные AI-ускорители, а NVLink Fusion даст этим чипам путь в стоечную инфраструктуру NVIDIA.

XPU здесь — не один конкретный тип процессора, а условное название заказного ускорителя под определённый профиль нагрузки: обучение или инференс, то есть работу уже обученной модели. Заказчик может принести собственную микроархитектуру либо поручить её MediaTek.

Один из показанных NVIDIA вариантов подключения выглядит так: заказной XPU → UCIe → чиплет-мост NVIDIA → NVLink → NVSwitch → AI-стойка
UCIe — открытый интерфейс между чиплетами внутри многокристальной системы. Через него XPU подключается к мосту NVIDIA, а тот выводит ускоритель в NVLink. NVSwitch объединяет множество ускорителей в одну высокоскоростную сеть. Рядом NVIDIA предлагает блоки для связи с CPU/GPU, памяти и общего стоечного формата — NVLink-C2C, NVHBM и MGX. Такая архитектура позволяет совместно использовать сеть, питание, охлаждение и управление; NVIDIA и MediaTek также обещают помогать с тестированием и отладкой готовой системы перед её серийным выпуском.

Если упростить, заказчик проектирует двигатель, а NVIDIA предоставляет дорогу и развязки, по которым должен двигаться целый парк таких машин.

Я бы читал NVLink Fusion именно так: NVIDIA не спорит с появлением заказных чипов у Google, AWS и других крупных игроков, а старается стать опорным слоем для гетерогенных AI-вычислений. Вычислительный кристалл может быть не NVIDIA, но обмен данными между ускорителями и, при выборе MGX, значительная часть стоечного контура могут остаться в её экосистеме.

При этом NVLink Fusion не стоит путать с полностью открытым стандартом. Открытой является локальная граница UCIe, а NVLink, чиплет-мост и NVSwitch остаются проприетарными технологиями NVIDIA. То есть зависимость возникает на уровне внутристоечной сети и может распространиться на архитектуру стойки.

И это не история одного MediaTek. При запуске NVLink Fusion 18 мая 2025 года NVIDIA назвала среди партнёров также Marvell, Alchip, Astera Labs, Synopsys и Cadence. Позднее AWS сообщила, что Trainium4 проектируется с поддержкой NVLink Fusion.

По утверждению NVIDIA, такая архитектура должна сокращать путь от проекта чипа до работающей стойки. Проверить это пока нельзя: у совместного проекта NVIDIA и MediaTek нет названного заказчика, даты выхода чипа и независимых данных о производительности или стоимости владения. Поэтому главный тест ещё впереди: появится ли серийная система, в которой XPU действительно свой, а NVLink Fusion действительно ускоряет путь до эксплуатации. Если да, защитный ров NVIDIA будет проходить уже не вокруг GPU. Он будет проходить вокруг стойки. И это, кажется, интереснее очередного сравнения FLOPS.

#AI #Engineering #Architecture #Infrastructure #Hardware #Bigtech
  • 👍 6
  • ❤ 3
  • 🔥 2
Post #4892 2.43K
Post #4891 2.65K
3 AImigo S1E4: AI нанимает AI. Как пересобрать IT-собеседования? (Рубрика #AI)

AI соискателя встречается с AI нанимающего — мегазорд против супер-рейнджера. Запрет AI не делает интервью AI-free, резюме всё хуже подтверждает способность работать, а старые онлайн-этапы дают всё более шумный сигнал. Вопрос у компании прежний: сможет ли человек успешно работать в этой роли?

В пятницу в 12:00 по Мск в прямом эфире подкаста 3 AImigo посмотрим на найм с двух сторон — кандидата и нанимающего менеджера — и обсуждаем, как пересобрать его под AI-Assisted Engineering.

— Как собрать hiring process как eval-систему: определить признаки для роли, подготовить банк задач с сильными решениями и проверить, что каждый этап измеряет нужный сигнал.
— Как сочетать AI-on и AI-off, собеседования онлайн и офлайн. Без AI проверять фундамент, с AI — реальную работу: запуск кода, выбор того, что делегировать агенту, и проверку результата.
— Почему важнее не скорость генерации, а инженерное суждение: уточнение требований, декомпозиция, поиск контекста, system design, debugging, тесты, безопасность, failure modes, trade-offs, ownership финального решения и способность отвергнуть убедительный, но неверный ответ модели.
— Почему единого трека больше может не быть. Product engineer, платформенный и R&D-инженер создают разную ценность — значит, им нужны разные сигналы и задания.
— Что меняется для кандидата: AI усилил обе стороны, рынок расслаивается, знакомства не являются новым лайфхаком, поиск становится почти full-time работой, а первой потерей работы из-за AI может оказаться вакансия, которую компания просто не открыла.

Как обычно, разбираемся втроём: Евгений Сергеев, Алексей Литвинов (@tip_podcast) и Александр Поломодов. Смотрите выпуск на Youtube. И напишите, какой этап вашего последнего собеседования действительно предсказывал будущую работу, а какой проверял умение проходить собеседования.

#AI #AI4SDLC #Engineering #Management #Evals #Interview #Career
YouTube 3 AImigo S1E4: AI нанимает AI. Как пересобрать IT-собеседования? AI соискателя встречается с AI нанимающего — мегазорд против супер-рейнджера. Запрет AI не делает интервью AI-free, резюме всё хуже подтверждает способность работать, а старые онлайн-этапы дают всё более шумный сигнал. Вопрос у компании прежний: сможет ли…
  • ❤ 8
  • 🔥 2
  • 👍 1
Post #4890 2.36K
Stanford MS&E435: дефицитный мегаватт AI-фабрики (Рубрика #AI)

После этой лекции «облачный AI» выглядит удивительно тяжёлой промышленностью: электричество, подстанции, охлаждение, бетон и люди, которые всё это собирают. Третья встреча Stanford MS&E435 полезна именно этим — опускает разговор о моделях, токенах и GPU на физический слой ниже. Гость — Чейз Локмиллер, сооснователь и CEO Crusoe, которая строит и продаёт весь стек от площадки до managed inference. Поэтому это одновременно хорошая карта отрасли изнутри и vendor pitch: Локмиллер объясняет ровно тот вертикальный стек, который продаёт.

Его схема называется «от электронов к токенам»: энергия → здание и охлаждение → compute → токены → выполненная работа. А главный тезис звучит так: по его опыту, текущий bottleneck — уже не отдельный GPU, а energized data center, то есть готовое место, где чип можно включить и загрузить работой.

Вот какие инсайты из лекции я бы вынес:
🔸 Bottleneck постоянно мигрирует
Вчера не хватало GPU, сегодня — подключённой мощности, газовых турбин, трансформаторов, switchgear и квалифицированных электриков. Вертикальная интеграция здесь работает не только как способ забрать больше маржи, но и как страховка от очередного дефицита.
🔸 Дефицитный товар — энергизированный мегаватт
Купить ускорители недостаточно: нужны земля, разрешения, подстанция, сеть и охлаждение. Поэтому площадка, где можно быстро запустить 100–1000 МВт compute, оказывается стратегическим активом.
🔸 Иногда дешевле перемещать данные, а не электричество
Обучение не обязано происходить рядом с пользователем, поэтому Crusoe ставит кластеры возле избыточной энергии Западного Техаса. Для inference с жёсткой задержкой и данных с требованиями к размещению эта логика работает хуже.
🔸 AI-бум — это ещё и промышленный бум
На кампусе Abilene, по словам Локмиллера, ежедневно работают тысячи строителей. Электрики, сварщики, pipefitters, бетон и километры кабеля оказываются не менее важны, чем CUDA и архитектура модели.
🔸 Старый GPU может стать commodity, масштаб — нет
Большой coherent cluster с общей высокопроизводительной сетью трудно воспроизвести. А managed service может скрыть поколение железа от клиента и продлить экономическую жизнь ускорителей: пользователю нужен результат API, а не конкретный H100.
🔸 В модели Локмиллера экономика зависит от depreciation, загрузки и слоя сервиса
По его оценке, здание и генерация стоят около $20 млн на МВт, IT — ещё $40 млн, из которых примерно $30 млн приходится на GPU. Аренда compute в его расчёте даёт около $15 млн выручки на МВт в год, managed inference — в оптимистичном случае до $30 млн. Последние цифры я бы воспринимал только как модель самого CEO. Локмиллер прямо признаёт возможный двойной счёт, неполный OpEx и то, что слайды были собраны в тот же день. Поэтому заявленные два–четыре года «окупаемости» — скорее CapEx / revenue, а не расчёт прибыли или free cash flow.

Самая спорная часть — последняя стрелка в схеме «от электронов к токенам»: от токенов к выполненной работе. Локмиллер называет AI-агентов digital labor и переносит их в фактор труда модели Cobb–Douglas. Это производственная функция (или функция полезности), отражающая зависимость объёма производства Y от создающих его факторов производства — затрат труда L и физического капитала K). Она выглядит так Y(L,K)=A * (L * alpha) * (K * beta), где A — технологический коэффициент, α ⩾ 0 — коэффициент эластичности по труду, а β ⩾ 0 — коэффициент эластичности по капиталу. Как метафора это работает. Но в обычном growth accounting GPU и дата-центр скорее попадают в капитал, улучшение моделей — в технологию и продуктивность, а токены сами по себе ещё не равны полезному результату.

И ещё одна оговорка: closed-loop cooling в Abilene действительно резко снижает расход воды, но, по словам Локмиллера, для кампуса построена газовая станция на 350 МВт. Low-water не означает автоматически low-carbon.

Я бы рекомендовал посмотреть отрезки 9:26–18:30 и 23:54–40:45: сначала меняется представление о bottleneck, затем появляется редкий публичный разбор экономики мегаватта — со всеми его полезными цифрами и честными оговорками.

#AI #Engineering #Infrastructure #Architecture #Economics #Bigtech
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Building AI Factories For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education This seminar covers infrastructure and building AI factories at gigawatt scale. Follow along with the course schedule: https://mse435.stanford.edu/…
  • ❤ 5
  • 👍 1
  • 🔥 1
Post #4889 2.59K
Code of Leadership S2E16: Джун после кода - как растить инженеров, когда исполнение уезжает агентам (Рубрика #Education)

Сегодня 1 сентября, хотел анонсировать завтрашний эфир в 13:00 про джунов и не только. AI-агенты уже умеют за минуты собирать прототипы, писать тесты, находить ошибки и предлагать готовые изменения. Артефакты становятся качественнее, а разница между работой джуна и опытного инженера на демо — всё менее заметной. Но одинаковый результат ещё не означает одинаковую компетентность.

Кто сформулировал критерий правильности? Кто проверил решение в реальном контексте? Кто понимает ограничения системы и отвечает за последствия после релиза? И главное: где теперь начинающему инженеру получать опыт, если безопасные стартовые задачи постепенно забирают агенты?

В выпуске разберём:
— почему скорость выполнения, навык и ответственность — три разные метрики;
— как сохранить продуктивное усилие, на котором формируется инженерное мышление;
— почему PR — только середина работы, а не её завершение;
— как выстроить лестницу ответственности от фрагмента кода до владения компонентом;
— что менять в найме, если скорость написания кода больше не является сильным сигналом;
— почему нанимать джунов без системы наставничества становится особенно дорогим решением.

Поговорим и о том, как должна выглядеть такая система: кто отвечает за развитие инженера, какие рабочие ритмы помогают расти и зачем команде нужны два табло — полезность сегодня и самостоятельность завтра.

Это выпуск не только о джунах. Он о том, сможет ли компания выращивать сильных инженеров в мире, где первый вариант решения стал почти бесплатным.

#Career #Engineering #Software #Leadership #SelfDevelopment
YouTube Code of Leadership S2E16: Джун после кода - как растить инженеров, когда исполнение уезжает агентам AI-агенты сделали первый вариант решения быстрым и дешёвым. Джун теперь может за короткое время подготовить убедительный прототип, тесты и pull request. Но готовый артефакт ещё не доказывает, что инженер понимает систему, способен проверить результат и готов…
  • ❤ 12
  • 🔥 6
  • 👍 4
Post #4888 2.6K
SGLang: как структура программы ускорила LLM-инференс (Рубрика #AI)

Продолжая тему vLLM и PagedAttention (что я разбирал раньше), решил продолжить статье «SGLang: Efficient Execution of Structured Language Model Programs». У vLLM вопрос был: как эффективнее размещать KV cache в памяти. SGLang делает следующий ход: как не вычислять заново точные префиксы, уже обработанные в предыдущих обращениях к модели.

Команда Stanford, UC Berkeley, Shanghai Jiao Tong и Texas A&M смотрела не на отдельный запрос, а на целую LLM-программу: несколько вызовов модели, ветвление, параллельные генерации, общий контекст и структурированный ответ. Главная идея работы, опубликованной на NeurIPS 2024: если движок видит эту структуру, он может оптимизировать всю рабочую нагрузку.

Базовые инженерные идеи здесь такие

1️⃣ Переиспользование — RadixAttention
KV cache зависит от точной последовательности предыдущих токенов. SGLang хранит ссылки на него в radix tree — сжатом префиксном дереве — и находит самый длинный уже вычисленный префикс. GPU считает только хвост. Эффект: меньше повторной обработки промпта (prefill) и дубликатов в памяти, ниже задержка до первого токена, выше пропускная способность. Лучше всего это работает с длинными общими system prompts, few-shot примерами, повторяющимся RAG-контекстом и ветвями рассуждения.

2️⃣ Планирование вокруг дорогого состояния
Сохранить кэш мало: им нужно воспользоваться до вытеснения. Поэтому планировщик предпочитает запросы с длинным совпадением, а LRU-механизм удаляет давно не использовавшиеся листья, на которые не ссылаются активные запросы. Эффект: больше попаданий в кэш и полезнее батч. Учёт на CPU невелик, но есть риск несправедливости: запрос без выгодного совпадения может ждать дольше.

3️⃣ Использование детерминизма
Если на некотором участке грамматика JSON допускает только одно продолжение, сжатый конечный автомат (compressed FSM) склеивает этот участок и обрабатывает его за один проход вместо нескольких шагов. Для закрытых API авторы ещё предложили заранее генерировать текст после stop-маркера: если хвост совпадёт со следующей операцией программы, его можно переиспользовать. Интересно, но именно RadixAttention оказался фундаментом системы.

В экспериментах авторов на их задачах SGLang давал до 6,4 раза большую пропускную способность, чем тогдашние Guidance, vLLM и LMQL. Это общий максимум от нескольких оптимизаций, а не множитель одного RadixAttention. Эффект кэша падает, если префиксы не повторяются или основное время уходит на длинную генерацию.

Сегодня SGLang — уже не столько язык для LLM-программ, сколько полноценная система инференса. RadixAttention остался в ядре; поверх него появился многоуровневый HiCache: GPU → RAM → внешнее хранилище. Вокруг выросли непрерывное формирование батчей, страничное хранение KV cache, спекулятивное декодирование, разнесение обработки промпта и генерации, распределённый запуск, квантизация и OpenAI-совместимый API. Идея управляемого структурированного вывода тоже осталась, но исходный jump-forward на compressed FSM в 2025 году убрали ради упрощения кода. Теперь JSON Schema, regex и EBNF обслуживают отдельные грамматические движки: XGrammar по умолчанию, Outlines и llguidance.

В общем, для меня эта статья продолжает историю vLLM. Производительность часто растёт не от более быстрых вычислений, а от правильно выбранной системной абстракции. vLLM навёл порядок в размещении KV cache и разделении общих блоков. SGLang автоматизировал поиск и повторное использование произвольных точных префиксов между вызовами и связал это с планированием. Оптимизировали не модель, а работу вокруг неё.

#AI #Research #Software #Architecture #Engineering #DistributedSystems #Performance #SystemDesign
arXiv.org SGLang: Efficient Execution of Structured Language Model Programs Large language models (LLMs) are increasingly used for complex tasks that require multiple generation calls, advanced prompting techniques, control flow, and structured inputs/outputs. However,...
  • 🔥 5
  • ❤ 2
  • 👍 2
Post #4887 2.72K
Stanford MS&E435: inference как производственная система (Рубрика #AI)

После истории Google TPU и разговора с Dylan Patel про hardware-software co-design вторая лекция Stanford MS&E435 складывается в следующий кусок пазла. Она называется «The GPU Economy», но интереснее здесь не вопрос «какой чип победит?». Интереснее момент, в котором software становится производством: каждый новый запрос снова включает фабрику.

Встречу ведёт Apoorv Agrawal, преподаватель курса и партнёр Altimeter. Гости — основатель фонда Brad Gerstner и Sunny Madra, бывший президент Groq, перешедший с частью команды в NVIDIA. Gerstner задаёт экономическую рамку, Madra объясняет железо. Оптика у разговора соответствующая: инвестор в AI-инфраструктуру и человек со стороны её поставщика, поэтому прогнозы и рыночные числа я бы держал с хорошим запасом скепсиса.

Техническое ядро — inference как неоднородный workload. Prefill обрабатывает входной контекст, decode последовательно выпускает токены; разные части упираются в вычисления, память и latency по-разному. Поэтому вместо одного «лучшего GPU» появляется составная система:

» GPU с HBM остаётся универсальной машиной для тяжёлых частей;
» LPU Groq использует детерминированное выполнение, compiler-managed SRAM и предсказуемую задержку;
» NVLink связывает ускорители, а runtime отправляет каждой архитектуре подходящую часть работы.

По словам Madra, совместный прототип давал в 2,5 раза больше токенов при том же энергобюджете (правда, в лекции нет конфигурации и воспроизводимого benchmark, так что это заявление участника сделки). Но сам принцип уже виден в продуктовой архитектуре NVIDIA: Rubin GPU и Groq LPX проектируются как одна inference-система (подробнее можно почитать в анонсе про Groq 3 LPX)

Не менее важна продуктовая часть. Groq не заставила разработчиков сначала полюбить новую архитектуру — она спрятала её за API GroqCloud. А затем вместо лобовой войны с NVIDIA команда разложила workload и нашла слой, где две архитектуры дополняют друг друга. Для deep tech совместимость с доминирующей платформой иногда сильнее чистой победы в benchmark.

Кстати, в разговоре NVIDIA несколько раз «покупает Groq за $20 млрд». Формально всё тоньше: стороны заключили неисключительную лицензию, часть команды перешла в NVIDIA, а Groq осталась независимой и сохранила GroqCloud. В отчётности NVIDIA раскрыто $17 млрд совокупного вознаграждения и отдельно сказано, что акции, клиентские контракты и существующие продукты не покупались. По-факту, это покупка части интеллектуальной собственности + покупка команды.

Дальше начинается экономика. Стоимость единицы inference падает, но reasoning и агенты делают больше шагов, вызывают инструменты, проверяют себя и работают часами. Поэтому удешевление токена не обязательно снимает дефицит GPU — оно может увеличить общий спрос. Почти парадокс Джевонса, только вместо угля мы сжигаем матричные умножения.

Но здесь я бы поспорил с Gerstner: больше токенов ещё не означает больше ценности. Мы уже обсуждали token burn как proof of work и ненулевую предельную стоимость в AI pricing. Для продукта взрослая метрика — не tokens per task, а cost per verified outcome: полезный результат вместе с retries, review и rework.

Тут есть даже непрямая связь с роботами. Для physical AI мало tokens per watt: нужны успешные действия на джоуль, p99 latency замкнутого control loop и доказанная безопасность. В разборе Waymo цена ошибки уже измерялась не токенами. И вот здесь «inference-фабрика» заканчивается не ответом в чате, а движением машины в физическом мире.

Я бы смотрел внимательно отрезок примерно с 16-й по 35-ю минуту: там разговор перестаёт быть презентацией большого AI-будущего и становится хорошим обсуждением системной инженериеи.

#AI #Engineering #Architecture #Infrastructure #Agents #Robotics
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | The GPU Economy For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education Follow along with the course schedule: https://mse435.stanford.edu/ Guest Speakers: Sunny Madra, Groq (now Nvidia) and Brad Gerstner, Altimeter…
  • 🔥 4
  • ❤ 3
  • 👍 2
Post #4886 2.98K
Post #4885 3.1K
JetBrains Developer Ecosystem 2026: что 15 509 разработчиков говорят об AI-агентах (Рубрика #AI4SDLC)

JetBrains опубликовала срез десятого ежегодного Developer Ecosystem Survey. Опрос проходил с мая по июль 2026 года, в анализ вошли 15 509 профессиональных разработчиков. Было восемь языков, региональные квоты и статистические веса по региону, занятости, языкам программирования и знакомству с продуктами JetBrains.

Что получилось:

- 90% респондентов используют AI-агентов для разработки на работе хотя бы раз в неделю, 68% — ежедневно;
- Claude Code вырос с 18% в январе до 39%. В США — 47%, а для 31% разработчиков это основной AI-инструмент;
- GitHub Copilot снизился с 29% до 21%, Cursor — с 18% до 12%;
- Codex вырос с 3% до 16%, а его узнаваемость — с 27% до 65%;
- OpenCode набрал 7%, Google Antigravity — 6%, JetBrains AI Assistant и/или Junie вместе — 9%.

Рост Claude Code и Codex — сильный рыночный сигнал: расклад рабочих инструментов быстро меняется. Но показатель использования здесь легко прочитать слишком широко.

Заголовок говорит об агентах, но вопрос на графике шире: какие AI tools респондент использует на работе. В одном списке смешаны агенты, ассистенты и редакторы; ответы множественные, а показана лишь часть списка. Поэтому 39% и 21% — не доли рынка, не оплаченные лицензии и не телеметрия. Один разработчик мог отметить Claude Code, Copilot и Codex.

С репрезентативностью тоже есть нюанс. Выборка большая, международная, квотированная и взвешенная, но вероятностного случайного отбора в опубликованных материалах нет. Был открытый opt-in-набор с призами, скидкой на лицензию и наградой за приведённых участников. Большое N уменьшает случайный шум, но не самоотбор — например, повышенный интерес к AI или JetBrains.

Подробная ссылка из нового материала пока ведет на методологию опроса 2025 года. Для волны 2026 не опубликованы каналы рекрутинга, показатель участия, размеры страновых подвыборок, эффективный размер после взвешивания и обезличенные исходные данные. Поэтому 47% для США стоит читать осторожнее, чем глобальный результат.

И еще: январские цифры взяты из AI Pulse, а летние — из Developer Ecosystem Survey. Это разные срезы, а не наблюдение за одними людьми. Можно говорить, что доля Copilot между опросами снизилась. Нельзя — что конкретные пользователи «перешли» в Claude Code или почему они это сделали.

Так что я бы использовал исследование как рыночный радар, а не точный измерительный прибор. Claude Code вышел вперед среди показанных инструментов, Codex быстро набрал долю, прежние лидеры просели. Но для решения внутри компании нужен уже свой приборный щит: активное использование, принятые изменения, время ревью, доля переделок, инциденты и стоимость полезной задачи. Иначе глобальные 90% легко превращаются в еще одну красивую цифру внедрения без ответа на вопрос, что стало лучше.

#AI4SDLC #AI #Agents #Research #Metrics #DevTools
  • ❤ 4
  • 👍 3
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →