vLLM и PagedAttention: как идеи из ОС ускорили LLM-инференс (Рубрика #AI)
Разобрал наконец целиком статью «Efficient Memory Management for Large Language Model Serving with PagedAttention» (Symposium on Operating Systems Principles (SOSP) 2023) — ту самую, из которой вырос vLLM, один из самых популярных open-source движков LLM-инференса. Я уже упоминал её в обзоре Таненбаума, а теперь хочу разобрать саму инженерную идею. Она красивая: авторы ускорили инференс в разы, не меняя модель и почти не трогая вычисления — они починили управление памятью.
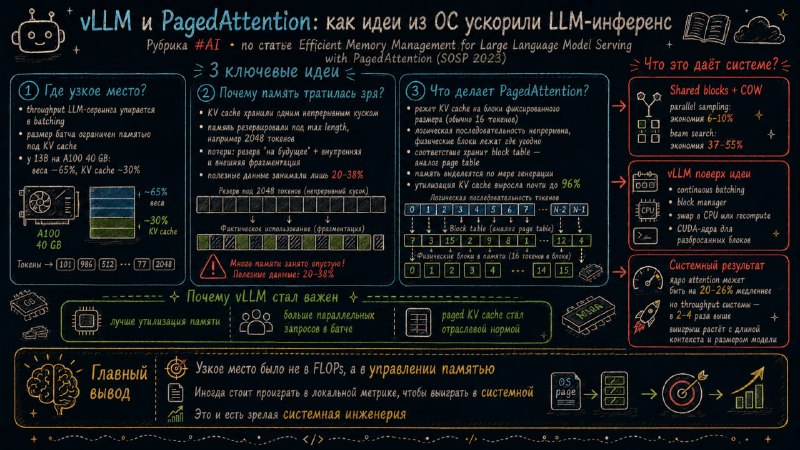
Контекст такой. Пропускная способность LLM-сервинга упирается в батчинг: GPU работает эффективно, когда генерирует токены сразу для многих запросов. А размер батча ограничен памятью под KV cache — ключи и значения attention для всех уже обработанных токенов каждого запроса. В конфигурации из статьи — OPT-13B с весами в FP16 на A100 с 40 ГБ — веса занимают около 65% памяти, KV cache — ещё около 30%. Именно кэш в этом раскладе определяет, сколько запросов поместится в батч.
Команда из Berkeley (среди авторов — Woosuk Kwon, Zhuohan Li и Ion Stoica) показала, что системы того времени — FasterTransformer, Orca — обращались с этой памятью расточительно. KV cache запроса хранился одним непрерывным куском, который резервировался сразу под максимальную длину, например 2048 токенов, даже если ответ занимал пятьдесят. Потери складывались из трёх частей:
1) слоты, зарезервированные «на будущее»
2) внутренняя фрагментация кусков, выделенных с запасом
3) внешняя фрагментация аллокатора
По замерам авторов, полезные данные занимали лишь 20–38% памяти KV cache — остальное пропадало.
Решение — PagedAttention: виртуальная память и страничная организация из операционных систем, перенесённые в инференс. KV cache режется на блоки фиксированного размера (по умолчанию 16 токенов) — аналог страниц. Логически последовательность непрерывна, физически её блоки лежат где угодно, а соответствие хранит таблица блоков — аналог page table. Память выделяется по мере генерации, недозаполненным остаётся лишь последний блок: в экспериментах авторов утилизация KV cache выросла почти до 96%.
Дальше включается второй классический механизм — разделяемые страницы и copy-on-write, как при fork процесса. При parallel sampling несколько вариантов ответа ссылаются на одни физические блоки промпта; в beam search гипотезы делят общие префиксы, а при расхождении копируется один блок, а не весь кэш. Авторы сообщают об экономии 6–10% памяти для parallel sampling и 37–55% для beam search.
Поверх алгоритма построен сам движок vLLM: continuous batching (итерационное планирование из Orca), менеджер блоков, вытеснение целых последовательностей при нехватке памяти — со swap в память CPU или пересчётом — и собственные CUDA-ядра для работы с разбросанными блоками. Честная деталь: ядро attention стало на 20–26% медленнее из-за доступа через таблицу блоков. Но система в целом даёт в 2–4 раза больший throughput, чем FasterTransformer и Orca, при той же задержке, потому что в память влезает кратно больше параллельных запросов. Выигрыш растёт с длиной последовательностей и размером модели.
Дальнейшее известно: летом 2023-го vLLM вышел в open source, и идею быстро переняли конкуренты — paged KV cache описан в документации TensorRT-LLM, а Hugging Face TGI прямо использует CUDA-ядра vLLM. По-моему, подход по факту стал отраслевой нормой.
Для меня главный вывод двойной.
1️⃣ Узкое место LLM-инференса оказалось не в FLOPs, а в управлении памятью, и лечится оно приёмами из учебника по ОС, которым больше полувека.
2️⃣ Авторы сознательно проиграли в локальной метрике (скорость ядра), чтобы выиграть в системной (throughput при заданной задержке). Умение выбрать уровень, на котором оптимизируешь, — признак зрелой системной инженерии.
#AI #Research #Software #Architecture #Engineering #RnD
Post #4823
2.45K
- ❤ 5
- 👍 4
- 🔥 2