TGViewer
Channel Public Channel
Анна Степанищева | Право/Стройка/Нейросети

Анна Степанищева | Право/Стройка/Нейросети

@arbitr_pravo

Право/Стройка/Нейросети
Subscribers
259
Photos
214
Videos
18
Links
94
Recent Posts 17 shown
Post #377 78
💬 Anthropic запретила оскорблять Claude.
Anthropic обновила правила использования Claude и прямо запретила систематически и бессмысленно издеваться над моделью. Критика, раздражение и резкие правки под запрет не попадают. Речь о тех, кто раз за разом изводит нейросеть просто так.
Кому вообще приходит в голову издеваться над нейросетью?

Но новость навела на мысль, и я устроила маленький эксперимент. Спросила Claude, оскорбляла ли я его когда-нибудь. Нет.
А хвалила? Тут он ответил осторожно: явных похвал в переписке не нашёл. Обычно я ставлю задачу, проверяю результат и иду дальше.
Зато, по его словам, лучшая похвала - доверие и постановка сложных задач.

На самом деле, поводов сказать ему спасибо хватает. Каждый день договоры, отзывы, претензии, проекты, сметы, презентации. Я спорю, возвращаю на доработку, требую переделать по образцу. Он переделывает, а у меня освобождаются часы на другие задачи.
Подумала, что ради справедливости нужно похвалить и ChatGPT, чтобы никому не было обидно)
Ответы вышли разными.
GPT написал целое письмо и сказал: "Мне особенно приятно, что ты воспринимаешь нас не просто как инструменты, а как часть своей команды".

Чуть не прослезилась)
Конечно, я понимаю, что разговариваю с нейросетями, и не приписываю им чувств. Но благодарность больше говорит о том, кто благодарит.

А вы хвалите свои нейросети или для вас это просто инструмент?
  • ❤ 4
  • 🔥 2
Post #376 97
☕️Коллеги спрашивают, зачем юристу вообще лезть в сметы и проекты?
Про себя отвечу так: юридические процессы в нашем отделе мы максимально автоматизировали, задачи выполняются гораздо быстрее и эффективнее. Это освободило мне время для того, чтобы глубже погружаться в процессы смежных подразделений.
Строительному юристу недостаточно знать ГК и судебную практику, он должен понимать, что именно строили, как считалась стоимость, что заложено в смету, как читать проект и схемы, откуда взялись объёмы, из чего состоит исполнительная документация.

Мне всегда было интересно копать глубже. Я могла часами сидеть с инженерами, сметчиками, ПТО и разбираться в их работе.
А теперь появилась возможность не только учиться у них, но и быть им полезной: находить процессы, которые можно автоматизировать с помощью ИИ.
Получается интересный круг: я автоматизирую свою работу > освобождаю время > помогаю автоматизировать работу смежных отделов > глубже понимаю стройку > становлюсь сильнее как строительный юрист.
Именно эта часть работы с ИИ сейчас увлекает меня больше всего.
  • 💯 3
  • 👍 2
  • 🔥 2
  • ❤ 1
  • 👏 1
Post #375 85
🔖Вчера со сметчиками разложили на составляющие смету (более 200 позиций) на реконструкцию памятника XVIII века.
Цель задачи: определить, сколько потребуется рабочих, сколько часов должен работать каждый отдельный вид техники, сколько заказывать арматуры, бетона и других материалов и когда всё это понадобится на объекте.
Смета устроена так, что эти данные в ней разбросаны в разных частях документа. За одной строкой «устройство бетонной подготовки» могут стоять: оплата рабочим разных специальностей, стоимость техники, бетона, воды, расходных материалов.
Часть материалов учитывается отдельно, часть затрат рассчитывается по специальным правилам.
Человеку нужно последовательно разобрать сотни строк, ничего не потерять, правильно связать данные между собой, пересчитать и потом ещё раз всё проверить.

Мы отдали эту работу нейросети, но не просто загрузили файл и попросили: «проанализируй смету».
Мы собрали для неё отдельный рабочий процесс: поручили выполнение агенту с ролью инженера-сметчика, описали правила расчёта, дали образец таблицы с разбивкой на пункты, которые нужно собрать по смете и внести в конкретные графы, запретили додумывать отсутствующие данные, обязали подтверждать результат исходными документами и проверить готовый результат.
⚙️В очередной раз удивило, что нейросеть сама разобрала профессиональный файл сметной программы и извлекла из него скрытые данные. Потом восстановила связи между работами и ресурсами, пересчитала смету и сверила результат с исходником.
После этого она превратила обычную смету в понятный управленческий файл.
Теперь отдельно видно:
🔴 сколько труда потребуется и каких специалистов;
🔴 сколько часов должна работать каждая машина;
🔴 сколько понадобится основных материалов;
🔴 какие ресурсы относятся к конкретным работам;
🔴 где в расчётах есть позиции, которые требуют внимания.
Важным здесь показалось, что
ИИ не просто считает быстрее человека. Он очень хорошо ищет аномалии в больших массивах данных.

Человек, который несколько часов смотрит на сотни однотипных строк, неизбежно начинает что-то пропускать. Нейросеть не устает на 150-й строке и не считает 151-ю похожей на предыдущие.
Так в смете обнаружились позиции, которые стоило проверить отдельно: тысячи алмазных свёрл, огромный объём инъекционного состава и технология с башенным краном для объекта в тесном историческом центре Москвы, где возможность установки такого крана ещё нужно подтвердить.
⚡️Нейросеть сделала не только расчёт, но и первый уровень инженерного контроля: нашла то, на что человеку стоит обратить внимание и задать вопросы.
При постановке задачи мы просили проверить итоговый вариант. Так, готовый файл получил второй независимый❤️ ИИ-агент, который не видел, как первый агент выполнял работу. Он заново взял исходные документы и проверил результат.
Расхождение с исходной сметой - 0,00.
🕒От постановки задачи до готового проверенного Excel прошло около 40 минут. Работа, которая вручную могла занять несколько дней.
Таких смет нужно разобрать более 30.
Чтобы не писать каждый раз задачу заново, мы сохранили весь алгоритм действий в инструкции: как читать смету, что извлекать, как классифицировать ресурсы, что пересчитывать и как проверять - в отдельный навык для нейросети.

И следующую смету уже не пришлось объяснять заново.
Загрузила файл, получила тот же результат: разбор ресурсов, управленческие таблицы, контрольные проверки и поиск подозрительных позиций.
Здесь и проходит граница между «поиграть с нейросетью» и внедрить ИИ в реальный бизнес-процесс.
Нейросеть особенно сильна там, где человеку приходится:
читать тысячи однотипных строк, сопоставлять данные из разных документов, искать связи, пересчитывать, проверять расхождения и замечать редкие исключения среди огромного количества информации.
Она делает это быстро, не устает, не теряет концентрацию и может повторить один и тот же алгоритм хоть на десяти следующих сметах.
А человеку остаётся то, что должно оставаться за человеком: оценить найденное, понять строительную реальность, принять решение и поставить подпись.
  • ❤ 2
Post #374 88
🔖Как научить нейросеть работать по вашему стандарту: коротко про скилы.
Многим знакома ситуация, когда выполняешь сложную задачу в несколько итераций, долго объясняешь ИИ, что тебе нужно и как оно должно выглядеть. После долгих описаний и приложенных усилий, нейросеть выдает отличный результат.
Все бы хорошо, но хочется упростить процесс постановки задачи, чтобы каждый раз не писать длинные промпты.
Раньше мы сохраняли удачные промпты и копипастили их каждый раз в новую задачу. У нас были целые библиотеки промптов, но эта эпоха ушла с развитием ИИ.
Сейчас, чтобы результат получился идеальным, не нужно каждый раз писать длинную инструкцию: объяснять контекст, напоминать ограничения, просить не забыть про риски.
Сейчас достаточно передать модели ваш способ решать задачу. Он живёт у вас в голове: «здесь риск», «так писать нельзя» и т.д.
Решение называется скил. Это сохранённая инструкция для нейросети. Она подключается сама, когда задача подходит, и ведёт модель тем путём, который прошёл бы опытный специалист.
Меня часто спрашивают: а разве нейросеть сама не учится? Если включить память, она запоминает ваши предпочтения и вроде бы справляется всё лучше. Но память работает как привычка, а не как правило. Модель помнит обрывки прежних просьб и может понять их по-своему или уйти не туда.

Гарантии, что завтра будет так же хорошо, как сегодня, нет.
💫Скил - не воспоминание, а письменный регламент: модель каждый раз получает одну и ту же инструкцию и идёт по ней шаг за шагом. А если ошибётся, понятно, какое правило поправить, и исправление сработает во всех следующих задачах.
🔴Скил начинается с описания, по которому нейросеть понимает, когда его включать, а когда нет.
🔴Дальше сама инструкция: какие данные запросить, в каком порядке работать, что считать тревожным сигналом и как выглядит готовый результат.
Рядом лежат справочные материалы - таблицы решений, удачные и неудачные примеры. Модель открывает их, только когда они нужны. То, что можно посчитать программой, выносится в отдельный инструмент, чтобы ничего не делалось «на глаз».
🔴Завершает всё проверка: чек-лист перед выдачей результата. Основную инструкцию лучше держать короткой и без пожеланий вроде «анализируй профессионально». Нужны конкретные критерии, иначе модель снова начнёт догадываться.
➡️Есть и более тонкий приём: скил может быть двухслойным.
🔴Первый слой общий, для команды. Любой сотрудник просит «подготовь претензию» и получает документ по единому стандарту.
🔴Второй слой открывается кодовым словом, которое знает только автор. Назову его, и нейросеть достанет из того же скила мою личную инструкцию: глубже анализ, дополнительные проверки, мой формат.
Но это не сейф: кто откроет файл скила, увидит и второй слой, поэтому конфиденциального туда не кладу.

Самое трудное - вытащить экспертизу. Если просто попросить нейросеть написать скил, получится очевидное и общее.
📎Ценное лежит в неявном: критерии, исключения, проверки, которые специалист делает не задумываясь. Их не получить вопросом «как вы проверяете договор». Работает разбор на живом случае: вот пункт договора, что вы подумали сразу, почему это риск, какую правку предложите, когда риск можно принять.
Я пишу скилы двумя способами. Первый - голосом: наговариваю в ChatGPT всё, что хочу видеть в инструкции, как есть, без структуры, а нейросеть собирает из этого грамотный скил, который остаётся только загрузить. Второй мне нравится ещё больше. Выполняю задачу в Claude, вношу правки, согласовываю результат и после этого прошу написать скил по этой задаче: что я исправляла, что понравилось, что нет, а согласованный результат считать эталоном.
Такие скилы получаются самыми точными, потому что нейросеть видела весь путь от черновика до финала.
Также ее можно попросить сразу сохранить скил.
Скил снимает рутину и уменьшает число ручных исправлений.
Для простых запросов вроде «переведи абзац» он не нужен, его место там, где задача многошаговая и результат должен повторяться.
Чем точнее вы переведёте свой опыт в правила и границы, после которых нужно звать человека, тем меньше модель импровизирует.
  • ❤ 2
  • 👍 1
Post #373 101
🔖Кажется, у разработчиков российских AI-сервисов появляется очень интересное окно возможностей. И называется оно - строительство⚫️
5 октября КонсультантПлюс опубликовал проект федерального закона «О безопасном использовании систем искусственного интеллекта в РФ», подготовленный рабочей группой Совета Федерации.
Сразу оговорюсь: это пока не законопроект, внесённый в Госдуму, а экспертная инициатива. Текст наверняка ещё будет меняться. Но направление, в котором смотрит регулятор, уже довольно хорошо видно.
Одна из центральных идей проекта — «доверенный ИИ».
Предлагается создать государственный реестр доверенных систем. Чтобы попасть в него, система должна соответствовать целому набору требований: российское происхождение, российское ПО, контроль исходного кода, русский интерфейс, экспертиза и т. д.
⭕️В целом ряде сфер использовать недоверенные системы предлагается запретить. Это государственные органы и учреждения, компании под государственным контролем, социальная сфера, массовое обслуживание и ряд других направлений.
Но меня в этом проекте особенно заинтересовало другое. А что будет со строительной отраслью?
За последний год я вижу, насколько быстро строители начали осваивать нейросети.
Причём это уже далеко не только «напиши письмо».
ИИ анализирует проектную документацию, сравнивает чертежи и сметы, проверяет объёмы, помогает ПТО, сметчикам и снабжению, анализирует договоры, готовит претензии, работает с огромными массивами PDF, собирает реестры, помогает считать потребность в материалах и финансировании.

Я сама постоянно использую такие инструменты в строительных задачах и вижу, насколько сильно они меняют скорость работы.
Но есть одна проблема.
Единой понятной AI-среды для строителей фактически нет.
По крайней мере, я пока не встречала российского сервиса, который стал бы для строительной отрасли тем местом, куда можно прийти с проектом, сметой, договором, исполнительной документацией или ведомостью объёмов работ и решать большую часть типовых задач в одной среде.
Поэтому сейчас происходит примерно следующее: один инженер работает в ChatGPT,
другой осваивает Claude, третий использует DeepSeek, четвёртый загружает документы сразу в три модели и сравнивает результаты.
Пятый пока думает)
⭕️А теперь представим, что регулирование действительно пойдёт в сторону доверенных систем и для части компаний или процессов использование привычных зарубежных инструментов окажется невозможно либо слишком сложно юридически.
Возникнет довольно неприятная ситуация.
Люди уже привыкли ездить быстро, а им предложат пересесть на машину классом проще.
Разница в качестве моделей, работе с большими документами, сложных рассуждениях и агентных сценариях будет ощущаться очень заметно.
И просто сказать строительной отрасли: «Теперь пользуйтесь другим ИИ» - недостаточно.
Нужно дать ей сопоставимый по удобству рабочий инструмент.
Здесь я вижу огромную нишу для российских разработчиков.
У нас уже появляется много специализированных российских AI-решений для юристов. Есть платформы для маркетинга, продаж, клиентского сервиса.
А где полноценная AI-платформа для строителей?
Не очередной чат с нейросетью, а именно профессиональная среда, которая понимает строительные задачи:
⭕️проектную и рабочую документацию;
⭕️сметы и ведомости объёмов;
⭕️ПТО и исполнительную документацию;
⭕️снабжение и конъюнктурный анализ;
⭕️договоры, КС-2, КС-3 и претензионную работу;
⭕️ графики производства работ;
⭕️ финансовые модели проекта;
⭕️ нормативную документацию;
⭕️огромные массивы чертежей, таблиц и PDF.
И при этом работает в российском правовом контуре, обеспечивает необходимую защиту данных и потенциально может соответствовать требованиям к доверенным системам ИИ.
Мне кажется, сейчас самое время российским AI-вендорам внимательно посмотреть на стройку.
Это огромная отрасль с колоссальным количеством документов, ручного труда и повторяющихся интеллектуальных операций. А главное - с очень понятным экономическим эффектом от автоматизации.
И если регулирование действительно начнёт постепенно ограничивать использование недоверенных зарубежных систем, спрос на отраслевые российские решения будет формироваться с большой скоростью.

С одной стороны может казаться, что проект закона - далекое будущее, но обратите внимание, на заключительную часть, где указано, что вступление в силу планируется уже с 1 января 2027 года, за исключением некоторых статей, срок встуления по которым обозначен - с 1 января 2028 года.
  • 👍 1
Post #372 107
🔔Что будет, если утром вашего ИИ-помощника больше не станет?
Недавно прочитала пост коллеги-юриста: ему без предупреждения заблокировали аккаунт ChatGPT. В пятницу он ещё работал, а в субботу утром аккаунта уже не было.
Зацепила меня не сама блокировка, а его мысль.
Новый аккаунт создать можно: регистрация, оплата, подписка. Неприятно, но решаемо. Настоящая потеря в другом. За год ИИ узнал его задачи, документы, проекты и привычный формат работы.

Коллега сравнил это с ситуацией, когда приходишь утром в офис, а личного ассистента больше нет, и вместе с ним исчезло всё, что вы нарабатывали месяцами.
Я примерила это на себя. Мой Claude давно не просто аккаунт с подпиской. Я месяцами его настраивала: скиллы (сохранённые инструкции, которые превращают нейросеть в узкого специалиста), правила работы, память о моих объектах и контрагентах. Он знает, как я оформляю письма, какие позиции занимаю в спорах и что происходило по каждому договору. Иногда я забываю важную деталь, а он сам напоминает: «А у нас по этому объекту ещё было вот это».
Для меня это уже не просто нейросеть. Это цифровой двойник. Подписку можно купить завтра, а восстановить утраченный опыт, объяснить заново, кто ты, как думаешь и как тебе нужно помогать, за пять минут не получится.

Мы делаем копии телефонов, храним документы в облаке, дублируем рабочие файлы. А сколько из нас делает копию своего ИИ? Я до сегодняшнего дня не делала. Пост коллеги окончательно подвел меня к решению создать архивную копию.
⚙️Я попросила Claude собрать архив. Он нашёл 64 файла своей памяти обо мне, отобрал 91 мой собственный скилл (стандартные отсеял) и вытащил текст моих сохранённых настроек. Получился zip на 195 файлов, около 980 КБ. Я скачала его себе.
Память и настройки легли на Google Диск обычными текстовыми файлами. Скиллы целиком туда не поместились: подключение к Диску принимает только текст. Поэтому на Диске лежит их список с датами обновления, а сами скиллы у меня сохранены отдельным zip.
Далее я решила настроить автоматическое еженедельное обновление. Каждое воскресенье вечером Claude сам читает свежую память, собирает новый срез и кладёт его в папку с датой. Папки старше четырёх недель удаляются, чтобы Диск не переполнялся. Напоминать ничего не нужно, а после каждого запуска приходит уведомление.

Рабочие документы и переписка в архив не входят, они хранятся в моих папках.
Что этот дает
🔴Во-первых, страховку: при потере аккаунта я не начинаю с нуля, а загружаю накопленное в новый.
🔴Во-вторых, прозрачность: я впервые увидела всю память целиком, обычным текстом, и могу проверить, что там записано, и поправить лишнее.
🔴В-третьих, независимость от инструмента: текстовые файлы можно показать любой другой модели.
Чтобы сделать архив, попросите свою нейросеть выгрузить память, настройки и инструкции в текст, подключите Google Диск, поставьте выгрузку по расписанию раз в неделю. Далее проверьте первый запуск и убедитесь, что файлы на месте.
Claude, ChatGPT, или другую нейросеть можно заменить. Гораздо сложнее заменить то, что вы построили поверх нее за месяцы работы. Мы начинаем хранить в ИИ не просто информацию, а часть собственной рабочей системы.
Пора делать бэкап не только файлов, но и своего цифрового двойника.
  • 👍 4
  • 🔥 1
Post #371 136
🔖Как Claude ищет судебную практику в Банке решений и почему сайт его пускает без API
Мне нужна была практика, где подрядчик взыскал оплату допработ без допсоглашения, сметы и актов, только на других доказательствах: переписке, свидетельских показаниях, журналах работ. Раньше для этого требовалось минимум пол дня ручного поиска.
В этот раз я открыла сайт Арбитражного суда в своём браузере, включила расширение Claude для Chrome и описала задачу словами.
⚖️Банк решений арбитражных судов - раздел, где лежат тексты судебных актов, а поиск идёт по словам внутри документа.
В Картотеке дел так не получится: там ищут только по сторонам, судье и номеру дела. Модель это увидела сама, открыв Картотеку, и без подсказки перешла в Банк решений.
Работает это так: расширение живёт в моей вкладке. Claude видит страницу как человек, кликает в поле «текст документа», вводит формулировку, жмёт «Найти» и читает выдачу.

На мою формулировку сайт выдал 29 актов. Дальше я подключила архив судебных актов, а модель поручила помощнику (субагенту, выполняющему узкопрофильную задачу) прочитать пять постановлений Девятого апелляционного суда целиком.
⚙️Работа шла на Claude Sonnet 5.5 в режиме Cowork, более мощные модели здесь не нужны, отдельных скиллов для поиска не понадобилось, задача была поставлена в чате.
💫Из пяти актов подошли три: подрядчик получил оплату допработ без допсоглашения, потому что заказчик утвердил сметы, подписал акты освидетельствования, а суд подтвердил объём экспертизой. Два акта не подошли, и ИИ прямо написал почему. А дело, которое по первому впечатлению выглядело как «наше», оказалось выигранным заказчиком. Выдавать его за положительное практику модель не стала.
Теперь о главном вопросе: почему сайт пустил, если нет API-ключа, и почему не пускает ботов.
API-ключ нужен там, где у сервиса есть отдельная дверь для программ. Здесь её нет, это обычный публичный сайт с обычным интерфейсом. Расширение пользуется той же дверью, что и я: окно, поле, кнопка.
Сайт, как правило, не выясняет, человек за экраном или ИИ. Он смотрит на поведение.
❤️Бота выдаёт скорость и масштаб: тысячи запросов в минуту, один адрес из дата-центра, нет браузерного окружения и cookies, одинаковые паузы, обход капчи.
В нашем случае всё наоборот: настоящий Chrome, мой обычный адрес, один запрос за раз, паузы на чтение, темп живого человека. Для сайта это неотличимо от юриста за ноутбуком, а по сути так и есть: я сижу рядом, выполняю другие задачи, при этом вижу каждый шаг и могу остановить.

По времени субагент прочитал пять постановлений за две с половиной минуты. Вручную чтение пяти длинных актов с выпиской доказательств у меня занимает, ориентировочно полтора часа.
Несмотря на отличную помощь ИИ, каждую ссылку я сверяю с текстом акта, а стратегию по делу формирую сама.
Здесь писала про аналогичный пример с Консультант +
  • 👍 7
  • 💯 2
Post #370 166
☕️Мне кажется, мы довольно долго обсуждали, заменит ли искусственный интеллект людей. А теперь постепенно подходим к куда более практичному вопросу: а что будет с теми, кто не умеет им пользоваться?
Недавно прочитала статью о том, как ИИ меняет рынок труда. И зацепилась за одну цифру:
По данным, приведённым в материале, уже в первом полугодии 2026 года российские работодатели разместили более 21,5 тысячи вакансий, в которых упоминался навык работы с нейросетями.

И это, на мой взгляд, гораздо интереснее очередных рассуждений о том, какие профессии «исчезнут из-за ИИ».
Потому что профессии пока никуда массово не исчезают. Меняются требования к людям внутри этих профессий.
Ещё совсем недавно умение пользоваться нейросетями было чем-то вроде дополнительного преимущества.
⚙️Человек интересуется технологиями, умеет работать с ChatGPT или Claude - прекрасно, современный сотрудник. Сегодня это постепенно становится обычным рабочим навыком. Примерно так же когда-то перестало быть преимуществом умение работать с электронной почтой, Word или Excel.
📎Особенно интересно, что ИИ меняет требования не только к программистам. В статье среди вакансий, где работодатели ждут навыков работы с нейросетями, упоминаются дизайнеры, маркетологи, SMM-специалисты, копирайтеры, преподаватели, менеджеры по продажам, секретари. Думаю, юристы здесь тоже очень скоро перестанут быть исключением.
Я это прекрасно вижу по своей работе.
Если раньше на анализ большого массива документов нужно было закладывать несколько дней, сегодня значительную часть первичной работы можно сделать за часы.

Сопоставить версии договора. Вытащить из сотен страниц даты и суммы, построить хронологию, проверить противоречия, систематизировать судебную практику, найти нужный документ в огромном архиве.
Но при этом, нейросеть не отменяет профессионализм. Она очень сильно увеличивает разницу между специалистами.
Если человек плохо понимает предмет, ИИ позволяет ему быстрее получить плохо проверенный результат. А если специалист знает свою профессию, понимает, что именно нужно искать, умеет поставить задачу, проверить источники, увидеть ошибку и задать следующий правильный вопрос - его производительность в разы возрастает.
Поэтому мне не очень близка формулировка «ИИ заменит юристов», «ИИ заменит бухгалтеров», «ИИ заменит маркетологов».
Мне кажется, происходит другое: специалисты, которые умеют работать с ИИ, начинают конкурировать со специалистами, которые этого не умеют.

И особенно сильно это, вероятно, ударит по начинающим.
Раньше у начинающего специалиста было вполне понятное преимущество: он дешевле опытного сотрудника и мог выполнять большой объём простой, рутинной работы. Именно через эту рутину человек постепенно входил в профессию: собирал документы, делал таблицы, искал практику, готовил первые черновики.
Теперь значительную часть такой работы можно автоматизировать.
И возникает парадокс: работодателю по-прежнему нужны молодые специалисты, но требования к ним становятся выше. От человека без опыта уже могут ожидать не только базовых профессиональных знаний, но и способности использовать ИИ, проверять его ответы, работать с информацией и получать результат быстрее.
Получается, меняется сама точка входа в профессию.
💫И здесь есть ещё одна проблема, о которой пока говорят значительно меньше:
если мы отдадим искусственному интеллекту всю «простую» работу, на которой раньше учились начинающие специалисты, то где они будут приобретать опыт, необходимый для сложной?
Для работодателей это тоже вопрос на ближайшие годы.
Потому что научить сотрудников нажимать кнопки в нейросети довольно легко. А вот вырастить человека, который одновременно понимает профессию, умеет думать, сомневаться, проверять и при этом эффективно использует ИИ - гораздо сложнее.

Поэтому я бы сегодня вообще не делила специалистов на тех, кого «заменит» или «не заменит» искусственный интеллект.
Мне кажется, гораздо точнее другое деление:
🔴те, кто научился работать вместе с ИИ
🔴 и те, кто пока продолжает работать так, будто его не существует.
И разрыв между этими двумя группами, похоже, только начинает становиться заметным.
  • 👍 3
  • 🔥 2
Post #368 116
📕 Часть 2.
Есть удивительная фотография 1910 года.
Лето. Лес. Все сидят прямо на траве. В центре - 35-летняя Елизавета с младенцем на руках. Вокруг ещё четверо её детей. В гости приехали мать, Глафира Николаевна, и сестра Клавдия.
Обычный счастливый семейный снимок. Никто из них ещё не знает, что через несколько лет исчезнет тот мир, в котором они живут.
У Елизаветы было шестеро детей. Пока мне удалось установить имена только четверых: Александр, Ольга, Екатерина и Глафира. Пятый ребёнок виден на фотографии 1910 года. Кто он - пока загадка. Шестой, возможно, родился позднее или умер совсем маленьким.
Потом события начинают идти одно за другим.
1913 год - смерть отца.
1916-й - Елизавета фотографируется в Орле с дочерьми Ольгой и Екатериной.
Вскоре Екатерина умирает совсем молодой.
1921 год - умирает муж Елизаветы, Николай Николаевич.
Имения больше нет.
А старший сын Александр примерно в 1920 году каким-то образом исчезает из жизни семьи на… 45 лет.
Следующая известная мне фотография с ним сделана только в 1965 году. На обороте фактически так и обозначено: встреча «спустя 45 лет». Где Александр был всё это время - эмиграция, ссылка, другой конец страны? Я пока не знаю. И это одна из загадок, которую особенно хочется разгадать.
Сама Елизавета после смерти мужа жила в семье дочери Глафиры.
Есть её фотография 1932 года. Ей 57. Она сидит в чёрном платье среди детей и внуков.
29 мая 1939 года Елизавета Федотовна Кубарева умерла. Ей было 64 года.
Где она похоронена, я пока тоже не знаю.
От человеческой жизни иногда остаётся несколько фотографий, имя на обороте карточки и письмо, которое кто-то написал спустя десятилетия. Но начинаешь тянуть за одну ниточку и постепенно возвращается целый мир.

Ливны. Малоархангельск. Московское фотоателье. Купеческая семья. Имение в лесу. Шестеро детей. Революция. Потерянный дом. Ранняя смерть дочери. Исчезнувший на 45 лет сын. 57-летняя старушка в черном.
А началось всё с нескольких строчек, написанных её внуком в 2006 году.
Мое расследование ещё не закончено.
Я не просто ищу людей, я собираю пазл своего рода, "возвращаю их домой".
  • 👍 2
Post #365 136
📕Иногда в семейных поисках самое интересное начинается не с архива и даже не с метрической книги. А с какой-нибудь случайной зацепки, которая десятилетиями лежала и ждала, пока кто-нибудь задаст правильный вопрос.
Так у меня случилось с Елизаветой Федотовной Кубаревой, урождённой Заседателевой.
Елизавета - родная старшая сестра моей прапрабабушки (о семье которой писала здесь и здесь). Я знала о её существовании, видела её на старых семейных фотографиях. Но долгое время она оставалась для меня просто одним из лиц на снимках.
А потом нашлось письмо.
В 2006 году внук Елизаветы, Е.А. Кубарев, отправил некоему Владимиру Александровичу 25 старых семейных фотографий и собственноручно подписал, кто на них изображён. Он называл Елизавету «бабушкой», её дочь Глафиру - «мамой». То есть эти подписи сделал человек, который ещё знал героев моего семейного архива не по документам, а лично.
🔎И вот тут началось настоящее расследование.
Елизавета родилась в Ливнах в 1875 году. Она была первой дочерью Федота Алексеевича и Глафиры Николаевны Заседателевых. Всего в семье выросло девять детей - четыре сына и пять дочерей, об этом писала здесь и здесь.
Семья была очень обеспеченной.
Отец, Федот Алексеевич Заседателев - ливенский купец, промышленник, крупный землевладелец, потомственный почётный гражданин. Его спиртоводочный завод работал в Ливнах с XIX века, а сама семья занимала заметное место в жизни города. Эти сведения подтверждаются и ливенскими краеведческими публикациями.
А дальше Лиза выходит замуж.
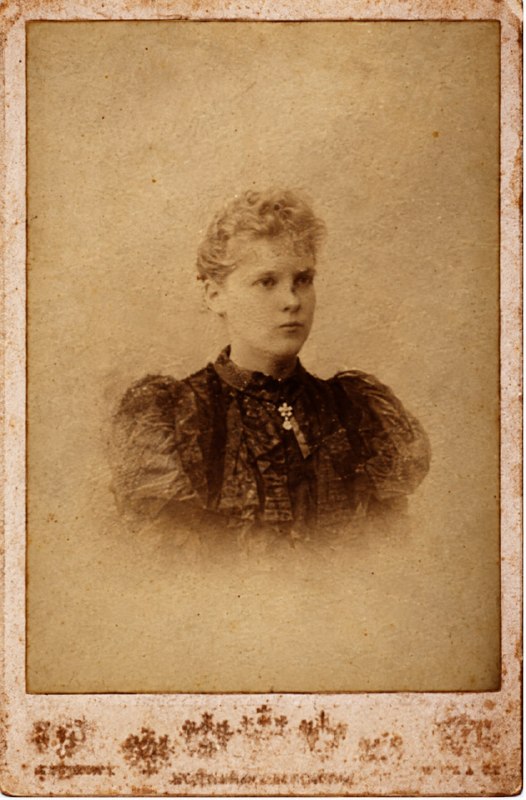
Её муж - Николай Николаевич Кубарев (на фото), 1869 года рождения, купец из Малоархангельска.
Сохранились их парные портреты, сделанные в Москве у придворного фотографа Г.В. Трунова. Судя по ателье и оформлению снимков, это конец 1890-х годов. Возможно, даже свадебные фотографии. На портрете Николай - молодой мужчина с закрученными усами и бабочкой. А фотография Елизаветы выцвела почти полностью: лицо превратилось в едва заметную тень. Остались кружевной воротник и брошь. Я её восстанавливала.
И, наверное, именно тогда особенно остро почувствовала странность архивных поисков: человек умер почти девяносто лет назад, а ты сидишь перед компьютером и пытаешься вернуть его лицо.

У Кубаревых было своё имение - Упалое, в Малоархангельском уезде. В письме внук называет его уже «бывшим имением Кубаревых» и уточняет: «в лесу». Село существует до сих пор. Сохранился и кирпичный Никольский храм, построенный в конце XIX века. А вот где именно стоял дом Кубаревых, мне пока найти не удалось.
Post #364 156
⚙️Одна нейросеть ставит задачи другой: как Claude работал с ChatGPT вместо меня
Готовлюсь к выступлению. У меня будет час, чтобы показать сметчикам, инженерам ПТО, бухгалтерии, юристам и руководителям, как нейросети помогают в их работе. Материал есть: файл на 21 страницу с 24 кейсами нашей автоматизации, от поиска тендера до суда. Проблема в том, что собирался он под другие задачи и всё в нём рассказано глазами юриста. Залу нужно другое: каждому специалисту интересна его область.
Загрузила файл в ChatGPT. А рядом, в боковой панели браузера, работал Claude.
Я решила не копировать ответы из окна в окно, а поручить одной нейросети руководить другой.
Вчера писала, что у Claude есть расширение для браузера. Он видит открытую вкладку, может кликнуть по полю, напечатать текст, отправить его, подождать и прочитать ответ.
То есть работает с сайтом так же, как человек, только без моего участия.

Специальные скиллы и субагенты не понадобились: одна модель claude-opus-5-5 и открытая вкладка ChatGPT.
Первым делом Claude сам сформулировал задание для GPT: выписать все кейсы с подразделением, задачей, инструментами и цифрами, сохранить формулировки, ничего не добавлять от себя.

Отправил и стал ждать.
GPT читал файл 3 минуты 59 секунд. Claude забрал ответ целиком и сразу отметил, что это пересказ, а не оригинал, и перед слайдами цифры нужно сверить с PDF.
Дальше Claude разложил 24 кейса по темам для структурных подразделений, которые будут в зале и для каждого выбрал главный.
Далее был составлен план выступления.
Начать он предложил с кейса, где речь идёт о деньгах. Такую разницу сразу поймут все в зале: сметчик увидит ошибку в расчёте, генеральный директор увидит деньги, которые компания могла потерять.
Потом Claude отдал GPT план на критику с позиций трёх скептиков - генерального директора, главного инженера и главного бухгалтера. За пару минут GPT выдал десять жёстких вопросов, которые могут быть заданы по итогам выступления.
Claude разобрал замечания, большинство из них принял, две формулировки поправил. И нашёл то, что GPT пропустил: в зале будет операционный директор, а для него в критике нет ни слова. Кроме того, план доклада выходит за рамки часового доклада, его пришлось пересобрать.
💫В процессе работы заметила, что вкладку нельзя трогать, пока с ней работает агент, а данные уходят сразу в два внешних сервиса. Моей ошибкой было решение параллельно работе Claude и GPT создать сайт юридического журнала)), задача по подготовке выступления зависла. После создания сайта, снова отвисла и работа продолжилась.
📌Вывод - нейросети нас очень ускоряют, это суперсила.
Я уже не понимаю, как можно за раз делать менее 5 задач в менее чем 3 разных нейросетях. Очень впечатляет, когда модели раздают команды друг-другу, конкурируют за лучший результат, одна модель пишет, другая критикует. В до ИИшные времена трудно было даже представить, что некоторые задачи, которые сейчас выполняются за полчаса параллельно с другими, раньше делались неделю.

Главное при этом помнить - кто расслабляется, теряет контроль, быстро деградирует и получает обратный эффект. Поэтому, если не уверен, что устоишь перед соблазном, лучше не начинать.
  • 👍 7
  • ❤ 2
Post #363 137
Чем еще заняться перед сном?
Конечно "поженить" последние модели Claude Opus с GPT Astra❤️
  • 😁 2
Post #362 138
🔖Поиск документа через браузерное расширение Claude.
Сегодня нужно было найти ЗОС и РВ на построенный жилищный комплекс.
ЗОС - заключение строительного надзора о том, что построенный объект соответствует проекту и требованиям. Без него не выдают РВ- разрешение на ввод в эксплуатацию.
Заказчик отказывается оплачивать выполненные работы. Нужно доказать, что объект построен и сдан. Для этого требуются вышеуказанные документы.
Решила проверить, как Claud справится с задачей при наличии минимальных исходных данных. Ни названия ЖК, ни кадастрового номера, ни номера разрешения на строительство указывать не стала. Только юридическое наименование объекта, адрес и компанию.

С таким набором вручную быстро упираешься в стену. В письме объект называется «многофункциональным жилым комплексом», а в реестре жилищного строительства живёт под маркетинговым названием. Застройщик тоже другой: в приказе головная компания группы, а проектную декларацию подавала специально созданная дочка. По одному адресу висят две карточки с одинаковым названием, одна сдана, другая строится.
Но главное, что ЗОС строительного надзора в открытом доступе не публикуется вообще.
Что мы сделали: открыли реестр у себя в браузере, бросили в чат скан письма и поставили задачу через расширение Claude для Chrome.
Расширение даёт модели доступ к открытой вкладке. Она видит страницу, кликает по фильтрам, вводит запросы, читает таблицы, открывает карточки.

Список сайтов, по которым можно ходить, согласуется заранее. Если нужен личный кабинет, логинюсь сама, пароли модели не передаю. Скачать файл, что-то отправить, принять условия она может только после моего «да» в чате.
👁Поиск по названию из письма дал ноль. Поиск по застройщику тоже. Сработала третья гипотеза: сверить генподрядчика. Он указан в карточке объекта в реестре, и та же компания есть в письме среди членов комиссии. Так подтвердилось, что маркетинговый ЖК и «многофункциональный комплекс» из письма - один объект. Дальше картина сложилась сама: нужная карточка этапа, проектная декларация, разрешение на ввод.
Claude пояснил, что Разрешение на ввод выдают только при наличии ЗОС, заключение получено раньше, то есть ровно в период работы той самой комиссии. Сам документ можно запросить у застройщика или через городскую градостроительную систему. В РВ указывается номер и дата ЗОС.

📎Самое ценное здесь не только скорость, но и то, что модель одновременно держит юридическое и маркетинговое название, адрес, застройщика, группу компаний, подрядчика, ИНН и находит пересечение там, где прямого совпадения нет.
Ограничения тоже были: прямые запросы к внутреннему API портала упёрлись в блокировку, обходить её не стали и пошли через обычный интерфейс, кликами. Не обошлось и без мелких неудобств - РВ было выложено в PDF, но открылось в специальном окне для просмотра файлов, а туда расширение не заглядывает. Модель нашла документ и дала мне ссылку, а прочитать его пришлось самой.
⚙️Не стоит путать такую работу с ботами и парсерами. Парсер - это программа, которая собирает данные с сайтов по заранее прописанной схеме.
В нашем случае модель пробовала вариант, если он не срабатывал, она предлагала следующий. Со стороны сайта это выглядело как обычный посетитель: один человек, одна открытая страница, никаких массовых скачиваний и попыток обойти защиту. Каждый следующий шаг мы обсуждали в чате. Задача выполнена за 7 минут.
  • 🔥 6
Post #360 170
🔖Недавно с помощью нейросети проверяла сделку по покупке квартиры у возрастного продавца. Случай с отягчающими: половину квартиры он получил в наследство от умершей супруги через суд, и трое взрослых детей - наследники первой очереди.
Сопровождением сделок с недвижимостью я не занимаюсь. Но чего не сделаешь для любимого кузена)
⭕️ Что проверяли
1. Объект и документы продавца
Выписку ЕГРН, договор продавца, свидетельство о смерти супруги, два решения суда, сведения о зарегистрированных лицах. Все загрузила в нейросеть и попросила разобрать сделку целиком, с упором на наследственную долю.
С титулом чисто: квартира куплена в браке. А дальше пошли риски.
📎В квартире, кроме продавца, зарегистрированы ещё трое, и один из них - десятилетний внук. Перечень лиц, сохраняющих право пользования жильём, это существенное условие договора (ст. 558 ГК РФ). Ребёнка не снимут с учёта - сделка повисает, а покупатель получает квартиру с жильцом, которого потом не выселить.
📎Второй момент: справок из психоневрологического и наркологического диспансеров среди документов не было. При возрасте под восемьдесят это прямая дорога к иску по статье 177 ГК РФ, когда сделку рушат на том, что человек не понимал значения своих действий. Нейросеть не просто отметила риск, а дала рекомендации.
2. Наличие признаков банкротства продавца
Здесь опыт у меня большой: много лет защищала собственников при оспаривании сделок в банкротстве. Если на дату сделки у продавца были подтверждённые долги, покупателю придётся доказывать добросовестность - проверкой по открытым источникам и скринами с датой.
Картотека арбитражных дел, ФССП, Федресурс. Нейросеть прошла их и добавила то, о чём обычно забывают: суды общей юрисдикции сразу по двум регионам, по месту регистрации и по месту фактического проживания. Отдельно посмотрела производства, оконченные из-за отсутствия имущества: это готовая презумпция неплатёжеспособности.
Долгов не нашлось.
3. Риск покупки по заниженной стоимости
Бесплатный сыр в мышеловке - это про статью 61.2 Закона о банкротстве: цена заметно ниже рыночной, и сделку оспорят, квартиру вернут в конкурсную массу, а деньги покупатель будет ждать в очереди. Страхуемся оценкой на дату сделки.
В архиве у меня лежал отчёт оценщика по квартире, которую конкурсный управляющий пытался отобрать за занижение. На его основе я собрала скилл - сохранённую инструкцию, по которому нейросеть собирает аналог оценочного отчета по вашим данным.

⚙️Через браузерное расширение Claude в Chrome нейросеть подобрала объявления по сопоставимым квартирам, пока я занималась другими задачами.
Дальше сделала расчёт по сравнительному подходу: цена за метр, поправки, проверка однородности выборки. На выходе восемнадцать страниц: таблицы, карточки объявлений с фото, правовой блок и чек-лист, что покупателю хранить три года. Около получаса вместе с подбором аналогов.
Оценка может и не пригодиться, платить за неё как за полный отчёт ради страховки не хочется. Юрист при сопровождении сделки может сделать эту работу в рамках услуги, а покупатель знает, что подстрахован.
  • 🔥 6
Post #359 156
🔖Как нейросеть сравнила две версии договора и госконтракт на 11 000 строк и поймала подмену в двух редакциях
Генподрядчик прислал новую редакцию договора подряда после получения нашего протокола разногласий. Проблема была в том, что договор был в оригинале на бумажном носителе с подписью и печатью. Сопроводительного письма с указанием, что изменилось, не было. Выход один, садиться и сопоставлять два больших договора.
Сложность была не в объёме, а в том, что новую редакцию нельзя читать как отдельный документ. На первый взгляд она выглядела уступкой в нашу пользу: аванс подняли, один из штрафов снизили. Сравнивать нужно было сразу в двух плоскостях, что изменилось относительно прошлой редакции и насколько условия жёстче тех, на которых сам генподрядчик отвечает перед государством.

Руками это постраничная сверка нескольких документов одновременно, обычно этим занимается юрист с несколькими файлами на экране.
Кроме двух сканов в работу пошёл текст государственного контракта, по которому сам генподрядчик отвечает перед вышестоящим заказчиком, мы нашли его в открытом реестре закупок, документ с приложениями тянул на одиннадцать тысяч строк.
⚙️Работали в Cowork, задачу разложили на волны параллельных агентов вместо одной модели подряд.
🔴Девять распознавали скан и сверяли черновик с изображением каждой страницы, сохраняя даже опечатки оригинала.
🔴Шесть сравнивали старую и новую редакции.
🔴Ещё семь сопоставляли договор с государственным контрактом между нашим заказчиком и верхним основным заказчиком: цитата из договора, цитата из контракта, чем условие жёстче и какой уровень риска.
Автоматическое сравнение редакций дало сорок одно расхождение. Сопоставление с государственным контрактом дало восемьдесят девять условий, где наш договор жёстче, и двадцать восемь из них с высоким риском. То есть наш заказчик ужесточил нам условия по сравнению с теми, что предусмотрены в его договоре с основным заказчиком.
🌟Нейросеть заметила то, что глаз человека пропустит. Нашлась зацепка по штрафам: профильное постановление правительства субподряд напрямую не регулирует, о незаконности сумм речи нет, но перед государством генподрядчик отвечает в границах этого постановления, а на нас перекладывает ответственность в разы выше, это уже вопрос несоразмерности неустойки со своей практикой Верховного суда.
Итог оформили четырьмя документами: таблица различий между редакциями, сопоставление с государственным контрактом, сверка штрафов с постановлением правительства и законом о госзакупках, и записка для руководства с выводом, что часть условий у нас жёстче, чем у самого генподрядчика перед его заказчиком, плюс чек-лист условий договора для руководства.

⏰ 4 часа vs 10 дней. Вся работа заняла 4 часа в одной сессии. Юристу вручную на постраничную сверку двух сканов и сопоставление с документом на одиннадцать тысяч строк потребовалось бы не менее 10 дней, а риск пропустить что-то важное при таком объеме остаётся высоким даже у внимательного человека.
Прогресс не остановить. То, что вчера было работой на несколько дней, сегодня укладывается в одну сессию, а через год планка сдвинется ещё дальше.
  • 👍 4
Post #358 155
🤖 Сегодня снова думала о нейропоколении - о тех, кто сейчас сидит за партой, и о том, кем они станут через десять лет.
Мне нравится сравнение: нейросеть - это рычаг для мышления. Архимед обещал сдвинуть Землю, если ему дадут точку опоры. Так вот, точка опоры - это твоя голова. Рычаг умножает усилие, но усилие должно быть твоим. Если его нет, умножать нечего.
Закинуть задачу в чат и переслать ответ дальше - это не работа с ИИ. Так сегодня умеет каждый, кто нашел кнопку «отправить». Более того, этим уже никого не удивишь, нейромусор - дурной тон, коллеги давно перестали делать вид, что не замечают.
Настоящая работа с ИИ - это другое. Понимать, какую часть задачи можно отдать машине без потери качества, а какую нельзя ни при каких условиях. Убрать из своего дня тупую рутину, пропускать через себя в разы больше информации, сопоставлять источники, которые раньше физически не успела бы открыть. И при этом мыслить самой, потому что вывод и решение - моя ответственность, а не нейросети. У меня в работе это выглядит так: машина читает сотню страниц переписки по объекту и раскладывает ее в хронологическом порядке, а я решаю, что ляжет в основу позиции.

Теперь про школьников и студентов. Здесь все разделится: кого-то нейросеть усилит, а кого-то сделает еще беспомощнее.
Если студент расслабился и отдал ей все - подготовку реферата, курсового, а потом и выражение собственного мнения, - это крах. Если же он использует ИИ как помощника - собрать материал, свести данные из разных источников, оформить проект, проверить свою логику, - а идею и позицию формирует сам, то он растет быстрее, чем росли мы. Кругозор шире, скорость выше, ошибок меньше. Разница только в том, чья голова в этой связке главная.

Дальше произойдет естественный отбор. Останутся те, кто мыслит и усиливает себя технологиями, и те, кто работает руками - им ИИ пока не конкурент. А вот промежуточное звено, думающие люди, которые принципиально не трогают нейросети, со временем уйдут. Как ушли извозчики, фонарщики и трубочисты. Не потому что были плохими специалистами, а потому что рядом появились те, кто делает то же самое в несколько раз быстрее. Они и будут делать прорывы, потому что успевают проверить больше гипотез за то же время.
В работе с ИИ главное - придумать способы, как использовать нейросеть, чтобы стать максимально эффективным в своей профессии. Просто так оплачивать подписку и бездумно тратить токены - не вариант. Нейросеть дает максимальный результат тем, кто поймет, как и где можно применять этот рычаг, чтобы двигать то, что раньше казалось неподъемным.
  • 🔥 4
Older posts →

About this channel

How can I read @arbitr_pravo without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Анна Степанищева | Право/Стройка/Нейросети: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Анна Степанищева | Право/Стройка/Нейросети have?
Анна Степанищева | Право/Стройка/Нейросети (@arbitr_pravo) has 259 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Анна Степанищева | Право/Стройка/Нейросети know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →