TGViewer
Channel Public Channel
Biostatistics on the Table

Biostatistics on the Table

@tabulated_stats

Место, где ML расшифровывается как Maximum Likelihood
Subscribers
341
Photos
122
Videos
6
Links
127

Showing posts older than #173 · Back to latest

Older Posts 19 shown
Post #172 277
Biostatistics on the Table Апостериорное распределение для разности матожиданий, то есть собственно "t-тест"
В тему получилось
Post #171 253

Forwarded from Sinекура

В курсе "Основы байесовского вывода" сегодня лекция про один развёрнутый пример, на мой взгляд, интересный и изрядно неожиданный:

СПбГУ — 2025.09.23 — Байесовский вывод для гауссиана
(слайды, доска и код на странице курса)

Мы уже много раз говорили в курсе о гауссианах, в основном в контексте линейной регрессии. И всё, что мы обсуждали, сводилось к тому, что что с гауссианами ни делай, получаются опять гауссианы. Можно их перемножать, маргинализовать, делать свёртку двух гауссианов, всё равно сумма многочленов второй степени останется многочленом второй степени. Байесовский вывод в линейной регрессии приводит к тому, что наша уверенность в (точечном) ответе уменьшается; но это уменьшение — это увеличение дисперсии в предсказательном распределении, а оно всё равно остаётся гауссианом.

И вот в этом примере оказывается, что не остаётся! Для этого, конечно, пришлось к гауссиану подмешать гамма-распределение как априорное для параметра τ (precision, величина, обратная дисперсии), но как иначе, это же как минимум положительная величина. Выясняется, что если маргинализовать апостериорное распределение по τ, то есть проинтегрировать по τ и оставить только μ, то его апостериорное распределение уже вовсе не будет гауссианом, а будет... распределением Стьюдента! Это, по-моему, очень интересный результат: не просто дисперсия увеличивается при байесовском выводе, а буквально меняется форма распределения; затухающий экспоненциально гауссиан превращается в распределение с тяжёлыми, полиномиальными хвостами. И это очень легко проверить на практике, мы это в численном примере на лекции увидели.

Кстати, здесь есть интересная историческая деталь: распределение Стьюдента начал рассматривать вовсе не Уильям Госсет, а совсем другие люди лет на двадцать раньше. Ещё в 1870-х годах немецкие математики Фридрих Хельмерт и Якоб Люрот занимались байесовским выводом и получили распределение Стьюдента именно как предсказательное распределение для гауссиана. Везде байесианисты!)
Post #170 214
Интересная объяснялка про раннее видение Нейманом и Фишером причинно-следственного вывода в экспериментах.
Для меня остается загадкой, почему Фишер отвергал* идею (фиксированных) потенциальных исходов, предложенную Нейманом, я просто не понимаю, как можно без них обосновать его идею randomization based inference. Видимо, придется как-нибудь собраться духом и с их оригинальными работами по теме познакомиться.

* личную неприязнь исключаем

https://www.youtube.com/watch?v=rrSduHsH47I
YouTube Statistics & Causal Inference: Neyman & Fisher In this video, EGAP Methods Director and University of Illinois Urbana-Champaign professor Jake Bowers discusses the relationship between statistics and causal inference.
Post #168 189
Biostatistics on the Table Ознакомился с содержанием
Увидел, что есть глава про восполнение пропущенных данных, конечно, сразу захотелось посмотреть, что там.
Думал, наткнусь на всякие безобразия и посоветую не читать ее, но, неожиданно, оказалось не все так плохо. Есть, конечно, что может вызвать негодование (см. скрины), но тем не менее пропустить главу я рекомендовать не буду.
Удивило, что про congeniality assumption и models compatibility в разделе про множественную импутацию даже что-то есть.
  • ❤ 1
Post #167 174
Вот на что наткнулся.
Знаю, что часто люди не понимают, с чего начать изучение R. Особенно проблема с рекомендацией русскоязычных источников. Литература по R на русском языке есть, но либо качество переводов сильно хромает, либо материал уже устарел, поскольку так, как писали на R 5 лет назад, мало кто сейчас пишет.

ДМК-пресс* оказывается новую книгу для начинающих выпустили. Ознакомился с содержанием, все очень актуально, я бы даже сказал, все модно и современно.
Позабавило, конечно, что "Автор: Ткаченко Н.", а "Перевод: Логунов А.".

* издательство, у которого, как правило, все неплохо, а иногда даже очень хорошо с переводами получается
Издательство «ДМК Пресс» Основы анализа данных на языке R Купить книгу «Основы анализа данных на языке R», автора Ткаченко Н. в издательстве «ДМК Пресс». Выгодные цены в Москве, доставка. Заказать книги и учебники на официальном сайте издательства.
  • ❤ 3
Post #166 166
Peter Tennant с коллегами оказывается междисциплинарные* онлайн-семинары по вопросам причинно-следственного вывода проводят (даже удивительно насколько междисциплинарно у них там).

На YouTube начали выкладывать записи.

* даже удивительно насколько междисциплинарно у них там
Post #165 142
Полезный материал, пока пробежался только, но Гелман там интересные моменты рассматривает, которые у меня частенько вопросы вызывают, планирую внимательно прочитать
Post #162 137
Biostatistics on the Table И в целом познавательно, и достаточно неплохое популярное изложение концепции https://www.youtube.com/watch?v=VlkByRCztzc
Я 12-ый )
  • 😁 4
Post #161 153
Post #160 141
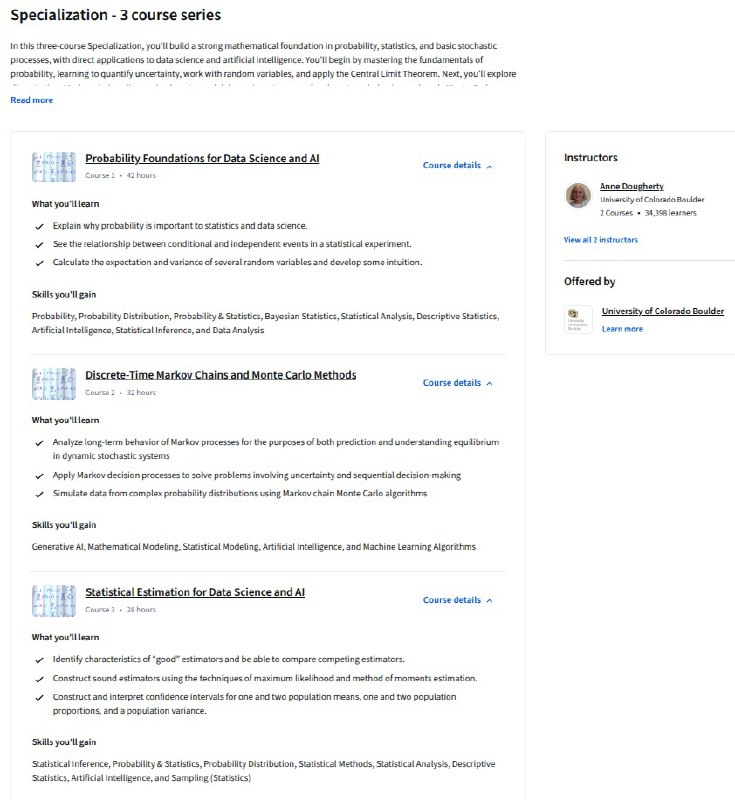
Смотрите, какой интересный куррикулум.
На курсере появилась специализация Foundations of Probability and Statistics Specialization (в целом у Colorado Boulder достаточно много интересного там есть по статистике и анализу данных с уклоном в advanced*).
Осень перестает быть скучной.

* по меркам MOOC, конечно
  • 😍 3
  • ❤ 2
Post #158 172

Forwarded from Biostatistics on the Table chat
Это оказалось очень тонким центральным моментом методологии, не все, что похоже на сэмплинг Гиббса им является, я раньше, например, считал (и на занятиях говорил), что MICE - это разновидность сэмплинга Гиббса, оказалось, что это не так, хотя и похоже
https://tpmorris.substack.com/p/mice-is-not-a-gibbs-sampler
Substack MICE is not a Gibbs sampler (A probably pointless bugbear)
  • ❤ 1
Post #156 133
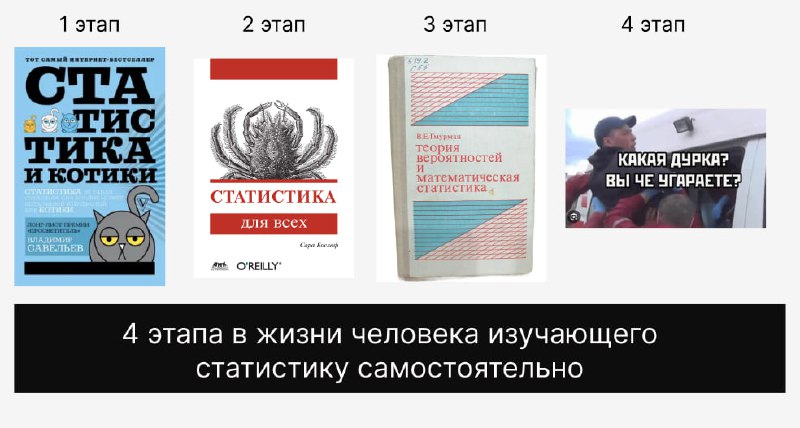
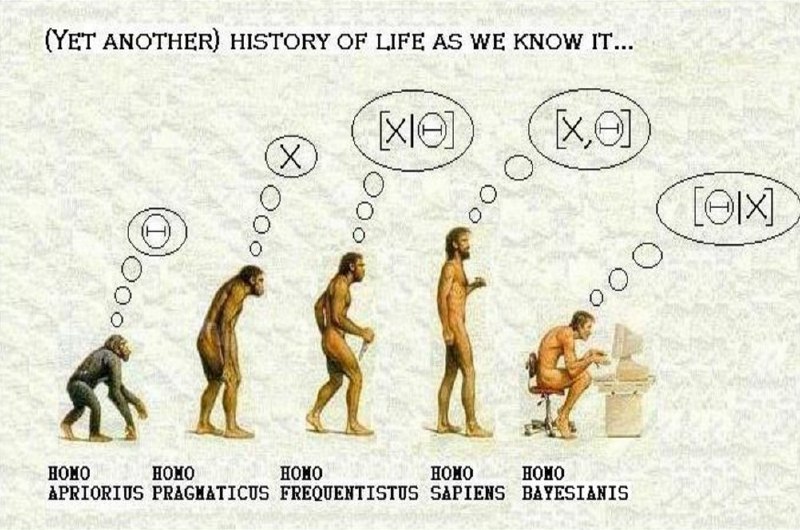
В комментариях есть еще мысли про 5 этап
Post #155 139
Ну и тематическая шутка, как водится
  • 🔥 2
  • ❤ 1
Post #154 145
Biostatistics on the Table Пример: df <- brglm2::endometrial set.seed(525243) fit <- MCMCglmm::MCMCglmm( NV ~ EH + HG, family = "categorical", data = df, prior = list( B = list( mu = rep(0, 3), V = MCMCglmm::gelman.prior( …
На что здесь следует обратить внимание: в примере с t-тестом мы сделали 2 раза сэмплинг по 10⁵ и из-за отсутствия автокорреляции между элементами можем считать, что эффективный размер выборки (ESS) примерно равен физическому размеру (то есть 100% сэмплов несут независимую информацию об апостериорном распределении).
В последнем примере мы взяли выборку размера 10⁵, при этом отбирали с лагом в 10 (то есть каждый 10-ый сэмпл из цепи попал в выборку), в итоге суммарный размер составил 10⁶. Но что мы видим в саммари: ESS для угловых параметров измеряется в сотнях.То есть эффективность сэмплинга составила примерно 10³ / 10⁶ (0.1% сэмплов несут независимую информацию об апостериорном распределении).
Я когда это увидел был в полном шоке.
  • ❤ 1
Post #153 127
Пример:
df <- brglm2::endometrial
set.seed(525243)

fit <- MCMCglmm::MCMCglmm(
NV ~ EH + HG,
family = "categorical",
data = df,
prior = list(
B = list(
mu = rep(0, 3),
V = MCMCglmm::gelman.prior(
~ EH + HG,
data = df,
scale = sqrt(pi^2/3+1)
)
),
R = list(V = 1, fix = 1)
),
nitt = 100000,
burnin = 1000,
thin = 10,
verbose = FALSE
)

summary(fit)
#>
#> Iterations = 1001:99991
#> Thinning interval = 10
#> Sample size = 9900
#>
#> DIC: 42.77461
#>
#> R-structure: ~units
#>
#> post.mean l-95% CI u-95% CI eff.samp
#> units 1 1 1 0
#>
#> Location effects: NV ~ EH + HG
#>
#> post.mean l-95% CI u-95% CI eff.samp pMCMC
#> (Intercept) -1.3239 -4.6634 1.8131 1430.6 0.43071
#> EH -1.8184 -3.4936 -0.1290 987.7 0.03131 *
#> HG 2.9383 0.8804 5.1687 733.0 0.00182 **
#> ---
#> Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →