TGViewer
Channel Public Channel
SuperOleg dev notes

SuperOleg dev notes

@super_oleg_dev

Обзоры новостей и статей из мира frontend, интересные кейсы, исследования и мысли вслух

https://github.com/SuperOleg39

https://twitter.com/ODrapeza

@SuperOleg39
Subscribers
1.75K
Photos
57
Videos
3
Links
160

Showing posts older than #182 · Back to latest

Older Posts 16 shown
Post #181 1.95K
Парочка интересных кейсы из беты React 19, которые особо не освещались:

- Прощай useIsomorphicLayoutEffect, больше нет варнинга на сервере - https://github.com/facebook/react/pull/26395

- Если вы используете throw promise или либы с поддержкой Suspense, в рамках одного Suspense загрузка данных в параллельных компонентах начнет происходить последовательно - https://github.com/facebook/react/pull/26380

Пример кода где будет водопад запросов при использовании условного useSuspenseQuery:

const Root = () => {
return <>
<Suspense>
        <CmpWithUseSuspenseQuery />
<CmpWithUseSuspenseQuery />
</Suspense>
</>
}


В релизе очень порадовало улучшение ошибок гидрации, и централизованная обработка ошибок Error Boundaries.

Также я никак не пойму в какой версии удалили или удалят 421 ошибку гидрации - https://github.com/facebook/react/issues/24959#issuecomment-1317309116

Ошибка происходит при ререндере Suspense компонента, поддерево которого не завершило гидрацию, и приводит к деоптимизации - клиентский рендер вместо гидрации.

Очень легко словить такую ошибку используя useSyncExternalStore.

Потратил часы на разборы таких ошибок, а ситуация в итоге странная - ошибку выпиливают, а деоптимизация остаётся.

Наверное мне стоило более тщательно подойти к замеру разницы в перформансе при деоптимизации, может проблема и не такая значительная, раз ее просто можно заглушить?
GitHub Remove layout effect warning on the server by rickhanlonii · Pull Request #26395 · facebook/react Overview This PR unfortunately removes the warning emitted when using layout effects on the server: useLayoutEffect does nothing on the server, because its effect cannot be encoded into the server...
  • 👍 14
  • 🔥 1
Post #180 1.65K
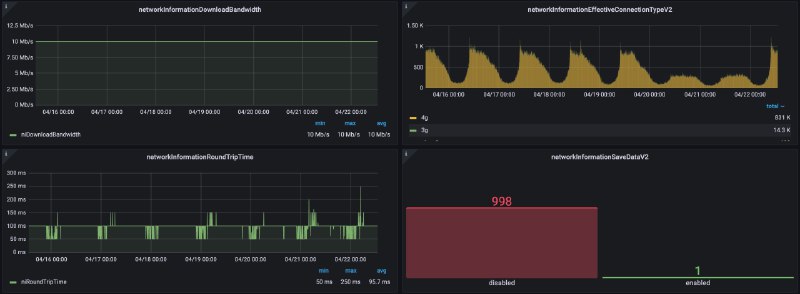
Забыл про API, которое разочаровало (по крайней мере не очень работает для нас) - Network Information API

По собранным метрикам, у подавляющего большинства пользователей отличный интернет, большая пропускная способность, некий средний RTT - в общем пользы не больше чем от метрики First Input Delay.
Post #179 1.41K
Подведу некий summary:

- Round Trip Time важен на каждом из многочисленных этапов загрузки HTML, в идеальном мире точка входа в приложение - это CDN
- Редиректы не бесплатные как для клиента, так и для приложения, лучше их не делать или делать поближе к пользователю, например на уровне балансера
- Service Worker может как ускорить, так и замедлить ваше приложение - измеряйте все что можете, пробуйте Navigation Preload, не используйте SW для "галочки" - браузер и так отлично все кэширует
- Раздутый HTML и плохой интернет - это значительная проблема для SSR, которую трудно исправить малыми усилиями

Круто, что есть много браузерных API для мониторинга таких деталей.
  • 🔥 9
  • 👍 5
Post #178 1.22K
И последняя, но к сожалению самая значимая часть - это время скачивания HTML документа, метрика между responseStart и responseEnd.

Не зря Qwik работает над уменьшением HTML разметки при стриминге - https://www.builder.io/blog/qwik-2-coming-soon

Типичный SSR с React, в нашем случае на Tramvai но мы тут не исключение, создает очень большой payload - это и большое количество информации в head (мета-теги, скрипты, preload теги), и огромное количество тегов в body, и HTTP заголовки вроде cookie и CSP.

Также, значительная часть HTML - это сериализованный стейт, переданный с сервера на клиент.

Концепт Qwik с resumability как раз хорош тем, что в HTML нет дублирующей информации, только то что нужно клиентскому коду для продолжения работы в браузере (для реакта же мы должны иметь серверный стейт для корректной гидрации всего дерева).

Даже с сжатием HTML на стороне балансера, эта часть на мобилках может занимать столько же времени, сколько отвечает сервер.
  • 👍 4
Post #177 1.03K
А вот время на установку TCP и TLS соединения тратят уже большинство пользователей, чем хуже интернет и больше Round Trip Time, тем хуже будет метрика у клиентов.

Тут минус, что perfume.js из коробки не собирает это время и вычисляю косвенно TCP + TLS - но на самом деле Navigation Timing API позволяет собрать их по отдельности.

Это может быть полезно для идентификации проблем с TLS, например какая-то медленная цепочка сертификатов (не сталкивался с таким на практике).
  • 👍 1
Post #175 887
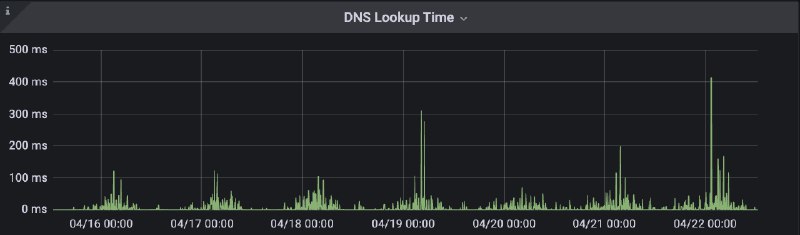
Приятно удивляет время резолва DNS - метрика между domainLookupStart и domainLookupEnd.

До 95 перцентиля (на первой картинке) даже не видно что это время вообще есть - как мне кажется, браузер либо хорошо кэширует результат резолва, либо делает его предварительно - например во время ввода урла в адресной строке, и в метрику уже это время не попадает.

На 99 перцентиле (второе изображение) уже видно, что кто-то из юзеров сталкивается с резолвом DNS, но скорее всего пики связаны с плохим соединением у конкретного клиента.
  • 👍 1
Post #173 847
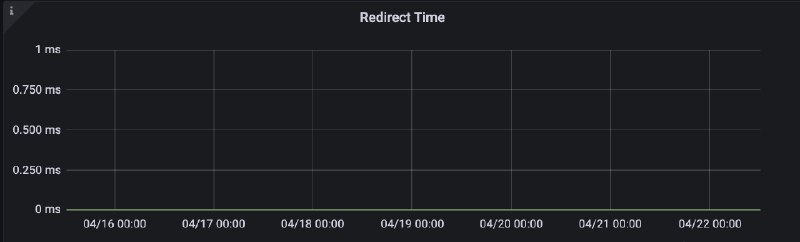
Если в приложении есть фон серверных редиректов - его оверхэд посчитать и заметить сложно - пример графиков с пустым 75 перцентилем и с 95 перцентилем, где уже видим что редиректы не бесплатные.

К примеру на tinkoff.ru все приложения будут делать редирект на адрес с "/" в конце.

Но из-за того что редиректов не больше 10% от общего числа запросов, нулевые метрики забивают все остальное.

Возможно стоит сделать отдельный график с отфильтрованными нулевыми значениями?

Метрика - время между redirectStart и redirectEnd.
  • 👍 2
Post #171 904
Первое, не значительное но интересное - это время работы Service Worker.

Как я понимаю, разница между точками workerStart и fetchStart с предыдущей диаграммы - это время на инициализацию спящего SW + время которое он потратил на "fetch" обработчик перед запросом текущей страницы.

Ночью и рано утром событий мало и шум сильный, а днем видно что в среднем оверхед небольшой - 10-20мс даже на мобилках, на десктопе еще меньше.

Но тем не менее, эти расходы есть, а высокие перцентили и пики в ночные часы показывают, что на небольшое количество пользователей оверхэд в разы сильнее.

Тут нам стоит провести эксперимент с Navigation Preload API, что бы делать запрос за страницей параллельно активации SW - https://web.dev/blog/navigation-preload

А в будущем возможно поможет Static Routing API - https://developer.chrome.com/blog/service-worker-static-routing
  • 👍 2
Post #170 874
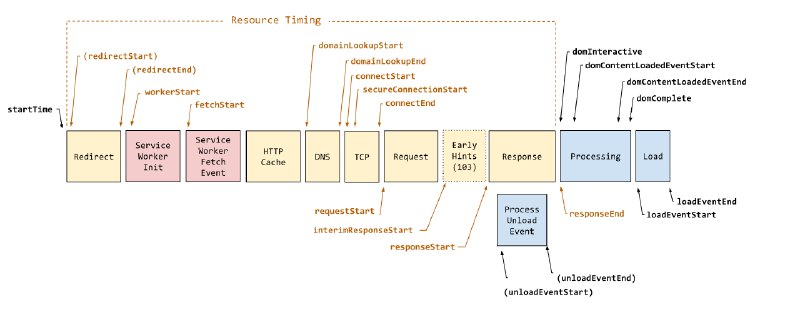
А вот составляющие запроса за HTML документом, которые можно мониторить через Navigation Timing API
  • 🔥 4
  • 👍 1
Post #168 847
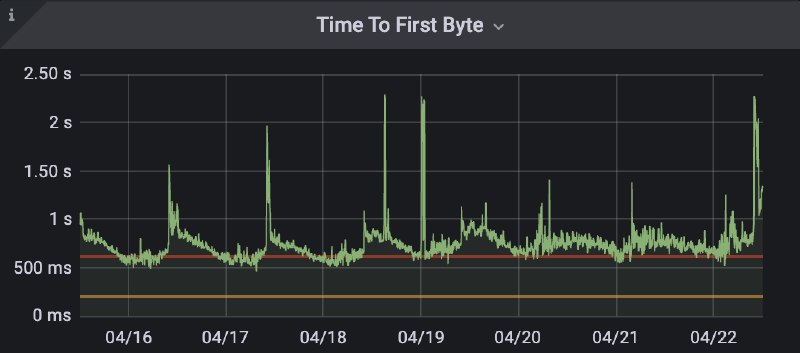
И сразу пример, как отличается TTFB от времени ответа сервера, это графики для desktop пользователей на 75 перцентиле одного из приложений - при времени ответа в среднем в 400мс, TTFB выше в полтора-два раза!
Post #167 811
Привет!

Обновлял библиотеку для клиентского performance мониторинга perfume.js, и как раз добавились изменения по метрике Time To First Byte - теперь без модификаций передается значение из пакета web-vitals, который используется под капотом (раньше по какой-то причине вычиталось время requestStart).

requestStart - это одна из performance метрик браузера относительно времени загрузки HTML документа, которые можно получить через PerformanceNavigationTiming API.

По какой логике вычисляется TTFB хорошо описано тут - https://stackoverflow.com/questions/69116839/does-ttfb-include-the-time-for-the-request-that-redirects-to-my-page

Вспомнил про это, так как после релиза одного из обновившихся приложений метрики TTFB на графике сильно ухудшились - раньше эта метрика гораздо лучше соотносилась с временем ответа SSR сервера приложения, а сейчас же стала значительно выше.

Но так как метрика просто стала корректной и надо принять как факт, что именно так ее измеряют инструменты гугла (CrUX, web-vitals), стало интересно - а почему такая разница с временем ответа SSR?

Решил разобрать прочие метрики, которые вычисляем из NavigationTiming API, кастомных пока нет, берем что есть из perfume.js, не идеально но полезные инсайты есть.
GitHub GitHub - Zizzamia/perfume.js: Web performance library for measuring all performance vitals metrics Web performance library for measuring all performance vitals metrics - Zizzamia/perfume.js
  • 👍 4
  • 🔥 3
Post #166 1.04K
Следующий кейс связан с переходом на async скрипты - https://t.me/super_oleg_dev/133

Используя defer скрипты, у вас есть уверенность - они будут выполнены когда DOM завершён (безопасно для гидрации) и по порядку.

Первое что я пропустил - это async для скрипта с полифиллами.

Трамвай использует подход с динамической загрузкой чанка с полифиллами - https://philipwalton.com/articles/loading-polyfills-only-when-needed/

При переходе на async мы больше не уверены что полифиллы будут загружены до выполнения основного кода.

Пришлось убрать атрибут defer у скрипта, что неизбежно приведет к штрафу на перформанс, из-за блокирующей загрузки. Ищу идеи получше)

Вторая проблема связана с нашими микрофронтами Child Apps.

Если в скриптах приложения сборщик отвечает за порядок их выполнения, проблем нет даже с async скриптами, так как есть явная связь, например через webpack_require.

Но скрипты микрофронтов добавляются на страницу отдельно, если они были предзагружены на сервере, прямой связи нет.

На клиенте скрипт микрофронта сохраняет его в window в уникальную переменную.

И клиентский код инициализации ожидает наличие этого микрофонта в window, так как скрипт есть на странице - ведь с defer он был бы точно выполнен заранее.

Для решения проблемы пришлось добавить логику ожидания загрузки скрипта - точки входа микрофронта, на события load и error.

И при этом предусмотреть кейс когда он был загружен или упал до навешивания обработчиков этих событий - добавить атрибут loaded, и его проставление true/false инлайн в атрибутах onload/onerror - у тега script нет никакого свойства что бы узнать текущее состояние загрузки скрипта.

При этом архитектурно не должно было поменяться поведение, что догрузка микрофронта на клиенте не должна задерживать инициализацию и гидрацию приложения - как с кейсами для Child Apps которые упали на сервере или их забыли предзагрузить.

Suspense + Error Boundary позволяет показать фаллбэк в каждом проблемном кейсе до итоговой успешной загрузки микрофронта.
Telegram SuperOleg dev notes Теперь фреймворк умеет в потоковый рендеринг, появились deferred экшены, и Await компонент для использования этих экшенов вместе с Suspense. Большая часть работы сделана, проблемы как всегда в деталях. Тут очередная хвала React Working Group, а именно гайду…
  • 🤔 4
  • 👍 2
Post #165 840
Отдельный челлендж - это продать преимущества стриминга вашим SRE :)

Далее пойдут более специфичные кейсы.

Приложение используется в основном в вебвью, и в основном в мобильном приложении Тинькофф на IOS.

Как вы понимаете, именно у этого сегмента возникли проблемы.

Все симптомы указывают на то, что вебвью перестает ждать окончания ответа и просто обрывает стрим, пользователь остаётся с незаконченной HTMLкой.

Дебажить вебвью сложно, пробовали разное, долго, коллега уже начал локально собирать нативное приложение и шатать его кодовую базу. И нашел!

Оказалось, что проблема возникает, с непонятной периодичностью, когда веб приложение в вебвью дёргает нативный экшен что бы скрыть лоадер нативного приложения, когда веб приложение загрузилось.

До сих пор не понимаем в чем причина, но сложился паззл с другим кейсом - когда у коллег по непонятной логике отваливались один или несколько запросов на старте вебвью - вебвью просто рубил всю не завершенные сетевые запросы, в том числе и за документом.

Пишите, если сталкивались или знаете статьи по теме.
  • ❤ 2
  • 👍 1
Post #164 838
Про deferred экшены и стриминг, которые анонсировал для трамвая тут - https://t.me/super_oleg_dev/136

После нескольких неудачных релизов на прод на одном из приложений Тинькофф Путешествия, продолжаем активно дорабатывать фичу, собрал несколько интересных моментов, о которых хочется рассказать.

Фичу очень хочется в прод - радикально улучшает метрики производительности - и общую LCP, и кастомную в приложении, которая как раз показывает как скоро нужный блок был показан в приложении, примерно на полторы секунды на 50м перцентиле.

В самом начале мы столкнулись ещё на тестовом стенде с проблемой буферизации.

Весь смысл стриминга HTML - отдать как можно раньше первый байт ответа на клиент, и все статичные элементы разметки.

При этом по дефолту, балансеры, в нашем случае Nginx - буферизуют ответ от апстрима, что бы не держать слишком много долгих открытых соединений, что полезно в большинстве случаев, но не для стриминга, где это напрямую ухудшает TTFB.

Отключить можно на балансере:
proxy_request_buffering off;

Или через HTTP заголовок в ответе на запрос за страницей:
X-Accel-Buffering: no

Также важно, что бы тайм-аут ответа от апстрима на балансере был выше, чем ваш максимальный тайм-аут на стриминг в приложении - иначе пользователь просто не получит кусок разметки.

В доке Next.js или Marko.js можно найти полезную информацию по теме:
- https://markojs.com/docs/troubleshooting-streaming/
- https://nextjs.org/docs/app/building-your-application/deploying#streaming-and-suspense
Telegram SuperOleg dev notes Привет! Релизнули экспериментальный функционал с Deferred экшенами. Сделал темплейт где можно потыкать результат - https://codesandbox.io/p/sandbox/tramvai-deferred-actions-s95q62 Экшен выполняется 1 секунду, время рендера компонента который зависит от…
  • 👍 6
Post #163 1.14K
Про разработку.

Запланированные процессы такие:
- один разработчик пишет бэк, один фронт- до разработки, создается задача на конкретный небольшой функционал
- бэк пишет Open API схему и тест кейсы до реализации, на этом этапе асинхронно ревью/приемка заказчиком
- фронт накидывает мокапы и тест кейсы до реализации, на этом этапе асинхронно ревью/приемка заказчиком
- фронт получает сгенерированные API клиенты + моки от бэка до реализации
- реализация обязательно с тестами (Mostly integration!)

И если с тестами нам очень помогают коллеги, в том числе QA-инженер (отсутствует в нашей команде), сильно недооценили работу по дизайну, делать хорошие мокапы сложно даже при наличии кита и каких-то гайдлайнов, поэтому в асинхронном режиме будем привлекать дизайнера (отсутствует в нашей команде).

Также, большой объем работы потребовался на изначальную настройку инфраструктуры, это и тестовое окружение, Allure, генераторы клиентов и моков, CI/CD, и многое другое.

Поэтому процессы еще совсем не прошли проверку временем.

История далека от завершения, но очень надеюсь в следующих постах затронуть сторонние темы, и возвращаться тут к MF Platform по мере возникновения интересных инсайтов, точно будет что рассказать по SRE (платформу будут использовать критичные сервисы, что подразумевает высокие требования к доступности и поддержке).
  • 👍 7
  • ❤ 1
  • 🤔 1
Post #162 992
Привет!

Вернулся из отпуска, вхожу в привычный ритм, пора начинать писать)

По проектированию Microfrontends Platform я не успел рассмотреть клиентскую архитектуру, но думаю тут достаточно информации из одного из старых постов - https://t.me/super_oleg_dev/41, те же подходы планируем применять и для UI сервиса.

Детальное проектирование сервиса очень помогло для старта, многие базовые сущности оказались достаточно гибкими и расширяемыми, и остались без изменений.
При этом, дизайн все-равно быстро устаревает по ряду причин:

- выявляются новые потребности
- все это время идет постоянная проработка сценариев и граничных кейсов
- информация мигрирует в другие источники

Потребности.

Как я писал ранее, одно из слабых мест проекта это предварительный сбор требований. За одну-две встречи и презентовать свое видение проекта заинтересованным лицам, и собрать с них все потребности кажется невозможно.

В итоге, кейсы использования сервиса у основного заказчика требуют совсем другого взгляда на возможности проекта - основная разница, что версиями и доставкой микрофронтов управляют не разработчики приложений где они используются (как я планировал изначально), а разработчики самих микрофронтов, которым грубо говоря нужно релизить большие наборы протестированных микрофронтов, часто, и сразу на все приложения где они используются.

Это очень сильно влияет на сценарии использования сервиса, и требуемый функционал, можно сказать у нас получается x2 фич.
И одновременно почти не влияет на структуру базы данных (расширяет в первую очередь), где в основе по прежнему штучные релизы микрофронтов, привязанные к конкретным приложениям.

Поэтому в будущем для любых проектов я планирую уделять намного больше времени на сбор требований и формирование сценариев использования.

Проработка сценариев и граничные кейсы.

Пока это похоже на потенциально бесконечный процесс, так как он идет рука об руку с развитием продукта.

Но на первых этапах это конечно проработка основного функционала, даже на самые простые кейсы можно добавить десяток правил валидации, а на более сложные - очень повезет если получится найти все подводные камни до реализации.

Пример, есть потребность - массовые релизы микрофронтов.
Коллегам нужна возможность группировать микрофронты, релизить группу на несколько приложений одновременно, откатывать эти релизы, при этом не затрагивая другие микрофронты приложения.
Сюда добавляются такие кейсы как “заморозка” версии одного микрофронта из группы, если следующие версии сломаны, но не хотим блокировать релизы полностью.
Потом встает вопрос изменения состава групп, перенос микрофронтов между ними, и так далее.

Что бы не утонуть в этой сложности, проводим регулярные встречи и ведем подробную документацию.
Для MVP проекта сильно ограничили функционал, и прикинули следующие итерации самых приоритетных вещей.
Сложные кейсы стараемся упрощать и откладывать проработку, если есть понимание что возможное решение не потребует перелопатить всю архитектуру проекта в будущем.

Источники информации.

Вайтборд почти полностью устраивал меня на начальных этапах проектирования.

Но для долгоживущей информации, которая должна быть полной и актуальной, не обойтись без какой-либо wiki.
Что у нас уже есть в этой документации:

- минимальный глоссарий (выбрать и согласовать общие и понятные для всех термины тоже оказалась целая история!)
- сценарии использования сервиса
- потребности стейкхолдеров
- значимые архитектурные решения
- процессы разработки и приемки фичей заказчиками
- спецификация как пишем API эндпоинты
- всевозможные meeting notes

Ряд вещей перемещается в кодовую базу:

- схема базы данных - Prisma
- схема API эндпоинтов - Open API
- всевозможные сценарии - Allure тест кейсы

Тут важно иметь один обновляемый источник информации, постепенно уйти от дублирования, соответственно этот источник должен быть удобен в поддержке.
Telegram SuperOleg dev notes Другая задача - разработка рекомендаций и практических советов по организации структуры и архитектуры в tramvai приложениях. Нашей команде кажется очень перспективным подход Feature Sliced - https://feature-sliced.design/ В рамках исследования подготовил…
  • 👍 4
  • 👎 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →