TGViewer
Channel Public Channel
SuperOleg dev notes

SuperOleg dev notes

@super_oleg_dev

Обзоры новостей и статей из мира frontend, интересные кейсы, исследования и мысли вслух

https://github.com/SuperOleg39

https://twitter.com/ODrapeza

@SuperOleg39
Subscribers
1.75K
Photos
57
Videos
3
Links
160

Showing posts older than #162 · Back to latest

Older Posts 20 shown
Post #161 1.25K
И в итоге это пока самая масштабная часть проектирования, по крайней мере визуально:
Post #160 1.18K
Нижний уровень C4 - Code.

Но у нас осталось много не проработанных вещей, поэтому дальше я работаю сразу над несколькими:

- сущности бэкенда
- структура API роутов
- основные классы и методы
- описание сценариев работы

Список сущностей похож на БД, но собран в удобные для дальнейшего использования объекты.

API роуты старался делать не слишком низкоуровневыми, а под основные кейсы использования.
Например, у каждого приложения могут быть пресеты, в каждом свой маппинг микрофронтов.
Сначала я описал эндпоинты вида /:tenant/:app/:preset/mapping где работа с сущностью Mapping, но понял что по отдельности они не нужны, и удобнее сразу работать со всеми маппингами - например на GET /:tenant/:app/mapping возвращать Record<Preset, Mapping>.

Для основных классов из C4 Components описал методы и логику их работы. Вообще, получилось что эти сервисы и их методы 1 к 1 соотносятся с API эндпоинтами, и кажется это не очень корректно, но может измениться после рефакторинга - далее планирую найти и вынести общую логику из сервисов.

И конкретный пример:

Есть сервис HistoryService, сигнатура одного из его методов - rollback( Tenant, Application, History? ): History[] - он будет использоваться для откатов по истории изменения маппингов.

Для метода rollback описана логика работы:

- В рамках одной транзакции, получаем в БД соответствующую запись History либо берем предыдущую
- Находим все записи History с timestamp выше, проходим по ним
- В цикле, в таблице Mapping находим все записи под текущие History и Application
- Удаляем эти записи Mapping, в конце удаляем эту запись History
- И наконец обновляем поле Revision для текущей записи Application

На этом этапе много сложностей, так как буквально зайти дальше - это уже писать код, держать все в голове и прорабатывать низкоуровневые моменты оказалось сложнее всего, особенно в областях с множеством неизвестных.

Из интересного, сильно задумался над процессом загрузки файлов микрофронта через API платформы в файловое хранилище s3.

План примерно такой:

- CLI утилита в CI/CD создает объект FormData, считывает контент файлов, добавляет туда и отправляет стрим на бэкенд
- Бэкенд не буферизует эти данные, а сразу перенаправляет стрим в s3 через aws-sdk

Тут стоит сделать отдельно прототип и убедиться что нет подводных камней.
Post #159 1.05K
Получается еще одна достаточно простая схема:
Post #158 1.07K
Далее, переходим к бэкенду.

Сначала поверхностно, уровень C4 components.

Как уже писал, это не самый сложный бэкенд и не тот случай когда когда нам нужны DDD или Hexagonal Architecture.

В первую очередь хочется отделить бизнес-логику от работы с запросами.

Также, выделить предметную область - сущности которыми будет оперировать бэкенд для удобства будут отличаться от сущностей, которые мы создали в базе данных.

Также у нас будут сервисы для работы с внешними хранилищами.

Итого слои приложения:

- Controllers - минимум логики, обработка API роутов, работа с req/res
- Services - конкретный функционал, без прямой работы с БД
- Entities - схема сущностей API
- Storages:
- Prisma - схема сущностей в БД, работа с БД, миграции
- s3 - работа с s3

Из важных границ, стоит для работы с БД сделать абстрактный интерфейс, а адаптером для этого интерфейса будет Prisma сервис - это немного ослабит зависимость от конкретной ORM.

И если все-таки мы в итоге возьмем Prisma (от вас много комментариев по этому поводу :) ), хочется переиспользовать опыт работы с Redux селекторами и React-Query, и выделить дополнительный слой с атомарными и переиспользуемыми queries, которые можно будет комбинировать уровнем выше, в том числе в транзакции.

Пока не прорабатываем логику авторизации / пользователей / ролей и групп - как уже писал тут хочется переиспользовать API нашей IDP.
  • 👍 1
Post #157 1.04K
И сама схема:
Post #156 1.01K
Привет! Продолжаем рубрику проектирование на диване.

Детально проектировать сервис я решил начиная со схемы базы данных, и это очень помогло для проектирования бэкенда и в целом улучшения изначальных идей из RFC.

В первую очередь выделил сущности:

- Microfront - каждый уникальный микрофронтенд
- Application - для группировки необходимых микрофронтов конкретных версий
- Contract - абстрактная сущность, должна быть совместима у микрофронта и приложения

Тут немного отвлекусь про контракты.

Уже писал, что нужен максимально независимый от технологий механизм. И тут нам на помощь приходит SemVer!

Для контракта достаточно иметь уникальное имя и версионирование по SemVer, таким образом имея версии контрактов у приложения и используемых на нем микрофронтов, мы легко можем провалидировать совместимость по семверу, не вникая в нюансы реализации (как правило это npm пакет с TS интерфейсами или даже конкретными объектами).

Нам критична история изменений, и появляются новые сущности:

- History - представляет собой состояние Application в конкретный момент времени (предполагается что пачку изменений в UI можно сгруппировать в одну запись в историю)
- Mapping - связь между приложением, микрофронтом конкретной версии и конкретной записью в истории

Также выделил версии микрофронтов и контрактов в отдельные таблицы, это позволяет им иметь разные метаданные, и при этом быть связанными общими сущностями:

- MicrofrontVersion
- ContractVersion

В эту схему позже был добавлен механизм пресетов - например, если разработчик хочет делать canary релизы, можно собрать два маппинга для одного приложения, а уже на уровне приложения использовать нужный конфиг.
  • 👍 3
Post #155 985
И сама диаграмма уровня Containers (если бы это было решение на собеседование по System Design, то стоило бы указать балансировщик нагрузки, тут он подразумевается)
Post #154 1.03K
Следующий C4 уровень - Containers.

Тут я уже выделяю составляющие платформы - API, база данных, UI и CLI утилита.

И сторонние сервисы - файловое хранилище s3 и Developer Platform.

За скобками остаются системы для сбора логов, метрик, ошибок, алертов, они подразумеваются но по хорошему стоит их рисовать сразу.

Тут же можно показать и технический стек (фактически описывал я его позже, при проектировании составляющих платформы, на C4 уровнях Components / Code)

API платформы:

- Node.js (писать и поддерживать сервис будут инженеры из Coretech Frontend :) )
- Nest.js (мы любим DI)
- @nestjs/swagger
- Prisma ORM (решит за нас ряд вопросов с БД, например инициализация и миграции)
- aws-sdk (работа с s3)
- prom-client (метрики)
- terminus (health-checks и graceful degradation, обязательно для k8s)
- @opentelemetry/sdk-node (трейсинг)

UI платформы:

- Tramvai.js (ну вы понимаете)
- Tinkoff UI (наш внутренний React UI-kit, пока еще не в open-source как Taiga)
- @micro-sentry/browser (наша open-source либа для отправки ошибок в Sentry и подобные сервисы)
- Клиенты для отправки логов и аналитики во внутренние сервисы

База данных - реляционная (планируется много связей), есть внутренняя DBaaS - PostgreSQL.

А также, для переиспользования в UI и CLI, планируется генерация API клиентов из Swagger схем с помощью любой подходящей библиотеки (например swagger-typescript-api)
  • 👌 1
Post #153 860
И сама диаграмма System Context (по хорошему тут не хватает s3 и CDN)
Post #152 990
Проблема обозначена, есть решение, пора приступать к проектированию!

На самом деле рановато, это еще одна проблема моего подхода, работа с требованиями проведена достаточно поверхностно.

Из плюсов - понятны стейкхолдеры, уже есть заинтересованные пользователи, неплохо собраны функциональные требования.

Но не проработаны нефункциональные требования и ограничения. В первую очередь потому что система не предполагает быть сложной или сильно нагруженной, но в будущем лучше формализовать все это заранее.

Немного про инструменты и подходы.

Привычный для меня вайтборд - https://excalidraw.com/

Для проектирования отлично подходить модель C4 - https://c4model.com/, которую на нижнем уровне модели можно комбинировать с UML.

Для схемы БД не стал искать специальные инструменты и использую псевдо-UML.

По модели C4 иду сверху вниз и начинаю с System Context, где указаны:

- пользователи платформы
- сервисы, с которыми платформа взаимодействует (забыл на изображении добавить s3)

Тут все очень просто, но есть важный момент.

Для платформы нужен механизм разграничения доступов, полноценная ролевая модель, которая позволит управлять микрофронтами и приложениями в скоупе отдельных команд.

В нашем Internal Developer Platform сервисе (чуть больше информации про него можно найти у Александра Поломодова - https://t.me/book_cube/1826) уже есть готовые механизмы авторизации, тенантов, групп и ролей, которые идеально подойдут к нашей платформе.

И я очень надеюсь переиспользовать эти механизмы Developer Platform, так как планируется не сложный бэкенд и это упростит разработку в несколько раз)
Excalidraw Excalidraw — Collaborative whiteboarding made easy Excalidraw is a virtual collaborative whiteboard tool that lets you easily sketch diagrams that have a hand-drawn feel to them.
Post #151 941
И для лучшего восприятия идеи, пример (пре-альфа версия :) ) как может выглядеть UI платформы
  • ❤ 4
  • 👍 1
Post #150 1K
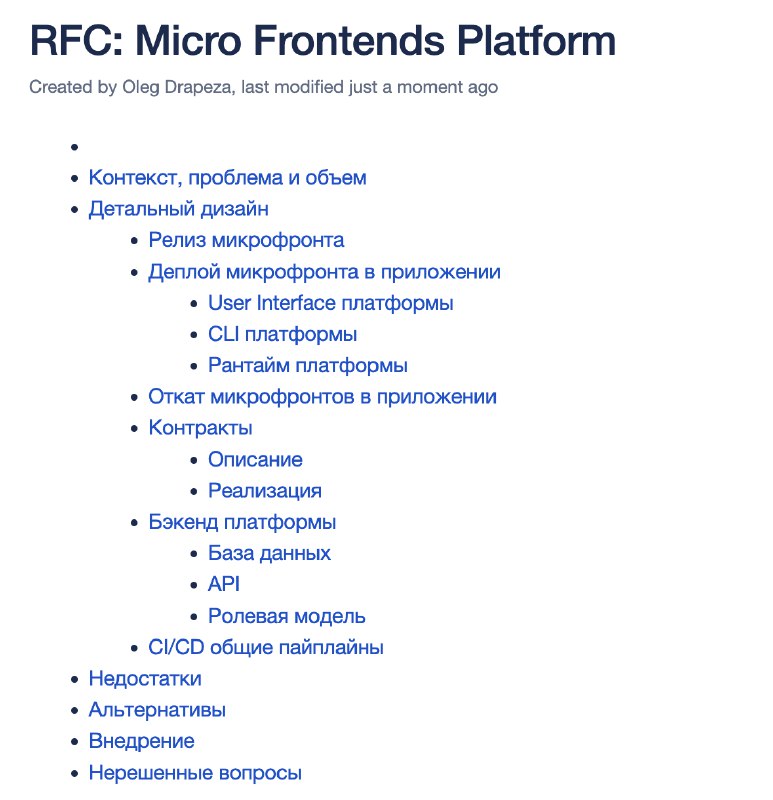
Структура RFC - наглядна проблема, начал с описания процессов, затем внутри них добавил детали реализации отдельных компонентов системы. Но сил все это переписывать уже не нашел)
Post #149 897
И тут постепенно появляется идея.

Сначала я разобрал основные слабые места Child Apps, и думал про полноценную экосистему для этих микрофронтов, которая будет решать все значимые проблемы.

А что если пойти дальше, и сделать отдельный сервис - платформу для микрофронтендов, которая будет решать проблемы и других экосистем (эти проблемы обсудим далее)?

Таким образом решение проблемы разделяется на два отдельных эпика:

- Общая платформа для микрофронтов для решения популярных проблем, не зависимая от фреймворков и экосистем
- Доработки специфичные для Child Apps (в ближайших постах не вижу смысла это рассматривать)

Идею платформы я оформил в лонгрид в формате RFC, который сначала обсудил с коллегами внутри команды, доработал и затем расшарил на всех остальных коллег.

RFC детально рассматривает платформу, которая состоит из следующих частей:

- Описание основных процессов (по сути одновременно и функциональные требования)
- Непосредственно сервис - бэкенд и база данных
- UI - админка сервиса (важная часть, так как управление версиями микрофронтов у многих команд либо происходит через коммиты в Gitlab, либо ручное редактирование JSON файлов, оба варианта не удобны по ряду причин)
- CLI утилита - для удобной работы с бэкендом в CI/CD пайплайнах
- Механизм контрактов
- Переиспользуемые CI/CD пайплайны с настроенными процессами

Примеры процессов - публикация новой версии микрофронта на платформе; раскатка новой версии микрофронта в приложении, и так далее.

В работе с этим RFC для себя выделил несколько слабых моментов:

- очень большой контекст, много деталей, RFC сложный для восприятия - стоило разделить RFC с идеей и RFC с детальной реализацией
- дорабатывал идею в процессе написания RFC - пострадала структура
- обсуждал RFC с лидами команд - разработчиков микрофронтов уже после его написания, то есть фактически позже чем нужно начал собирать функциональные требования, которые напрямую влияют на реализацию

Обсуждение экосистем микрофронтов с лидами команд очень помогло сформировать окончательное видение платформы, вдохновиться идеями и собрать доп. требования, а также отделить проблемы специфичные для трамвайных микрофронтов.

Одна из основных общих проблем между экосистемами - это управление версиями микрофронтов в приложениях. На втором месте - валидация контрактов между микрофронтами и приложением - так как независимые от приложения релизы это одна из главных фич микрофронтов, тут очень важна прямая и обратная совместимость.
  • 👍 3
  • 🔥 2
Post #148 989
Привет!

Появился интересный проект связанный с микрофронтендами, и хочется рассказать про мои подходы к его проектированию, в первую очередь что бы структурировать их и уложить в голове, выделить проблемные места, но надеюсь что-то будет полезным и вам.

Важный момент - у меня около-нулевой опыт разработки бэкенда и работы с базами данных, поэтому буду особенно рад фидбеку по этим областям.

Сам проект на начало января 2024 года еще на этапе проектирования, поэтому эта серия постов скорее всего часто будет пополняться.

Итак, про проектирование.

Все начинается с проблемы.

Во-первых, у нашего фреймворка Tramvai есть свое решение для микрофронтендов, Child Apps, использование которых только набирает обороты в компании.

Также, в Тинькофф есть еще не меньше 4-х взрослых экосистем с микрофронтендами, про это есть разные доклады и статьи, вот некоторые из них:

- https://www.youtube.com/watch?v=adgUumoPv6o
- https://habr.com/ru/companies/tinkoff/articles/517230/
- https://habr.com/ru/companies/oleg-bunin/articles/718302/

Как минимум в двух из этих экосистем существуют мощные конструкторы страниц на основе микрофронтов-виджетов.

У разных экосистем по большей части разные проблемы, например команде которая начнет использовать наши Child Apps сейчас надо самостоятельно решить и автоматизировать ряд вопросов:

- Версионирование микрофронта
- Публикация статических файлов микрофронта в s3 плюс настроенный CDN
- Управление версиями микрофронтов в приложении (релизы и откаты, история изменений)
- Витрина для отдельных микрофронтов
- Опционально, контракты между микрофронтом и приложением (входящие и исходящие данные, события)
tramvai.dev Overview | tramvai Micro frontends heavily integrated with tramvai framework
  • 👍 2
  • 🔥 2
  • ❤ 1
Post #147 1.32K

Forwarded from Alexey Ryazanov

В 3 версии Tramvai появилась поддержка View Transitions API. Вкратце – это возможность создания анимированных переходов между состояниями DOM. Мы сделали демо на CodeSandbox, показывающую как это работает. Приглашаем ознакомиться.

Возможно, стоит показать это вашим дизайнерам, у них могут возникнуть интересные идеи 🌚
tramvai.dev View Transitions | tramvai Overview
  • 🔥 16
  • 👍 2
Post #146
SuperOleg dev notes pinned «Привет! Не так давно на Github была заблокирована организация Тинькофф, и к сожалению публичное зеркало репозитория tramvai со всеми настройками и звездочками кануло в лету. С опозданием переехали в новую организацию - https://github.com/tramvaijs/tramvai…»
Post #144 1.8K
В комментариях к предыдущему посту подсветили тонкости работы React Server Components, что React делает основную работу с RSC (а не Next.js как я писал ранее) и хочется копнуть еще поглубже.

Сразу прикреплю ссылку на статью где хорошо и подробно разбирается механизм RSC (upd. местами out-of-date но концепции актуальны) - https://www.plasmic.app/blog/how-react-server-components-work

Что нам тут важно и еще не рассмотрели, это пакет react-server-dom-webpack - на сервере, импорт клиентского компонента заменяется на специальный сериализуемый объект, где присутствует ссылка на модуль вида `./src/ClientComponent.client.js`.

Для клиентского кода этот пакет содержит метод для реконструкции RSC формата в дерево React элементов.

Также, в имплементации Partial Prendering можно увидеть не один раз слово postponed.

По этому ключу вижу PR в React с Postpone API (механизм для работы с промисами в компонентах, которые могут быть зарезолвлены позже, по сути defer) и PR где мы видим работу над пререндером и возобновлением рендеринга, новые апишки prerender и resume - в общем много интересных и сложных вещей на которые полагается Next и будут полагаться другие мета-фреймворки.

Собственно вот и код в Next где мы видим использование prerender метода и получение postponed данных, и рядом код с использованием resume метода который работает как раз с postponed компонентами.

postponed данные, возвращаемые методом prerender, содержат строку в формате RSC.

Итого, как работает PPR в Next.js:

На этапе сборки, для каждого роута Next вызывает react-dom/static prerender (этот метод возвращает и AppShell и postponed дерево), и сохраняет полученную разметку в кэш. Также, в кэш сохраняется и полученное на этом этапе postponed RSC дерево компонентов, если вы будете собирать официальную демку, найдете postponed в кэшах с мета информацией о страницах, например файл .next/server/app/index.meta.

В рантайме, Next проверяет есть ли страница (App Shell) в кэше, и если есть - отдает в стриме.

Затем, проверяет есть ли postponed дерево в кэше, если есть - комбинирует стрим ответа со стримом, который вернет react-dom/static resume(postponed).

Концептуально понятно и просто, изящно, и тут очень радует что большую часть работы все-таки делает фреймворк - React.

Конечно, у Next тут много своего кода и специфики, например как собирается дерево компонентов страниц и лэйаутов для рендеринга из сегментов, но никакой магии с вычислением отдельного отложенного React дерева на этом уровне нет.

До этого у меня был стереотип что React не будет так сильно залазить в сборку / серверную часть и гораздо больше всего остается на плечах мета-фреймворков.

Очень ждем, когда все эти механизмы выйдет из экспериментального статуса)
GitHub Add Postpone API by sebmarkbage · Pull Request #27238 · facebook/react This adds an experimental unstable_postpone(reason) API. Currently we don't have a way to model effectively an Infinite Promise. I.e. something that suspends but never resolves. The reason ...
  • 🔥 5
Post #143 1.52K
Привет!

У Next.js недавно появилась новая экспериментальная фича - Partial Prerendering, которая решает проблемы SSR (долгий ответ сервера) и ISR (статичные данные без стриминга), и по сути комбинирует эти подходы.

С момента анонса очень хочу разобраться как же это работает под капотом, все изменения в принципе в одном PR, но далеко пока не ушел, тут изначально надо понимать как работает новый App роутер в Next.js и как работают React Server Components.

Кстати вот интересный гайд от Дена Абрамова которые поможет лучше понять как работает RSC написав механизм с нуля.

Что бы разобраться с partial prerendering (далее ppr), стоит рассмотреть важные моменты работы (как я их понимаю) про App роутер и RSC:

- RSC механизм отправляет на клиент данные для рендеринга в специальном текстовом формате, они могут содержать React дерево с данными, необходимыми для рендеринга, и например также JS/CSS чанки, которые надо вставить на страницу перед рендерингом, ReactDOM уже умеет с этим работать
- App роутер позволяет собирать страницы из кусочков - каждый сегмент урла может иметь отдельный лэйаут и компонент страницы
- App роутер реализует RSC механизм, он используется для отложенной загрузки данных (async компоненты) и SPA-переходов
- RSC для deferred данных - отдается в текущем HTML стриме
- RSC для SPA-переходов - отдается через отдельный GET запрос на тот же урл что и целевой роут, но с query параметром ?rsc=xxx

Также, это немного рассматривал в постах про Deferred Actions, у потокового рендеринга в React есть разделение разметки на App Shell и динамическую.

App Shell - это все ваше приложение, но с отрендеренными fallback компонентами для всех Suspense границ (внутри которых используются async серверные компоненты или выкидывается промис если у вас не Next.js, далее это будут suspended компоненты)

Динамическая часть - это то что вернут suspended компоненты после резолва промиса, у некста это как раз RSC.

PPR - это механизм предварительного рендеринга App Shell страниц приложения в билд тайме или в рантайме через ISR.
И если я все правильно понял, киллер фича тут как раз в том, что Next.js умеет в стриме ответа скомбинировать готовый App Shell, отдать его сразу первым чанком в стриме и не рендерить эти React компоненты повторно, и дальше в стриме рендерить только suspended компоненты, и вклеивать их в нужные слоты в App Shell на клиенте.

За счет вложенного роутинга и всех наворотов Next.js с кэшами, это фактически полноценный кэш рендера HTML на уровне компонентов (механизм с которым я экспериментировал - https://t.me/super_oleg_dev/125 - без особого успеха и гораздо менее перспективным образом).

То есть это и экономия на серверных вычислениях, и отличный TTFB на первый заход пользователя (стандартный паттерн с App Shell требует использования Service Worker, что несет свои сложности и работает только на повторные заходы).

Но, это подчеркивают коллеги из Vercel в твитах вокруг анонса PPR, эта фича требует очень вдумчивого подхода, то есть весь флоу что будет App Shell а что динамикой, надо тщательно проектировать.

В первую очередь опасность в возможности закэшировать динамические данные.
Next.js будет автоматически определять динамический ли компонент, например по прямому использованию глобальных headers / cookies, но мне не кажется такой механизм очень надежным.

В любом случае, это крутая фича, которая очень хорошо вписывается в архитектуру с потоковым рендерингом, RSC и вложенным роутингом.

И конечно официальная демка - https://www.partialprerendering.com/
Telegram SuperOleg dev notes Привет! Не так давно писал про механизм lazy hydration - https://t.me/super_oleg_dev/102, основанный на хаке с dangerouslySetInnerHTML Встретил интересный баг: - если LazyRender обернут в Suspense - и мы ловим ошибку This Suspense boundary received an update…
  • 👍 18
  • ❤ 2
  • 🔥 1
Post #142 1.6K
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →