TGViewer
Channel Public Channel
Start Career in DS

Start Career in DS

@start_ds

Тут публикуются материалы для прокачки скиллов в DS и подготовки к собеседованиям.

Пишем про технические тулзы, визуализацию данных, бизнесовые задачи, разбираем ML-алгоритмы и обсуждаем смежные темы :)

Автор: @RAVasiliev

№ 5141779667
Subscribers
11.5K
Photos
95
Videos
2
Links
325

Showing posts older than #283 · Back to latest

Older Posts 19 shown
Post #282 6.46K
​​☕️ Random-coffee боты для нетворкинга в data science

Концепция random-coffee бота заключается в том, что каждый понедельник он подбирает вам случайную пару из людей, которые так же, как и вы, зарегистрированы в нём. И за неделю надо списаться с человеком и договориться на онлайн-созвон или живую встречу за чашечкой кофе

Какой профит? На встрече вы можете обнаружить общие интересы, поделиться ценными инсайтами и опытом друг с другом. Кто знает, возможно, вы даже найдете партнера для совместной работы над проектом или исследованиями.

Важно писать партнёру первым, потому что чаще всего люди не начинают диалог сами.

🤖 Вот некоторые random-coffee боты:
– @ODS_RCbot - бот сообщества Open Data Science
– @RandomCoffee_Habr_bot, @RHRandomCoffeeBot - кофе-боты для программистов

Ставь огонёчек, если до этого не знал о существовании такой штуки) 🔥
  • 🔥 79
  • 👍 3
Post #281 6.33K
​​🚕 Как в Ситимобил тестируются гипотезы?

Бывает так, что обычные способы A/B тестирования не подходят. Например, из-за несоблюдения главного условия валидности A/B теста – stable unit treatment value assumption, которое говорит, что измененные условия воздействуют только на группу, к которой они были применены, и не воздействуют на пользователей из других групп.

Ребята из Ситимобил 2 года назад написали классную статью о подходе к A/B тестированию, который называется switchback. В ней вы узнаете, в чем заключается суть этого подхода и какие у него преимущества 🙂

Читайте статью и ставьте пальцы вверх, это заряжает на новые посты! 👍
  • 👍 37
  • ❤ 5
  • 🔥 2
Post #280 6.3K
📈 «Корреляция не подразумевает причинно-следственную связь»

Для машинного обучения становятся все более актуальными вопросы причинно-следственного анализа (causal inference) - когда главной целью моделирования является не прогноз и его качество, а то, как мы можем принимать решения на основе нашего алгоритма.

Недавно нашли клёвую статью, в которой рассказывается о причинно-следственном анализе, его методах и применении в машинном обучении. Её классная особенность в том, что практически для каждого утверждения автор приводит хороший пример. Советуем почитать, займёт около 15 минут 🙂
  • 👍 52
  • ❤ 6
  • 🔥 2
  • 🤩 2
Post #279 6.28K
​📄 Как сделать продающее CV
Этим вопросом часто задаются DS’ы/аналитики/разработчики. Секретов и советов повсюду очень много. Но как конкретно это делать всё равно не все понимают.

Мы с ребятами сделали бота на основе ChatGPT, который поможет вам преобразовать основные блоки вашего резюме в более понятные и чёткие.

В бота можно потыкаться тут: @cv_coach_bot
Самое эффективное - присылать ему текущий опыт работы, бот будет его преобразовывать. Примеры - на скринах. Если будет фидбэк (и позитивный, и негативный) - приходите с ним в личку.

Подробнее про проект написали на vc.ru

UPD: запросы обрабатываются чуть дольше обычного из-за пиковых нагрузок
  • 🔥 28
  • 👍 4
  • ❤ 1
Post #278 6.71K
​​🐼 Клёвая статья про неэффективные паттерны работы в Pandas
Часто у юзеров pandas при использовании библиотеки возникают «плохие привычки» - неэффективные способы работы. В этой статье автор описывает четыре неэффективных паттерна pandas и показывает более эффективные подходы к решению рабочих задач.

Вот паттерны и их лучшие аналоги:
1.❌Использование мутаций (пошаговых изменений объектов DataFrame)
✅ Использование цепочек методов

2. ❌ Применение циклов for и встроенных методов-генераторов при работе с объектами DataFrame
✅ Использование метода .apply / векторизованных операций

3. ❌ Неоправданное использование .apply при работе с большим объемом данных
✅ Использование np.select, np.where и .isin

4. Использование неподходящих типов данных (например, использование строк, а не pandas.Categorical для описания категориальных признаков)

Чтобы понять, почему такие паттерны эффективнее, лучше прочитать саму статью. И оставляйте огоньки под постом, это всегда приятно!🔥
  • 🔥 83
  • ❤‍🔥 3
  • 👍 2
Post #277 5.42K
🔥Очень по-горчему: прямо сейчас проходит DataFest!
Если кто не слышал, это большая конфа от ODS - крупнейшего ML/DS сообщества в Восточной Европе!
Вот здесь можно посмотреть про все доклады, которые там проходят

А вот здесь сегодня в 16:45 я буду выступать с докладом ‘Кто такие аналитики в Фудтехе Яндекса и как мы их нанимаем’. Приходите послушать, инсайты точно будут 🙂
YouTube Data Fest 2023, день 12: оффлайн в Москве 31 мая Открываем заключительную неделю Data Fest 2023! Сегодня вас ждут живые выступления в гостях у Сколтеха: -С 12 до 14 доклады про DS/ML Open Source и Random DS -С 15 до 18 доклады секции Career Полное расписание: https://ods.ai/events/fest2023-moscow4/schedule…
  • 🔥 16
  • 👍 7
  • ❤ 2
  • ❤‍🔥 2
Post #275 8.02K
​​👨‍🎓 Как изучить SQL самостоятельно?

В этом вам может помочь крутая статья с «дорожной картой» и источниками информации. А чтобы побольше заинтересовать вас, вот первые 10 пунктов оттуда, которые автор советует изучать последовательно, от 1-го к 10-му:
1. Основы реляционных баз данных
2. Основы SQL
3. Сложные SQL-запросы
4. Базовые операции изменения данных
5. Работа с индексами
6. DDL, DML и TCL
7. Настройка производительности
8. Управление правами доступа
9. Процедуры, триггеры и функции
10. Интерфейсы для работы с базой данных

В статье к каждому пункту есть подробное описание и ссылки на материалы – всё, чтобы самостоятельно изучить SQL 😊
  • ❤ 46
  • 🔥 21
  • 👍 3
Post #274 7.07K
🎸 Ещё один интересный EDA: исследование успешности музыкальных исполнителей

В нём автор:
1. Строит базовые гистограммки распределений
2. С помощью plotly делает интерактивные scatterplot’ы и исследует происходящее на них
3. Строит регрессии для оценки значимости влияния факторов друг на друга
4. Рассуждает о причинно-следственных связях в популярности музыки

P.S. Там в коде периодически происходят крайне странные штуки, но тут скорее интересен именно подход автора к связыванию реального мира и данных. Если вы хотите серьёзный научный подход, вам скорее сюда
YouTube Успех в музыке неизбежен (Data Science) Мы используем анализ данных на python, чтобы понять, как стать успешным в музыке, как добиться успеха в музыке. Мы продолжаем разведочный анализ, и к нему сегодня добавляется проверка гипотез на python и чуть более продвинутая визуализация данных на питоне.…
  • 👍 69
  • 🔥 19
  • ❤ 6
Post #273 6.76K
​💸 Задачи на Market Sizing

Тагир выпустил клёвый пост про логические задачки на собеседованиях. И одним из блоков затронул важную тему - Market Sizing. Что это такое? К ней относятся бесячие задачки, которые хоть раз в жизни спрашивали точно всех:
- Сколько самолетов сейчас в небе?
- Сколько поездов сейчас едет в метро?
- Сколько фонарей в Москве?
- Сколько шариков для гольфа влезет в боинг?

“ЗАЧЕМ ОНО НУЖНО” спросите вы. Ответ вытекает из названия.
Аналитикам часто приходится прикидывать различные числа: сколько юзеров будет у той или иной фичи, какой будет эффект от внедрения модели, какой объём рынка мы пытаемся покрыть и т.д. И важно уметь решать такие задачи чётко и последовательно

КАК ИХ РЕШАТЬ
Как правило, вычислить искомое значение напрямую нельзя. Можно лишь разложить по факторам искомое число, прикинуть их значеия и погрешность на открытых источниках. При этом важно придерживаться типа МЕСЕ (Mutually Exclusive and Collectively Exhaustive ― «взаимно исключающие, совместно исчерпывающие»).
Именно скилл правильно разложить величину по факторам и проверяется таким типом задач.

Есть клёвое видео, в котором разбираются подобные кейсы (скрин оттуда)
И есть статья от Changellenge, по которой можно прочувствовать саму концепцию, которая лежит в основе такиз задач (МЕСЕ)
  • 🔥 52
  • ❤ 20
  • 👍 15
  • 👏 11
  • 🤩 6
  • 😁 4
Post #272 6.02K
🍀 Всем привет! Новости про мок-интервью 🙂

1. В комментариях к посту с моками оказалось очень много интересных вопросов, поэтому нам потребовалось чуть больше времени на объявление результатов.

Итоги конкурса:
- В номинации самые интересные вопросы с собеседований побеждают: @sciuru, @darth_fuckn_vader, @Mishanya43
- По велению рандома ещё 2 мока достаются @ping_pong_genocide и @Curinga

Поздравляем победителей и спасибо всем участникам 🙂

2. Мы решили попробовать запустить активность с моками на всех!
После поста нам писали люди с примерно следующими историями: “Прошел курс по DS от школы X. Знаю базовую теорию. Но на интервью боюсь ходить/теряюсь на них/получаю отказ за отказом”. Моки решают именно эту проблемы - дают вам опыт и обратную связь.

Ссылка на условия проведения и анкету для записи на моки тут

Если вам зашли конкурсы в нашем канале - ставьте 🔥
Разыграем что-нибудь ещё 🙂
  • 🔥 36
  • ❤ 3
  • 👍 3
Post #270 6.6K
📈 Start Career in DS: чем вам будет полезен канал
В последнее время у нас много новичков, давайте расскажем немного про авторов контент 🙂

Канал веду я, Рома Васильев. 5 лет в ML & Аналитике данных, сейчас лидю команду аналитики в Яндекс.Лавке и преподаю ML в ВШЭ. Мне помогает ассистент Олег, будущий великий Data Scientist :)
Тут публикуются материалы для прокачки скиллов в DS и подготовки к собеседованиям. Пишем про технические тулзы, бизнесовые задачи , разбираем ML-алгоритмы и обсуждаем смежные темы (например, проверку гипотез)

Несколько популярных постов из нашего канала, которые будут вам полезны:
- Розыгрыш бесплатных мок интервью (продлится до 12 мая)
- Курс по машинному обучению, который читается на ФКН ВШЭ
- Красивый курс по базовой теории вероятностей и статистике
- Курс ‘Python для анализа данных’
- 6 лучших бесплатных курсов для изучения Python
- Мини-лекции на Youtube про линейную регрессию и функционалы потерь регрессии
- Интервью на Youtube c легендами индустрии
  • 👍 27
  • 🔥 18
  • ❤ 10
  • 😁 9
  • 🤩 9
Post #269 6.87K
​​🤨 Как определить размер выборки для бутстрэпа?

Бутстрэп — это один из популярных методов обработки результатов A/B тестов. Он довольно универсален, но его проблема заключается в том, что он является эмпирическим. То есть нет теории, которая лежала бы в его основе, как например, для t-теста. И все бы ничего, но на этапе планирования A/B теста нужно определить размер выборки.

Вот в этой статье рассказывается о том, с помощью какой формулы можно определять размеры выборки. А главное, тут показывается на реальных примерах, почему и в каких случаях это работает 🙂

P.S. Напоминаем, что вы всё ещё можете поучаствовать в розыгрыше! Уже 12 мая мы назовем счастливчиков, которые получат бесплатные мок-собеседования
  • 🔥 24
  • 👍 14
  • 🤩 13
  • ❤ 10
  • 😁 4
Post #268 6.99K
Мок-интервью - одна из самых мощный техник подготовки к собеседованиям. Это симулятор реального интервью, на котором вы оцениваете свои знания в максимально приближенных к реальным условиях.

Чтобы проверить интерес к теме, мы проведем конкурс: разыгрываем 4 мок-интервью с развёрнутым фидбэком для вас (укажем на сильные/слабые стороны, дадим советы по проработке навыков). Всё это будет бесплатно и полностью приватно 🙂

Проводить моки будет автор канала Start Career in DS Рома Васильев.

Коротко о Роме:
– Проводит собеседования в Яндексе, до этого делал это в DS командах Мегафона и Магнита
- Занимался наймом и развитием стажёров и более опытных специалистов
– Сейчас строит аналитику ассортимента в Яндекс.Лавке
– Закончил ВМК МГУ с красным дипломом

Условия розыгрыша:
1. Написать в комментариях самые интересные вопросы и задачи, которые вам встречались на собеседованиях. Если вы только начинаете свой путь - можете рассказать про вопросы, которые слышали от товарищей! Или просто про то, что часто спрашивают 🙂
2. Поставить на этот пост реакцию
3. Ну и, конечно, быть подписанным на этот канал)

13 мая мы объявим четырех победителей:
- Двоих выберем экспертно по самым интересным вопросам/задачам
- А ещё двоих выберем абсолютно случайно среди комментариев к этому посту

Учитываться будут только осмысленные комментарии (с вопросами)

По любым вопросам пишите сюда
Примеры моков в записи можно посмотреть тут

🍀 Удачи!
Telegram Start Career in DS Тут публикуются материалы для прокачки скиллов в DS и подготовки к собеседованиям. Пишем про технические тулзы, визуализацию данных, бизнесовые задачи, разбираем ML-алгоритмы и обсуждаем смежные темы :) Автор: @RAVasiliev № 5141779667
  • 🔥 74
  • 👍 5
  • 🎉 4
  • 🤩 2
  • ❤ 1
Post #266 6.76K
✒️ Подборка задач с одного из дней карьеры в МИФИ
Как-то мы уже постили задачки со дня карьеры в МГУ, и, кажется, вам зашло. Поэтому вот подборка задачек на теорвер, матан, логику и т. п. от одной компании по управлению цифровыми рисками: за две правильно решённых задачки можно было получить их мерч 🙂

Пишите свои решения в комментариях и, если вам нравятся посты с задачками, ставьте огонёчки 🔥
#задачи
  • 🔥 46
  • 👍 5
Post #265 6.58K
🥳 Парадокс дней рождения

Часто говорят, что для работы в аналитике данных нужна математическая интуиция. Один из способов её развить - рассуждать над задачками из повседневной жизни. Парадокс дней рождений - одна из таких задач.

Представьте, что вы и еще 22 человека находитесь в одной комнате. Какова вероятность, что хотя бы у двух человек из комнаты дни рождения приходятся на один и тот же день? А если в комнате находитесь вы и еще 49 человек?

Попробуйте посчитать эту вероятностью сами, а потом обязательно гляньте нашу статью о парадоксе дней рождения.

Если вас заинтересовал этот парадокс, можете посмотреть, как о нём рассказывает Алексей Савватеев

Ну и ставьте лайки, если вам заходят такие посты 👍

#тервер
Telegraph Парадокс дней рождения Представьте, что вы и еще 22 человека находитесь в одной комнате. Какова вероятность, что хотя бы у двух человек из комнаты дни рождения приходятся на один и тот же день? Интуиция подсказывает, что вероятность небольшая – но, увы, наша интуиция часто ошибается.…
  • 👍 37
  • 🔥 6
  • ❤ 2
Post #264 6.44K
🐢 Первый пост про ChatGPT на этом канале

Пока в комментариях других каналов на тему DS люди ругаются, что они слишком часто делают посты про ChatGPT, мы решили сделать небольшое саммари про нашумевшую нейросеть для тех, кто «в танке»
ChatGPT - это чат-бот с искусственным интеллектом, который поможет вам написать код, сгенерировать идеи, сделать доклад и даже дипломную работу - это лишь малая часть его возможностей.
Пользоваться ChatGPT можно как через официальный сайт, так и через тг ботов.

Мы подготовили для вас краткую инструкцию по регистрации на официальном сайте

Если возиться с регистрацией не хочется - можно использовать тг боты, которые подключены к ChatGPT: например, этот. Но функционал у таких ботов, конечно, поменьше.
После того, как вы зарегистрировались в ChatGPT, можете получить свой API ключ, благодаря которому открываются новые возможности. Например, вы сможете использовать бота в гугл-таблицах. Подробнее об этом можно почитать тут.

Рассказывать про ChatGPT можно долго. Если хотите постов такого рода – ставьте 👍, а если посты про ChatGPT уже надоели и хочется чего-то другого – ставьте 🤩
Telegraph Краткая инструкция по регистрации на официальном сайте ChatGPT 0. Вам понадобятся терпение и 150 рублей 1. Установите VPN - например, Hola, и запустите его 2. Зайдите на сайт ChatGPT 3. Нажмите «Sign up» 4. Введите свою gmail почту, ткните зелёную кнопку и введите придуманный пароль. Снова ткните зелёную кнопку 5. Если…
  • 👍 47
  • 🤩 28
  • 🔥 9
  • ❤ 3
Post #263 6.18K
Start Career in DS 📈 Метрики и функции потерь в линейной регрессии: как выбрать лучшую модель? — Метрики - это инструменты для оценки качества моделей машинного обучения. Они наглядно показывают человеку, насколько хорошо модель предсказывает результаты, что позволяет выявить…
📹 Видео про функционалы потерь и метрики регрессии!

Мы строили-строили и наконец построили! Долго собирались сделать видео про основные ФП и метрики - и наконец выпустили 🙂

Накидайте комментарии, задавайте вопросы и ставьте лайки!
Если хотите больше подобных видео - пишите какие темы были бы наиболее интересны

https://youtu.be/EyxcTnHl1wk
YouTube Функционалы потерь и метрики регрессии. Простым языком! 0:00 - О чём видео 0:24 - План видео 00:38 - Зачем нужны функционалы потерь? 01:15 - Простейший функционал потерь (MAE). Как его строить? 03:20 - Как сильнее штрафоваться за большие отклонения? MSE. 04:46 - Сравнение MSE и MAE 05:42 - Более экзотические…
  • 🔥 27
  • 👍 6
  • ❤ 3
Post #259 6.25K
​​🤔 Как стать аналитиком?

У Тагира, который работает senior аналитиком в Альфе, есть целая серия постов это. Всего там 5 частей:
Часть 1: Почему люди хотят стать аналитиками, и признаки того, что аналитика – это твоё.
Часть 2: Тут подробно разбираются основные типы аналитиков: чем они занимаются и какие навыки для этого нужны.
Часть 3: Какими будут ваши первые шаги в аналитике и варианты обучения на аналитика в зависимости от вашего бэкграунда.
Часть 4: Ресурсы, где можно получить или подтянуть навыки для работы аналитиком - Python, A/B тестирование, SQL и т.д.
Часть 5: Лучшие школы и курсы для аналитиков.

А ещё у него на канале очень много другой полезной информации, советуем глянуть
  • 👍 19
  • 🔥 10
  • ❤ 4
Post #250 7.01K
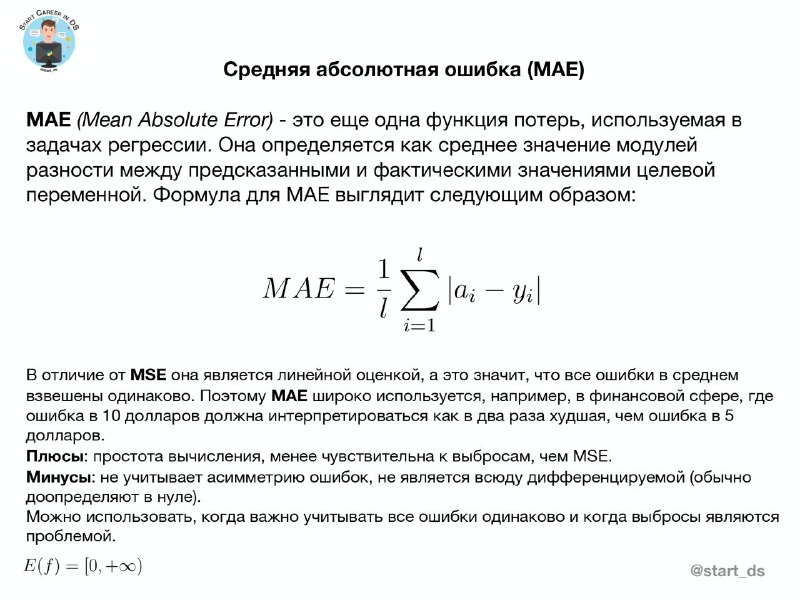
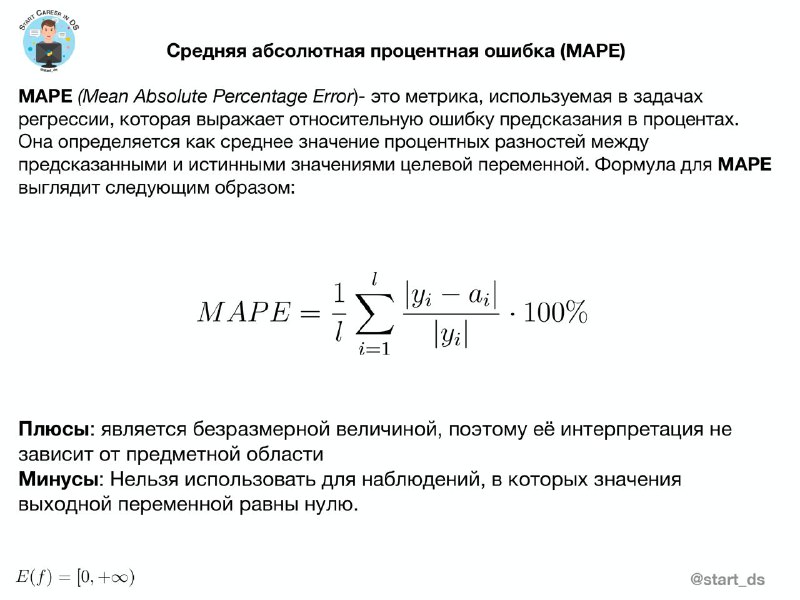
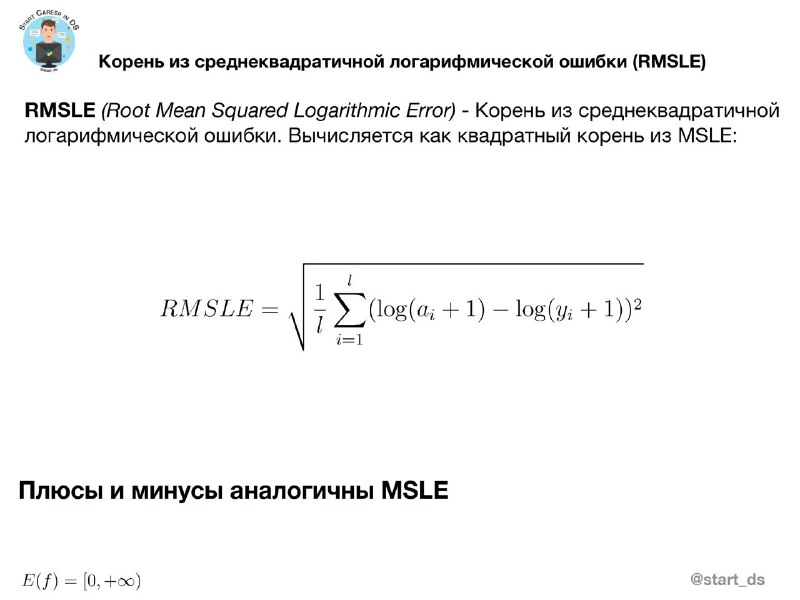
📈 Метрики и функции потерь в линейной регрессии: как выбрать лучшую модель?

— Метрики - это инструменты для оценки качества моделей машинного обучения. Они наглядно показывают человеку, насколько хорошо модель предсказывает результаты, что позволяет выявить возможные проблемы.

— Функции потерь - это способы измерения ошибки между предсказанными значениями и истинными значениями. Они помогают модели обучаться и адаптироваться к данным.

В прикрепленных фото вы найдете формулы, плюсы и минусы основных метрик и функций потерь в линейной регрессии.

В ближайшее время на нашем ютуб-канале выйдет мини-лекция про метрики и функции потерь – поэтому подписывайтесь и жмите колокольчик, чтобы не пропустить видео 🙂

Ставьте лайки на этот пост, чтобы ролик вышел быстрее) 👍
  • 👍 83
  • 🔥 10
  • ❤ 7
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →