TGViewer
Channel Public Channel
Путь SRE

Путь SRE

@sre_community

Это проект Слёрма: коммьюнити для SRE-инженеров

Наш с вами кайфовый чат — https://t.me/sre_chat
Subscribers
1.91K
Photos
177
Videos
11
Links
160
Recent Posts 20 shown
Post #374 492
Четыре алерта почти подряд. Один сервис отдаёт 500, latency поползла вверх, в чате уже спрашивают, что происходит. 😰
Что делаете первым?

У нас как раз есть симулятор такого инцидента. Вы проходите его за дежурного SRE и принимаете решения по ходу ситуации.

В конце сможете сверить свой подход с SRE-логикой и посмотреть, какие навыки стоит прокачать дальше.

Если летом пропустили, то советую пройти. Минут 15, и почти наверняка где-то захочется выбрать свой вариант)

Забрать симулятор здесь 🙂
  • ✍ 2
  • 👻 2
  • ❤ 1
Post #373 746
В сентябре у нас стартует SRE-интенсив. Да, сегодня прямо рекламный пост 🙂

21 сентября у Слёрма стартует 7-дневный интенсив по SRE. На нём за неделю соберёте для своего сервиса SRE-пакет:
✔️ SLI и SLO
✔️ error budget
✔️ сигналы мониторинга
✔️ план первых действий при инциденте
✔️ mini-postmortem
✔️ roadmap того, что улучшать дальше

То есть на выходе остаётся не просто набор терминов, а понятная схема работы с надёжностью конкретного вашего сервиса.

Разбирать всё это будем вместе с моим коллегой Максимом Гусевым, руководителем команды SRE в RWB. Он больше 11 лет занимается отказоустойчивыми системами, был SRE-техлидом в финтехе и руководил Observability Team в Dodo Engineering.

Старт 21 сентября · 7 учебных дней · 5 000 ₽

Посмотреть программу целиком и записаться 👉 клац!

Если SRE для вас уже давно не новая тема и хочется работы на Kubernetes-стендах, командных инцидентов и более глубокой практики, интенсив может быть слишком базовым. Тогда лучше сразу смотреть большой курс по SRE. К нему ещё отдельно вернёмся.
  • ❤ 2
  • 👍 2
  • 🔥 1
Post #372 772
Давайте сегодня не мы вам кейс, а вы нам 🙂

Наверняка у каждого, кто дежурил или настраивал мониторинг, был тот самый алерт. Он стабильно прилетает (часто ночью), все знают о его существовании, но каждый раз начинается немой диалог: «Так, и что мне теперь с этим делать?»
Это может быть классический CPU > 80%, сообщение без контекста и ссылок на ранбук, алерт на технический симптом, который ни на что не влияет, или уведомление, которое срабатывает ложно настолько часто, что его просто заглушили в Slack/Telegram.

Хотим разобрать один такой пример вместе. Принесите в комментарии самый бесячий алерт из своей практики (компания и сервис нам не нужны, всё чувствительное можно убрать или заменить):
1. Что примерно написано в алерте?
2. Что вы обычно делаете, когда он прилетает?
3. Почему хочется его выключить, переписать или забыть как страшный сон?

Можно прислать скриншот или описать словами. Один из примеров возьмём в следующий раз и устроим ему подробный разбор: выясним, что этот сигнал сообщает инженеру, должен ли он вообще кого-то будить и какой информации в нём не хватает.
  • 👀 4
  • 👍 1
  • 🤝 1
Post #371 713
Итак, backend отвечал 200 OK. А оплатить всё равно было нельзя.

Закрываем нашу смоделированную историю. Проблема здесь даже не в том, что кто-то посмотрел «не на тот график». Дашборд честно отвечал на вопрос, который ему задали: сервис технически отвечает? Да. Только пользователь приходил за другим — ему нужно было закончить покупку.

И вот тут полезно посмотреть на свой мониторинг со стороны:
1. Какое действие пользователя для сервиса действительно критично?
2. Увидим ли мы, если именно оно начнёт ломаться только у части людей?
(Например, в одном регионе, на одном endpoint или в конкретном сценарии, пока общие графики остаются зелёными).
3. Узнаем ли мы о проблеме раньше поддержки? Если первым настоящим алертом становится сообщение пользователя «у вас ничего не работает», значит, в наблюдаемости есть слепая зона.
4. Когда сигнал приходит, понятно ли инженеру, что с ним делать? Сам по себе график, сообщающий в три часа ночи «что-то выросло», ценности добавляет мало.

Можно взять один свой сервис и быстро прогнать его по чек-листу из четырёх вопросов:
✔️ Что пользователь должен успешно сделать?
✔️ Видим ли мы сбой именно этого сценария?
✔️ Узнаем ли мы об этом раньше пользователя?
✔️ Понятно ли дежурному после сигнала, что делать дальше?
Если на половине вопросов появилось «ну-у-у…», это отличный повод покопаться в архитектуре алертов 👀


А если хочется не просто читать разборы, а попробовать выстроить SRE-подход вокруг своего сервиса на практике, 21 сентября у нас стартует 7-дневный SRE-интенсив. Это прикладной формат для тех, кто хочет связать разрозненные практики в единую рабочую систему.
  • 👍 3
  • ❤ 2
  • 🔥 1
Post #370 723

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 2
  • ❤ 1
  • 👍 1
Post #369 685
В прошлый раз дашборд говорил, что всё хорошо, а пользователи были другого мнения.

Докидываем данные:
Жалобы идут не от всех. Проблема возникает только у части пользователей, которые доходят до оплаты через один конкретный сценарий.
Разрезаем общие метрики, и картина становится интереснее:
• У основного API по-прежнему всё зелёное.
• 5xx почти нет.
• Latency не уехала.

Но в проблемном пользовательском пути резко просела доля успешных транзакций. Почему этого не было видно сразу?

Потому что backend в этих случаях технически отвечает нормально. Запрос обработан, HTTP 200 вернулся (например, с ошибкой внутри тела ответа). Но нужного пользователю результата не случилось.

Итак, сервис технически доступен, а воспользоваться им нельзя. В следующем посте закроем кейс и отдельно посмотрим, что здесь вообще стоило мониторить, чтобы не ждать сообщений от пользователей.
  • 👍 4
  • ❤ 2
  • 🔥 2
  • 👏 2
Post #368 735

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🤔 4
  • 👍 2
  • 🤨 2
  • 🔥 1
Post #367 706
Дашборд зелёный. Пользователи говорят, что сервис не работает. Кому верим?

Давайте немного поиграем в on-call. Ситуация смоделированная, но вполне жизненная. В поддержку начинают приходить жалобы: часть пользователей не может завершить покупку.

Открываем основной дашборд:
• HTTP 5xx — без аномалий.
• p95 latency (время ответа) — в привычных значениях.
• CPU и память — в норме.
• Свежих релизов тоже не было.

На первый взгляд всё прекрасно. Кроме маленькой детали: пользователи продолжают писать 🙂
Выбирайте, что сделали бы первым, имея только эти данные. В следующем посте принесём ещё немного фактуры — посмотрим, останется ли ваша версия прежней 👇
  • ❤ 5
  • 👍 3
  • 🔥 2
Post #366 778
27 августа MTS Web Services собирает DevOps- и SRE-инженеров на офлайн-встречу в Москве. И я там тоже буду 😉

Так что если давно хотелось выбраться из чатов и дашбордов в реальный мир, вот хороший повод.

В программе вечера:
*️⃣ мастер-класс по мониторингу ИИ-приложений «Смотри, как думает агент» от платформы MWS RelyOps
*️⃣ «Как создать свой приватный enterprise-каталог операторов в закрытом сегменте» от Orion soft
*️⃣ опыт внедрения ИИ-агента, который сам решает тикеты техподдержки, от SRE-лида MWS
*️⃣«Оптимистичный прогноз о навыках инженера в эпоху AI-native» от платформы MWS DevRails AI

Можно прийти офлайн в Москве или подключиться к трансляции.

Я буду ведущим, так что если тоже придёте — подходите знакомиться 👋

Программа и регистрация
  • 👍 4
  • ❤ 3
  • 🔥 3
Post #365 738
19:07. Падает один сетевой контроллер. Сервисы зарезервированы. Вроде ничего страшного?

Примерно через час в Yandex Cloud уже каскадом отказывают узлы внешней связности. В какой-то момент проблемы одновременно затрагивают две зоны доступности.
Как из одного отказа получился большой региональный инцидент?

Мне здесь понравился один момент: довольно быстро проблема перестала быть только про сломанный контроллер. Система начала сама добавлять себе работы.
После сбоя запустились миграции части виртуальных машин. Сам по себе механизм нормальный, для этого он и существует. Но в условиях аварии миграции создавали дополнительные служебные запросы. Пользовательский трафик не вырос, а внутренней нагрузки стало в разы больше.

И это был только один слой. По сути, контроллер дал первый толчок, а дальше несколько факторов неудачно совпали и начали усиливать друг друга.

В ретроспективе Яндекса для этого приводят модель «швейцарского сыра»: у каждого защитного слоя есть свои слабые места. Обычно следующий слой страхует ситуацию. Но иногда дырки внезапно выстраиваются в одну линию.

И мне кажется, разбирать такие цепочки намного интереснее, чем просто найти один root cause и успокоиться.
Если на postmortem вы нашли убедительную первопричину, продолжаете копать дальше? Или обычно на этом расследование заканчивается?

Пишите в комментариях 👇
А если хочется раскопать этот кейс целиком, у Яндекса есть подробная ретроспектива с таймлайном и списком изменений, которые они внедрили после инцидента.
  • ❤ 5
  • 👍 3
  • 💯 2
Post #363 906
Впервые в «Пути SRE»? Начните отсюда 👇

Здесь мы разбираем SRE через то, с чем инженеры реально сталкиваются в production: инциденты, SLO, observability, алерты, postmortem, on-call и ситуации, где «сделали по best practice» ещё не означает «сделали хорошо».

🐻 Если пока разбираетесь в базе → вот с чего можно начать: что важнее, SLA или SLO и зачем вообще нужны оба

🙂 Если хочется чего-нибудь побоевее → ночная задача про БД: сервис тормозит именно тогда, когда нагрузка почти исчезает

🤨А здесь можно проверить свою гипотезу → разбор задачи

🐸 Хотите ещё одну → куда исчезли логи между Fluentd и Elasticsearch?

😁 А вообще тут собрали хороший мясной дайджест за май-июнь: от метастабильных сбоев и высокой нагрузки до тихих алертов и будней SRE

И оставайтесь рядом. В ближайшее время здесь будет больше инженерных разборов, задач по шагам, кейсов из production и коротких включений практикующих SRE.

Кстати, этой осенью у Слёрма два SRE-старта.

Если хотите понять, насколько вам вообще подходит SRE, то ловите 7-дневный интенсив, старт 21 сентября

Если уже работаете с инфраструктурой или production и хотите пройти полный цикл практики, то для вас есть большой курс, старт 26 октября. Три недели работы SRE-командой

А канал никуда не заканчивается после обучения. Будем дальше ломать, чинить и спорить о надёжности здесь ;)
  • ❤ 2
  • 🔥 2
  • ⚡ 1
  • 👍 1
Post #361 918
Давайте сверим координаты.
В Пути SRE собрались люди с очень разным бэкграундом: кто-то только разбирается, где заканчивается DevOps и начинается SRE, а кто-то уже просыпался ночью от алертов и потом писал postmortem.

Хотим сделать следующие месяцы канала ещё более практическими: больше инцидентов, инженерных задач, SLO, observability, on-call и разборов того, почему привычная SRE-практика иногда вообще не работает.

Поэтому для начала интересно понять, кто сейчас по эту сторону экрана.
Голосуйте ниже. А в комментариях можно добавить роль и одну reliability-задачу, которая сейчас больше всего бесит на работе 🙂

Итак, а теперь к главному вопросу...
  • 🔥 3
  • ⚡ 2
  • 👍 2
  • ❤ 1
Post #360 1.22K
Друзья, всем привет 👋🏻
Сможете решить задачку?⬇️

02:17. Pager разрывается. Продакшн падает. А вы — дежурный SRE.

Успеете среагировать за 15 минут?

Слёрм подготовил интерактивный симулятор реального инцидента: API отвечает 500-й ошибкой, задержка растёт, разработчики спят, а бизнес уже требует ответов.

Вам предстоит принять 5 решений — ровно так, как это делают дежурные инженеры в проде:
⏩ что проверить первым
⏩ какую метрику считать критичной
⏩ когда объявлять инцидент
⏩ что написать пользователям
⏩ что делать после того, как всё починили

❗️Никакой теории — только реальная ситуация и разбор каждого шага сразу после ответа. В конце узнаете, насколько ваш подход похож на мышление настоящего SRE, и получите список навыков, которые стоит прокачать.

Проверьте, спасли бы вы продакшн⬇️

ЗАБРАТЬ СИМУЛЯТОР
  • 👍 2
  • 🔥 2
Post #359 1.33K
Друзья, всем привет 👋🏻

Слёрм запускает Интенсив по SRE⚡️

За 7 учебных дней разберёте:
➡️как SRE измеряет надёжность — SLI/SLO и error budget не на словах, а на цифрах
➡️как работать с инцидентами так, чтобы фиксить систему, а не искать виноватого дежурного
➡️как системно улучшать сервисы, а не тушить одни и те же пожары по кругу

На выходе два реальных артефакта:
🔹SRE-пакет по вашему собственному, знакомому сервису
🔹личный roadmap внедрения SRE-практик на ближайшие 3 месяца

✅Формат лёгкий: Telegram-чат, ~ 3 часов в день, из инструментов нужен только браузер.

✅Автор — Максим Гусев, руководитель SRE в RWB, 11+ лет в отказоустойчивых системах.

Если бы я начинал путь в SRE сегодня, я бы стартовал именно с этого интенсива — рекомендую.

Узнать подробности 👉 на страницу интенсива
  • 👍 2
  • 🔥 1
  • 👏 1
Post #358 1.61K
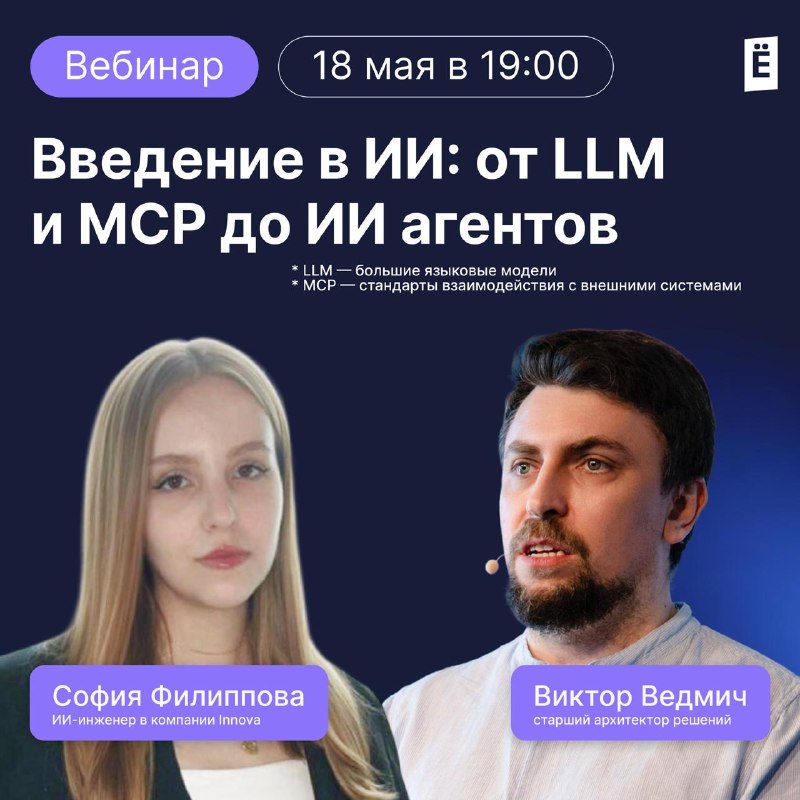
Введение в ИИ: от LLM и MCP до ИИ-агентов

Привет всем! Приходите сегодня в 19:00 на вебинар по ИИ. Эксперты обсудят:

🔸 как работает LLM;
🔸 полезные приемы написания запросов для ИИ на выполнение задачи (промптов);
🔸 как работать с внутренними данными с помощью ИИ-агентов;
🔸 что такое MCP и зачем это нужно;
🔸 как создать своего первого ИИ-агента.

Вы скорее всего слышали про сертификацию CKAD (Certified Kubernetes Application Developer). Обычно на этот экзамен выделяют 120 минут и 18 задач. На вебинаре эксперты проведут демо, как решить все задания буквально за пару минут с помощью ИИ.

👥 Спикеры вебинара — эксперты курса «ИИ в работе DevOps-инженера»:

— София Филиппова, AI engineer at Innova.
— Виктор Ведмич, Senior Solution Architect.

Ссылка придет в бота:
👉 Регистрация за 30 сек 👈
Post #357 1.76K

Forwarded from Слёрм

Я вроде что-то знаю, но цельной картины нет 🧩

Мы знаем, что путь в управление надежностью (SRE) может быть непростым — нужно разбираться и в коде, и в железе, и в процессах, и даже в психологии. Становится особенно трудно, когда не понимаешь, что от тебя требуется и с чего начать.

Если вы готовы реально потрудиться, чтобы сделать большой шаг в направлении SRE, то приходите на обучение.

📌 Старт уже завтра — 6 апреля!

Вы получите:

— Не гугловскую теорию, а рабочий опыт инженеров из российских компаний.
— Не фантазийные задания, а практику в условиях, максимально имитирующих реальность SRE-инженера.
— Не фрагментарные знания, а целый набор необходимых скиллов для того, чтобы развиваться в SRE.

🔥 Набор в группу закроется на днях. Изучите программу и оставляйте заявку — ТУТ 👈🏻
  • ❤ 1
Post #356 1.98K
➡️Время безотказной работы (Uptime, не по-нашенски).

Друзья, всем привет!
Сегодня погорим о почти бесполезной метрики надёжности: uptime.
Инженеры любят говорить, что соглашение об уровне сервиса (SLA)= 99.99. Но это число почти ничего не говорит о реальной надёжности системы, потому что uptime не связан с пользовательским опытом и бизнес-результатом.

Простой пример: 99.99% доступности = примерно 52 минуты простоя в год.

⚡️Но важны не минуты, а контекст этих минут:
• Это 52 минуты ночью или в пик трафика?
• Сломался критический путь или второстепенная функция?
• Затронуто 1% пользователей или 100%?
Одинаковый uptime может означать радикально разные последствия.

Инженеры по надежности (SRE) вообще почти не используют uptime, потому что это сервисная, а не ориентрованная на пользователя метрика. Она не отвечает на главный для нас вопрос: пользователь смог сделать то, ради чего пришёл?

🔹И кстати, именно поэтому в SRE используются цели уровня обслуживания (SLO) на основе пользовательских операций. Типичные индикаторы уровня обслуживания (SLI):
• Доля успешных запросов (Success Rate)
• Задержка (Latency) — 95-й и 99-й перцентили (p95 / p99)
• Актуальность данных (Freshness)
• Полнота данных (Completeness)
• Корректность данных (Correctness)

Критический путь важнее общего SLA. Он есть в любой системе. Например для маркетплейса этот будет выглядеть так: Просмотр каталога → Поиск → Карточка товара → Добавление в корзину → Оформление заказа → Оплата

🔹Надёжность всей системы определяется самым слабым звеном на этом пути. Поэтому разумные SLO распределяются не равномерно, а по критичности. Так повелось, потому что стоимость отказа разная. Если упали рекомендации, пользователь всё равно может купить. А вот если упали платежи, то бизнес остановился.

🔹Поговорим еще про механизм управления риском (Error Budget).
Главная идея SRE:
надежность не максимизируется бесконечно. Она балансируется со скоростью разработки. Например, если SLO = 99.9% успешных запросов, то допустимый бюджет ошибок = 0.1% запросов (примерно 43 минуты недоступности в месяц). Этот бюджет можно осознанно тратить на релизы, эксперименты и инфраструктурные изменения.
🔹Но если бюджет исчерпан, следует использовать заморозку выпуска функций (feature freeze) и делать фокус на надёжности.

⚡️Так все же, почему же идеальный uptime может означать плохой сервис. Классическая проблема – деградация успешности (degraded success).
Вот вам реальный пример, система рассылки уведомлений:
Время безотказной работы API: 99.999%, но 40% сообщений доставляются с задержкой более 1 часа. С точки зрения времени безотказной работ, сервис работает, а с точки зрения пользователя, сервис сломан.
Правильная цель уровня обслуживания здесь выглядит иначе, условно: доставка уведомлений < 5 минут для 99% сообщений. И внезапно оказывается, что реальная доступность системы — 60%.

🔹Как переводить бизнес-риски в SLO
1. Оценить стоимость отказа.
Потери = трафик × конверсия × средний чек заказа × время простоя.После этого разговор про цели уровня обслуживания становится очень конкретным.

2. Найти критические пользовательские сценарии (critical user journeys)
Не все операции равны. Обычно выделяют путь к выручке, активации и удержанию. Именно они получают самые строгие цели уровня обслуживания.

3. Декомпозировать цели по сервисам
Если пользовательский сценарий проходит через 5 сервисов, например аутентификация, каталог, корзина, оформление заказа и оплата, то цель уровня обслуживания системы распределяется по ним через компоновку целей (SLO composition).
И вот это уже инженерная задача — распределение бюджета надёжности (reliability budget allocation).

➡️Что по итогу
Uptime – метрика инфраструктуры. SRE интересует другое, смог ли пользователь выполнить свою задачу? Поэтому реальные SLO строятся вокруг: success rate пользовательских операций, latency, freshness данных, critical user journeys и error budge.

➡️Главный вопрос от SRE бизнесу: сколько денег компания готова терять из-за сбоев? Потому что SLO –не техническая цель, а экономическая договорённость о допустимых потерях 🔥
  • 👍 16
  • ❤ 5
  • 🔥 3
Post #355 1.83K
Красные флаги на собеседованиях 🚩

Друзья, всем привет! Сегодня хочу поговорить про фразы, которые не стоит использовать на собесах, чтобы не поймать мгновенный отказ. Начнем с самой явной:
▶️Люблю, когда всё горит, инциденты бодрят, иначе скучно

Такое высказывание почти всегда значит, что человек не различает хаос и управляемую надёжность. Он не хочет строить системы так, чтобы они реже падали, ему интересен адреналин и тушение пожаров.
Такой кандидат с высокой вероятностью будет саботировать работу над техдолгом, автоматизацией и профилактикой, ведь тогда ему станет скучно.

Идем дальше
▶️
Если что-то падает — я просто иду и руками чиню

Сигнал, что нет мышления в терминах процессов, автоматизации, SLO и устойчивости.

▶️
Документацию писать не люблю, я же не техпис

SRE без передачи знаний и описанных процедур превращается в личного супергероя, а не инженера.
Если человек приходит за тем, чтобы погасить и пободриться, а не за тем, чтобы делать системы предсказуемыми, для SRE‑роли он не подходит.

➡️Что думаете? Есть ли у вас какие-нибудь фразы, которые сразу заставляют насторожиться?
  • ❤ 4
  • 👍 4
  • 🤔 2
  • 💯 2
Older posts →

About this channel

How can I read @sre_community without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Путь SRE: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Путь SRE have?
Путь SRE (@sre_community) has 1.91K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Путь SRE know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →