TGViewer
Channel Public Channel
Симулейтив

Симулейтив

@simulative_official

Мы — образовательная платформа в сфере аналитики Симулейтив: simulative.ru

Создаём курсы-симуляторы, где обучаем на кейсах из реального бизнеса.

Канал по ML: @modprod
Наш уютный чат: @itresume_chat
Поддержка: @simulative_support
Subscribers
7.46K
Photos
2K
Videos
86
Links
1.6K

Showing posts older than #3204 · Back to latest

Older Posts 19 shown
Post #3202 941
Привет! На связи Александр Грудинин, ментор курса «Аналитик данных» 👋🏻

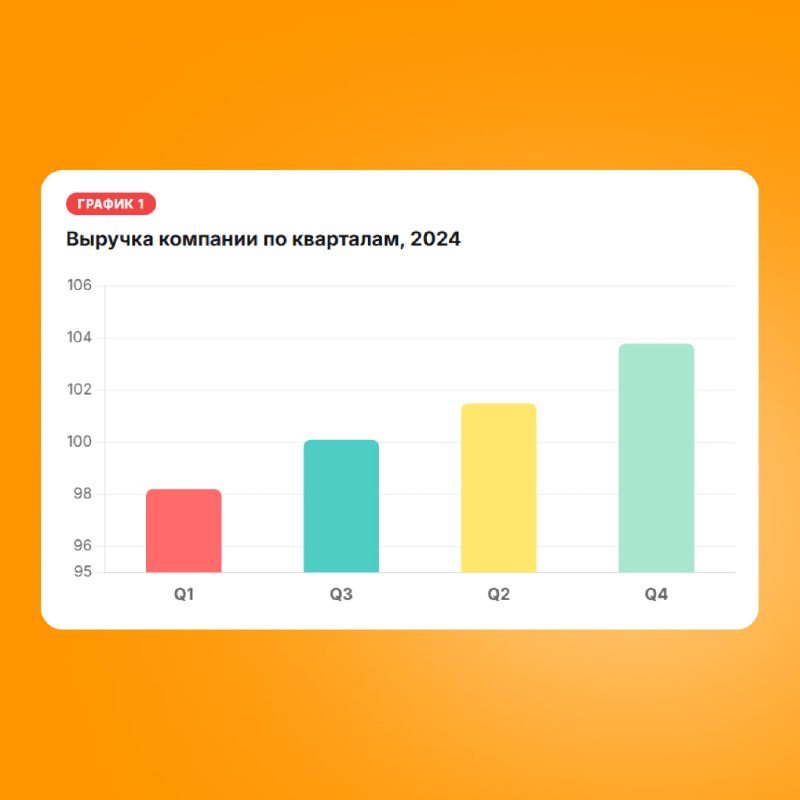
Сегодня тренируем основы визуализации.

Ниже два графика. Оба содержат типичные ошибки, которые встречаются в реальных отчётах и дашбордах. Ваша задача:

1️⃣ Найдите все ошибки в каждом графике;
2️⃣ Объясните, почему это ошибка и как она искажает восприятие данных;
3️⃣ Предложите, как переделать каждый график, чтобы он корректно доносил информацию.


💡 Подсказка: в каждом графике спрятано минимум 3 ошибки. Попробуйте найти все!

Пишите свои варианты в комментариях! Разбор с правильными ответами — завтра.

📈 Симулейтив | ВК | YouTube
  • 🔥 6
  • ❤ 5
  • 😱 1
Post #3201 973
4 реальных кейса применения оконных функций

Всем привет! Я Павел Беляев, ментор курса «Аналитик данных» и ведущий канала Тимлидское об аналитике 👋🏻

Хочу показать несколько примеров применения оконок из реальной практики аналитиков Яндекс eLama.

1️⃣ Последняя запись в исторических данных

Если имеем дело с таблицей, которая обновляется не перезаписью с нуля, а добавлением новых строк для объектов, которые изменились, вот как можно взять последнюю строку:

SELECT *
FROM
(
SELECT *
MAX(updated_at) OVER (PARTITION BY payment_id) AS last_update
FROM payment
)
WHERE updated_at = last_update


Здесь payment — таблица, содержащая транзакции пользователя. Одна строка отражает состояние транзакции на момент добавления строки, т. е. на дату updated_at. Каждая транзакция имеет уникальный идентификатор payment_id, но он не уникален в рамках всей таблицы.

2️⃣ Топовые юзеры

Выясним, кто же главные герои, которые делают нам кассу. Если они уходят, мы получаем заметное проседание доходов. И наоборот, если доходы просели, имеет смысл выяснить, как дела у наших клиентов, не перестали ли пользоваться нашими услугами.

SELECT *
FROM
(
SELECT d, w, user_id, revenue,
ROW_NUMBER() OVER (PARTITION BY d ORDER BY revenue DESC) AS rn -- нумеруем юзеров в порядке убывания их оборота
FROM
(
SELECT DATE(date_paid) AS d,
dateName('weekday', date_payed) AS w,
user_id,
SUM(revenue) AS revenue
FROM datamart.financial_activity
GROUP BY 1,2,3
)
)
WHERE rn<=15 -- Количество топовых юзеров за каждый день
AND w='Wednesday' -- День недели. Часто пользователи активничают ритмично, например по средам.
ORDER BY d DESC, revenue DESC


3️⃣ Lifetime value

LTV часто выбирают как главную метрику компании (North Star Metric). Оконкой можно вывести LTV юзера на каждый момент времени — например, когда он совершает очередной платеж.

SELECT user_id, date_paid, 
turnover,
SUM(turnover) OVER (PARTITION BY user_id ORDER BY date_paid) AS LTV
FROM datamart.money
ORDER BY date_paid DESC


Заметим, что при такой записи выводится LTV на момент date_paid, а не текущий LTV. Так что можно следить за скоростью его роста.

4️⃣ Скользящее среднее

Положим, у нас есть некая величина, которая становится известной только в начале следующего месяца. Например, сумма заактированных оборотов пользователя.

Тогда в течение месяца мы её ещё не знаем. Простой прогноз можно состряпать как скользящее среднее за предыдущие месяцы.

В ClickHouse прошлые значения выводит функция lagInFrame():

SELECT period, SUM(act_amount) am,
lagInFrame(am,1,0) OVER (ORDER BY period ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS am1,
lagInFrame(am,2,0) OVER (ORDER BY period ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS am2,
lagInFrame(am,3,0) OVER (ORDER BY period ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS am3,
(am1 + am2 + am3)/3 AS am_avg,
FROM datamart.money
GROUP BY ALL


Ставьте огоньки, если пригодится в работе!

📈 Симулейтив | ВК | YouTube
  • 🔥 16
  • ❤ 4
  • 👍 1
Post #3200 922
Симулейтив Вебинар: почему 80% новичков в IT выбирают именно аналитику данных Аналитик данных — одна из самых востребованных IT-профессий. Но с чего реально начать, какие навыки действительно нужны, а что можно смело пропустить? И главное — как получить первую работу…
Присоединяйтесь к решению тестовых заданий сегодня в 19:00

Павел Беляев ждёт вас на вебинаре! На примере тестового задания из Magnit Tech мы потренируемся работать со списками товаров и заказов, особенно актуальными для e-commerce.

Мы попрактикуемся:
🟠 Фильтровать выборку разными видами условий;
🟠 С помощью оконной функции выбирать текущее состояние товара в исторических данных;
🟠 А также увидим, как использовать JOIN-объединение таблиц в качестве фильтра.

➡️ Зарегистрироваться на вебинар

📈 Симулейтив | ВК | YouTube
  • ❤ 1
  • 🔥 1
Post #3198 989
A/B-тест в коммуникациях: реальный кейс, результаты и главная ошибка, которую мы недооценили

Привет, коллеги! На связи Евгений Буторин, руководитель CRM-аналитики в Альфа Банке 👋🏻

Делюсь свежим (и поучительным) кейсом из нашей практики по A/B-тестам. Мы тестировали изменения в push + email-цепочке, чтобы поднять пост-коммуникационную активность клиентов.

😶 Что тестировали

Гипотеза: новая версия сообщения (более персонализированный текст + эмодзи + вечерний тайминг) даст больший прирост (lift) в активности или активации клиентов, чем старая.

➖ Группа A (контроль): старая коммуникация
➖ Группа B (тест): новая версия

Метрики:
➖ Активность клиента в Т0 — активность в месяце отправки коммуникации;
➖ Активность клиента в Т1 — активность клиента на следующий месяц после отправки коммуникации.

😶 Выборка и дизайн

Целевая база: 100 тысяч клиентов. Группы стратифицировали по активности, сегменту, времени жизни клиента, тарифу и каналу привлечения.

Период проведения: 1 месяц проведения + 1 месяц вызревания.

😶 Результаты на первый взгляд

Группа B показала рост активности на 11% в Т0 и на 7% в Т1. На первый взгляд мы решили, что пилот успешен, пока не сравнили профили клиентов по сторонним коммуникациям.

😶 Главная ошибка

При стратификации мы не учли параллельные коммуникации вне этого пилота. Даже при том, что на A/B-группы по этому тесту коммуникации были строго разделены, клиенты продолжали получать триггерные рассылки, другие промо, емейлы и SMS от параллельных кампаний, win-back и сервисные рассылки.

В итоге в группах A и B оказалась разная «загрязнённость» дополнительными касаниями: в B случайно попало на 15–20% больше параллельных коммуникаций, чем в A. Это создало искажённое представление об успешности пилота — часть lift’а мы приписали нашей новой версии, хотя на деле был эффект синергии (или каннибализации) от других каналов.

Как исправляли постфактум:
🟠 Собрали полную историю всех коммуникаций (1 месяц от запуска пилота) по каждому клиенту;
🟠 Ввели новую стратификационную переменную «communication load» с типом и количеством касаний;
🟠 Перестратифицировали обе группы заново, создав чистые эквивалентные группы;
🟠 Заново пересчитали эффекты от пилота: реальный эффект нашей коммуникации упал до +4% в Т0 и +1% в Т1.

Положительный результат пилота сохранился, но значения значительно снизились.

😶 Что теперь делаем обязательно

Перед запуском любого теста коммуникаций проводим обязательный аудит параллельных кампаний. В дизайне всегда включаем глобальную контрольную группу без тестовой коммуникации + стараемся изолировать группы от внешнего шума. Если шум неизбежен, то тест должен быть крупнее и дольше, чтобы шум усреднился.

Хотите строить эффективные тесты и избегать ошибок? Записывайтесь на курс по A/B-тестированию, где под руководством опытного специалиста вы начнёте проводить эксперименты, которые покажут вам реальные выводы и приведут к выгодным решениям!


📈 Записаться на курс: simulative.ru/ab-test

📈 Симулейтив | ВК | YouTube
  • ❤ 3
  • 🔥 2
  • 👍 1
Post #3197 955
Глобальные контрольные группы

Привет! На связи Илья Ковалёв, старший аналитик данных в Dodo Brands и автор канала про аналитику кусочек пиццы 👋🏻

У аналитиков время от времени просят оценить эффект всех запущенных фич за год. Может показаться, что если сложить аплифты всех успешных A/B-тестов, то мы как раз и получим искомый результат.

На самом деле нет.

Проблема в том, что мы привыкли оценивать эффекты изолированно — для каждой отдельной фичи в рамках каждого конкретного эксперимента. Но мы забываем про совокупный эффект (Cumulative Effect) и взаимодействие изменений.

Возможно, новые пуши раздражают пользователей, пришедших к нам из-за новой фичи, и увеличивают отток. В изолированных тестах оба изменения зелёные 🟢. Вместе они могут гасить друг друга и не давать прокрасы или, что хуже, убивать LTV.

Чтобы понять, как все наши изменения в сумме влияют на пользователя на длинной дистанции, обычного A/B-теста недостаточно. Нам нужна глобальная контрольная группа (ГКГ/ГЦГ).

ГКГ (global holdout group) — это сегмент пользователей, который изолируется от всех (или большинства) изменений и маркетинговых коммуникаций на длительный срок.


Если в классическом тесте мы держим контроль 2 недели, то ГКГ живет 3, 6 или 12 месяцев. Это наша «тихая гавань» в шторме релизов.

Как это работает на практике?

Механика внедрения обычно делится на два типа, у каждого свои плюсы и минусы.

🏘 Тип 1. Статическая ГКГ (Static Holdout)

Вы просто отрезаете кусок аудитории (например, 5% по User ID) и «замораживаете» их навсегда.

➕ Плюс: идеально чистые данные для расчета LTV — вы точно знаете историю каждого пользователя.

➖ Минус: со временем эта группа «протухает». Пользователи, живущие в продукте год (а то и больше), отличаются от новичков. Группа перестаёт быть репрезентативной и оценка эффектов становится нечестной.

🎢 Тип 2. Ротируемая ГКГ (Rolling Holdout)

Пользователи попадают в контроль на фиксированное время (например, на 90 дней), а затем возвращаются в общую массу, заменяясь новыми.

➕ Плюс: выборка всегда свежая, нет смещения (bias).

➖ Минус: сложнее математика. Вы не можете оценить эффекты длиннее окна ротации.

Главное ограничение использования ГКГ: «Мы теряем деньги!»

Внедрение ГКГ — это всегда битва с заказчиками. Маркетинг кричит: «Если мы не отправим промокоды этим 5% людей, мы недополучим миллионы выручки!».

Здесь важно объяснить два момента:
🟠 Мы не теряем, мы инвестируем в знание.
🟠 Без ГКГ мы летим вслепую. Мы можем тратить бюджет на SMS, которые не приносят инкрементальной выручки. Стоимость ГКГ — это плата за то, чтобы не сжигать бюджет впустую на остальной базе.

Эффект может быть обратным. Бывают кейсы, когда глобальная контрольная группа показывает LTV выше, чем основная база. Это значит, что ваши коммуникации настолько назойливы, что вы не зарабатываете, а теряете деньги на маркетинге. Без ГКГ вы бы никогда об этом не узнали.

Резюмирую: если ваш продукт предполагает длительные отношения с клиентом (подписка, банкинг, e-commerce, телеком) — локальных тестов мало. Локальный тест отвечает на вопрос: «Как эта кнопка влияет на клики сегодня?» ГКГ отвечает на вопрос: «Становится ли наш бизнес здоровее от всего, что мы делаем?».


Ставьте реакции, если было полезно!

📈 Симулейтив | ВК | YouTube
  • 🔥 19
  • ❤ 4
Post #3196 966
Привет, на связи Аслан Байрамкулов, автор курса по A/B-тестированию 👋🏻

Я познакомился с A/B-тестами в теории в 2015-2016 году, а серьёзную практику получил в маркетинговой аналитике Яндекса: мы тестировали гипотезы по водителям, клиентам и тарифам. Именно этот опыт — первый взгляд на практическую сторону работы с гипотезами — дал понимание, что можно не просто тестировать, а выстроить data-driven систему на основе гипотез и тестов.

Это понимание я переиспользовал в X5, где систематизация работы с экспериментами дала огромные плоды: выросли и качество, и скорость работы. Мы создали методологию и внутренний инструмент, через который проходило большинство тестов компании.

В МТС идея инструмента превратилась в open-source библиотеку Ambrosia, которой в настоящее время пользуется большое количество людей из разных компаний.

Курс — логическое продолжение этого пути: передать не просто инструмент, а мышление, которое за ним стоит. Жду вас на курсе, где мы пройдём весь путь от гипотезы до внедрения экспериментов с понятными и эффективными метриками.


👉 Забронировать место: simulative.ru/ab-test

📈 Симулейтив | ВК | YouTube
  • ❤ 6
  • 👍 4
  • 🔥 2
Post #3195 1.07K
Вебинар: почему 80% новичков в IT выбирают именно аналитику данных

Аналитик данных — одна из самых востребованных IT-профессий. Но с чего реально начать, какие навыки действительно нужны, а что можно смело пропустить? И главное — как получить первую работу, если у вас нет опыта?

На вебинаре с Павлом Беляевым, тимлидом группы дата-аналитиков в Яндекс eLama, разберём, составим понятный план старта в профессии, а также потренируемся в решении тестовых заданий.

➡️ Зарегистрироваться

О чём расскажем на вебинаре:
➖ Почему аналитика — самый понятный вход в IT;
➖ Какие навыки реально нужны, и что не нужно учить;
➖ Сколько зарабатывают начинающие аналитики;
➖ Как выйти на первую работу без опыта;
➖ Реальный путь входа в профессию.

❗️ Встречаемся 24 марта в 19:00 МСК

💬 Если вы хотите сменить профессию, устали от текущей работы или просто ищете стабильный доход — приходите на вебинар!


➡️ Зарегистрироваться

📈 Симулейтив | ВК | YouTube
  • 🔥 4
  • ❤ 3
Post #3194 1.16K
Новый курс: Data Scientist с нуля до профи

Data Scienсe — это самая высокооплачиваемая сфера в IT: симбиоз навыков из аналитики и инженерии данных, машинного и глубокого обучения. Таких специалистов немного, и на рынке они очень ценятся. Теперь вы можете стать одним из них!

Мы объединили опыт практикующих экспертов, чтобы за 8 месяцев вы:

➖ Освоили полный стек инструментов аналитики и инженерии данных: от SQL, Python и Pandas до Docker, Airflow и ETL-пайплайнов;
➖ Погрузились в мир ML и DL: от регрессии, кластеризации и рекомендательных систем до архитектур нейронных сетей, обработки текста (NLP) и компьютерного зрения (в продвинутом тарифе);
➖ Решили реальные бизнес-кейсы: только практика от действующих аналитиков, которая ляжет в ваше портфолио.

Кому подойдёт курс:

👨‍💻 Новичкам в профессии: с нуля получите востребованную специальность и полный набор навыков для уверенного старта с зарплатой 90 000 — 170 000 ₽ на начальных позициях.
👨‍💻 Аналитикам с опытом: углубитесь в машинное обучение и глубокое обучение нейросетей, сможете прокачаться на текущем месте или перейти на позицию Data Scientist (специалиста по данным), вырастете в доходе.
👨‍💻 Специалистам смежных сфер: научитесь работать с данными, чтобы принимать обоснованные решения, и сможете перейти на позицию Data Scientist (специалиста по данным).

После курса вы сможете не просто обрабатывать данные, а прогнозировать будущее и находить скрытые возможности. Получите диплом государственного образца и уверенно ворвётесь на рынок труда с полным набором навыков!


👉 Записаться на поток со скидкой 30%: simulative.ru/data-scientist

📈 Симулейтив | ВК | YouTube
  • ❤ 3
  • 🔥 2
Post #3193 1.08K
Запустили Telegram-канал про Data Science и машинное обучение

В нём практикующие ML/DL-инженеры рассказывают доступным языком про прод, пайплайны, метрики, ошибки, фичи, архитектуры и реальные бизнес-кейсы.

В канале вы найдёте:
➡️ Разборы ключевых концепций и подходов в ML/DL на языке инженера;
➡️ Кейсы из продакшена: что сработало, что сломалось, какие выводы сделали;
➡️ Факапы, которые помогут не наступать на те же грабли;
➡️ Карьерные маршруты: какие скиллы нужны ML/DL-инженеру и как их системно прокачивать.

Кому будет полезно:
➖ Действующим ML/DL-инженерам и дата-сайентистам, которые хотят глубже в архитектуры, прод и инженерные практики;
➖ Начинающим ML‑инженерам и DS, которые ищут понятные ориентиры, реальные кейсы и честный взгляд на профессию;
➖ Аналитикам и дата-инженерам, планирующим переход в ML/DL и не желающим тонуть в разрозненных материалах.

Если вы хотите расти как инженер и собирать работающие ML/DL‑системы — присоединяйтесь!

✅ Подписаться

📈 Симулейтив | ВК | YouTube
  • ❤ 2
  • 🔥 1
Post #3192 1.11K
Пройдите опрос и получите подарок!

Мы хотим лучше узнать нашу аудиторию, чтобы делать наш продукт и контент ещё полезнее. Заполните небольшой опрос (займёт не более 5 минут) и получите полезный материал в подарок.

✍🏻 Пройти опрос

📈 Симулейтив | ВК | YouTube
  • 🔥 2
  • ❤ 1
Post #3191 1.05K
Симулейтив Вебинар: как аналитику данных эффективно использовать ИИ Часто бывает так: бизнес даёт размытый запрос («растим заказы, но падают оценки, разберитесь»), а вы не знаете, с какой стороны подойти к задаче. На вебинаре с Мариной Ермак мы пройдём полный путь…
Присоединяйтесь сегодня к вебинару по использованию ИИ

В 19:00 МСК вместе с Мариной Ермак разбираем бизнес-кейс и решаем задачу с помощью нейросетей — от туманной формулировки и построения гипотез до их проверки и визуализации метрик. Все материалы вы сможете повторить в прямом эфире, ждём вас!

➡️ Зарегистрироваться

📈 Симулейтив | ВК | YouTube
  • ❤ 3
  • 🔥 2
  • 🎉 1
Post #3190 1.06K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 4
  • 👍 3
  • 🔥 1
Post #3189 1.2K
Кейс: как перевести конкурентный анализ на автопилот и спасти культуру созвонов

Привет! На связи Марина Ермак, автор курса «ИИ для анализа данных» 🚀

Я часто встречалась с подходом, когда анализ конкурентов считали либо «творческой», либо разовой задачей. Но на самом деле это трудозатратная операционка, на которую часто тратятся часы сотрудников, или её делают «на коленке» перед самым созвоном.

В консалтинговой компании я внедрила систему регулярного мониторинга через периодические задачи в ChatGPT и сэкономила часы нашей команде 😎

Архитектура решения

Вместо того чтобы вручную проверять сайты и соцсети, мы выстроили трёхэтапный цикл:

1️⃣ Сбор и агрегация: настройка периодических запросов. ChatGPT получает структурированные данные о критериях изучения трендов или конкурентов. Здесь самое важное — точно прописать в промпте фокус исследования, иначе получится каша из данных.

2️⃣ Работа GPT и само сравнение. Хороший промпт сфокусирован на сравнительном анализе. В ряде случаев можно даже отдать ИИ на откуп совокупную оценку тренда или изменения у конкурентов. Здесь мы получаем самые ценные данные.

3️⃣ Рутина. Раз в неделю (или чаще, если захотите) команда получает лаконичный дайджест — это структурированный отчёт. Обычно я делала сначала краткое содержание с ключевыми трендами, а потом уже таблицы с подробным анализом по критериям. Не забывайте про ссылки и про их проверку — всё-таки нейросети любят галлюцинировать!

Главный результат: смерть «информационных» созвонов

Раньше у нас первые 20-30 минут каждой встречи уходили на синхронизацию. Сейчас каждый участник заходит в Zoom, уже прочитав двух-минутный дайджест от ИИ. У всех в голове один и тот же контекст. Мы больше не обсуждаем вопрос «Что произошло?» — мы сразу начинаем с «Что мы будем с этим делать?». Время встреч сократилось минимум на треть, а их глубина выросла в разы.

Получается, что автоматизация через ChatGPT — это не просто способ «не читать новости», это инструмент управления фокусом команды. Когда рутину по сбору и первичной аналитике забирает нейросеть, у людей высвобождается когнитивный ресурс для того, что ИИ пока делает хуже — для принятия сложных стратегических решений 💪🏻


🧑‍💻 Записаться на курс «ИИ для анализа данных»

📈 Симулейтив | ВК | YouTube
  • ❤ 3
  • 🔥 3
  • 👍 1
Post #3188 1.01K
Почему вы до сих пор не в аналитике данных (или боитесь начинать)?

Хотим провести для вас полезный эфир и понять, что реально мешает людям войти в профессию. Расскажите, что для вас является самой большой болью (оставьте реакцию под постом):

👍 — страх математики/статистики
🔥 — непонятно, где брать опыт после курсов
❤️ — дорогое и долгое обучение
😥 — сомнения, что профессия перегрета и джунов больше не берут
🧑‍💻 — технический барьер (например, SQL/Python даются тяжело, руки не доходят)

Или пишите в комментариях, какой у вас самый главный страх или возражение? Что вас останавливает прямо сегодня? 👇


📈 Симулейтив | ВК | YouTube
  • 😢 19
  • 🔥 13
  • 👍 7
  • 👨‍💻 6
  • ❤ 4
Post #3187 1.06K
Как автоматизировать дашборд при помощи ИИ

Привет! На связи Марина Ермак, автор курса «ИИ для анализа данных» 👋🏻

Есть популярное заблуждение: сейчас подключим ИИ, и он сам соберёт нам красивый, умный и полезный дашборд. К сожалению, это далеко не так — но с рутиной ИИ действительно помогает.

Если смотреть на самые популярные варианты автоматизации, то обычно это:

📈 Power BI + Copilot — помогает собирать черновики отчётов, подсказывает визуализации, объясняет формулы и отвечает на вопросы по данным;
📈 Tableau + AI/Pulse — хорош для исследования данных, поиска аномалий и коротких summary по метрикам;
📈 Looker + Gemini — удобен там, где уже есть нормальная модель метрик и хочется общаться с данными текстом.

Как этим пользоваться на практике?

На самом деле самое важное здесь — порядок и понимание конечной цели. Сначала привести в чувство метрики, названия полей и логику расчётов, потом — отдавать ИИ черновую сборку дашборда, подбор визуалов, поиск отклонений и ответы на типовые вопросы. То есть не «сделай всё сам», а «ускорь мне первый проход».

Что не стоит отдавать на автоматизацию:
➖ Финальную логику KPI;
➖ Доступ к чувствительным данным без ограничений;
➖ Проверку качества источников;
➖ Итоговые выводы для бизнеса без ревью человеком.

Потому что ИИ неплохо отвечает на вопрос «что происходит», но на вопрос «почему это произошло» часто начинает очень уверенно фантазировать 😀

Хороший сценарий использования выглядит так: человек проектирует смысл, ИИ ускоряет сборку и анализ, человек проверяет результат.


То есть ИИ в дашбордах — это не замена аналитика. Это очень быстрый помощник, которому нельзя без проверки доверять финальные выводы.

💡 Я рекомендую начать с простого: взять один конкретный сценарий и пройтись по нему с ИИ. Например, взять еженедельный дашборд по продажам, сделать для него AI-саммари отклонений и поштормить с ним возможные проблемы, чтобы предусмотреть тонкие места на будущее.

Но автоматизация дашбордов — лишь малая часть применения ИИ в работе над анализом данных. На курсе я расскажу фундаментальные подходы к автоматизации рутин, разберёмся с тем, как и какие ИИ-инструменты и где использовать, и как можно быстро и наглядно визуализировать данные.


♾ Присоединяйтесь к курсу, стартуем уже 20 марта: simulative.ru/ai-for-da

📈 Симулейтив | ВК | YouTube
  • ❤ 2
  • 🔥 2
Post #3185 1.18K
Вебинар: как аналитику данных эффективно использовать ИИ

Часто бывает так: бизнес даёт размытый запрос («растим заказы, но падают оценки, разберитесь»), а вы не знаете, с какой стороны подойти к задаче.

На вебинаре с Мариной Ермак мы пройдём полный путь решения реальной проблемы. В прямом эфире разберём кейс на открытом датасете: от туманной формулировки и построения гипотез до их проверки и визуализации метрик.

Вы увидите, как нейросети помогают аналитику не утонуть в рутине, а сфокусироваться на выводах. Все материалы будут у вас на руках — ссылки и QR-коды для повторения скинем во время вебинара!


➡️ Зарегистрироваться на вебинар

На вебинаре разберём по шагам:

➖ Как ИИ помогает превратить размытый запрос бизнеса в чёткий план действий;
➖ Как быстро находить первые сигналы проблемы, анализируя с ИИ готовые отчёты и дашборды;
➖ Как выстроить весь процесс анализа с использованием ИИ.

❗️ Присоединяйтесь 18 марта в 19:00 МСК.
🎁 Бонус за регистрацию — подборка из 15 промптов для работы аналитика!

➡️ Зарегистрироваться на вебинар

📈 Симулейтив | ВК | YouTube
  • ❤ 4
  • 🔥 3
Post #3184 1.16K
⬆️ Ментор курса «Аналитик данных» Александр Грудинин поделился, на что он смотрит перед тем, как пригласить человека на собеседование.

Кстати, поток с его менторской поддержкой уже стартовал! Присоединяйтесь: simulative.ru/data-analyst
  • ❤ 3
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →