TGViewer
Channel Public Channel
Симулейтив

Симулейтив

@simulative_official

Мы — образовательная платформа в сфере аналитики Симулейтив: simulative.ru

Создаём курсы-симуляторы, где обучаем на кейсах из реального бизнеса.

Канал по ML: @modprod
Наш уютный чат: @itresume_chat
Поддержка: @simulative_support
Subscribers
7.46K
Photos
2K
Videos
86
Links
1.6K

Showing posts older than #3183 · Back to latest

Older Posts 11 shown
Post #3182 1.27K
Вакансии в аналитике: что важно работодателям?

Всем привет! На связи Александр Грудинин, ментор курса «Аналитик данных» 👋🏻

Сегодня посмотрим на свежие вакансии для аналитиков данных. Акцент сделаем на обязанностях и требованиях к кандидатам, а также формату работы.

Вот список вакансий:

https://hh.ru/vacancy/130941500 (в архиве)
https://hh.ru/vacancy/130886039
https://hh.ru/vacancy/130890343
https://hh.ru/vacancy/130955912
https://hh.ru/vacancy/130952083 (уже закрыта)
https://hh.ru/vacancy/130871256
https://hh.ru/vacancy/130761447
https://hh.ru/vacancy/130320128 (в архиве)


Начнём с обязанностей. Почти везде есть базовый набор: подготовка дашбордов и отчётности, ad-hoc аналитика, взаимодействие с бизнесом. Интереснее смотреть на отличия.

🟠 Аналитика данных и отчётность присутствуют во всех 8 вакансиях без исключения — и это неудивительно. Данные сами по себе не имеют ценности, пока кто-то не превратит их в понятную картину для принятия решений. Именно этим и занимается аналитик: проводит исследования, строит дашборды, поддерживает отчёты, готовит презентации для бизнеса/руководства.

🟠 Ad-hoc аналитика явно упоминается у Сбера, Т-Банка и X5, в остальных подразумевается. Ad-hoc бывает разный: когда-то могут попросить сделать выгрузку, иногда — разобраться, почему упала метрика, или сделать отчёт «ко вчера» 🙂 То есть всегда важно уточнять, какого рода ad-hoc практикуется в компании и каков его объём.

🟠 A/B-тесты и эксперименты — только X5 Digital и Яндекс. A/B-тесты — тема непростая, и не в каждой компании есть культура и инфраструктура для них. С другой стороны, и не все аналитики готовы этим заниматься.

🟠 Работа с источниками данных, парсинг и автоматизация — Сбер и Флюид-Лайн: аналитик должен настраивать сбор и парсинг логов, кластеризировать сырые данные. Это уже инженерная задача, что показывает тренд на ещё большее размытие границ между дата-специалистами.

🟠 Взаимодействие с бизнесом фигурирует в том или ином виде в каждой вакансии. Это говорит о том, что аналитик данных — не строго технический специалист: необходимо уметь общаться с людьми и понятно презентовать результаты своей работы.

Теперь пройдемся по хард-скиллам.

➖ SQL — 8 из 8. В разных компаниях просят разный уровень. В любом случае SQL остаётся одним из основных навыков, которым стоит овладеть на достаточно уверенном уровне, если вы хотите начать ходить на собеседования.

➖ Python — 7 из 8 (нет только у Альфа-Банка). Везде как минимум классика — pandas/numpy. Также почти must-have для аналитика данных. Без знания этого языка можно работать, но это накладывает ряд ограничений, а многие компании не будут рассматривать вашу кандидатуру без него.

➖ BI-инструменты — 7 из 8. Чаще всего Power BI. FineBI у Совкомбанка — обязательное условие, и видимо, это достаточно специфичная вакансия, раз опыт владения инструментом прописан явно. Здесь я как и всегда скажу: стоит овладеть на достаточном уровне каким-либо одним BI-инструментом и делать упор на базовые принципы визуализации, так как компании, как правило, не требуют строго конкретного инструмента.

➖ Excel — 4 из 8, преимущественно банки. Мой опыт говорит, что даже если его не указывают в описании, минимально уметь пользоваться Excel или Google Sheets всё равно стоит. А если освоите ВПР / VLOOKUP — это, несомненно, добавит респекта в глазах коллег 🙂

➖ Опыт — Яндекс и Сбер (стажировка) берут без опыта, большинство — от 1–2 лет, X5 — от 3 лет. Что-то мне подсказывает, что на вакансию с требованием от 1–2 лет можно попробовать откликнуться и с учебным опытом 😉

Из необычного — в Сбере уже начали явно прописывать опыт работы с нейросетями. Думаю, скоро такое будет в каждой второй вакансии.


Большинство вакансий — офис или гибрид. Полная удалёнка встречается только в одном случае из восьми. Гибрид у двух компаний прописан явно, у одной — «по договорённости с руководителем», что по факту не гарантия.

Вот такой срез рынка на начало марта. Если вы сейчас в поиске или только планируете войти в профессию — надеюсь, это помогло сориентироваться!

📈 Симулейтив
  • ❤ 12
  • 👍 4
  • 🔥 3
Post #3176 1.27K
20 откликов и 2 оффера: история студента Симулейтив

Многие боятся начинать путь в IT с нуля, особенно если текущее образование далеко от аналитики и будет сложно найти первую работу.

Знакомьтесь, Александр Стерлин. Он пришёл к нам, чтобы применить свои знания на реальных задачах, а в итоге получил не просто опыт, а работу мечты!

В своей истории Александр рассказал:
➖ Почему важно выходить за рамки учебных заданий и как расширить свой проект до реального кейса;
➖ Как не бояться доставать ментора вопросами;
➖ И почему 20 откликов иногда достаточно для поиска работы мечты.

Осторожно: после просмотра карточек может возникнуть желание бросить всё и писать код (желательно на наших курсах 😉)


📈 Симулейтив
  • ❤ 7
  • 🔥 6
Post #3175 1.24K
Симулейтив SQL и карьера в аналитике: что происходит на рынке на самом деле? SQL был и остаётся главным инструментом аналитика данных. Но достаточно ли просто уметь писать запросы, чтобы построить успешную карьеру? И какие требования к аналитикам сейчас предъявляют…
Решаем задачи по SQL на вебинаре

Подключайтесь в 19:00 МСК — вместе с Евгением Буториным обсудим, насколько SQL важен для аналитика данных, порешаем задачи по SQL и рассмотрим рынок аналитиков внимательнее. Приходите, чтобы задать вопросы!

➡️ Регистрация

📈 Симулейтив
  • 🔥 5
  • ❤ 2
Post #3173 1.25K
Pandas vs SQLite: когда стоит «нырнуть» в SQL прямо из Python

Привет! На связи Александр Грудинин, ментор курса «Аналитик данных» 👋🏻

Pandas — это отличный инструмент, но иногда попадаешь в ситуацию, где что-то идёт не так:

🟠 groupby + transform превращается в многоэтажную конструкцию;
🟠 Коллега присылает готовый SQL-запрос, и его нужно «просто запустить»;
🟠 Данных много, и держать всё в памяти не хочется.

В такие моменты удобно знать, что SQLite можно поднять прямо внутри Python без сервера, без установки и даже без файла на диске. Просто :memory: — и всё живёт в оперативке как обычный датафрейм, только запросы пишешь на SQL.

Давайте покажу на примере.

Данные

import pandas as pd
import numpy as np
import sqlite3

dates = pd.date_range('2026-01-01', periods=30, freq='D')
stores = ['Москва', 'СПб', 'Казань']

df = pd.DataFrame([
{'date': d, 'store': s,
'revenue': np.random.randint(50_000, 300_000),
'orders': np.random.randint(10, 150)}
for d in dates for s in stores
])


Задача: по каждому магазину посчитать накопленную выручку, скользящее среднее за 7 дней и ранг дня по выручке.

🐼 Вариант 1: pandas

df = df.sort_values(['store', 'date'])

df['running_total'] = df.groupby('store')['revenue'].cumsum()

df['rolling_avg_7d'] = (
df.groupby('store')['revenue']
.transform(lambda x: x.rolling(7, min_periods=1).mean())
)

df['day_rank'] = (
df.groupby('store')['revenue']
.rank(method='dense', ascending=False)
)


🗄 Вариант 2: SQLite

conn = sqlite3.connect(':memory:')  # всё в оперативке, налету, никаких файлов!
df.to_sql('sales', conn, index=False)

result = pd.read_sql("""
SELECT
*,
SUM(revenue) OVER (PARTITION BY store ORDER BY date) AS running_total,
ROUND(AVG(revenue) OVER (PARTITION BY store ORDER BY date ROWS BETWEEN 6 PRECEDING AND CURRENT ROW), 0) AS rolling_avg_7d, DENSE_RANK() OVER (PARTITION BY store ORDER BY revenue DESC) AS day_rank
FROM sales
ORDER BY store, date

""", conn)

conn.close()


Подведём итог. Когда можно использовать SQLite:

➡️ Есть готовый SQL-запрос, который жалко переписывать на pandas;
➡️ Оконная логика сложная, и OVER читается понятнее, чем groupby + transform;
➡️ Нужно произвести сложные JOIN’ы.

В целом SQLite — это не конкурент pandas, а ещё один способ решить задачу работы с данными. И порой самое элегантное решение — кинуть датафрейм в :memory:, написать читаемый запрос и вернуть результат обратно в Python.

Было полезно? Ставьте 🔥 и ждите от меня ещё больше полезных материалов!

📈 Симулейтив
  • 🔥 20
  • ❤ 5
  • 👍 2
Post #3172 1.02K
Симулейтив Вебинар: как инженеру данных проектировать хорошие ETL/ELT-процессы ETL/ELT-процессы (они же пайплайны) — основа любой дата-инженерной системы. Именно пайплайны собирают и превращают сырые данные в структурированную информацию, на которую опираются аналитики…
Обсуждаем ETL/ELT-процессы через 2 часа

Георгий Семёнов ждёт вас в эфире! Подключайтесь в 19:00 МСК, чтоб узнать, как построить надёжный и эффективный процесс обработки данных и узнать, из чего складываются надёжные дата-процессы в крупных компаниях.

➡️ Регистрация

📈 Симулейтив
  • 🔥 5
  • ❤ 2
Post #3165 1.22K
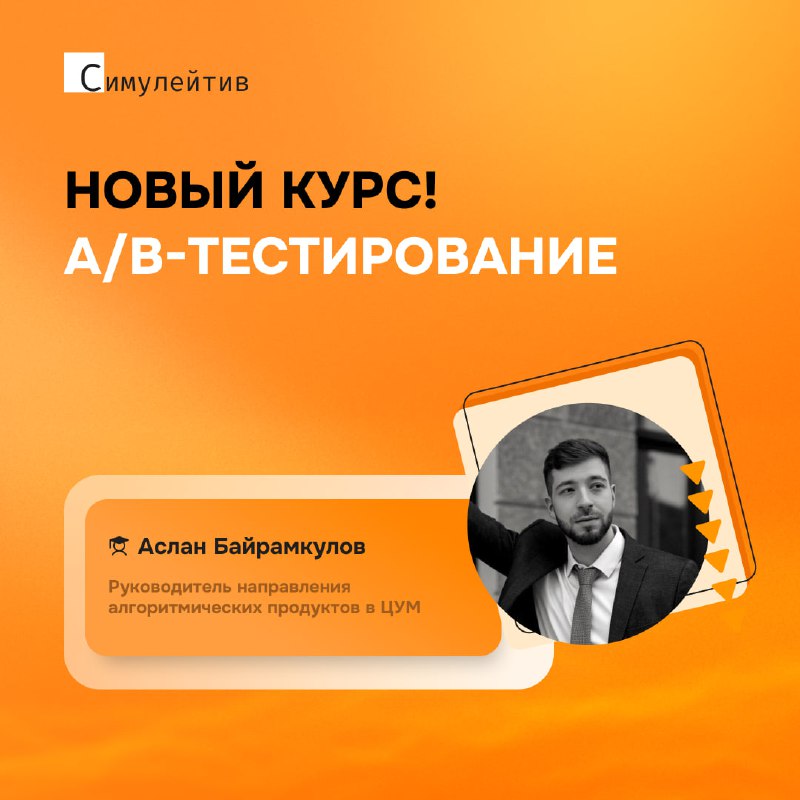
Учитесь строить A/B-тесты с нами 🔥

С 24 апреля стартует авторский курс по A/B-тестам от Аслана Байрамкулова — эксперта, который строил A/B-тесты в компаниях с аудиторией в десятки миллионов пользователей. Он руководил направлением в ЦУМ, создавал культуру экспериментов с нуля в X5 Retail Group, возглавлял платформу A/B-тестирования в Wildberries и работал с экспериментами в Яндекс.Такси.

За 3-4 месяца (в зависимости от тарифа) вы:

➖ Освоите полный цикл A/B-теста — от формулирования гипотез до внедрения результатов по итогам экспериментов;
➖ Научитесь корректно планировать тест: определять целевую аудиторию, длительность и размер выборки, чтобы получать надёжные результаты с первого раза;
➖ Поймёте, как выбирать ключевые метрики, работать с иерархией метрик и избегать искажений;
➖ Разберётесь в типах метрик и научитесь использовать вспомогательные и контрольные для глубины анализа;
➖ Освоите не только базовые, но и продвинутые методы статистики
➖ Построите культуру A/B-тестирования, чтобы автоматизировать процессы и проводить более 50 успешных тестов в месяц.

👨‍💻 Ждём на курсе аналитиков данных, продакт-менеджеров, маркетологов и руководителей команд аналитики.

После курса вы будете с уверенностью оперировать топовыми методиками, сможете принимать решения, которые реально растят продукт, и прокачаетесь в карьере благодаря набору востребованных навыков.

Перестаньте гадать, работает ли гипотеза, и начните проводить эксперименты, которые покажут вам реальные выводы и приведут к выгодным решениям!


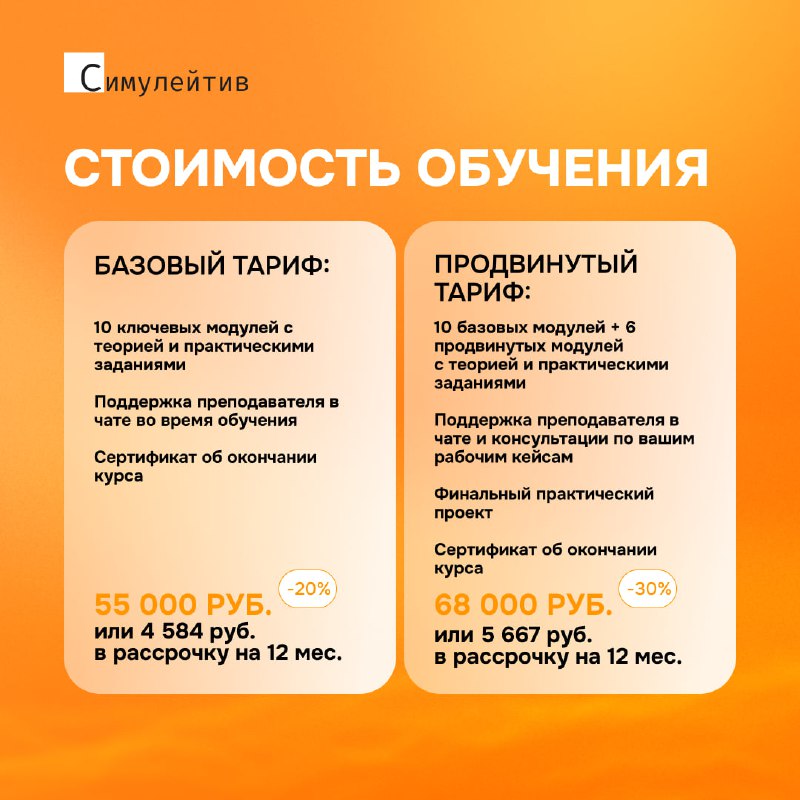
👉 Изучить программу и выбрать тариф (базовый или продвинутый с дополнительными модулями): simulative.ru/ab-test

📈 Симулейтив
  • ❤ 5
  • 🔥 4
  • 🤩 3
Post #3163 1K
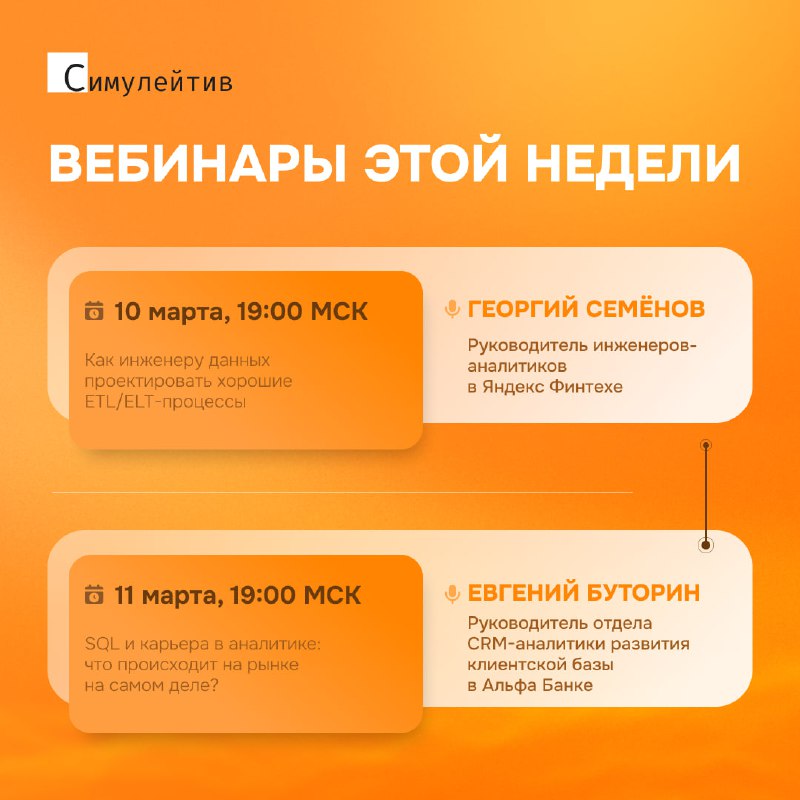
Вебинары этой недели 🍃

Поговорим про построение ETL/ELT-процессов и узнаем, как построить карьеру в аналитике 👨🏻‍💻

📌 10 марта, 19:00 МСК — Как инженеру данных проектировать хорошие ETL/ELT-процессы

На вебинаре c Георгием Семёновым разберём ключевые подходы к построению пайплайнов, поговорим о важных инженерных деталях и покажем, из чего складываются надёжные дата-процессы в крупных компаниях.

➡️ Зарегистрироваться на вебинар


📌 11 марта, 19:00 МСК — SQL и карьера в аналитике: что происходит на рынке на самом деле?

На вебинаре c Евгением Буториным разберёмся, как знание SQL помогает решать реальные бизнес-задачи и почему это база, на которую смотрят работодатели в первую очередь. Поговорим о текущей ситуации на рынке труда в аналитике: что изменилось, какие навыки нужны сейчас и где искать возможности для роста.

➡️ Зарегистрироваться на вебинар


Регистрируйтесь на вебинары и добавляйте к себе в календарь, чтобы не забыть!

📈 Симулейтив
  • 🔥 7
  • ❤ 3
Post #3161 1.12K
📈 Главный пост этого канала

Мы Симулейтив — образовательная платформа по обучению аналитиков и других специалистов в сфере данных. Наша фишка — обучение на кейсах из реального бизнеса и индивидуальный подход к студентам.

Несколько фактов о нас:
➡️ Учим не для экзаменов, а для реальных задач — наши студенты работают на уникальном симуляторе, отрабатывая практические кейсы из бизнеса.
➡️ Преподаватели-практики — эксперты в своей области, которые знают, что важно здесь и сейчас.
➡️ Карьера, а не просто сертификат — сопровождаем в процессе трудоустройства, помогаем лучшим найти работу или прокачать текущую.
➡️ Сообщество, а не просто курсы — мы не просто учим аналитике, а создаём среду, где каждый может развиваться и обмениваться опытом.
➡️ Лучшая оценка платформы (8,8) — по версии исследования одного из крупнейших сообществ аналитиков в России Left Join.
➡️ Школе всего 3 года, но нам доверились уже более 2 000 студентов. При этом средняя оценка материалов нашими студентами — 9,7.

🧑‍💻 Симулейтив — это ещё и комьюнити
Мы верим, что аналитика — это не удел любителей, а мощный инструмент для любого бизнеса. Поэтому мы регулярно делимся статьями, бесплатными полезными материалами и проводим открытые вебинары и стримы.

❤️ Наши лучшие материалы и посты:
➖ Ошибка фильтрации в SQL
➖ Шпаргалка по Pandas
➖ Проект выпускницы Симулейтив
➖ Типовая ошибка джунов: LEFT JOIN + WHERE
➖ Как быстро познакомиться с датасетом, прежде чем писать код

📌 Также у нас есть отдельный Telegram-канал для инженеров машинного обучения и дата-сайентистов — про то, как устроены настоящие ML/DL‑системы и какие навыки ценятся на рынке.

Наши основные программы:
✅ Аналитик данных — освоите всё, что необходимо аналитику данных: аналитическое мышление, Python, SQL, математику и статистику, А/В-тесты и визуализацию.
✅ Визуализация данных — научитесь делать красивые и полезные дашборды в Power BI, Superset и Metabase.
✅ Инженер данных — научитесь разрабатывать архитектуру данных, освоив весь необходимый стек дата-инженера.
✅ Инженер машинного обучения — научитесь создавать модели машинного обучения, строить рекомендательные системы и обучать нейронные сети.
✅ Аналитик полного цикла — станете универсальным специалистом, который в одиночку может выстроить аналитику любому бизнесу.

⭐️ В каждой программе есть VIP-опция, где мы сопровождаем студента в процессе трудоустройства с персональным треком обучения.

❗️ Записывайтесь на консультацию — расскажем о платформе, подберём программу под ваш запрос и ответим на все возникшие вопросы!
  • ❤ 8
  • 🔥 6
  • 👎 2
Post #3160 1.08K
3 варианта ранжирования в Pandas: какой правильный?

Pandas — один из основных инструментов аналитика: с его помощью можно решить огромное количество аналитических задач + он сильно помогает в оптимизации рутинной работы. А ещё его большое преимущество — его вполне реально выучить всего за две недели.

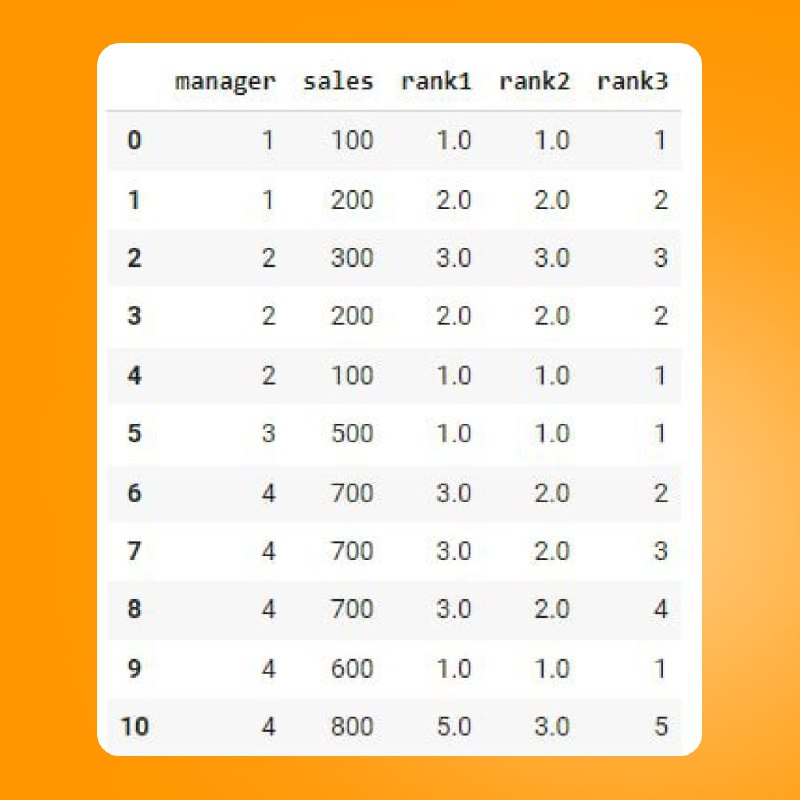
Однако в Pandas есть много тонких моментов, и мы хотим поделиться как раз одним из них. Ниже мы будем описывать свои действия, а на картинке прикрепили таблицу.

✅ Допустим, у вас есть датафрейм Pandas с информацией о менеджерах и их продажах. Ваша задача — отранжировать продажи в рамках каждого менеджера от минимальной до максимальной.

Код для создания датафрейма:

import pandas as pd

df = pd.DataFrame({
'manager': [1, 1, 2, 2, 2, 3, 4, 4, 4, 4, 4],
'sales': [100, 200, 300, 200, 100, 500, 700,
700, 700, 600, 800]
})


Сделаем это тремя способами и посмотрим на разницу:

➖ rank
➖ rank + dense
➖ cumcount

➡️ Способ 1: rank

df['rank1'] = (
df
.groupby('manager')['sales']
.rank()
)


Самый простой способ — сделать это с помощью метода rank. И кажется, что всё нормально, но посмотрите на продажи четвёртого менеджера. Всем записям со значением 700 почему-то присвоен ранг 3.

Это связано с тем, что по умолчанию rank ставит средний ранг в группе — в данном случае среднее значение между (2, 3, 4).

Что ещё интересно — после 3 сразу идет 5, то есть ни 2, ни 4 у нас в этом наборе нет.

➡️ Способ 2: rank + dense

df['rank2'] = (
df
.groupby('manager')['sales']
.rank(method='dense')
)


Есть способ немного «улучшить» ранжирование, сделав ранг «плотным». Это значит, что не будет разрывов, как в предыдущем случае.

Давайте снова посмотрим на 4 менеджера — теперь у него все значения 700 имеют ранг 2, а после него логично идёт ранг 3. Это уже сильно лучше!

➡️ Способ 3: cumcount

df['rank3'] = (
df
.sort_values(['manager', 'sales'])
.groupby('manager')['sales']
.cumcount() + 1
)


А что, если мы вообще не хотим повторять ранги, даже если значения совпадают? Тогда можно воспользоваться методом cumcount, который просто ранжирует значения по порядку, даже если они совпадают.

По сути, мы получаем аналог функции ROW_NUMBER в SQL, что также полезно в некоторых ситуациях.

Теперь вы сможете подбирать нужный вариант в зависимости от задачи. А на бесплатном курсе по Pandas мы разбираем все эти функции с нуля — присоединяйтесь, чтобы освоить нужную для аналитика библиотеку!


🟠 Зарегистрироваться на курс: simulative.ru/pandas

📈 Симулейтив
  • 🔥 6
  • 👍 5
  • ❤ 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →