TGViewer
Channel Public Channel
я так понимаю, Роман Васильев

я так понимаю, Роман Васильев

@ravasiliev_ch

Мысли про жизнь, карьеру, развитие в аналитике данных и не только :)
@RAVasiliev
Subscribers
3.29K
Photos
43
Videos
6
Links
56
Recent Posts 17 shown
Post #159 892
И немного фоточек/видео по мотивам школы!
  • 🔥 32
  • ❤ 16
  • 🥰 12
  • ❤‍🔥 6
Post #158 883
🏫 Как я был директором ШАРа 2026

Яндекс каждый год проводит летние школы по разным профессиям для ребят уровня стажёров / джунов. В этом году я был директором одной из них — ШАР, Школы аналитиков-разработчиков. Наша школа традиционно была одной из самых популярных по заявкам. Учились офлайн в московских офисах Яндекса, привозили и иногородних ребят. Кроме учёбы, много знакомились и тусили. Офлайн, имхо, сильно выигрывает перед онлайном - и в учёбе, и в общении 🙂

Я уже много лет преподаю и собираю курсы, но руководство целой школой - отдельный масштаб ответственности. Нужно разработать отборочные задания и процесс отбора, собрать программу и преподавателей, организовать работу над проектами. Ещё сделали систему сбора обратной связи по всем занятиям. Работы дофига, но опыт колоссальный. Благо рядом были Маша Губанова и Даня Нестеренко, менеджеры Young&&Yandex, которые помогали организовывать кучу всего. Они солнышки ❤️

Формат был такой: в июле 13 занятий, в основном по вечерам, плюс домашки, а август отвели на проекты. Все лекции читали эксперты из Яндекса. Разбирали метрики, A/B-тесты, специфичные приколы вокруг метрик (что делать, когда в эксперименте они едут в разные стороны), DWH и BI. Много говорили про задачи аналитиков в разных командах Яндекса, хотелось дать побольше прикладного. Особенно запомнилась лекция Саши Андреева (тоже старался ходить слушать!) про то, как работает Рекламная сеть Яндекса: сколько там разных технологий, что делают аналитики и в чём специфика их работы. Сам наконец достаточно широко осознал, как работает эта огромная машина 🙂

Проекты (над ними работали в августе) у аналитиков в этом году были свои отдельные. Из сырых датасетов (а кто-то начинал вообще с API) нужно было собрать систему витрин и дашбордов, сделать выводы о продукте, предложить гипотезы улучшений и разработать схемы A/B-тестов для их проверки. Например, одна из команд работала с большим датасетом Яндекс Музыки - Yambda. Кураторы помогали ребятам разбираться с данными и доводить проекты до результата.
Ребята жёстко заряженные, очень горжусь нашими выпускниками. И очень благодарен преподавателям и кураторам, которые вкладывали в школу свои силы и время. Отзывы о школе от студентов (у нас была целая система сбора регулярного!) очень хорошие

Ну и масштабы мероприятий Яндекса - отдельный восторг. На выходных мы оккупировали целые офисы под работу над проектами, реябта на добровольной основе приходили читать лекции, помогать с проектами и организацией. А на закрытии пела МакSим. Там я впервые в жизни увидел слэм под МакSим (который, конечно же, организовала команда ШАРа!!) и даже немного поучаствовал 🙂

Знаю, что многие из участников ШАРа 2026 читают этот канал. Ребята, вы крутые 🙂
Спасибо Маше, Дане, всем кураторам, преподам и, конечно, студентам лучшей школы ❤️
Школа аналитиков-разработчиков Летняя школа Яндекса для аналитиков-разработчиков. Больше половины выпускников получают офер
  • 🔥 38
  • ❤ 18
  • 🥰 13
  • ❤‍🔥 3
Post #153 2.33K
👀 Про аналитическую насмотренность
Больше года назад на одной из моих лекций в ШАРе молодой человек спросил, как развивать аналитическую насмотренность.
Я пообещал написать об этом пост в канале - и вот, спустя год с лишним, наконец пишу. Впрочем, за это время тот молодой человек уже и без меня успел её прокачать 🙂

1. Что это такое
Опыт чувствуется в любой области, и аналитика не исключение. Когда ты приходишь стажёром или джуном, почти каждая задача для тебя новая: непонятно, с чего начать, что проверить и где искать подвох.
Опытный аналитик тоже не видит готового решения сразу. Но он быстрее понимает, на что похож кейс, где могут возникнуть проблемы и в какие стороны копать бесполезно.
В фильмах опытный человек часто смотрит на задачу и сразу понимает, как решить её от и до. В жизни опыт скорее сужает пространство поиска: ты не знаешь точного ответа, но примерно понимаешь, куда идти.
При этом опыт бывает глобальным и локальным.
Глобальный опыт накапливается за всю карьеру: ты видел разные бизнесы, типы задач и подходы к их решению. Он помогает понять, на что похож новый кейс и какие способы решения вообще существуют.
Локальный опыт появляется внутри конкретной компании или продукта. Ты уже знаешь, каким данным можно доверять, как устроены процессы и какие подходы здесь работают. Глобальный опыт шире и универсальнее, локальный - уже, но точнее. Вместе они дополняют друг друга и помогают быстрее разобраться в новой задаче.
Вот это я и называю аналитической насмотренностью. Раньше я уже писал про близкую идею - умение замечать паттерны.

2. Сколько времени нужно
Есть популярная идея: чтобы стать экспертом в любой области, нужно потратить на неё 10 000 часов. Если работать по 40 часов в неделю около 50 недель в году, это примерно пять лет.
Но для насмотренности недостаточно 10 000 часов повторять одно и то же. Важнее разнообразие: разные проекты, продукты, домены и типы задач.
Чем больше разных кейсов ты видел, тем выше вероятность, что следующая задача окажется на что-то похожа.
Кстати, раньше, аж в 2023 году, я уже писал, почему правило 10 000 часов не работает само по себе.

3. Как ускорить развитие насмотренности
Если работаешь в большой компании - выходи за пределы своего домена. Ходи на встречи и хуралы других команд, вникай в их исследования, бери смежные проекты и общайся с коллегами о том, какие задачи и проблемы возникают у них.
Если большой компании рядом нет - например, ты студент или только учишься - собирай кейсы самостоятельно.
Из того, что я бы советовал: GoPractice - про продуктовую аналитику, метрики и юнит-экономику, Yandex for Analytics и блог AvitoTech - про реальные задачи внутри компанийб архив Data Fest и ODS - чтобы смотреть на разные области DS и ML.
Из конференций - Data Driven, Матемаркетинг и ProductSense. Необязательно ходить на всё очно: можно смотреть старые доклады и специально выбирать темы вне своего домена.
Чтобы просмотр не превращался в фоновый шум, после каждого кейса попробуй выписать: какую задачу решали, какие данные использовали, почему выбрали конкретный подход и что получилось в итоге.
Ещё одно клёвое упражнение Саша предложил в нашем выпуске подкаста «Доверительный интервал»: брать разные бизнесы и разгонять вместе с ChatGPT, как в них может быть устроена аналитика.
Например, можно взять кофейню, такси или онлайн-кинотеатр и вместе с ChatGPT поразгонять, как устроен этот бизнес: на чём он зарабатывает, какие у него основные расходы, за какими метриками нужно следить и какие направления аналитики там могут быть.
Но самый быстрый способ всё тот же - найти стажировку и попасть в среду, где реальные аналитические задачи обсуждаются и решаются каждый день.

4. Что в итоге
С насмотренностью ты реже начинаешь задачу с чистого листа. Где-то уже видел похожий кейс, помнишь, что там сработало, а где всё сломалось, и можешь хотя бы не наступать на те же грабли.
Поэтому насмотренность растёт не столько от количества лет в профессии, сколько от количества областей и направлений, в которых ты успел разобраться и сделать что-то хорошее 🙂
Telegram я так понимаю, Роман Васильев Правило 10 тысяч часов не работает ⠉⡂⠲⣂ ⢁⡃ ⣄⢄⡡⢔ Я тут недавно понял, что скоро у меня будет юбилей - 5 лет в анализе данных. За это время я чем только не занимался: и модели машинного обучения катил в прод, и оптимизацию всего чего угодно в оффлайн-ритейле…
  • ❤ 34
  • ❤‍🔥 11
  • 👍 6
  • 🔥 4
  • 🥰 1
Post #152 6.59K
🏆 Преподавание ML студентам очно в Москве

Знаю, что этот канал читают многие мои выпускники с различных курсов по ML / анализу данных. Это предложение в первую очередь для вас. Ну и для всех интересующихся тоже!

Я последние несколько лет руковожу курсами и веду лекции в ЦУ (Центральном университете).

В осеннем семестре значимо увеличивается количество студентов на курсах по ML в бакалавриате и магистратуре ЦУ, поэтому ищем талантливых семинаристов!

Важное:
• Пары проходят очно на Маяковской / Тверской в Москве
• В бакалавриате пары проходят с 10:00 до 19:00 в будни, в магистратуре - с 18:00 в будни и по субботам
• Ждём, что у вас есть опыт преподавания
• Также ждём, что вы владеете классическим ML (в идеале - работаете с ним)
• Будем проводить собеседования, чтобы отобрать лучших из лучших

Если давно хотели проявить себя в преподавании - приходите в личку, это ваш шанс!
@RAVasiliev
  • 👍 24
  • 🔥 18
  • ❤‍🔥 11
  • 👎 5
Post #151 4.16K
📺 Аузан про образование в эпоху ИИ

Посмотрел классный монолог Александра Аузана, декана экономфака МГУ, про образование, человеческий потенциал и ИИ.
Одна из главных мыслей: последние несколько сотен лет образование во многом было заточено на то, что ИИ теперь делает всё лучше: запоминать, пересказывать, считать, искать стандартные решения.

Если раньше хорошее образование часто проверялось через цепочку выучил - воспроизвёл - получил оценку, то сейчас такой формат становится всё более странным. Нейросеть воспроизводит материал быстрее, ровнее и без нытья перед дедлайном.
Аузан предлагает смотреть в другую сторону: для эффективного использования искусственного интеллекта рядом нужен сильный естественный интеллект.

Важнее становятся навыки, где человек сейчас сильнее:
интуиция: принимать решения при недостатке информации;
эмпатия: понимать чувства / эмоции людей;
воображение: придумывать то, чего ещё нет;
системная память: связывать куски опыта в логичные структуры;
критическое мышление к ИИ

Последний пункт особенно зацепил.
У зумеров, как говорит Аузан, часто хорошо развито критическое мышление по отношению к старшим, но не к нейросетям. И это навык, которому явно нужно будет учить в ближайшие годы.
Мой вывод простой: образование в эпоху ИИ должно меньше учить конкурировать с нейросетями. И больше учить задавать хорошие вопросы, видеть странности в ответах, собирать контекст и придумывать следующий шаг.

В общем, всем интересуеющимся - очень советую 🙂
На ютубе тут
YouTube Александр Аузан — о человеческом потенциале России и будущем образования в эпоху ИИ Подписывайтесь на канал: https://www.youtube.com/channel/UCD23js7wHnyG_yhimDMpLpg?sub_confirmation=1 --------------------- ▪️Почему сильный человеческий потенциал не всегда превращается в экономический рост? Как нейросети меняют обучение? И какие навыки…
  • 👍 23
  • ❤ 15
  • ❤‍🔥 11
  • 🔥 2
Post #150 3.13K
Yandex for Analytics 🐚 Ответили на вопросы подписчиков Недавно мы собрали вопросы от аналитиков, чтобы ответить на самые интересные из них в подкасте «Доверительный интервал». Для нового выпуска мы выбрали 10 самых интересных, которые ведущие Саша, Ксюша и Дима обсудили вместе…
Сходил в гости в Доверительный интервал 🙂

Получилось 49 минут разговоров про аналитику с довольно жизненными вопросами: как работать с бизнесом, что делать с серыми A/B-тестами, насколько LLM правда может заменить аналитика, как менять специализацию и чем middle отличается от senior.

Ну и да, отдельный кайф - вопросы собирали в том числе здесь. Так что технически часть выпуска сделали вы 🙂
Посмотреть/послушать можно по ссылкам в посте выше.

Единственное, что я понял, когда пересматривал подкаст: как-то уж больно быстро проскочили вопрос «чем хороший аналитик отличается от плохого». Он на отдельный пост в этом канале тянет!

Тыкайте 👍, если интересно будет почитать)
  • 👍 42
  • ❤ 8
  • 🔥 8
Post #149 2.94K

Forwarded from Yandex for Analytics

🐚 Ответили на вопросы подписчиков

Недавно мы собрали вопросы от аналитиков, чтобы ответить на самые интересные из них в подкасте «Доверительный интервал». Для нового выпуска мы выбрали 10 самых интересных, которые ведущие Саша, Ксюша и Дима обсудили вместе с гостем выпуска. Да, теперь у нас будут гости, и первым из них стал Рома Васильев — руководитель аналитики международного Поиска.

📺 Смотрите в выпуске:

🔵 Что учить, если есть всего один час в день

🔵 Как без опыта в А/В вкатиться в команду, которая проводит A/B-тесты

🔵 Чем хороший аналитик отличается от плохого

⏭️ Ответы на эти и другие вопросы уже на ютубе, в VK Видео и Яндекс Музыке.

Подписывайтесь:
💬 @Yandex4Analytics
  • ❤ 9
  • 👍 7
  • ❤‍🔥 5
  • 🔥 2
  • 👎 1
  • 😱 1
Post #147 3.54K
Доверительный интервал: собираем вопросы

Меня позвали в подкаст про аналитику, который делают ребята из Яндекса.
В прошлых выпусках ребята говорили про срочные задачи, цели и культурный код аналитика.

А в следующем выпуске мы будем разбирать самые животрепещащие вопросы от слушаетелей! У вас есть возможность поучаствовать и оставить свои вопросы для подкаста.

Что можно спросить:
• куда расти в аналитике в 2026
• сложные рабочие ситуации, где всё пошло не по плану
• как жить между бизнесом, продуктом и здравым смыслом
• любые неловкие вопросы, которые обычно не задают вслух

Оставляйте свои вопросы тут
Самые интересные разберём в выпуске. Форма анонимная, так что можно спросить всё, о чём пожелаете 🙂
YouTube Дофаминовая яма аналитика: почему мы тонем в мелких задачах / Доверительный интервал Знакомая история: только навели порядок в бэклоге и распланировали спринт, как налетают «горящие» задачи с пометкой «Нужно вчера». И вот вы весь день тушите пожары, так и не добравшись до основной задачи. В этом выпуске наши ведущие — Дима, Ксюша и Саша…
  • ❤ 23
  • 🔥 14
  • 🥰 9
  • 👍 3
Post #145 4.94K
Въезжаем в ИИ в 2026. Часть 2. Как работают LLM'ки - разбираемся на пальцах (2/2)

Что можно почитать/посмотреть, чтобы понять тему лучше:
1. Краткое объяснение больших языковых моделей от 3blue1brown (есть дубляж на русском): ссылка
2. Подрбный плейлист по теме от 3blue1brown (есть дубляж на русском): ссылка
3. Статья Игоря Котенкова "Как работает ChatGPT: объясняем на простом русском эволюцию языковых моделей с T9 до чуда": ссылка

---

Как обычно, ставьте ❤️, если ждёте продолжение!
YouTube Large Language Models explained briefly A light intro to LLMs, chatbots, pretraining, and transformers. Dig deeper here: https://www.youtube.com/playlist?list=PLZHQObOWTQDNU6R1_67000Dx_ZCJB-3pi Technical details as a talk: https://youtu.be/KJtZARuO3JY This was made for an exhibit at the Computer…
  • ❤ 32
  • ❤‍🔥 9
  • 🥰 7
Post #144 3.83K
Въезжаем в ИИ в 2026. Часть 2. Как работают LLM'ки - разбираемся на пальцах (1/2)

Если сильно упростить, современные LLM - это модели, которые очень хорошо умеют предсказывать следующее слово по предыдущему тексту.

Самая близкая бытовая аналогия - старый-добрый T9 на телефонах. В нулевых он тоже пытался угадать, что вы хотите напечатать дальше. Принцип был ровно тот же: есть контекст - есть вероятность следующего слова. Просто модели тогда были маленькие, контекст короткий, словари ограниченные. Этого хватало, чтобы дописать SMS, но не чтобы вести осмысленный диалог.
С LLM произошло то же самое, но в экстремальном масштабе. Модель получает текст, считает вероятности следующего слова, выбирает одно из них, добавляет к тексту, и повторяет этот шаг снова и снова. Так, слово за словом, и рождается ответ. Даже длинный текст или код - это просто сотни таких итераций подряд.

Ключевая разница здесь - масштаб. Мощность таких моделей во многом определяется числом параметров - настраиваемых коэффициентов, которые модель подбирает во время обучения. У GPT-3 в 2020 году их было около 175 миллиардов; у более новых моделей точные цифры не раскрываются, но они явно крупнее. По порядку величины это сопоставимо с числом нейронов в человеческом мозге (80–90 млрд), пусть и не один в один.
Но важен не только сам размер: критично и то, насколько мы умеем эти параметры обучать (железо и масштаб вычислений), и какие архитектуры позволяют делать это эффективно. Именно в этом и был основной рывок последних лет.

Почему всё это вообще стало возможным?

Во-первых, данные.
Современные модели обучаются на колоссальных объёмах текстов: интернет, книги, код, документация, диалоги - по сути, почти всё, что человечество успело написать в цифровом виде. Если очень грубо, это объём текста, который человек физически не смог бы прочитать за несколько тысяч лет непрерывного чтения

Во-вторых, железо.
Идеи нейросетей были понятны ещё в 90-х, но обучать их было банально не на чем. Перелом случился, когда GPU начали массово использоваться не только для графики, но и для вычислений: сначала CUDA (примерно 2006–2007 годы), затем специализированные GPU под машинное обучение. Именно параллельные вычисления сделали возможным обучение моделей с сотнями миллиардов параметров.

И в-третьих, архитектура.
В 2017 году появились трансформеры. Они позволили моделям перестать читать текст строго последовательно и начать обрабатывать весь контекст сразу через attention. Это резко повысило эффективность обучения и позволило масштабировать модели дальше.

И в-четвёртых, человеческий фидбэк (Reinforcement Learning with Human Feedback)
Большие модели сначала учатся просто продолжать текст, не имея представления о том, что считать хорошим ответом, а что - плохим. Поэтому поверх базового обучения их напрямую дообучают на человеческих оценках.
Люди смотрят на ответы модели и размечают их с точки зрения полезности, после чего она начинает оптимизироваться не только под правдоподобие текста, но и под ожидания человека.

Дальше случился самый интересный эффект.
Когда модели стали достаточно большими, у них начали появляться способности, которые никто специально не закладывал: перевод, программирование, рассуждения.
В итоге сегодня есть целые лаборатории, которые пытаются разобраться, как именно эта система к этому пришла, и почему рост масштаба приводит к таким эффектам. Параллельно обсуждаются и риски - в первую очередь связанные с тем, что поведение больших моделей становится всё сложнее предсказывать.

Таким образом, LLM - это не интеллект в человеческом смысле. Это самый мощный автокомплит, который мы смогли построить. И, как оказалось, даже этого уже достаточно, чтобы заметно изменить то, как мы работаем, пишем и ищем информацию 🙂
YouTube Large Language Models explained briefly A light intro to LLMs, chatbots, pretraining, and transformers. Dig deeper here: https://www.youtube.com/playlist?list=PLZHQObOWTQDNU6R1_67000Dx_ZCJB-3pi Technical details as a talk: https://youtu.be/KJtZARuO3JY This was made for an exhibit at the Computer…
  • ❤ 19
  • ❤‍🔥 6
  • 🥰 6
  • 👍 3
Post #143 3.25K
Въезжаем в ИИ в 2026. Часть 1. Терминология (2/2)

Внутренние и вспомогательные термины

Промпт - Текстовая инструкция для модели. В сложных задачах формулировка запроса часто важнее выбора конкретной модели.

RAG (Retrieval-Augmented Generation) - Подход, при котором модель отвечает, опираясь на внешние данные. Запрос обогащается найденными документами, и ответ строится на их основе, а не только на параметрах модели.

Мультимодальность - Работа с текстом, изображениями, звуком и видео в рамках одной модели.

Copilot - Формат использования LLM как встроенного помощника внутри инструментов и приложений. Например, кодовый ассистент, который на лету ищет баги, исправляет их и пишет код.

Вайбкодинг - Написание кода с помощью LLM через текстовые инструкции. Позволяет получать рабочий код без знания языка программирования. Но иногда шалит при написании сложных проектов 🙂

Контекстное окно - Объём информации, который модель учитывает в одном запросе или диалоге. Показывает, на сколько токенов назад модель «помнит», о чём шла речь.

Галлюцинации - Ситуации, когда модель уверенно выдаёт неверную информацию, начинает путать факты, языки или контекст. Часто выглядит правдоподобно, из-за чего особенно опасно.

Ризонинг (Reasoning) - Способность модели рассуждать пошагово и выстраивать логические цепочки.

Дипфейк - Генерация изображений и видео с участием реальных людей с помощью нейросетей. Предмет споров и дискуссий в последние годы.

---

Естественно, мы покрыли далеко не всю терминологию вокруг темы, но этих понятий уже достаточно, чтобы 90% статей и обсуждений про ИИ стали заметно понятнее!

В следующем посте подробнее разберём базовые принципы, на которых всё это работает.

Ставьте ❤️, если ждёте продолжение!
  • ❤ 69
  • 🔥 13
  • ❤‍🔥 10
  • 👍 6
Post #142 3.01K
Въезжаем в ИИ в 2026. Часть 1. Терминология (1/2)

Наконец-то дошли руки завершить первый полноценный пост из серии!
В качестве вводной хочется зафиксировать базовую терминологию, которой будем пользоваться дальше. Без этого любые разговоры про ИИ очень быстро превращаются в спор людей, которые говорят о разном, но одинаковыми словами

Общие термины

AGI (Artificial General Intelligence) - гипотетический общий интеллект уровня человека, способный решать любые задачи лучше человека. Когда-то считалось, что если компьютер обыграет человека в шахматы, то это уже своего рода AGI 🙂

ИИ (искусственный интеллект) - Область компьютерных наук. Состоит из классического ML (предсказательные модели, статистика, оптимизация) и Deep Learning (нейросети). ИИ - надмножество, а не синоним нейросетей или LLM.

Machine Learning (ML) - Методы, которые учатся на данных и делают предсказания. Большая часть ML не имеет отношения к генерации и существовала задолго до нейросетевого бума.

Deep Learning (DL) - Подраздел ML, основанный на многослойных нейросетях.
Идеи нейросетей активно изучались ещё в 60–80-х (в том числе в СССР), но реальный прорыв случился после ~2012 года из-за роста вычислительных ресурсов, GPU и больших датасетов.

Трансформеры - Архитектура нейросетей, позволившая обрабатывать весь контекст целиком, а не последовательно. Представлена в 2017 году. Именно масштабируемость трансформеров напрямую привела к появлению LLM.

Механизм внимания (Attention) - Механизм внутри трансформеров, позволяющий модели самой определять, какие части данных важнее. Ключевой эффект - возможность обучения на сырых, неструктурированных данных. Представлен в 2017 в статье "Attention is all you need” как основа трансформеров.

Языковые модели

Токен - Базовая единица, с которой работает языковая модель. Фактически это кусок текста (часть слова, символ или несколько символов). Модель оперирует последовательностями токенов, именно на них часто появляются лимиты

LLM (Large Language Models) - Класс моделей внутри DL, оптимизированных под предсказание следующего токена. Генерация текста, кода и рассуждений происходит как последовательное предсказание токен за токеном

GPT (Generative Pre-trained Transformer) - Семейство LLM на архитектуре трансформеров. Обучается генерировать текст, предсказывая следующий токен на основе предыдущих. За счёт такого подхода одна и та же модель может писать текст, код и вести диалог

BERT (Bidirectional Encoder Representations from Transformers) - семейство языковых моделей на трансформерах, обученных понимать текст, а не генерировать его. Хорошо подходит для классических NLP-задач: поиска, классификации, извлечения сущностей. В проде его часто дообучают под конкретные задачи

Продукты и их сравнения

ChatGPT / DeepSeek / Gemini / Grok / Perplexity
Семейства языковых моделей. Внутри каждого — большое количество версий.
Все построены на трансформерах, но отличаются конкретной архитектурой, объёмом и составом обучающих данных, способом дообучения и продуктовой обёрткой.
Про то, где именно они реально отличаются и почему, поговорим отдельным постом

Alice AI / GigaChat
Российские LLM-продукты, оптимизированные под собственные экосистемы (Яндекс / Сбер) и локальный рынок, в первую очередь - под язык

Агенты - Надстройка над LLM, при которой модель не просто отвечает на запрос, а планирует действия, вызывает инструменты, проверяет результат и может работать в несколько шагов. Используются для автоматизации и сложных сценариев

n8n - Один из самых популярных инструментов оркестрации. Используется для сборки автоматизаций, пайплайнов и агентных цепочек вокруг LLM без написания большого количества кода

Бенчмарки - Наборы тестов для сравнения языковых моделей между собой. Измеряют отдельные навыки (код, рассуждения, знания). Фан-факт: один из популярных бенчмарков называется Last Human Exam.
  • ❤ 35
  • 🔥 14
  • 👍 9
  • 😱 3
  • ❤‍🔥 2
Post #141 3.72K
🤖 2025 - год LLM’ок в жизни и работе

Для меня самое большое открытие этого года - большие языковые модели (LLM). Процентов 80–90 запросов, которые раньше уходили в поиск, статьи и десятки вкладок, теперь сразу улетают в ChatGPT / Gemini. Просто потому что таким образом можно кратно быстрее решать задачи: переносить свой образ мышления «на бумагу» и получать результат с существенно меньшими затратами времени и усилий.

Этим постом хочу начать цикл про LLM (в том числе GPT) для жизни и работы. Цикл скорее для тех, кто уже сталкивался с этой темой, но не погружался в детали, не до конца понимает, как модели работают внутри, и хочет разобраться, как их можно использовать уже сейчас. Если давно хотелось расставить точки над i, сейчас - самое время.

Что точно войдёт в цикл статей:
1. История LLM, терминология и откуда вообще всё это выросло
2. Какая революция сейчас происходит и с чем её вообще корректно сравнивать
3. Как LLM работают изнутри, на простых аналогиях и примерах (без глубокой математики под капотом, на уровне понимания идей)
4. Как применять их в повседневной жизни и какие задачи туда можно уносить уже сейчас
5. Как применять LLM в работе и бизнесе
6. Куда всё это реально может прийти дальше

Начать хочу с цитаты из книги 2011 года, за 6 лет до статьи Attention Is All You Need, которая положила старт всему этому делу. Мне кажется, она на уровне ощущений очень точно передаёт, как работают LLM. Для контекста: суры в этом произведении - человекоподобные роботы, которые служат для хозяйства и прочих дел.

— Знаете, когда-то люди изобрели опыт под названием «Китайская Комната». Слышали?
— Нет, — сказал я.
— В запертой комнате сидит человек, не знающий китайского языка. В окошко ему дают записки с вопросами на китайском. Для него это просто бумажки с нарисованными закорючками, смысла которых он не понимает. Но у него в комнате полно разных книг с правилами, в которых подробно описано, как и в какой последовательности отвечать одними закорючками на другие. И он, действуя по этим правилам, выдает в другое окошко ответы на китайском, которые создают у всех стоящих снаружи полную уверенность в том, что он знает китайский язык. Хотя сам он совершенно не понимает, о чем ему задают вопросы и в чем смысл его ответов. Представили?
— Ну, представил.
— Сура — это такая же китайская комната, только автоматизированная. Вместо человека со справочниками в ней сканер, который считывает иероглифы, и огромная база референций и правил, позволяющих подбирать иероглифы для ответа.
— Много же там будет правил, — пробормотал я.
— Немало, — согласился консультант. — Она переводит каждую вашу фразу на несколько символических языков, разделяя ее на множество слоев и уровней. Затем каждый слой соотносится со своей базой опыта. После этого происходит обратный синтез инвариантов, и мы получаем комплексную реакцию, имеющую смысловой, стилистический и эмоциональный аспекты, которые взаимно дополняют друг друга, создавая ощущение уникального, живого и адресованного лично вам ответа. Это, конечно, симуляция. Но точно так же дети имитируют своих родителей и сверстников — часто до самой старости. Общаясь с сурой, вы имеете дело с прошлым человечества.

S.N.U.F.F., Виктор Пелевин


Почему эта цитата так точно попадает в то, что мы сегодня называем LLM:
- модель не понимает смысл в человеческом смысле слова, но отлично имитирует понимание
- внутри — не знания, а огромная статистика прошлого опыта человечества (точнее, текстов, на которых она училась)
- ощущение «живого диалога» — побочный эффект хорошо собранной симуляции. И, если честно, люди в этом месте не так уж сильно отличаются

Дальше в цикле разберём базу: от истории и устройства LLM до практических сценариев использования в жизни, работе и бизнесе, и того, куда всё это может прийти дальше.

Если LLM уже стали для вас полноценным инструментом для работы или жизни - ставьте 🔥
А если интересно продолжение и хочется разобраться глубже - ставьте ❤️
  • ❤ 73
  • 🔥 50
  • ❤‍🔥 9
Post #140 4.42K

Forwarded from Вокруг Центрального университета

Как совмещать работу в Яндексе и преподавание? 

Узнали у Романа Васильева, руководителя аналитики международного Поиска в Яндексе и руководителя и лектора курсов по ML в Центральном университете. 

Жестко 🙂 
А если серьезно — жесткий тайм-менеджмент, расстановка приоритетов. И увлеченность тем, что делаю. 

 
Роман начал преподавать еще в 2019 году. Для него работа со студентами — возможность вкладывать частичку себя в других людей. 

Поначалу может быть страшно и непросто, но в итоге это невероятно круто и вдохновляюще. 


А мы всегда поможем начать: подберем удобный график, от 5 часов в неделю, чтобы совмещать лекции или семинары с основной работой, подготовим методички, презентации, комфортные аудитории и поддержим смелые идеи. 

Знакомьтесь с нашими героями в цикле видео и приходите преподавать: https://cntrluniv.ru/cu_heroes
  • ❤ 28
  • 🔥 21
  • 👍 12
  • ❤‍🔥 3
Post #139 4.49K
💙 Data Driven 2025.
Яндекс Поиск в Межнаре: как мы масштабируем аналитику на международные рынки

У меня тут накопилось несколько выступлений / подкастов, в которых я принимал участие за последние месяцы. Прихожу к вам рассказать про них!
Внутри этого доклада рассказал о том, что делает наш отдел аналитики международного Поиска, какие вызовы у нас возникают и как мы с ними справляемся.

Для кого может быть полезно:
1. Руководителям аналитики, которые развивают команды в условиях неопределённости
2. Аналитикам данных, которые хотят подсмотреть хорошие практики и позаимствовать проверенные идеи 🙂

Youtube: тут
Vk video: тут

Накидывайте ❤️ если вам интересен подобный контент 🙂
YouTube Яндекс Поиск в Межнаре: как мы масштабируем аналитику на международные рынки / Роман Васильев Спикер — Роман Васильев, руководитель аналитики международного Поиска Роман рассказал о том, как создаём аналитику для Яндекс Поиска на рынках Казахстана и Турции. Работаем с новыми географиями внутри корпорации: выстраиваем аналитику полного цикла, от исследования…
  • 🔥 23
  • ❤ 18
  • ❤‍🔥 8
Post #138 4.63K
⏱️ Валюта XXI века — внимание

1. Предпосылки
Сегодня компании борются не столько за деньги напрямую, сколько за внимание. Чем дольше вы находитесь в приложении, тем больше ценности вы создаёте для его владельцев. Пока вы скроллите ленту, вам показывают рекламу, а алгоритмы подстраиваются под ваши интересы, чтобы удержать вас ещё дольше. Так внимание превращается во время, а время - в привычку.

2. Онлайн
В рекламном бизнесе это давно просчитано
: за каждый клик и даже просто просмотр бренды платят реальные деньги. Есть теория пяти касаний - человек должен несколько раз столкнуться с брендом, прежде чем начнёт его узнавать и со временем что-то купит. Поэтому платформам выгодно, чтобы вы оставались как можно дольше: чем больше экранного времени, тем выше шанс, что эти касания произойдут.

Два часа в день в TikTok, Reels или Shorts - это не просто “отдохнуть и отвлечься”. Это инвестиция вашего внимания. Только выгоду от этой инвестиции получаете не вы.

3. Оффлайн
Кажется, что без экранов внимание отдыхает. На самом деле просто меняется форма: офлайн тоже устроен так, чтобы мы замечали. Вывески, музыка в кафе, запах кофе у витрины - всё это часть одной системы. Она не давит, но мягко подталкивает: задержись, зайди, купи.

Самый понятный пример - аэропорт. Чтобы попасть в зону вылета, вы проходите через Duty Free. Так повышают шанс, что вы сделаете покупку или хотя бы запомните бренды, с которыми столкнулись.

Внимание измеряется не только временем, но и шагами, запахами, звуками. Просто офлайн делает это чуть изящнее.

4. Что с этим всем делать
Не обязательно отказываться от технологий. Достаточно начать замечать, куда уходит ваше внимание.

Если на что-то уходит несколько часов в неделю - это уже инвестиция. Вопрос только, кому и во что. Иногда это время уходит не на людей или задачи, а на мелочи: бесконечный поиск нужного приложения, прокрутка до нужного чата, проверка «на секундочку», которая превращается в получасовой скролл.

Я для себя вывел несколько простых правил, которые действительно работают:
- Отключить уведомления. Не только звуки, но и цифры на иконках - они создают ложное ощущение срочности.
- Замьютить чаты и аккуратно разложить их по папкам. Чтобы читать тогда, когда нужно
- Систематизировать главный экран смартфона. 95% кликов приходят на первый экран + в приложения в доке
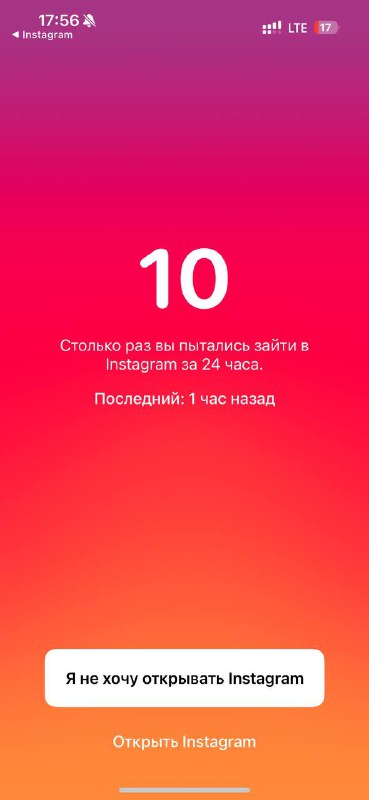
- One Sec (см скриншоты выше, не реклама!). Моё любимое открытие. Перед запуском соцсети - короткая пауза. За эти двадацать секунд мозг успевает спросить себя: «мне это сейчас действительно нужно?» - и часто ответ «нет».
- Проверять статистику времени. Когда видишь, что Instagram, YouTube и Telegram съели двадцать часов за неделю - становится проще навести порядок.

Эти простые вещи помогли мне вернуть фокус.

5. Финал
Очень важно осознавать, куда течёт ваше время, потому что время и внимание - самое ценное
. Особенно пока вы молоды, полны сил, когда мозг способен работать на пределе, а тело быстро восстанавливается.

Каждый день к вам приходит поток этой валюты. И только от вас зависит, куда вы его направите. Можно потратить два часа на ленту, а можно - на интересную книгу / встречу с другом / спорт.

Внимание - это ваша валюта. И если не управлять ею самому, найдутся те, кто с радостью сделает это за вас.

Ставьте ❤️ если согласны :)
  • ❤ 98
  • 👍 23
  • ❤‍🔥 11
  • 🔥 3
  • 👎 1
  • 😱 1
Post #134 3.01K
  • 👍 4
  • 🔥 4
  • 🥰 2
Older posts →

About this channel

How can I read @ravasiliev_ch without a Telegram account?
TGViewer shows the public web preview Telegram publishes for я так понимаю, Роман Васильев: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does я так понимаю, Роман Васильев have?
я так понимаю, Роман Васильев (@ravasiliev_ch) has 3.29K subscribers on Telegram, refreshed roughly every 30 minutes.
Does я так понимаю, Роман Васильев know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →