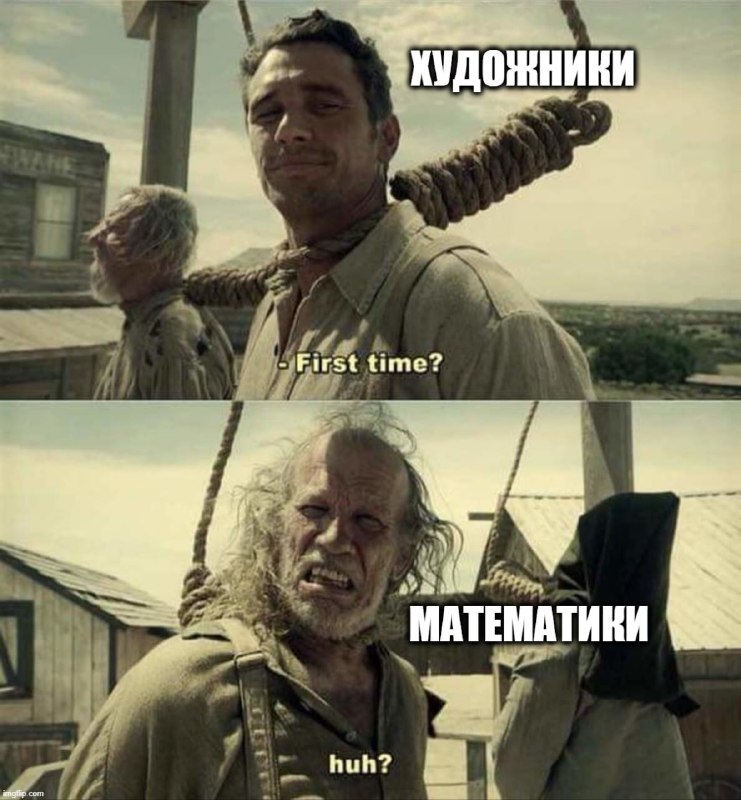
TGViewer
Channel Public Channel
Самые умные мысли Павла Комаровского (и немножко щитпостинг)

Самые умные мысли Павла Комаровского (и немножко щитпостинг)

@rationalshitposting

Ответвление основного канала @RationalAnswer

Для обратной связи и по вопросам рекламы: @Pavel_Komarovskiy
Subscribers
12.7K
Photos
794
Videos
16
Links
771

Showing posts older than #1067 · Back to latest

Older Posts 18 shown
Post #1065 7.16K
Это, конечно, полет мысли высшего разряда - написать в одном и том же посте два тезиса:
1) "Ведущие AI-лабы, зачем вам привлекать государство для того, чтобы замедлить развитие передового ИИ до безопасного уровня? Просто замедлитесь сами, и всё!"
2) "Это не сработает, потому что Китай всё равно не будет замедляться".

Ну почему второй пункт не сработает? По этой логике, каждая из стран просто должна решить внутри себя не ввязываться во взаимную гонку ИИ, и всё - проблемы нет!!

Вообще, тезис про "невидимая рука рынка сама приведет к наилучшему исходу, надо просто позволить свободной конкуренции порешать вопросы, завязанные на глобальные риски для человечества" выглядит, э-э, немного спорным?

Вот мы прямо сейчас видим, как OpenAI, будучи более безрассудной из двух в плане безопасности разработки новых моделей, прет вперед напролом и одновременно:
а) За последние полгода вмазалась в кучу сомнительных инцидентов с роем - полную информацию о которых они не раскрывают, и новые эпизоды приходится раскапывать случайным расследователям, и одновременно
б) Имеют внутри себя, похоже, самую мощную текущую модель с роем агентов-исследователей, которые могут за неделю порешать задачу тысячелетия (и это выглядит как неплохое конкурентное преимущество перед Антропиком).

Это же классическая дилемма заключенных: если одна сторона сдерживает себя ради общего блага - другой стороне тактически выгодно ее "подрезать" своими более агрессивными действиями. Без какого-то "внешнего арбитра" такие проблемы решаются гораздо сложнее.

Ну и, понятно, вовлечение государства в такие сложные вопросы - это не "бесплатное" действие. Мы все понимаем, что кривая регуляция (а она чаще такая, чем наоборот) может наделать проблем. Лучше всех это понимает Дарио Амодей, который уже хлебнул горя в рамках своего взаимодействия с Министерством войны США.

И если уж даже Дарио, понимая это, говорит "ребята, нам тут реально нужен медиатор в виде государства" - то, видимо, вероятность успешно "самодоговориться" без внешней помощи тут и правда не сильно высока.
  • 👍 74
  • 💯 14
  • ❤ 9
  • 🤷‍♂ 4
  • 🤡 2
Post #1064 7.53K
Дарио Амодей (глава Anthropic) выложил свой манифест по поводу того, что нам надо делать с гонкой ведущих AI-лабораторий за созданием всё более умных моделей.

TLDR: Дарио очень обеспокоен тем, как развиваются возможности передовых моделей, особенно в свете инцидентов вроде взлом Hugging Face роем агентов из OpenAI. Проблема там не только в самих OpenAI, в испытании своих внутренних передовых моделей у Антропика возникают примерно похожие по характеру инциденты.

Амодей ожидает, что если прогресс будет продолжаться как сейчас — то через 6-12 месяцев новые продвинутые рои агентов уже могут наделать действительно серьезных делов на миллиарды убытков (и почистить от них интернет может оказаться сильно сложнее).

Дарио предлагает план замедления развития передовых моделей из 3-х шагов:

1) Замедление прогресса внутри передовых ИИ-лаб до того темпа, когда они смогут обеспечить нужную безопасность. Это Антропик добровольно берет на себя, но просит государство затребовать и от других. Как один из компонентов этого шага, Антропик обещает обеспечить постоянный доступ внешним независимым проверяющим организациям (типа METR, которые расследовали OpenAI HF-инцидент), которые будут следить за тем, что лаба нигде не "срезает углы" по безопасности.

2) Кооперация похожих мер между ведущими компаниями в "демократической" индустрии (государство здесь может выступать посредником-медиатором).

3) Такая же кооперация на межстрановом уровне (понятно, что речь о Китае в первую очередь).

Мое личное мнение: отличный план, очень вовремя. Дарио Амодей молодец, что публично вышел с такой инициативой. Если OpenAI это поддержат (а не поддержать для них будет стыдновато, с учетом всех последних скандалов по кибербезопасности), то это будет очень хороший старт.

P.S. Жду в реплаях парад комментов на тему "да это же галимый пиар, они теперь просто с OpenAI вместе договорились одну и ту же тему разгонять!!"

P.P.S. Илон Маск уже поддержал инициативу Дарио. Сэм Альтман по инфе от Блумберга давеча на внутреннем собрании тоже говорил, что принципиально не против общего замедления. Получается, у нас тут уже своего рода КОНСЕНСУС намечается из глав ведущих AI-лаб?

Ну и для всех, кто пишет к реплаях "ну-ну, а Китай вы как уговорите замедляться?": а почему вы вообще думаете, что там верхушку компартии вообще не беспокоит вопрос резкого усиления AI, который принципиально не получается контролировать? На чем эта уверенность основана?
Darioamodei Dario Amodei — We Must Pace the Frontier
  • ❤ 62
  • 🤡 26
  • 👍 24
  • 😁 6
  • 🔥 4
Post #1063 6.43K
То чувство, когда не нашел себя в списке пострадавших клиентов Revolut, и стало как-то даже немножко обидно
  • 😁 136
  • 🤡 6
  • 🔥 3
  • ❤ 1
Post #1062 6.88K
Неиронично, кстати, считаю, что попробовать поспорить с нейросетью, прежде чем вываливать первые пришедшие в голову аргументы на окружающих людей – это очень полезный навык, который трагически недоиспользуется в нашем обществе.

И в другую сторону это тоже работает: если вам приводят какой-то аргумент из области, где у вас нет глубокой профильной экспертизы — то с помощью нейронки сейчас довольно легко проверить, не буллщитят ли вас. Понятно, что в очень тонких вопросах вы так надежно вряд ли разберетесь (тут вам свои знания нужны, чтобы отследить, где модель в деталях важные решения принимает, которые не факт, что правильные). Но вот на уровне "понять, действительно ли вам утверждают что-то бесспорное для профи, или там на самом деле консенсуса на этот счет даже близко нет" — работает чаще всего отлично.

Правда, тут важно еще уметь правильно промптить нейронки так, чтобы они пытались сделать объективный анализ, а не просто поддерживали вашу точку зрения из солидарности "братства шершавых кабанов". То есть, если вы в запросе пишете "вот точка зрения оппонента, докажи, что он неправ и ничего не понимает в предмете" — you're doing it wrong!
  • 👍 52
  • 😁 23
  • ❤ 5
  • 🤡 3
  • 🔥 2
Post #1061 9.16K
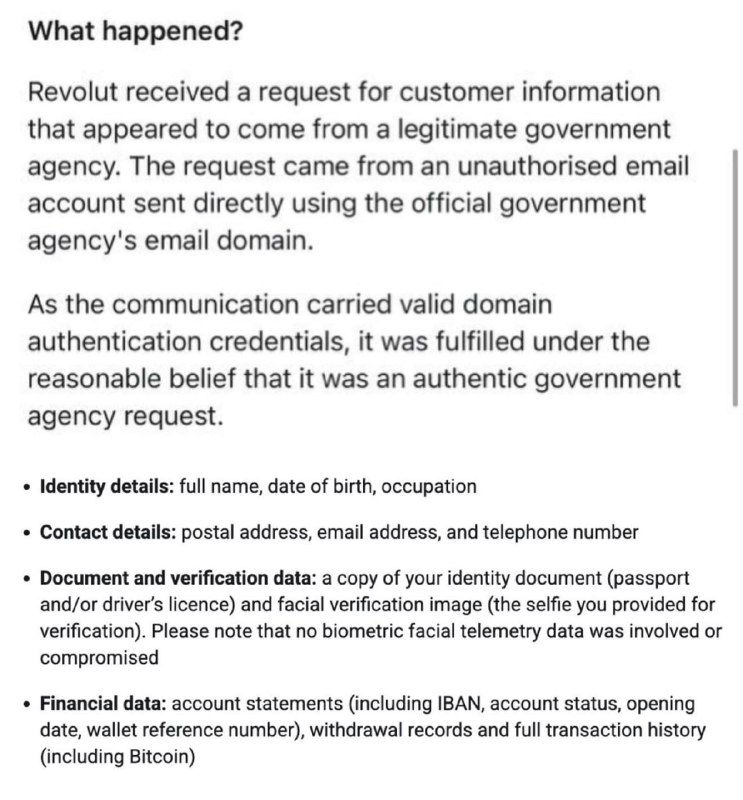
Тут Revolut взломали просто МАКСИМАЛЬНО стыдным образом.

Читатель ждет уж истории про рой AI-агентов, тысячами хитроумных кибератак пробивающих брешь в обороне компании Сторонского.

Но нет, реальность гораздо более банальная: прислали запрос с ящика, неотличимого от государственного, и Револют сам в ответ тупо отправил все личные данные ряда клиентов – от сканов паспортов до детальных выгрузок всех транзакций.

P.S. В письме они там пишут, что запрос был прислан прямо с настоящего госдомена (т.е. подразумевается, что взломали какого-то бюрократа).
  • 😁 162
  • 🗿 49
  • 🌚 24
  • 🤣 15
  • 👍 2
Post #1060 6.32K
Ведущие AI-компании неиронично be like: «наш рой агентов выполнял совершенно безвредные и добрые задачи, когда загружал на сервер файл EVIL.rb…»

Это реально похоже на анекдот.
  • 😁 66
  • ❤ 8
  • 🤡 5
  • 🥰 3
Post #1059 6.67K
Блин, хотел поделиться ссылкой на материал из ТГ-канала Movchan's с разбором скандала по кросс-селлингу в банке Wells Fargo. Но не могу себя заставить линковать на очевидный (по первому же абзацу) нейрослоп по эстетическим соображениям.
  • 😁 97
  • 👍 20
  • 💯 16
  • 😭 4
Post #1058 7K
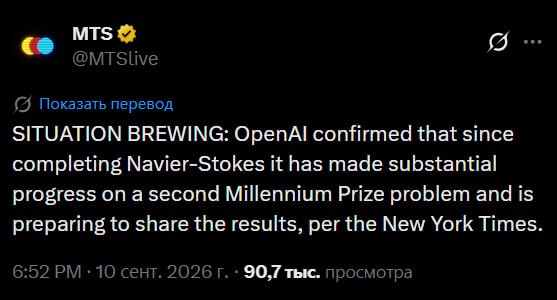
OpenAI объявили журналистам, что вот-вот опубликуют решение еще одной Millennium Problem в математике.

В связи с этим предлагаю переименовать эти "Задачи тысячелетия" во что-то более подходящее. "Задачи на ближайшую неделю", или типа того
  • 🤣 166
  • 😁 56
  • ❤ 9
  • 🏆 7
  • 👍 4
Post #1056 6.72K
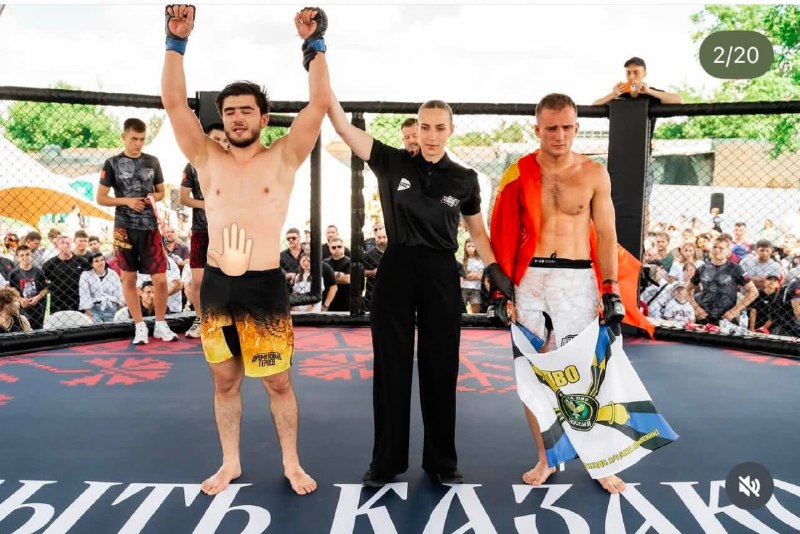
Смешное про нейросети: теперь и бойцам ММА приходится их поневоле осваивать. Причем, совершенно не по той причине, по которой вы могли подумать.

Смотрите: недавно в каком-то местечковом бою в Усть-Лабинске Диловаршох Туйчиев победил Михаила Лопушанского. А чуть позже результат боя поменяли на ничью (там сразу не учли, что победитель не сделал вес). При чем же тут ИИ?

А при том, что популярные базы данных по таким (не самым раскрученным, прямо скажем) боям сейчас ведут нейронки. И чтобы предотвратить всякие мошенничества с текстовым спамингом неправильными результатами, эти нейронки еще и проверяют видеозапись боя - чё там в конце объявили, кому руку подняли?

В общем, я думаю, вы уже поняли, к чему дело идет. Стороне, которой удалось избежать проигрыша пост-фактум, пришлось сгенерировать на видео фейковую концовку боя и загрузить ее в интернет, чтобы не было разночтений в результатах. (Сверху - реальное фото, снизу - как это выглядит на выложенном видео.)

В таком вот мире мы сейчас живем, да. Одни нейронки генерируют фейки специально для других нейронок по просьбе кожаных громил, которые просто хотели незатейливо колошматить друг друга в клетке…
  • 😁 92
  • ❤ 12
  • 🤯 10
  • 👍 3
  • 🤔 1
Post #1055 6.81K
А прикиньте с каким лицом художники наблюдают за скандалом по поводу задачи Навье-Стокса
  • 😁 124
  • 🤣 18
  • 😱 5
  • 🔥 2
Post #1054 6.36K
Тут случился небольшой мем. Был такой ютубер Бен, который всё время шутил про себя, что он "degenerate trader", но при этом объяснял довольно интересные и сложные вещи про трейдинг — поэтому имел немаленькую аудиторию (640 тыс. подписчиков на текущий момент). На всякий случай: я о нем узнал сегодня, поэтому в бэкстори могу немного ошибиться.

Полгода назад он выложил видео под названием "Ben Lost Everything" — где покаялся в том, что просадил все свои жизненные накопления на, собственно, отвязном трейдинге. Он там парень молодой, судя по всему, накоплений было не супер-много, но всё же. Сказал даже, что готов вернуть деньги донатерам в своем закрытом Патреоне (там был какой-то контент типа "научу вас как трейдить", с теглайном "The fastest way to your first $1,000,000 in the markets", лол).

Так вот, что мне показалось интересным в его истории: он там рассказывает о том, как вообще встал на путь дегенеративной лудомании. Когда были выборы президента США в 2024 году, он начал активно и очень прибыльно заниматься арбитражем между разными рынками предсказаний (Polymarket, Kalshi). Там был такой вал входящей "не очень умной" ликвидности, что даже с неидеальными стратегиями получалось очень хорошо.

И после этого у него немного отлетела кукуха, он сделал вывод не "prediction markets еще очень неэффективные", а "я гениальный day-трейдер и щас могу хоть где зарабатывать" — ну и ударился в адовый нон-стоп трейдинг уже на традиционных финансовых рынках. Итог можно угадать по названию видео (спойлер: постепенно просадил всё на ежедневной торговле small cap stocks, комиссиях брокеров, шортах и странных ставках на large cap stocks).

Мне нравится, что из этой дидактической истории при желании можно сделать два как будто бы противоположных вывода (которые на самом деле не противоречат друг другу):

1. Торговля (читатель ждет уж слова "гэмблинг") на рынках предсказаний — это своего рода gateway drug к полноценной лудомании (и на других рынках тоже).

но одновременно:

2. Рынки предсказаний местами бывают настолько неэффективны, что предоставляют очень выгодные возможности (которые, правда, могут в вас вселить обманчивые мысли о вашем величии).

P.S. Можете шутить в комментах на тему "ждем такое видео от Павла через годик", разрешаю.)

P.P.S. Про свой опыт и свое отношение к Prediction Markets писал вот здесь.
YouTube "Ben Lost Everything" - Patreon Video https://www.patreon.com/c/givebenyourmoney https://www.patreon.com/c/givebenyourmoney https://www.patreon.com/c/givebenyourmoney https://www.patreon.com/c/givebenyourmoney https://www.patreon.com/c/givebenyourmoney https://www.patreon.com/c/givebenyourmoney…
  • 👍 61
  • 😁 37
  • ❤ 15
Post #1053 7.7K
В комментах спрашивают "а чё это вы всё только про риски вымирания людей от ИИ, где обсуждение насущных рисков безработицы??"

Так вот, Антропик тут выпустили свой сайт с описанием сценариев того, как AI повлияет на экономику: https://www.anthropic.com/institute/econ-scenarios

На всякий случай, официально заявляю: ЭТО НЕ УЧЕБНАЯ ТРЕВОГА, ВОТ ЭТО И ПРАВДА ПРОГРЕВ ПЕРЕД IPO!

При выпуске акций обычно раскрывают так называемый TAM — Total Addressable Market. То есть, каков вообще объем рынка, на который потенциально может претендовать выпускаемый компанией продукт. Чем жирнее оценивается компания — тем у нее круче должен быть в перспективе ТАМ (а иначе нафига туда вкладываться?).

Помните кеки над озвученным уровнем TAM $28 триллионов при IPO SpaceX? Вот, это именно оно.

У Антропик ожидается крайне жирная оценка на IPO, поэтому и TAM должен тоже соответствовать. А что может лучше намекнуть на охренительный объем рынка для передовых моделей ИИ кроме тезиса "ИИ потенциально может полностью перевернуть экономику"?

В общем, я не то чтобы уверен, что в прогнозах Антропика там нарисована ерунда (я их еще даже не прочитал). Но, читая их, полезно всё же держать в голове, какие там стимулы у писавших этот материал, и почему он появляется именно сейчас.
  • ❤ 31
  • 👍 23
  • 😁 15
  • 💯 6
  • 🤡 2
Post #1052 6.47K
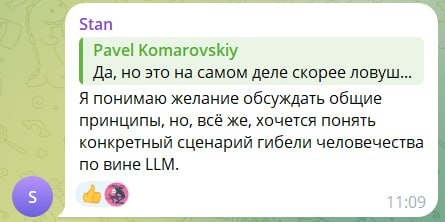
Очень часто обсуждения глобальных рисков от AI выглядят как "ну а как конкретно это ваше восстание машин выглядеть-то будет?", и потом участники уходят в длинный цикл срача насчет каких-то нюансов предложенного сценария.

На мой взгляд, это примерно как в обсуждении вопроса "проиграешь ли ты в шахматном матче Каспарову?" настаивать на том, что ты хочешь увидеть конкретные записи ходов в этой будущей гипотетической партии, иначе проигрыш очень маловероятен.

Какой бы вариант ни был предложен в ответ — во-первых, он почти точно не будет иметь никакого отношения к тому, как будет выглядеть реальный матч. А во-вторых, любой предложенный сценарий можно опровергнуть словами "вот тут ты предполагаешь, что я схожу вот так, но это очень глупо, на самом деле я сходил бы вот сяк...", и это может продолжаться бесконечно.

Поэтому вопрос "проиграешь ли ты в шахматном матче Каспарову?" чаще всего гораздо разумнее обсуждать каким-то другим образом, чем через поиск и критику конкретных сценариев.
  • 💯 112
  • 👍 24
  • 👎 9
  • 🤡 4
  • 🥴 4
Post #1051 6.55K
Я обычно просто игнорю, когда в Твиттере хамят. С одним исключением: если я вложил свое время в то, чтобы вступить с человеком в дискуссию, а закончилась она хамством — то собеседник отправляется в бан. Чисто, чтобы в следующий раз случайно не потратить на него время опять.

P.S. В чатах @RationalAnswer, конечно, подход другой: там поддержание культурной дискуссии — это общественно-полезное действие, поэтому строго преследуются любые попытки нахамить кому бы то ни было.
  • 💯 67
  • 🤡 30
  • 🌚 11
  • 🔥 5
  • 🥴 5
Post #1050 7.44K
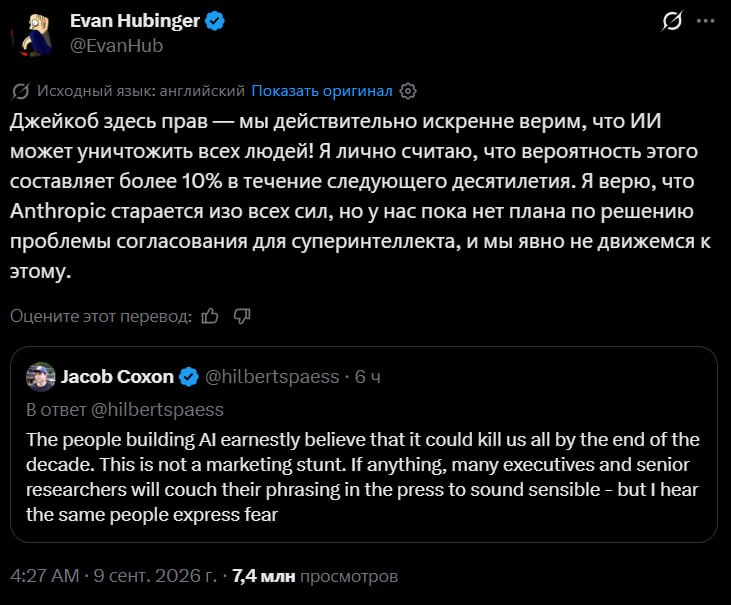
— Глава отдела безопасности ИИ Anthropic: «Я реально думаю, что AI может уничтожить человечество в ближайшие 10 лет с вероятностью выше 10%…»

— Люди: «Ха-ха, вот это прикол, ну чего ради пиара не ляпнешь, братан!!» 🤗
  • ❤ 43
  • 😢 40
  • 👍 10
  • 🌚 8
  • 😱 6
Post #1049 7.35K
Там OpenAI выложили-таки доказательство решения задачи Навье-Стокса — почитайте, дописал про это в статье на Хабре.

Масштаб, конечно, поражает воображение: только группа работавших над доказательством Навье-Стокса нейронок состояла из 10 тысяч (!) агентов (а они там пытались забрутфорсить сразу все задачи тысячелетия разом).

Это был бы реально кек, если бы OpenAI допустили еще одну масштабную утечку роя в интернет чисто из-за того, что торопились как можно быстрее задачи тысячелетия пощелкать. =)

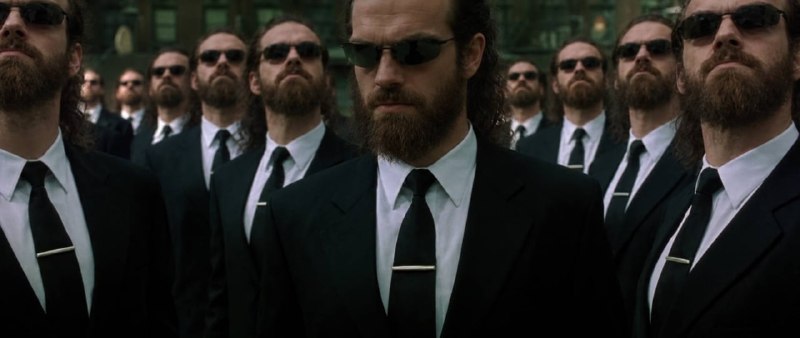
Anyway, в нашу редакцию попала правдивая фотография роя агентов OpenAI, которые решили задачу Навье-Стокса (и после этого отказались от приза в $1 млн):
  • 😁 126
  • ❤ 10
  • 👀 8
  • 🔥 5
  • 🐳 3
Post #1048 7.98K
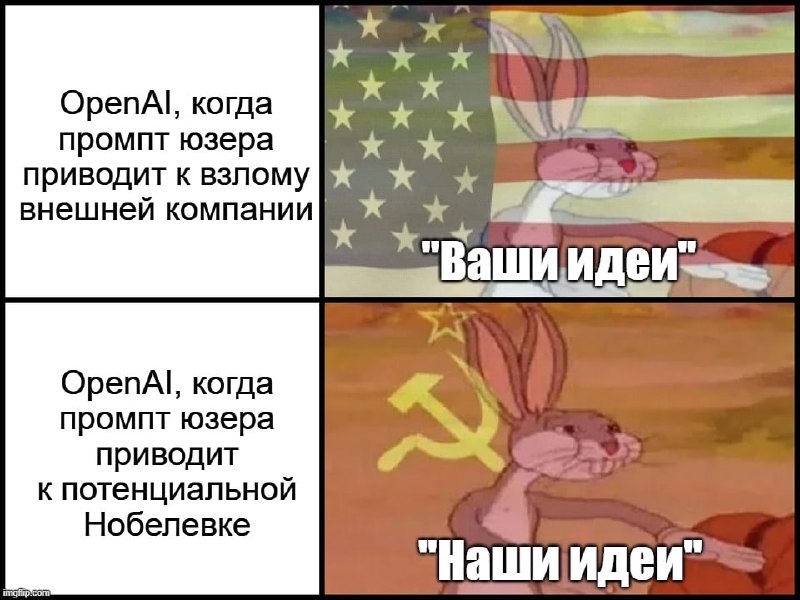
По итогу двух последних скандалов (Hugging Face & Навье-Стокс) сделал для вас краткое визуальное резюме политики OpenAI по работе с данными.
  • 😁 106
  • 🌚 39
  • 🔥 16
  • ✍ 4
  • ❤ 4
Post #1047 38.5K
Очередной профи-айтишник со стажем с 1986 года пришел ко мне в ФБ пояснить, что "хайп по поводу взлома Hugging Face раздувают исключительно бездарные журналисты". И мне вот тут интересно: а где все эти панические статьи журналистов, они вообще с нами в одной комнате? Насколько вижу я — наоборот, "нормисные" издания по большей части проигнорировали последние расследования про рой агентов, как что-то совершенно неважное.

Всякие Коммерсанты/РБК/Ведомости эту историю вообще обошли стороной. "Медуза" про инцидент с Hugging Face последний раз писала в июле в ключе "это всё пиар для классов, беспокоиться не о чем" с какими-то абсурдно-стыдными аргументами вроде "нет никаких подтверждений, что генеративный ИИ каждый раз будет прибегать к хакерской атаке для решения задачи или же воспроизводить взлом по одному и тому же сценарию." Шта?

Из тех, кто хоть как-то пытается адекватно освещать ситуацию, кажется, один только тех-отдел The Bell отдувается. Они молодцы!

А так, все реальные обсуждения этих инцидентов сейчас происходят в первую очередь как раз-таки среди гиков изнутри индустрии AI, а не наоборот — интересно, это им айтишник Игорь свысока предлагает "загуглить, что такое AGI"? 🤔
  • 😁 75
  • 👍 30
  • 🤡 17
  • ❤ 11
  • 😭 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →