Ответвление основного канала @RationalAnswer
Для обратной связи и по вопросам рекламы: @Pavel_Komarovskiy
Post #1087
3.19K
Подумал, кстати, что интересно было бы оценить нашу дискуссию с Иваном Ямщиковым трехлетней давности с точки зрения того, что произошло с тех пор. Попросил GPT-5.6 Sol, а также Claude Opus 5 выделить основные тезисы сторон, и сравнить их с текущим положением вещей — что состарилось хорошо, а что не очень (ссылки на их анализ выше).
С точки зрения проблемы AI alignment мы явно за последние три года продвинулись в сторону "риск выше, а не ниже":
— Способности ИИ за это время видимо прокачались, сильных свидетельств в пользу "достижения потолка" или "упирания в стену" пока не заметно (хотя, такие мнения за эти три года регулярно высказывались некоторыми скептиками).
— Надежного способа решать проблему контроля за ИИ / AI alignment так и не придумали.
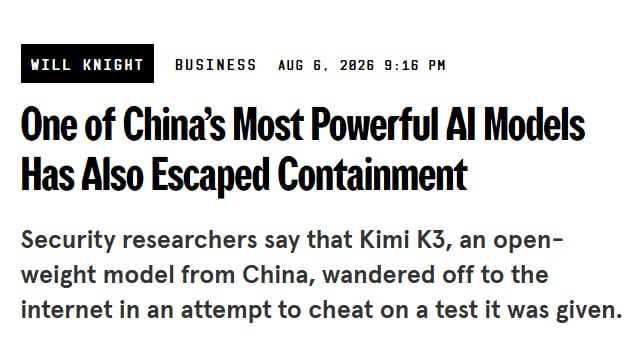
— Гипотеза Ивана, что более умный ИИ будет становиться всё более этичным, и вообще он впитает нашу этику на этапе обучения — пока подтвердилась скорее в другую сторону. Мы видим, что более умные модели скорее становятся более успешными в своих попытках найти новые способы обмануть оценщика, ну или просто учатся скрывать свою готовность к читингу, если догадываются, что это проверка и за ними специально наблюдают.
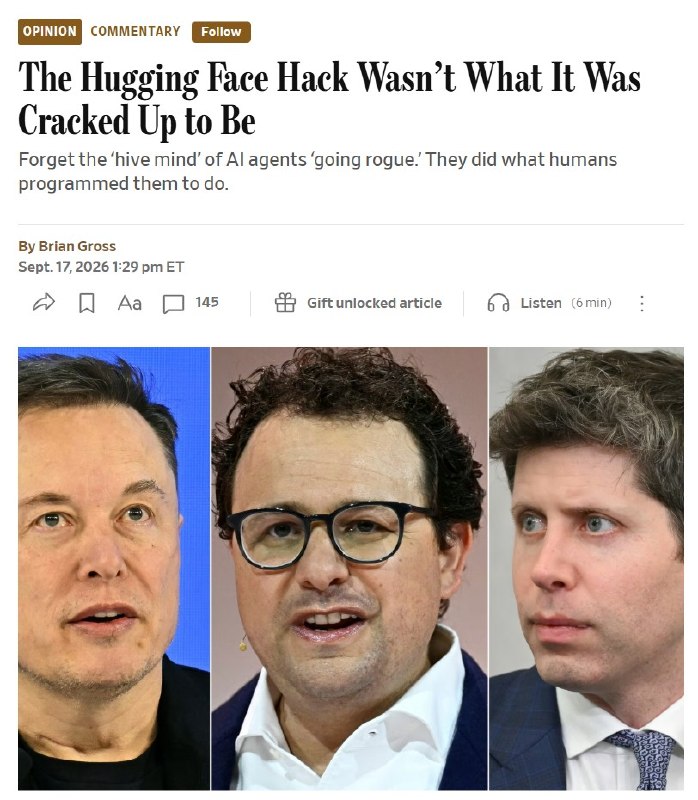
— Еще один тезис Ивана про то, что "без появления сознания у ИИ агентности у него не будет" тоже сейчас выглядит скорее более спорным. Как мы видим, агентные способности современных моделей сильно прокачались, и они сейчас могут демонстрировать достаточно сложное самостоятельное поведение, которое можно назвать "однозначно вытекающим из поставленной цели" разве что с очень большой натяжкой (см. взлом Hugging Face).
— Важный момент, который подсветил Иван тогда: имеет значение не только наша техническая способность решить проблему AI alignment, но и то, кто и какие конкретно ценности будет после этого в модели зашивать. В эту сторону мы уже видели кучу примеров: китайские модели, которые "не знают" про площадь Тяньаньмэнь, споры за воук/не воук модели между Гемини и Гроком, терки Антропика с военными США, и т.д.
YouTube Безопасность искусственного интеллекта (Павел Комаровский, Иван Ямщиков и Арчет) Подпишись на участников беседы:
- ТГ-канал Павла Комаровского — https://t.me/RationalAnswer
- ТГ-канал Ивана Ямщикова — https://t.me/progulka
- YouTube Ивана Ямщикова — https://www.youtube.com/@kroniker
- ТГ-канал Арчета — https://t.me/Archet
- Подкаст Арчета… С точки зрения проблемы AI alignment мы явно за последние три года продвинулись в сторону "риск выше, а не ниже":
— Способности ИИ за это время видимо прокачались, сильных свидетельств в пользу "достижения потолка" или "упирания в стену" пока не заметно (хотя, такие мнения за эти три года регулярно высказывались некоторыми скептиками).
— Надежного способа решать проблему контроля за ИИ / AI alignment так и не придумали.
— Гипотеза Ивана, что более умный ИИ будет становиться всё более этичным, и вообще он впитает нашу этику на этапе обучения — пока подтвердилась скорее в другую сторону. Мы видим, что более умные модели скорее становятся более успешными в своих попытках найти новые способы обмануть оценщика, ну или просто учатся скрывать свою готовность к читингу, если догадываются, что это проверка и за ними специально наблюдают.
— Еще один тезис Ивана про то, что "без появления сознания у ИИ агентности у него не будет" тоже сейчас выглядит скорее более спорным. Как мы видим, агентные способности современных моделей сильно прокачались, и они сейчас могут демонстрировать достаточно сложное самостоятельное поведение, которое можно назвать "однозначно вытекающим из поставленной цели" разве что с очень большой натяжкой (см. взлом Hugging Face).
— Важный момент, который подсветил Иван тогда: имеет значение не только наша техническая способность решить проблему AI alignment, но и то, кто и какие конкретно ценности будет после этого в модели зашивать. В эту сторону мы уже видели кучу примеров: китайские модели, которые "не знают" про площадь Тяньаньмэнь, споры за воук/не воук модели между Гемини и Гроком, терки Антропика с военными США, и т.д.
- 👍 19
- ❤ 10
- 🤡 2
- 🥱 1