TGViewer
Channel Public Channel
Pixel Science

Pixel Science

@pixels_science

пишем о ресёрчах по Комьютерной Графике, нейронному Рендеру и ИИ

и про их влияния на индустрию конечно же, с инсайдами из личного ресёрча и карьеры

автор: @Mishok43, mishok43.com, PhD студент в IVD KIT, ex Eagle Dynamics
Subscribers
478
Photos
136
Videos
53
Links
106

Showing posts older than #203 · Back to latest

Older Posts 13 shown
Post #201 640
Почему полезно графикам следить за миром фундаментального ИИ?

Я думаю уже все видели самую ожидаемую презентацию Ильи Суцкевера с NIPS 24

Если же нет, то вот рекомендую выделить 20 минут своего времени, т.к. он озвучивает часть мыслей в слух, которые уже витали в воздухе, но многие в них сомневались

Находясь на научном фронтире, благодаря аллоцированным ему ресурсам (~1$ млрд) и его положению, важно что он подтверждает своими словами 2 тейка:
- Данные не растут. У нас всего 1 интернет. И именно он не позволяет отскалироваться современным моделям, полагаясь на pre-training
- Одним из решением может являться Synthetic Data

Что значит Synthetic Data в нашем случаи? Конечно же это рендеры, которые можно использовать для обучения моделей. Безусловно там еще множество фундаментальных проблем, но я бы ожидал всё больше инвестиции в физически-корректные визуализации и автоматизацию создания контента в ближайшие года

И да, Sora, кажется обучалась на Apex, подтверждая теорию выше :)

#ии #графон #индустрия
  • 🤔 6
  • ❤ 4
Post #198 601
В последние пара дней в твиттере происходит забавный срач на фоне выхода Sora и ооочень крутой модели text->game от Google (рекомендую оценить если ещё не видели)

Графики решили пообесценивать достижения ИИ-ресерчеров, а те в ответку поиздевались над первыми

А я в этот момент сижу на двух стульях и хохочу с этого небольшого цирка 😁

Но Ben got the point:
Оставаясь чисто рендерщиком в 2024 году, можно и правда повторить судьбу лингвистов в области Natural Language Processing
  • 🥰 7
Post #197 562
Pixel Science Аномальные тени и геометрия с некорректной проекцией выдают современные генеративные модели. Авторы обнаружили, что можно просто обучить детекторы ИИ определять оригинальность изображений исключительно полагаясь на геометрические данные без доступа к оригинальным…
Пока все комментируют интересные особенности опубликованной OpenAI Sora, хочу подметить, что тейк о котором я уже давно писал все еще актуален: Диффузные - flow matching - модели все еще не могут выдерживать геометрическию проекцию

на что также обратил внимание ученый из TTIC


Конечно, если поддать еще больше данных оно наверняка отскалируется. Но, учитывая уже текущие вычислительные вложения, поразительно как сетки все еще не могут успешно проецировать геометрию без искажений 🫠🫠🫠

Или же надо прибегать к 3D inductive-bias через привнесение некого rendering equation. Или biased, как в NeRFах\GSplats, или unbiased как в PBR. Но из этого наследуется столько проблем, что аж страшно себе представить и там генеративные успехи, все еще на "уровне GANов".

В общем, сложна 😕
Post #196 446
Чтобы вы понимали почему скорее всего завтра не появится нормальной LLMки, которая будет писать крутые шейдера: для обучения текущих открытых SoTA LLMок используется сотни гигабайт С++ файлов, десятки миллионов Си файлов и т.д.

уже отфильтрованного кода

А с shadertoy, того же, моим коллегам по академии удалось вытащить всего лишь порядка ~200 МБ шейдеров или же 50к файлов

Спасет лишь синтетика
  • ❤ 6
  • 🫡 5
Post #195 485
Ждём такого же подъеба, но в сторону Light Transport Simulation 🫣

но пока, насколько мне известно, никто не обучает модельку, предсказывающую освещение для случайного набора параметров сцены

всё больше данных, демонстрирующий, что классические численные методы просто на просто sucks
  • ❤ 5
  • 👍 1
Post #194 569
Matthias Niessner из TUM организовал разговор от Chief Scientist-ом Luma Labs Jiaming Song, который начался лишь 10 минут назад. Кто хочет - запрыгивайте!

Upd:
Очень рекомендую
- Объясняет мотивацию к использованию фото и видео в качестве основы ИИ, а не 3Д. И почему не полагаемся на ИИ-based 3D рендере

- Кратко объясняет все то, что происходило в сфере за последний год. Приятно видеть все знакомые статьи

- Демонстрирует интересные примеры ИИ-based "light transport" и физики
YouTube TUM AI Lecture Series - Dream Machine: Emergent Capabilities from Video Models (Jiaming Song) Abstract: Dream Machine is a new video generative foundation model developed by Luma AI. We will show how Dream Machine exhibits some emergent capabilities that relate to vision, such as depth, segmentation, light transport, dynamics, and causality. Given…
  • ❤‍🔥 4
  • ❤ 1
Post #193 452
Pixel Science Ben Mildenhall, создатель NeRF-ов, объявил о своем новом стартапе World Labs, который кафаундит вместе с Fei-Fei Li (профессорка Стенфорда, ex-VP Google, "godmother of AI") и с Christoph Lassner. Все три с PhD 😊 Фандинг 230$ млн 🤯🤯🤯 И они хайрят! Им нужны…
Не прошло и года с момента, как World Labs получили фандинг, а ребята уже выпустили интересные демки с видосами генеративных 3д миров, поддерживающих:
- базовую физику и коллизии
- передвижение камеры
- консистентный мир даже с какими-то отражениями
- освещение сцены искусственным источником света
- depth-based эффекты
- динамические эффекты, анимация, водичка

всё это работает не идеально, т.к. мы все еще наблюдаем:
- странные искажения перспективы
- несоответствие отражений и действительности
- освещение уровня 90ых годов CGI - для искусственного источника света


ставлю на то, что последние две проблемы будет очень сложно разрешить в долгосрок... но кто сказал, что их прям уж и обязательно разрешать для успешного продукта в ближайшем будущем?)

#графон #ии #индустрия
  • 🔥 3
Post #191 548
Odyssey, привлёкший еще дополнительно 18$ млн решил подойти к проблеме генерации реалистичных 3Д миров (именно 3Д, 3Д) прагматично:
отправить в хайк ребят с качественными панорамными камерами, лидарами, гиростабилизатор и попросить их отсканировать леса, дороги, пещеры и т.д.

весит махина ~12кг с аккумулятором.
зачем?!?...


помните давнюю работу от Интел, Enhancing Photorealism Enhancement, где ученые еще используя устаревшие GANы и датасет с камер машин, смогли добиться "реалистичной" графики в GTA (видео)? к сожалению, штука работает нормально только с похожим контентом, т.е. с трафиком, дорогами и улицами

для решения более сложной задачи нужен более генеральный датасет... вот они его в тупую и собирают 😁

также на сайте представлен очень качественный текст с рассуждением на тему проблем современных Gaussian Splats, NeRFов, Meshей и т.д. утверждают что их цель - найти новое решение, новое представление в 3Д

можно им лишь пожелать удачи! а если кто ищет работу - рекомендую постучаться :)
#индустрия
  • ⚡ 4
  • 🫡 2
  • ❤ 1
  • 🔥 1
Post #190 432
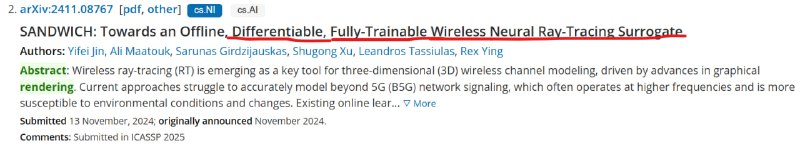
авторы собрали все ключевые слова 😁

✅ Differentiable
✅ Trainable
✅ Wireless
✅ Neural
✅ Ray-Tracing
  • 😁 9
Post #186 424
Можно было бы: отсканировать геометрию, реконструировать каждый волосок, восстановить все возможны параметры описывающие BSDF кожи, важнейшие для корректного subsurface scattering-а (вплоть до определения меланина и гемоглобина в крови. читай тут). для этого надо было бы снять лицо под 1000 вариантами освещения, а не под 1им. далее провести дорогостоящую симуляцию света, ебясь с Monte Carlo шумом. Meta делала похожее просто :)

Что они сделали:
1️⃣ натравили динамические GSplats на видос таргет-лица для рендера flat-lit face с любого ракурса. ушли от проблемы реконструкции геометрии.
2️⃣ далее тупо применили fine-tuned Stable Diffusion 2.1, на вход которой подается flat-lit render и token sequence с закодированным SH освещением (вместо text-conditioning) => на выходе итоговый relit рендер. обучили используя 123 environment map-ы

всё. 0 PBR. 0 инженерии. но работает 👌

сколько времени занимает рендер? 5-6 секунд на А100 (~ RTX 4090) 1080p. это без оптимизации модели, с 30 диффузными шагами. кто в теме понимают, что можно достичь около SOTA результатов за 1-4 шага, что уже позволяет достичь ~200ms/frame. если еще оптимизировать исполнение модели, уверен что ~50ms более чем возможно! теперь подумайте сколько бы времени заняла симуляция света для похожего качества 🫠 или же денег-часов инженеров, пытающихся её ускорить...

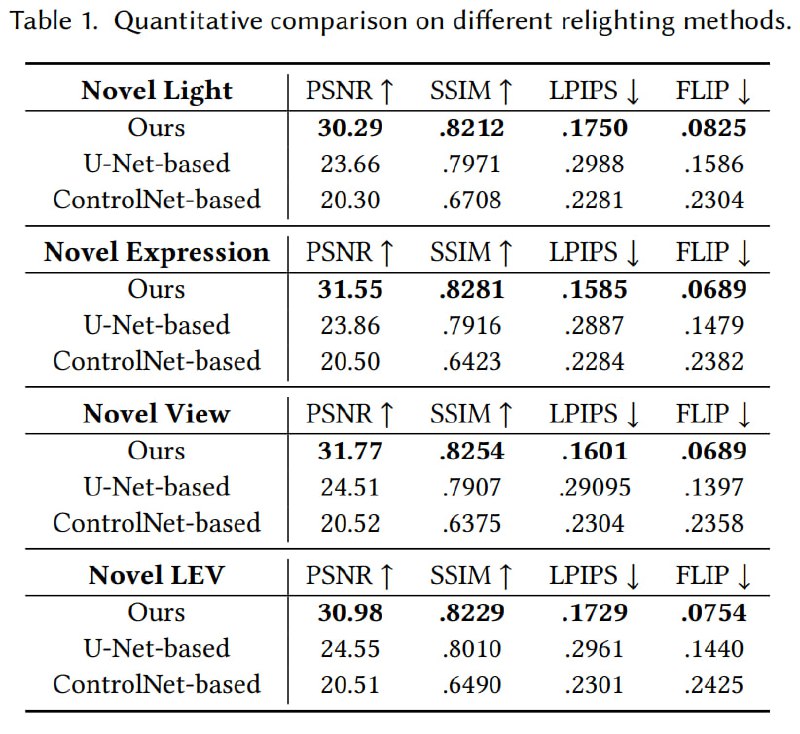
какова мысль: диффузные сетки - как показывает одно из сравнений, приложил ниже - очень хорошо понимают как должны выглядеть лица. и как +- работает light transport. так еще мы их и исполнять учимся в реал-тайме (AI-Minecraft\AI-Doom)
так может быть им и правда стоить доверить часть рендера? т.к. оно просто на просто эффективнее, а еще есть окно для оптимизации, и не требуют реконструкции 1000 параметров?
если есть чем дополнить - пишите 👍
Post #184 392
Netflix выпустил крутую работу Diffusion-Based Facial Performance Relighting, которую я бы предложил разобрать более научно, не коротко, но без попсы

1️⃣ Призываю зайти на сайт проекта и посмотреть их великолепные примеры освещения captured лиц. Качество безусловно на уровне 9-10/10. Ну и авторы просто разбили все иные решения, судя по PSNR, SSIM, FLIP и т.д. (см. внизу)
2️⃣ Окей. В чём же сыр-бор?
Дано: видео с flat-lit лицом с эмоциями
Хотим: хотим "зарендерить" с новым освещением и novel-view - вставка актеров в виртуальную сцену


Читай ниже ⬇️

#ии #графика #статья
  • 🔥 1
Post #183 351
Мне кажется этот прекрасный график объясняет за секунду важность скиллов в High Performance Computing и понимания современной архитектуры железа

Добавлю это в слайды для своего GPGPU курса следующего семестра! Кстати, возможно благодаря тому что я пиарил курс в этом семестре через призму AI-Computing-а мы увидели 4х рост в числе студентов 🥳

#ии #индустрия
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →