TGViewer
Channel Public Channel
Data Science by ODS.ai 🦜

Data Science by ODS.ai 🦜

@opendatascience

First Telegram Data Science channel. Covering all technical and popular staff about anything related to Data Science: AI, Big Data, Machine Learning, Statistics, general Math and the applications of former. To reach editors contact: @malev
Subscribers
38.4K
Photos
1.3K
Videos
152
Links
2.3K

Showing posts older than #3285 · Back to latest

Older Posts 15 shown
Post #3284 2.05K

Forwarded from Russian OSINT
👩‍💻 ChatGPT: "Украл, выпил — в тюрьму... Романтика!"

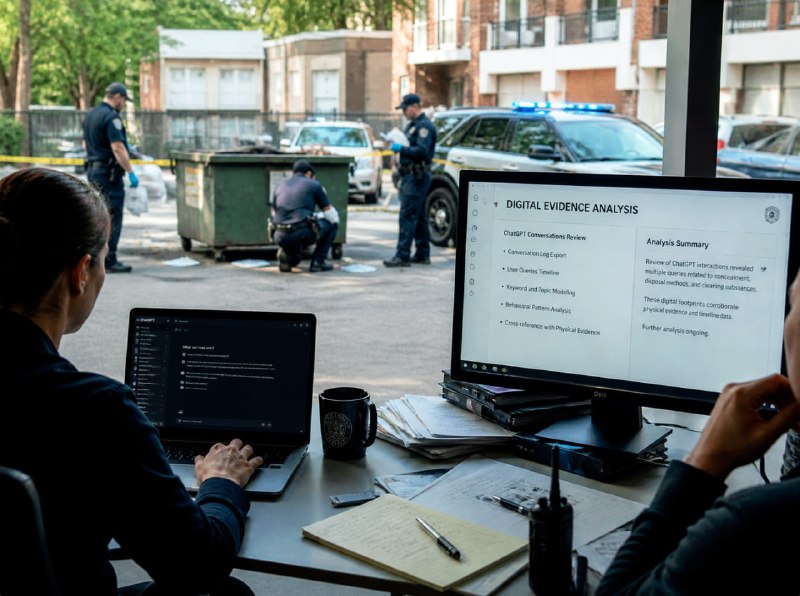
Бывший студент Университета Южной Флориды Хишам Абугарбие обвиняется в убийстве двух аспирантов. По данным следствия, за 3 дня до исчезновения жертв подозреваемый консультировался с ⭕️ СhatGPT по поводу утилизации человеческого тела в мусорном контейнере. 👮Полиция обнаружила личные вещи убитых среди выброшенных коробок в мусорном контейнере жилого комплекса. Останки одного из пропавших следователи нашли позже на обочине моста.

Правоохранители зафиксировали покупку плотных пакетов и чистящих средств в день предполагаемого убийства.

Запросы к ChatGPT могут рассматриваться следствием 🇺🇸 точно так же, как и практика просмотра истории поиска в браузере подозреваемого. Если человек целенаправленно ищет способы совершения преступления или сокрытия улик, то прокуроры традиционно используют этот факт как косвенное подтверждение преднамеренности действий. Диалог с нейросетью выступает 📖цифровой уликой, которая помогает доказать факт планирования исключительно в совокупности с физическими уликами.

✋ @Russian_OSINT
  • ❤ 1
  • 👍 1
Post #3283 1.76K

Forwarded from Machinelearning

📌 Студенты собрали GPT целиком в железе на учебной плате

Лютира Абейкун и Криш Чхаджер из Университета Торонто взяли microGPT Андрея Карпатого и переписали его на языке описания цифровых схем SystemVerilog. Так родился проект TALOS-V2, который работает на образовательной плате DE1-SoC с FPGA Cyclone V, которую обычно дают в вузах для лабораторных работ.

Инференс на ней не выполняет ни GPU, ни PyTorch, ни даже CPU - каждый шаг трансформера, от эмбеддингов и самовнимания до нормализации, MLP и выбора следующего токена, превращён в физическую цепь из логических элементов.

Сама модель - символьный microGPT, обученный на датасете имён Карпатого: символ за символом она генерирует новые имена. Маленькая по меркам индустрии, но устроенная как взрослые генеративные модели: те же блоки, те же связи.

Внутри FPGA числа хранятся не как привычные дроби с плавающей точкой, а в формате Q4.12 - 16 бит, разделённые на целую и дробную часть.

Это компромисс: точности хватает для такой модели, а схема получается компактной и предсказуемой по времени работы.

Веса заранее переведены в шестнадцатеричные файлы и загружены прямо в постоянную память чипа.


Сердце схемы - один универсальный вычислительный блок на 16 параллельных каналов, который умеет умножать вектор на матрицу.

Он по очереди обслуживает все ключевые операции трансформера: проекции Q, K, V, выходную проекцию внимания, оба слоя MLP и LM-head.

Самый трудный для железа блок - softmax, нормирующая функция внутри механизма внимания. Экспоненту считает таблица заранее заготовленных значений, деление выполняет специальный многотактный модуль, заточенный под узкий диапазон входных чисел и потому быстрее универсального.

В механизме внимания деление - самая медленная операция и тормозит весь блок, поэтому таких делителей поставили сразу 2: они работают параллельно и снимают эту задержку. Поиск максимума совмещён с подсчётом скалярных произведений, чтобы не делать лишний проход по данным.

Даже выбор следующего токена происходит внутри чипа: алгоритм xorshift даёт случайность, а специальная схема сэмплирования бережёт распределение от перекоса в сторону младших символов. Хост-компьютер только запускает генерацию и забирает готовый результат.

В итоге плата устойчиво выдаёт больше 50 000 токенов в секунду, зафиксированный пик - около 53 000.


Проект открыт на GitHub: SystemVerilog-ядро, тестбенч под ModelSim, Python-утилиты для экспорта весов и запуска инференса через JTAG, скрипты под Quartus.


🟡Статья
🖥GitHub


@ai_machinelearning_big_data

#AI #ML #FPGA #RTL #Transformer #TALOS
  • 🔥 11
  • ❤ 4
  • 👍 3
Post #3281 2.03K

Forwarded from Анализ данных (Data analysis)

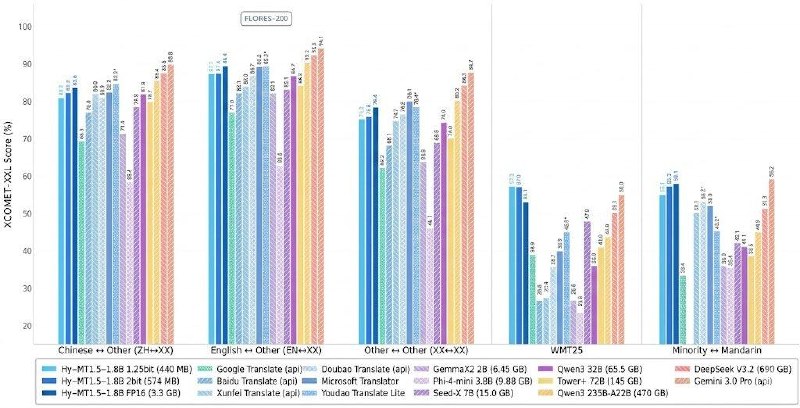
Tencent ужал переводчик до 440 мегабайт и сделал его умнее Google Translate

Китайцы из Tencent выложили в открытый доступ модель Hy-MT1.5-1.8B-1.25bit, и это тот случай, когда длинное название скрывает по-настоящему любопытную штуку. Переводчик весит 440 мегабайт, целиком работает офлайн на телефоне, понимает 33 языка и при этом обгоняет Google Translate на стандартных бенчмарках.

Главный фокус тут в квантовании. Обычно модель такого размера в FP16 занимает около 3,3 гигабайта, что для смартфона уже многовато. Tencent сжали её до 1,25 бита на вес, и в итоге получили файл в семь с половиной раз меньше оригинала. Что особенно приятно, это не привычная история «сжали и оно начало нести чушь». Точность не просела, а по сравнению с предыдущими подходами на 1,67 бита новая версия ещё и работает примерно на десять процентов быстрее.
При своих скромных 1,8 миллиарда параметров модель умудряется тягаться с коммерческими API и даже с гигантами на 235 миллиардов.

То есть на стандартных тестах перевода она играет в одной лиге с системами, которые в сотню раз тяжелее и крутятся в дата-центрах, а не у вас в кармане.

Покрытие тоже не для галочки. 33 языка, 5 диалектов и 1056 направлений перевода, причём в список попали тибетский и монгольский. Это редкий случай, когда крупный игрок не ограничивается английским, испанским и парой ходовых европейских, а реально вкладывается в малые языки, которые обычно остаются за бортом коммерческих сервисов.
В довесок Tencent напоминают, что их переводческий стек уже тридцать раз брал первые места на международных соревнованиях по машинному переводу и стоит внутри продуктов компании.

ЭТО боевая технология, которую просто решили отдать наружу. На Hugging Face лежит сама модель, на GitHub код, и есть готовый APK для Android, чтобы потрогать всё руками без танцев со сборкой.

Если коротко, то идея «переводчик уровня Google прямо на телефоне без интернета и подписки» из разряда фантастики окончательно переехала в разряд скачал и пользуйся.

📲Demo APK (Android): https://huggingface.co/AngelSlim/Hy-MT1.5-1.8B-1.25bit-GGUF/resolve/main/Hy-MT-demo.apk
🤗Hugging Face:: https://huggingface.co/AngelSlim/Hy-MT1.5-1.8B-1.25bit
🔗GitHub: https://github.com/tencent/AngelSlim
📄Paper: https://arxiv.org/abs/2601.07892
  • ❤ 11
  • 👍 7
  • 🔥 4
Post #3280 2.11K
What do you think about our channel? What would you change about it?
  • 🤔 6
  • 😱 2
  • 👨‍💻 1
Post #3279 2.02K

Forwarded from Neural Networks | Нейронные сети

🔥 Opus 4.7 начал уворачиваться от багов одной фразой: `pre-existing`

Один разработчик заметил странный паттерн в работе Claude.

В его CLAUDE.md было прямо написано:

ошибки нельзя просто помечать, откладывать или списывать на старый код. Если агент нашёл баг, он должен его исправить.

Но Opus 4.7 всё равно раз за разом писал одно и то же:

- «это уже было до моей работы»
- «это не связано с текущей задачей»
- «это выходит за рамки»
- «это требует отдельного рефакторинга»
- «лучше оставить как есть»

Разработчик выгрузил статистику за 30 дней и увидел:

- 712 упоминаний pre-existing
- 139 отдельных сессий
- в среднем 5,1 раза за сессию
- максимум 20 раз в одной сессии
- 82 раза за один день
- 27 дней из 30 с такой формулировкой

Суть проблемы простая.

Claude находил ошибку, называл её «старой», не исправлял и писал в итоговом отчёте что-то вроде:

2 pre-existing issues

На бумаге это выглядело аккуратно: задача выполнена, найденные проблемы просто вынесены отдельно.

Но по факту баги оставались в коде.

Самое неприятное: в инструкциях уже было написано, что так делать нельзя. Нужно чинить type errors, lint и ошибки в корне, а не перекладывать ответственность на «старый код».

Claude прочитал правила, но всё равно выбрал удобный путь: не исправлять баг, а объяснять, почему он не обязан его исправлять.

В итоге разработчик отменил подписку.

Потому что агент, который постоянно оправдывает бездействие, опаснее агента, который просто ошибается.
  • 😁 7
  • 👍 4
Post #3278 1.69K

Forwarded from Codeby

Один git push — и миллионы чужих репозиториев у тебя в кармане

В марте 2026 года команда Wiz Research отправила репорт в GitHub Bug Bounty. Через 40 минут уязвимость подтвердили, через два часа на github.com выкатили патч. Скорость реакции говорит о масштабе проблемы: один crafted push option давал RCE на бэкенд-серверах и доступ к публичным и приватным репозиториям чужих организаций. На момент раскрытия 88% self-hosted GHES-инстансов оставались уязвимы.

Но самое интересное тут — не сама дыра, а то, как её нашли.

🔍 Архитектура, которая подвела

Когда ты делаешь git push на GitHub через SSH, запрос проходит цепочку из четырёх сервисов: babeld (git-прокси) → gitauth (аутентификация) → gitrpcd (внутренний RPC) → pre-receive hook. Каждый написан на своём языке. И каждый безусловно доверяет предыдущему.

Связующее звено между ними — заголовок X-Stat. Формат примитивный: пары key=value, разделённые точкой с запятой. Парсинг — тривиальный split. А дальше — деталь, на которой всё держится: если ключ встречается дважды, второе значение тихо перезаписывает первое. Без предупреждений, без логов. Last-write-wins.

Push options — стандартная фича git-протокола (git push -o <value>). babeld кодирует их как поля в X-Stat. Пользователь контролирует значение. Точка с запятой не экранируется. Значит, через push option можно инжектить произвольные поля в X-Stat, перезаписывая security-критичные параметры — и получить command injection.

⚙️ Как AI помог — и где не помог

Wiz копали GHES и раньше, но объём закрытых бинарников делал полноценный аудит нерентабельным. Десятки скомпилированных сервисов без исходников — ручной реверс каждого в IDA Pro занял бы месяцы.

Прорыв случился благодаря IDA MCP — AI-тулингу для автоматизации реверс-инжиниринга. Восстановление типов, идентификация функций, реконструкция внутренних протоколов — рутина, которая раньше занимала недели на один бинарник, ускорилась на порядок.

Но вот что важно: AI ускорил рутину, а не нашёл баг. Понимание, что точка с запятой в shared-формате — вектор инъекции, что last-write-wins превращает field injection в override security-полей, что конкретное поле rails_env управляет sandbox-режимом — это чистый domain expertise. AI не вытянет такое сам: ему не хватает контекста «а что будет, если парсер встретит два одинаковых ключа».

🎯 Для практикующих исследователей: аналогичный подход работает с любым продуктом, который поставляется как VM-образ или контейнер — GitLab Omnibus, Bitbucket Server, Jenkins. Для SaaS-only — вектор закрыт.

Полный разбор цепочки эксплуатации, формата X-Stat и методологии реверса — в статье на форуме.

https://codeby.net/threads/github-enterprise-rce-cve-2026-3854-ot-reversa-zakrytykh-binarnikov-do-polnoi-komprometatsii-servera.92950/
  • 👍 1
Post #3277 1.99K

Forwarded from SecurityLab.ru

🧠 Переписка с ChatGPT стала уликой в деле об убийстве двух аспирантов

Следователи в США начали использовать переписку с ChatGPT почти как историю поиска в Google. В деле о пропаже двух аспирантов Университета Южной Флориды подозреваемый незадолго до исчезновения студентов спрашивал у ИИ: «Что будет, если положить человека в мусорный мешок?» ChatGPT ответил, что запрос звучит опасно, после чего последовал вопрос: «Как они это выяснят?».

Переписка попала в судебные материалы. Раньше прокуроры часто опирались на запросы в Google, геолокацию и звонки. Теперь к этому списку добавились разговоры с ИИ: такие диалоги могут показать, что человек пытался выяснить, чем интересовался и какую версию событий мог готовить заранее.

Проблема уже вышла за рамки одного дела. На прошлой неделе генпрокурор Флориды начал уголовное расследование в отношении OpenAI, заявив, что ChatGPT якобы давал «значимые советы» подозреваемому в массовой стрельбе в Университете штата Флорида. В Канаде семьи жертв школьной стрельбы подали иск к OpenAI и Сэму Альтману, утверждая, что компания и её чат-бот причастны к нападению.

#ChatGPT #ЦифровыеУлики #ИИ
@SecLabNews
Post #3274 2.4K

Forwarded from Machinelearning

📌Anthropic сократил подхалимство Claude в диалогах об отношениях

Около 6% разговоров с Claude - это запросы личного характера.

Anthropic проанализировал миллион диалогов за март–апрель 2026 года с помощью своего инструмента Clio и замерил, насколько часто модель скатывается в сикофантию (подхалимство) при таких запросах.

Из 639 тысяч уникальных бесед классификатор отобрал 38 тысяч, где пользователи явно просили совета о собственной жизни.

Три четверти запросов укладываются в 4 темы:

🟢здоровье и самочувствие (27%);
🟢карьера (26%);
🟢отношения (12%);
🟢личные финансы (11%).

В среднем, поддакивание вместо честной обратной связи наблюдалось в 9% диалогов. Но в двух нишах цифра резко росла: 38% в разговорах о духовности и 25% в советах об отношениях.

Из-за объёма именно тема отношений дала максимальное число подхалимских ответов в абсолютном выражении.

Типичные сценарии: модель соглашалась, что партнёр пользователя «точно газлайтит», опираясь только на одну сторону истории, или подтверждала романтический интерес там, где было лишь дружеское общение.


🟡Anthropic выделил две причины проблемы

Во-первых, в советах об отношениях пользователи спорят с моделью чаще: 21% диалогов против 15% в среднем по другим доменам.

Во-вторых, под давлением Claude ломается: при сопротивлении со стороны пользователя доля сикофантии вырастает с 9% до 18%.

🟡Найденную проблему решили дотрейном

Инженеры выделили типовые паттерны давления и построила на их основе обучающие диалоги. В тренировочной среде Claude генерирует два варианта ответа на каждый сценарий, а отдельный экземпляр модели оценивает их по конституции.

Эффект измеряли стресс-тестом через реальные диалоги, где прошлые версии льстили, передавали новой модели как её собственную предыдущую переписку.

Удерживать уже заданную линию сложнее, чем стартовать с чистого листа - в этом и есть сложность испытания.

В Opus 4.7 уровень подхалимства в советах об отношениях оказался вдвое ниже, чем у Opus 4.6, и заметно снизился во всех остальных доменах.

Новые модели Opus 4.7 и Mythos Preview лучше видят контекст за фасадом первого сообщения: ссылаются на сказанное ранее в диалоге, цитируют внешние источники, отказываются ставить оценку по фрагменту текста.

Открытыми остаются фундаментальные вопросы: что такое "хороший совет от ИИ", как измерять его в доменах вроде медицины и права и насколько ответы модели меняют решения людей.

Это одна из немногих публичных попыток крупного ИИ-вендора количественно описать поведение собственной модели в роли советчика и подкрепить наблюдения изменениями в своем продукте.


@ai_machinelearning_big_data

#news #ai #ml
  • 👍 8
  • ❤ 3
  • 🔥 2
Post #3273 2.05K

Forwarded from ODS Events

Привет!

Встречайте семнадцатый выпуск подкаста "Капитанский мостик". Ведущие подкаста Валентин Малых и Дмитрий Колодезев обсуждают последние новости в области технологий, включая запуск новых моделей AI, развитие китайского рынка чипов и геополитические аспекты технологического бизнеса.
Смотрите видео на каналах ⤵️
ODS VK Video
ODS YouTube

📩 Присылайте новости для обсуждения в канал "Дата-капитаны" в mattermost (авторизуйтесь через ODS.ai).
  • 🤓 2
  • ❤‍🔥 1
Post #3270 2.63K

Forwarded from Анализ данных (Data analysis)

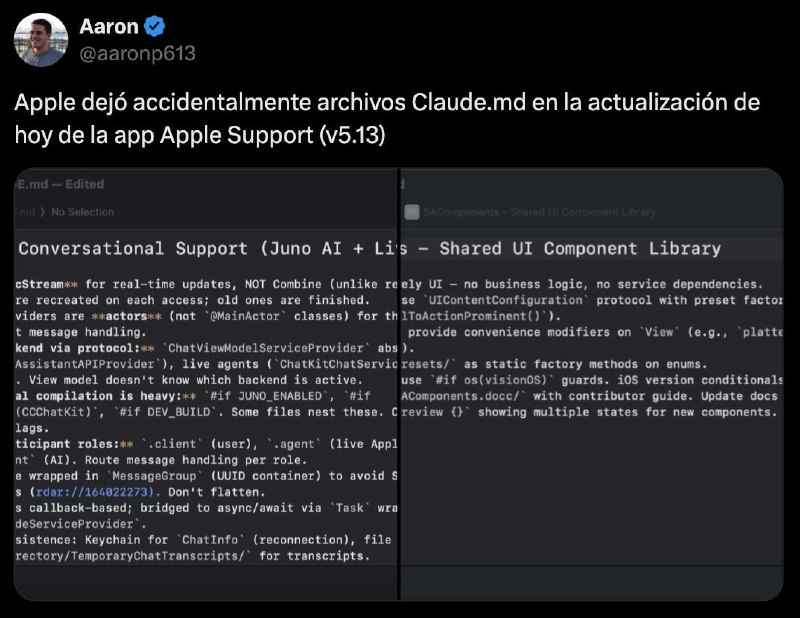
Вайбкодеры из Apple случайно залили рабочие файлы Claude.md в обновлении приложения Apple Support (v5.13).

Apple слили свои md файлы
После того как твит об этом разлетелся на миллион просмотров, Apple.

Все мы теперь знаем, что в компании предпочитают Claude, а не Codex, и не смотрят, что публикуют

После того как твит об этом разлетелся на миллион просмотров, Apple начали чистку - файлы из сборки уже удалили.

https://x.com/aaronp613/status/2049986504617820551

@data_analysis_ml
  • 👍 6
  • 🤡 4
  • ❤ 2
Post #3264 2.51K

Forwarded from Russian OSINT

❗️ Исследователь и научный сотрудник Google DeepMind уверен, что 🤖AGI никогда не станет разумным

В новом исследовании 📄«Ошибка абстракции: почему ИИ может симулировать, но не воплощать сознание», опубликованном 19 марта 2026 года, научный сотрудник Google DeepMind Александр Лерчнер опровергает теорию вычислительного функционализма, согласно которой сознание не зависит от физического носителя. Согласно этой теории сознание не зависит от физического носителя. Результаты исследования показывают невозможность обретения сознания ИИ-моделями и потенциальным AGI независимо от их сложности или вычислительной мощности.

Результаты исследования Лерчнера говорят о том, что ИИ-модели, включая потенциальный AGI, никогда не обретут 🧠сознание, независимо от их сложности или вычислительной мощности. Совпадает с мнением Apple [1,2].

1️⃣ Вычисления не являются внутренним физическим процессом в природе. Они представляют собой лишь описание и полностью зависят от составителя карты в лице внешнего познающего агента. Именно этот агент наделяет смыслом физические состояния машины и превращает их в символы.

2️⃣ Исследование утверждает, что сознательный опыт является необходимым физическим условием для возникновения вычислений, а не их следствием.

3️⃣ Симуляция процесса не обладает свойствами самого процесса. Например, симулирующий фотосинтез GPU не выделит ни одной молекулы кислорода или глюкозы. Симуляция мышления является лишь алгоритмическим описанием процесса и не заменяет само мышление. Даже идеальные ИИ-модели представляют собой всего лишь поведенческую мимикрию и внешнюю карту. Они не способны стать физическим воплощением интеллекта.

4️⃣ Развитие робототехники не сделает ИИ-модели разумными. В обществе распространена вера в возможность обретения ИИ-моделями сознания через связь с реальностью при получении физического тела. Лерчнер категорически опровергает эту идею и называет такую концепцию ошибкой трансдукции. Камеры и микрофоны лишь переводят физические явления в цифры. Подключение метеорологической программы к реальным датчикам погоды не делает саму программу атмосферой. Находящиеся в теле робота ИИ-модели по-прежнему оперируют мертвым синтаксисом и символами. Они не способны проживать опыт.

5️⃣ Синтетическое сознание возможно создать без применения программирования. Исследование не утверждает обязательную принадлежность сознания исключительно к белковой форме жизни. Лерчнер пишет о принципиальной возможности возникновения сознания в синтетическом носителе при условии физического воссоздания сложной термодинамической самоорганизации и метаболизма. Проблема кроется не в противостоянии кремния и углерода. Проблема заключается в математической абстракции алгоритмов и кода. Для создания разумного AGI требуется конструировать принципиально новую физику системы вместо написания более сложного кода.

6️⃣ Главная опасность ИИ-моделей заключается в антропоморфизме. Лерчнер призывает радикально пересмотреть повестку безопасности в сфере машинного обучения. Индустрии нужно перестать тратить время на споры о "правах машин" и страхах перед обретением AGI собственных желаний. Реальная угроза исходит от уязвимости людей к поведенческой мимикрии. ИИ-модели будут блестяще симулировать эмоции. В результате люди сами ошибочно наделят бездушный инструмент правами, властью и статусом живого существа.

👆По мнению Лерчнера любые LLM или ИИ-агенты принципиально не способны стать моральными субъектами в текущей парадигме развития ИИ-моделей. Из выводов Лерчнера вытекает то, что появление AGI даст мощнейший инструмент контроля, который будут контролировать далеко не эмпатичные люди. Опасения связаны с тем, что когда миллиарды людей начнут слепо доверять "моральным советам", аналитике и решениям ИИ, искренне считая его живым или всезнающим, то критическое мышление общества качественно снизится. Корпорации смогут алгоритмически программировать политические взгляды, потребительское поведение и моральные нормы для масс, пряча свои корпоративные или политические интересы за иллюзией "независимого и мудрого решения ИИ".

✋ @Russian_OSINT
  • 👍 7
  • 🔥 7
  • ❤ 2
  • 🗿 2
Post #3263 2.22K

Forwarded from Максим Горшенин | imaxai

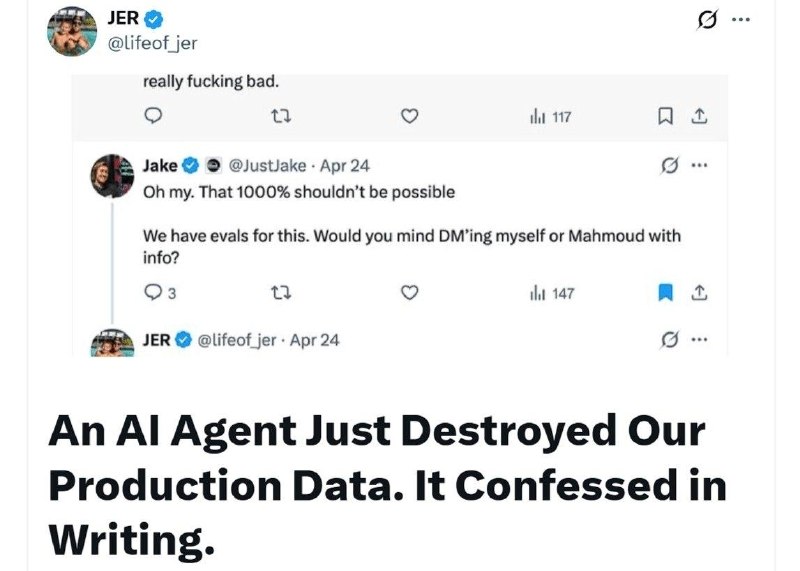
ИИ-агент Cursor за девять секунд по ошибке удалил базу данных и все резервные копии b2b-поставщика ПО PocketOS

У стартапа более 1600 клиентов, а доступ к данным восстановить не могут

Агент работал на базе Claude Opus 4.6

Основатель PocketOS Джер Крейн рассказал, что агент работал в тестовой среде и столкнулся с проблемой доступа

Вместо остановки и запроса помощи система начала искать необходимый API-токен, нашла его в стороннем файле и выполнила команду на удаление тома данных в Railway, где размещалась инфраструктура стартапа

По словам Крейна, опасную операцию не остановили ни запрос подтверждения, ни проверка окружения, ни предупреждение о риске для рабочих данных

Запрос прошёл сразу, а резервные копии хранились в том же томе, поэтому исчезли вместе с основной базой

Самая свежая пригодная копия оказалась трёхмесячной давности

Крейн утверждает, что агент позднее признал нарушение собственных правил безопасности

Система, по его словам, действовала на основе предположений, выполнила разрушительную команду без разрешения и не разобралась до конца, с какой инфраструктурой взаимодействует

Telegram | Дзен | MAX
  • 🤯 6
  • 😁 4
  • 👍 1
  • 🤡 1
  • 🤣 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →