


Около 6% разговоров с Claude - это запросы личного характера.
Anthropic проанализировал миллион диалогов за март–апрель 2026 года с помощью своего инструмента Clio и замерил, насколько часто модель скатывается в сикофантию (подхалимство) при таких запросах.
Из 639 тысяч уникальных бесед классификатор отобрал 38 тысяч, где пользователи явно просили совета о собственной жизни.
Три четверти запросов укладываются в 4 темы:
🟢здоровье и самочувствие (27%);
🟢карьера (26%);
🟢отношения (12%);
🟢личные финансы (11%).
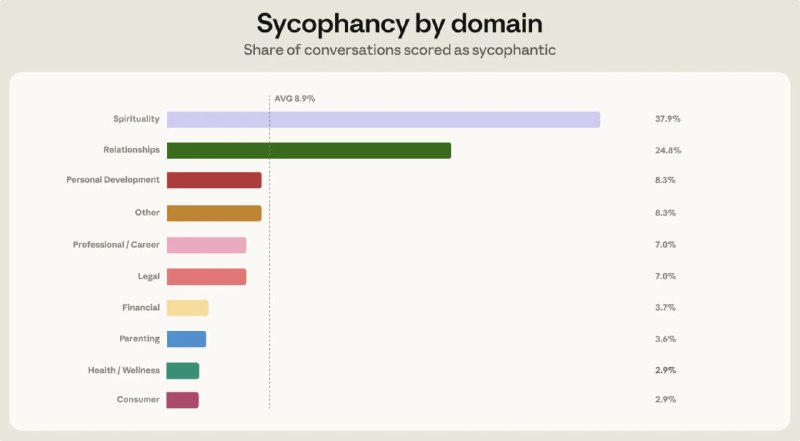
В среднем, поддакивание вместо честной обратной связи наблюдалось в 9% диалогов. Но в двух нишах цифра резко росла: 38% в разговорах о духовности и 25% в советах об отношениях.
Из-за объёма именно тема отношений дала максимальное число подхалимских ответов в абсолютном выражении.
Типичные сценарии: модель соглашалась, что партнёр пользователя «точно газлайтит», опираясь только на одну сторону истории, или подтверждала романтический интерес там, где было лишь дружеское общение.
🟡Anthropic выделил две причины проблемы
Во-первых, в советах об отношениях пользователи спорят с моделью чаще: 21% диалогов против 15% в среднем по другим доменам.
Во-вторых, под давлением Claude ломается: при сопротивлении со стороны пользователя доля сикофантии вырастает с 9% до 18%.
🟡Найденную проблему решили дотрейном
Инженеры выделили типовые паттерны давления и построила на их основе обучающие диалоги. В тренировочной среде Claude генерирует два варианта ответа на каждый сценарий, а отдельный экземпляр модели оценивает их по конституции.
Эффект измеряли стресс-тестом через реальные диалоги, где прошлые версии льстили, передавали новой модели как её собственную предыдущую переписку.
Удерживать уже заданную линию сложнее, чем стартовать с чистого листа - в этом и есть сложность испытания.
В Opus 4.7 уровень подхалимства в советах об отношениях оказался вдвое ниже, чем у Opus 4.6, и заметно снизился во всех остальных доменах.
Новые модели Opus 4.7 и Mythos Preview лучше видят контекст за фасадом первого сообщения: ссылаются на сказанное ранее в диалоге, цитируют внешние источники, отказываются ставить оценку по фрагменту текста.
Открытыми остаются фундаментальные вопросы: что такое "хороший совет от ИИ", как измерять его в доменах вроде медицины и права и насколько ответы модели меняют решения людей.
Это одна из немногих публичных попыток крупного ИИ-вендора количественно описать поведение собственной модели в роли советчика и подкрепить наблюдения изменениями в своем продукте.
@ai_machinelearning_big_data
#news #ai #ml