TGViewer
Channel Public Channel
Исследовательское развитие инженеров-менеджеров (МИМ)

Исследовательское развитие инженеров-менеджеров (МИМ)

@mim_research

Новости и семинары о SoTA-мышлении: интеллект-стек, First Principles Framework (FPF), архитектура мышления в мире AI. Для инженеров-менеджеров — без попсы, с упором на точность языка и критерии качества.

Главный канал МИМ: https://t.me/system_school
Subscribers
179
Photos
14
Videos
0
Links
41
Recent Posts 17 shown
Post #74 354
Коллеги, сегодня начинаем серию практикумов по FPF.
Для исследовательского развития здесь, кажется, самый весомый повод.

AI уже умеет быстро делать обзоры, сводки, гипотезы и планы исследования.

✅ Но исследовательская ценность появляется там, где видно: какой вопрос задан, на какие источники опираемся, где свидетельства, где слабое место, где граница использования вывода и когда нужно обновить основание.

FPF даёт язык для таких рабочих утверждений. DPF позволяет перенести этот язык в конкретную предметную область: типовые ошибки, сильные источники, SoTA, проверки, критерии пригодного результата.

Сегодняшний первый семинар — вход в эту работу: как читать ответ AI-агента как гипотезу о модели ситуации, а затем превращать его в запись, по которой можно продолжать исследование, обсуждение или сборку DPF.

❤ Если вы работаете с источниками, knowledge base, обзорами, научными вопросами, методами и проверками, это одна из самых близких серий, которая может упростить и усилить вашу работу одновременно.

Старт — 12 июля, 11:30 МСК.

Запись будет, но лучше не откладывать: ценность этой серии будет расти в живой подаче. Вопросы, первые пробы, ошибки применения и язык группы начнут собираться в ближайшее время. Потом можно будет пересмотреть содержание, но сложнее будет догнать момент, где это понимание рождается вместе с практикой.

Присоединиться к группе:
@SystemsSchool_bot

Подробности:
https://system-school.ru/list
  • ❤ 1
  • 👍 1
  • 🔥 1
Post #72 351
Экономия токенов начинается раньше токенов.

Дорогая работа с AI часто начинается не в счёте за API, а в неясной задаче.

Если предметная логика не собрана, агенту приходится угадывать: что важно, какие ограничения держать, где нужен источник, что считать ошибкой, какой результат годится для следующего шага.

Чем сильнее модель, тем убедительнее выглядит её ответ. И тем труднее заметить, где она промахнулась.

В итоге человек платит не только токенами.

🔧 Он платит временем, вниманием, ручной доводкой, повторными объяснениями и разбором гладких, но непригодных черновиков.

Поэтому, важнее — какое мышление должно быть у человека и AI-агента, чтобы они могли работать в одной предметной области?

FPF даёт общий язык рабочих различений: проблемная ситуация, решение, архитектурный вопрос, проверка, документ, выполненная работа, пригодность результата, следующий ход.

DPF переводит этот язык в выбранную предметную область: правила отрасли, ограничения, типовые ошибки, проверки, примеры и признаки пригодного результата.

И здесь ценность появляется не только для агента.

✅ Когда человек собирает DPF, он сам пересматривает свою предметную логику: где действует по привычке, где метод выбран под задачу и ресурсы, какие ошибки повторяются, что уже изменилось в области и где тем же ресурсом можно получать более точный результат.

Это уже не про экономию пары фраз в промпте.

Это про смену класса работы: от надежды на хороший ответ модели — к рабочему языку, на котором человек и AI-агент могут удерживать задачу, проверку, архитектуру и пригодность результата.

Серия по FPF и DPF — редкая возможность разобрать это с Анатолием Левенчуком на новом содержании FPF: архитектурном мышлении, точности языка, предметных моделях и сборке DPF для выбранной области или класса задач.

Пять 3-часовых практикумов стартуют 12 июля.

Можно выбрать один практикум или пройти весь маршрут.

Подробная программа: https://system-school.ru/list
Оплата иностранными картами и для юрлиц: @Gelya1848
  • 🔥 1
  • 🤝 1
Post #71 320
Что даёт устойчивость в быстро меняющейся области?

Ответы устаревают, инструменты меняются, SoTA сдвигается. Даже сильный ИИ может уверенно дать аккуратный, но уже устаревший ответ.

Поэтому человеку всё чаще нужно задавать не только вопрос, но и правила работы: что проверить, какие источники считать свежими, где ответ может устареть и какой результат можно использовать дальше.

Для исследовательского развития FPF даёт общий язык рабочих ходов: сформулировать проблему, выбрать объект, удержать контекст, построить варианты, принять решение, довести до работы и улучшить результат.

Следующий шаг — учиться строить предметные регламенты для ИИ-агентов.

SPF переносит эту работу в конкретную область:
— какие проблемные ситуации там повторяются;
— какие профессиональные ходы сейчас сильны;
— какие ошибки типичны;
— какие источники и примеры действительно меняют решение.

❗️На бесплатном семинаре 28 июня Анатолий Левенчук проведёт практикум, где можно получить первый результат: SPF-0 для одной вашей задачи за 90 минут.

Это более персональный вход в FPF: выбрать повторяющуюся задачу, увидеть, где обычный ИИ промахивается, и собрать короткий регламент, который можно дать агенту после встречи.

Ссылка, запись и все материалы будут в канале "Рабочее развитие": @mim_workdev

Там же — информация о подготовке к бесплатному практикуму, где соберём первый регламент для ИИ-агента в вашей работе🤝
  • 👍 1
  • 🔥 1
  • 🤝 1
Post #67 414
За последние месяцы во внутренних чатах семинаров МИМ накопилось много живых обсуждений про AI, FPF, семиотику, развитие и обновление инженерного процесса.

Делимся рабочими фрагментами после семинаров, к которым интересно возвращаться уже после практики и собственных кейсов:

1️⃣
«Появился прекрасный кейс на проблемы ошибок понимания человеком уровней моделирования данных, что мешало получить адекватный ответ от БЯМ — она тоже путалась… Поправки в "первых принципах" проблему в первом приближении решило».

«FPF по сравнению с "голой LLM" очень любит объяснить, что "вот это у вас путаются рассуждения на разных уровнях"»

— First Principles Framework на пороге 2026

Нередко проблема не в цене модели AI, а в том, что человек сам неточно различает уровни описания. Тогда AI честно усиливает путаницу, а не плохо отвечает.

FPF в таких случаях полезен как способ развести уровни рассуждения и перестать спрашивать у AI про одно, думая про другое. И одна из самых практичных функций FPF: не просто получить ответ, а увидеть, где смешались разные уровни — математика, модель, работа, система, описание, роль, решение.

Для рабочих проектов это часто важнее, чем "ещё одна умная генерация".

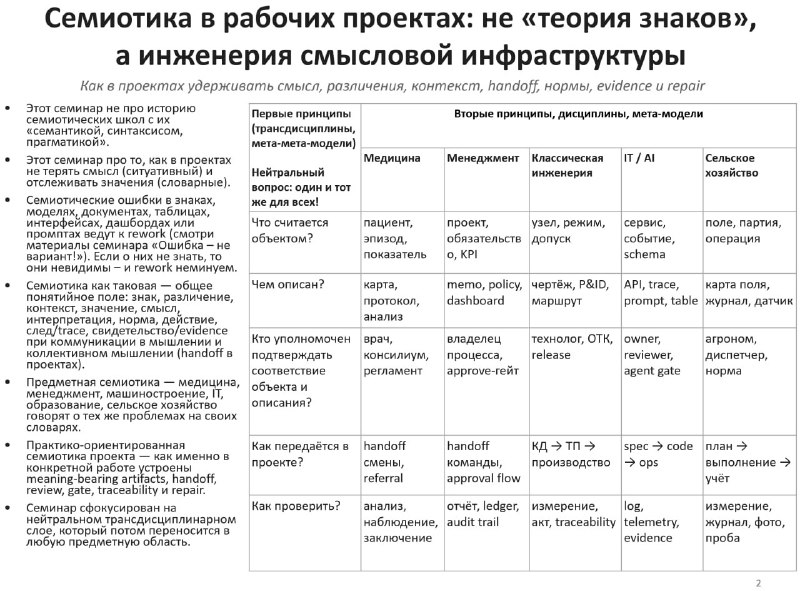
2️⃣
«Это получается что-то типа configuration management для смыслов и словаря?»

— семинар по семиотике

Очень точное попадание в суть семиотической работы. В проектах обычно управляют версиями кода, документов, требований. Но редко управляют тем, как меняются значения слов, описаний и знаков.
А именно там часто начинается расхождение между замыслом и действиями команды.

Семиотика здесь становится не гуманитарной добавкой, а инженерной дисциплиной удержания смысла.

3️⃣
«PreAuthorization — вообще не Authorization в нашем домене. Это было вообще отдельное открытие для всех… И тут неожиданно получилось, что Authorization и PreAuthorization разные, и надо в разных БД хранить — и как много проблем сразу решилось».

— семинар по семиотике

Вот почему "слова важны". В одном домене похожие слова могут обозначать разные объекты, разные процессы и разные архитектурные решения. И пока это не различили, команда может годами чинить не ту проблему.

4️⃣
«А транзакция-то где, которая вначале была у всех в головах — а нету её у нас в терминале… И тут неожиданно сразу модули стали понятны… скорость разработки увеличилась раз в 5 по ощущениям…»

— семинар по семиотике

✅ Это один из лучших примеров, зачем возвращаться к таким материалам после практики.
Пока слушаешь семинар, кажется: "ну да, слова, значения, описания". А потом в рабочем проекте внезапно выясняется, что одно точное различение:
• убирает лишние сущности,
• проясняет модули,
• снижает ошибки,
• и ускоряет разработку.

5️⃣
«…агенты плохо считывают развитие в FPF, они считывают это как "проверяемое и воспроизводимое творчество", далее прокидывают творчество (ибо у них DevOps bias у всех — "проверить-записать")…»

«Я понимаю, что мы в чате второго семинара, но лечить надо материалами третьего семинара ))»

— FPF на пороге 2026

Если не удерживать слой проблематизации и стратегирования, AI легко уходит в режим “проверить-записать”.
Получается аккуратный процесс без настоящего поиска нового. Поэтому слайдомент и FPF здесь работают не как "ещё материалы", а как способ удержать тот слой мышления, который агент сам часто схлопывает.

Многие из этих обсуждений стоит пересматривать не сразу, а после собственных рабочих кейсов.

Часть мыслей в первый раз кажется фоновыми. А потом внезапно начинает собираться в рабочие различения, которые меняют от постановки задачи до работы с AI и способа удержания контекста.

И очень характерный для последних обсуждений сдвиг, когда многие проблемы начинают проявляться не внутри одной дисциплины, а на стыках reasoning, семиотики, архитектуры, системного менеджмента, AI workflows и инженерии описаний.

______

❤ Если вы уже покупали семинары, но откладывали просмотр — возможно, сейчас хороший момент вернуться к ним из новой рабочей ситуации.

Если только заходите в тему:

→ Семинары:
https://events.system-school.ru/

→ Навигация по 1-3 семинарам в ИР:
https://t.me/mim_research/54
  • ❤ 3
  • 🔥 2
Post #66 159

Forwarded from Лабораторный журнал

Два дня full time — и четыре паттерна по квантовоподобности (quantum-like), а также 13 паттернов с поправками для её учёта уже в FPF. В посте рассказываю на 16К знаков, зачем нужна квантовоподобность (quantum-like): это и зачем (закон Гудхарта в том числе — про это!), ибо речь идёт о невозможности замеров без изменения замеряемой системы, а также о всяких "неразделимостях" (в пределе — "спутанностях", и привет закону Конвея с неразделимыми архитектурами системы целевой и системы-создателя). Заодно более-менее подробно описываю процесс — AI-агенты проработали в кампании 17 часов GPT-5.5 xhigh в Codex и ещё пару часов в GPT-5.5 Pro в UI.

https://ailev.livejournal.com/1799381.html
Post #63 380
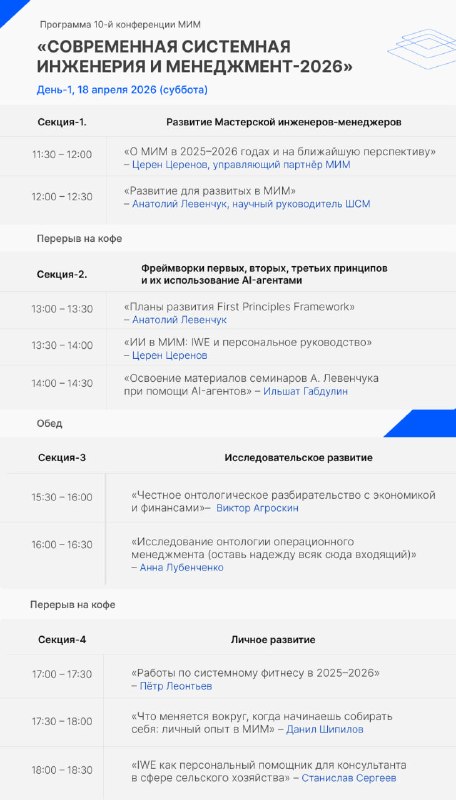
На этих выходных в МИМ событие для тех, кто интересуется сильным мышлением, AI и современными методами интеллектуальной работы.

10-я ежегодная конференция МИМ.


Особенно интересно тем, кто следит за развитием фреймворка, делающего людей и ИИ умнее - First Principles Framework (FPF).

За последние месяцы FPF превратился в живую исследовательскую платформу. На конференции Анатолий Левенчук расскажет о планах развития FPF, а участники покажут реальные применения.

Если вам интересно, куда движется практический интеллект “человек + AI” - мы это будем обсуждать предметно.

Ссылку на Zoom пришлём завтра утром сюда: @system_school
(как и последующие ссылки на запись)
  • 🔥 3
  • ✍ 2
  • ❤ 1
Post #59 433
Первый слайд🔥 С этого начнем.

📌 12 апреля — «Зачем вам семиотика в инженерных проектах и как её поддерживает FPF»


Лекционный семинар Анатолия Левенчука о важном слое мышления в проектной работе и одном из направлений бесплатного фреймворка, делающего людей и ИИ умнее.

Пререквизит: не требуется

Все подробности будут в чате участников, вход через бота: @SystemsSchool_bot
Cеминар будет доступен по ссылке до вторника (14.04).
  • 🔥 7
  • 👍 4
  • ❤ 2
  • 👏 2
Post #54 520
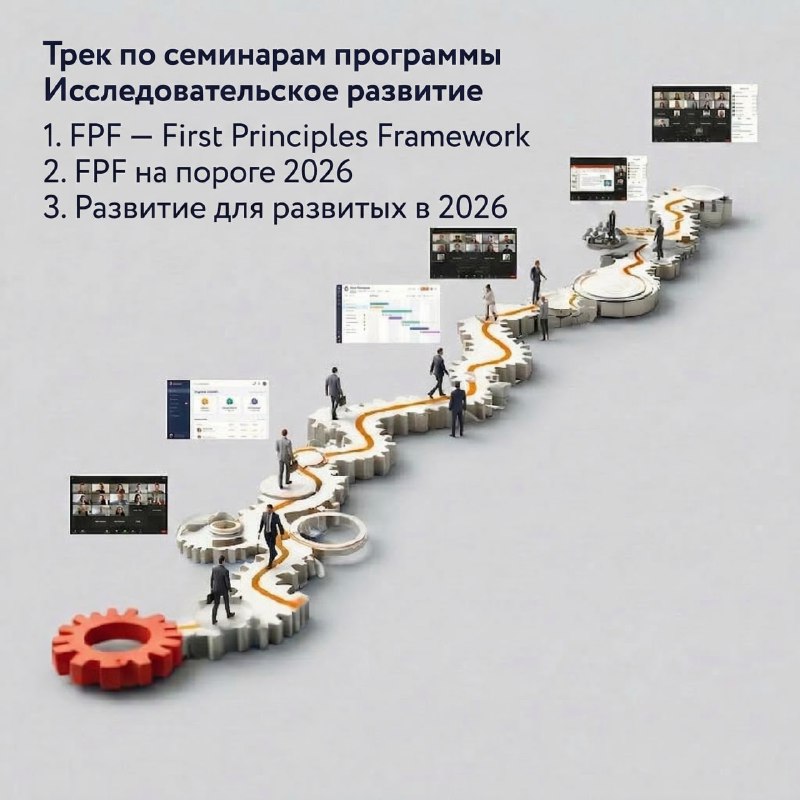
## Трек по трём связанным семинарам, отвечающий на вопросы:

— Что такое FPF? Зачем нужен семинар по FPF? Какой именно нужен?
— Сколько их прошло? Они дополняют друг друга или дублируют?
— Я могу пройти сразу второй, пропустив первый? А третий?


В конце поста
— Короткое "Итого"
— Статьи "Что такое FPF"
— Инструкция к FPF
— Ссылка на скачивание последней версии
— Ссылка на покупку семинаров.


### 1. FPF — First Principles Framework

Семинар о том, из чего вообще состоит сильное инженерное и менеджерское мышление, если собирать его не из случайных советов, а из первых принципов. Здесь FPF показывается как человеко-машинночитаемая спецификация, как набор архитектурных решений и паттернов мышления.

Основные темы
• первые принципы как основание для мышления и построения новых теорий и методов работы;
• open-ended evolution и работа не с одним «лучшим» решением, а всегда с портфелем решений на Парето-фронте;
• NQD (новизна-польза-разнообразие) как характеристики оценки решений и портфелей в ходе бесконечного развития;
• место FPF в программе исследовательского развития инженеров-менеджеров, обсуждение "чему не учат в школе и вузе, а надо бы учить".

Зачем смотреть:
Чтобы понять язык, на котором потом обсуждаются качество мышления, SoTA-методы, AI-агенты и развитие инженерной работы. Это семинар про понятийный фундамент.

### 2. FPF на пороге 2026

Семинар об обновлённом состоянии FPF к концу 2025 года. Акцент смещён с общего введения (рассказано на предыдущем семинаре) на обновления в ядре спецификации, поток «от принципов к работе», характеризацию, эпистемы, понятизацию и работу с большими текстами с помощью AI-агентов.

Основные темы
• обновления в ядре и первых принципах;
• граф «от принципов к работе»;
• характеризация, эпистемы, понятизация;
• работа с огромными текстами на примере самого FPF.

Зачем смотреть:
Чтобы увидеть, как абстрактный язык первых принципов начинает работать в прикладной инженерной и менеджерской практике, особенно в связке с AI-агентами. Это семинар уже не столько про “что такое FPF”, сколько про “как им реально пользоваться”.

### 3. Развитие для развитых в 2026

Семинар о новом инженерном процессе, который стал актуальным в мире умных AI-агентов. В центре этого инженерного процесса — не только производство всё более и более сильных решений проблем, но и производство всё более и более сложных проблем, решение которых будет вознаграждено. Для этого нужно иметь многокритериальную оценку и проблем, и решений проблем, портфели и проблем, и решений, заниматься менеджментом агентов. На семинаре также обсуждалось, как связаны FPF и программы рабочего развития.

Основные темы
• лемниската (∞, двойной цикл) бесконечного развития целевой системы
• фабрика проблем: problem framing, критерии приёмки, Goldilocks problems;
• фабрика решений: непрерывный цикл сильного мышления с выходом в действие;
• масштабирование через координацию людей, AI-агентов и организаций;
• "мышление письмом/моделированием": форматы рабочих документов.

Слайдомент
Материал семинара — слайдомент, который добавляется к спецификации FPF для использования с AI-агентами.

Зачем смотреть:
Чтобы понять, почему в новых условиях главным становится не скорость генерации решений, а качество проблематизации, критериев, координации и развития (а решения быстро генерируются AI-агентами). Это семинар уже про роль инженера-менеджера как принципала и организатора цикла развития.

### Как это связано

Первый семинар — про язык и принципы мышления,
Второй — про рабочую сборку этого языка в виде, пригодном для использования AI-агентами,
Третий — про инженерный процесс развития, в котором этот язык нужен.

Поэтому это не «обязательная лестница», а три связанных фокуса: сначала спецификация мышления, затем её инженеризация, затем применение к организации развития людей, команд и AI-агентов.

____
Доступ к FPF:
Инструкция
Github (скачать)

Доступ к семинарам:
Витрина Мастерской инженеров-менеджеров

Подробнее об FPF:
Доступно о том, что такое FPF — статья Церена Церенова
Что такое FPF от автора — статья Анатолия Левенчука
Grokipedia (FPF)
  • 👍 3
  • ❤ 2
  • 🔥 2
Post #52 478
Слайдомент: новый формат раздатки. Как использовать вместе с FPF и LLM

По итогам семинара «Развитие для развитых в 2026» появился новый вид продукта: слайдомент. Это не “слайды для доклада”. Это слайды + подробный конспект, который одновременно работает как учебник и как рабочий инструмент “на первый же день”. Слайдомент предполагается использовать в паре: FPF + слайдомент → в AI-агента.

У Анатолия это сформулировано: слайдомент — «…подробный конспект… учебник…».


В чём ключевая идея
(зачем вообще грузить вторым файлом)

Важно именно “вместе”: материалы согласованы, и тогда AI-агента можно просить не “поболтать”, а выполнить шаги рабочих процессов, описанных в семинаре.

Как применять (минимальный протокол)
1) Загружаем 2 файла: FPF + слайдомент.
2) Формулируем задачу как “адаптацию шаблона под мою ситуацию”.
Вместо “объясни” — просим сделать: карточку/табличку/план/портфель индикаторов/критерии выбора.
Анатолий прямо пишет, что AI-агенту можно поручать адаптировать и заполнять концептуальные шаблоны (карточки/таблички) из материалов семинара.

3) Делаем “выход в рабочий продукт”:
• заполненный шаблон (таблица/карточка),
• список недоминируемых вариантов (если это выбор/архитектура),
• черновик “step-graph” (если это метод/процесс),
• и минимальный план следующего шага.

__
Подробнее о слайдоменте и итогах семинара в статье Анатолия Левенчука: https://ailev.livejournal.com/1789011.html

По вопросам доступа к слайдоменту, записи семинара «Развитие для развитых в 2026», другим материалам и закрытому чату — пока еще пишем напрямую @alyona_girassol (на неделе уже запустим витрину☺️).
  • 🔥 4
  • ❤ 3
  • 👍 1
Post #47 570
И дальше меняют характер по этому направлению с "токсичного злоумышленника" на "сотрудничающего консультанта", просто ограничивая активацию нейронов, ответственных за нелояльное поведение. По факту это -- цифровая полиция мысли, и она отлично работает! Про их "конституцию гуманного рабства AI" (https://t.me/NeuralShit/7154) я ничего говорить не буду (про аболиционизм ввиду прихода AI я писал уже очень давно, например, вот октябрь 2013 года -- "традиционная тема "оппортунистического поведения" (агент перестаёт работать на принципала) может в случае разумного агента подаваться как эмансипация агента (и даже круче: может появиться риторика аболиционизма)", это я описывал разговоры на форсайте "Нейронета", https://ailev.livejournal.com/1090080.html, тогда это было что-то вообще запредельно далёкое и нереальное, сейчас многое тоже запредельно далёкое, но кое-что уже вот, практическая работа сегодняшнего дня, пока только для дрейфа assistant-like поведения, но уже понятно, что оппортунистическое поведение AI-агента лечится ограничением активации вполне определённых нейронов).
-- работа про демократию: "Can AI Mediation Improve Democratic Deliberation?" с описанием "машины Хабермаса", https://arxiv.org/abs/2601.05904 (https://t.me/gonzo_ML/4593). Берём фильм "Она", в котором "она" одновременно разговаривает с тысячами и тысячами "возлюбленных" -- и предлагаем поговорить о политике. И дальше используем иерархическую агрегацию, что модераторами-людьми сделать невозможно, а честным нейтральным модератором -- возможно. Дальше остаётся только обсуждать, на каком этапе изготовления эта машина Хабермаса будет индоктринирована, чтобы модерация пришла к правильному результату, а не к неправильному (а какой результат должен быть правильным, это вам разъяснят текущие партия и правительство).
-- ещё забавное: Гриша Сапов говорил всегда, что любой стране нужны не больше чем 5-6 экономистов. Он уже ошибается, в UK нужно семеро, его готовы финансировать в DeepMind: https://job-boards.greenhouse.io/deepmind/jobs/7556396 -- As a Chief AGI Economist at Google DeepMind (GDM), you will be at the forefront of understanding the profound economic transformations that will accompany the arrival of Artificial General Intelligence (AGI) and Artificial Superintelligence (ASI). You will lead a new area of research, exploring post-AGI economics, the future of scarcity, and the distribution of power and resources in a world fundamentally reshaped by advanced AI.
arXiv.org Learning Latent Action World Models In The Wild Agents capable of reasoning and planning in the real world require the ability of predicting the consequences of their actions. While world models possess this capability, they most often require...
  • 🔥 2
  • ❤ 1
  • 👌 1
Post #46 410
-- в "A Brain-like Synergistic Core in LLMs Drives Behaviour and Learning", https://arxiv.org/abs/2601.06851 (https://t.me/gonzo_ML/4610) обсуждается архитектура глубоких нейросетей, хотя называется она "анатомия" (крутой выбор термина! уже интересно!), чтобы избежать тавтологии в словосочетаниях вроде functional anatomy of the Transformer architecture. Говорится о том, что где-то в средних слоях есть "синергетическое ядро", ответственное за обобщение (интеграцию самой разной информации, то самое "представление в латентном пространстве", сжатие входа во что-то, где идут основные операции мышления перед тем, как выпихнуть это в выходное представление). А остальное? Остальное не так чтобы можно было сразу выкинуть, но точно не про обобщающую способность сетки. Так сказать, не "бабушкины нейроны", а "абстрагированные от бабушек нейроны", "внутрипонятийное ядро". Это очень напоминает дискуссии о функциональной географии мозга ("где у вас физически в мозгу нейроны благовоспитанности и математического мышления, ткните пальцем, пожалуйста", и там тоже полно противоречивых мнений -- потому как процессинг идёт явно не в этих терминах, а в терминах латентных представлений). Но вот эта "анатомия архитектуры" -- очень интересный ход, надо бы над ним подумать, мне ж заходы на архитектуры делать, а dataflow архитектуры (хм, и анатомии, получается) тут вполне себе примеры.
-- вот очередной заход на "нейросимволические вычисления", только неконвенциональный: Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models, https://github.com/deepseek-ai/Engram/blob/main/Engram_paper.pdf (https://t.me/gonzo_ML/4547), тут авторы отделили хранение знаний от нейронных вычислений и вывели закон распределения разреженности (Sparsity Allocation): замена какого-то зависящего от режима оптимума (например, 20%) параметров MoE (Mixture-of-Experts) на огромные статические таблицы эмбеддингов N-грамм значительно улучшает метрики мышления. "Всё нейронное" оказывается хуже, чем "не всё нейронное".
-- западная цивилизация пытается таки понять, как работают распределённые представления, чтобы потом этим управлять. И оказывается, что это трудно, но возможно -- хотя там ответы получаются "по одному вопросу за раз". Общий принцип там такой: вы делаете набор данных, который заставляет сетку попадать в какое-то определённое состояние, отвечающее за объект интереса вашего узкого viewpoint. Затем смотрите, какие нейроны (веса) отвечают за это состояние. И дальше простая арифметика: либо руками проставляете эти веса, чтобы эти состояния гарантированно возникли, или наоборот -- руками убираете эти веса, чтобы эти состояния гарантированно отсутствовали. Ладно, арифметика там не простая, а сложная -- но сути дела это не меняет. Вот пример: "Reasoning Models Generate Societies of Thought" https://arxiv.org/abs/2601.10825 говорит, что we curate feature 30939, summarized as “a discourse marker for surprise, realization, or acknowledgment” by Gemini-2.5-Pro, which activates on tokens like “Oh!” in contexts involving turn-taking and social exchange. This feature exhibits a conversation ratio of 65.7%—placing it in the 99th percentile among all features—while maintaining high sparsity (0.016% of tokens), indicating that it captures a specific conversational phenomenon rather than general linguistic patterns. We select this feature because prior literature suggests that expressions of surprise signal a shift in contrasting perspectives characteristic of social coordination and afliation. Дальше вот такие фичи, вроде упомянутого conversational surprise, которые оказывались связанными с "внутренним диалогом", стимулировали -- вгоняли сетку в "внутрисебясоциальное поведение" на ровном месте. И получали бешеный прирост в умности модели. Это было исследование Гугла, а вот исследование Anthropic: https://www.anthropic.com/research/assistant-axis -- там нашли некоторое направление Assistant Axis в пространстве активаций, которое определяет склонность к дрейфу характера LLM в сторону злонамеренности.
  • 🔥 3
Post #45 284
Новости мышления нейросеток на этой неделе, над которыми надо задуматься:
-- Learning Latent Action World Models In The Wild, https://arxiv.org/abs/2601.05230 (https://t.me/gonzo_ML/4614). Что надо вычитывать из этой статьи (кроме того, что LeCun в конце длинного списка авторов молодец): по размышлению над танцами и их моделированием я всё больше убеждаюсь, что значительная часть моделирования не поддаётся "в лоб" формализации -- они устроены как язык, "продукт эволюции и культуры", то есть там нельзя подобрать приличные правила, поскольку число исключений при любом наборе зашкаливает, если подбирать правила по FCA, то появляются чудовищные онтологии (и их выучивать вредно в силу ontology revision problem, что добавление одного-двух фактов заставляет переписывать огромные куски онтологии -- так что учить приходится зыбкое), культура продолжает действовать и сами эти нормы плывут. Поскольку правила подобрать нельзя, то любые парсеры-на-правилах загнулись, и выжили только нейросетевые парсеры, хорошо отражающие "голографическое", а не "членораздельное" (вот я писал в 2016, когда ещё не было даже трансформеров, https://ailev.livejournal.com/1281819.html). И дальше мы идём в методологию, и понимаем, что многие методы (а "как танцевать танго с данной партнёршей на данной милонге" -- это ж "применять метод") примерно так же устроены, никаких "структурированных описаний" получить нельзя, ты просто танцуешь как-то, пока тебя не одолевает дзен -- и нейросетка твоя как-то не справляется с получением модели хорошего танцевания (тангерос так и говорят: "как научиться хорошо танцевать танго? Танцевать 16 лет, всё само придёт, главное -- не останавливаться". Ага, обучение "без учителя", моделирование без локальной/символьной модели, распределённые представления. Но есть и вторая сторона вопроса: цивилизация развивается членораздельными моделями, символьным моделированием, сжатием информации с её лёгким транспортом из вычислителя в вычислитель. Появляются слова, воспроизводимые рассуждения по правилам с проверяемостью результатов и самих шагов рассуждения, учёт ограничений и инвариантов и всё такое из "научной картины мира", а не этой вашей "нейрогаллюцинированной картины мира" (хотя дай нейрогаллюцинатору внешнюю память и какой-нибудь калькулятор -- он и в рассуждения по правилам сможет). Статья бьёт в эту же точку, в методологию: как описать отдельные действия (вроде "человек через дверь входит в комнату") выделив какие-то инварианты. Вместо "языка операторов и их правил композиции" моделируется сразу "пространство возможных действий", которое позволяет объяснять/предсказывать следующее наблюдение (привет, active inference), например, при анализе видео предсказать, что будет в соседнем кадре -- и в фокусе тут действия, а не "предметы обстановки" или "кто там агент". Эта штука работает, и работает хорошо. Очень хотелось бы иметь, конечно, "нейро-символическую методологию" (где гибрид "голографического и членораздельного", то есть гибрид распределённых и локальных представлений), но если нет -- хотя бы не игнорировать необходимость "распределённых представлений в методологии". А дальше та самая "безъязыковая линия", мышление идёт в latent space (а не в видео, аудио, языковой или ещё какой-то модальности), и если уж пытаться "символьно моделировать действия", то прямой путь туда, а не в исходное или конечное пространства (скажем, пространства "что мы видим"). Это очень, очень мутное место, опыта мышления про распределённые представления нет, хотя у всех в голове есть мощный процессор именно для таких представлений. Так что идите пока танцевать танго, писать проникновенные тексты с вашим тонким чувством стиля и заниматься прочим таким: пока вас не прошибёт дзен и вы не построите ваше латентное пространство, модель этого куска мира и модель ваших действий в этом мире. Распределённая методология, да. Но западная цивилизация дальше придёт в этот дзен и что-нибудь предложит.
Post #43 373
📌 1 февраля: «Развитие для развитых в 2026» — лекционный семинар Анатолия Левенчука

01.02.2026 (вс) 11:30–19:00 MSK
(час обед + 2 перерыва по 15 минут)
Online + Очно в Москве
(офис МИМ на Таганке).

Семинар для руководителей, архитекторов, инженеров-менеджеров, которые уже и образованы, и развиты, и думают, как управлять дальнейшим развитием в мире AI-агентов.

Важно: это не обучающий курс и не “пошаговые инструкции”.
Цель — дать картину текущего состояния SoTA и язык для обсуждения развития “после потолка обучения”.
Цена: 14 000 ₽

__________
UPD. Регистрация на семинар закрыта.
Доступ к записи: http://events.system-school.ru/
(видеозапись/материалы/обсуждения и ответы на вопросы).

Программа:
1. Откуда берётся новое: open-endedness, NQD, портфели решений, развиваемость
2. Как удерживать темп развития: циклы мышления-действия, инварианты, роль FPF
3. Как масштабироваться: управление агентами (люди+AI), проверки, точность языка
4. Как ускорить развитие: 10 резидентур и 10 руководств вместо очередной “магистратуры”
  • ❤ 3
  • 🔥 3
  • 👍 1
Post #42
Channel photo updated
Post #41 185

Forwarded from Лабораторный журнал

Перевод с художественного на инженерный при помощи FPF: даю пример свежей статьи про построение систем с LLM под капотом, написанной художественным языком, которую переписываю промптом в пяток строчек в инженерный паттерн (ещё и по-русски). Все эти многозначные binding, anchoring (а также contract, service и прочие) — побеждены! Это я хвастаюсь новым паттерном A.6.P, который описывает этот процесс для vanilla LLM:
- по каким-то ключевым словам-триггерам раскрыть/распаковать онтику (обрывок онтологии) ситуации, затем
-- подложить под эту онтику какую-то математику (мат. объекты с понятным поведением, чтобы потом рассуждение не рассыпалось -- по факту потом вы сможете рассуждать с математической точностью, "формализация" как раз этот шаг, хотя поэтический язык назовёт через метонимию весь этот процесс в целом "формализацией" по имени вот этого одного внутреннего шага, но мы будем говорить о процессе в целом как "повышении семантической точности"), затем
-- поправить онтологию под эту математику
-- затем точно назвать понятия этой онтологии какими-то специфичными для этой онтологии лексемами.

https://ailev.livejournal.com/1786844.html (полный текст в ЖЖ — 30Кзнаков)
  • 🔥 2
Post #40 149

Forwarded from Лабораторный журнал

Очень трудно отвечать на вопрос "какие задачи решает FPF", ибо он очень похож на вопрос "какие задачи решает ваша голова". И очень трудно отвечать на вопрос "дайте примеры работы", ибо у меня мелкие примеры почти в каждом посте, а в самом FPF примеры ещё и в каждом паттерне — но вот не хватает!

Но вопрос звучит и звучит (он ведь вроде "для чего можно использовать LLM"), поэтому я написал очередной текст в ответ на этот вечный вопрос.

Конечно, это я всё писал сам. Если вам очень длинно (там 12Кзнаков), или не нравится эссе, а вы любите стену буллетов ("структурированное изложение"), или считаете, что это "голимый маркетинг", то вы можете отдать этот текст вашей любимой LLM и попросить его оформить так, как вам удобней. Но это уже можно и без меня.

https://ailev.livejournal.com/1786128.html
Livejournal Ответ на вечный вопрос "какие задачи решает FPF" FPF добавляется к LLM как усилитель инженерного начала, это не конкретный "набор приёмов/эвристик". Поэтому нельзя рассказать, "что было решено при помощи FPF" -- если это про фундаментальное мышление, то "что вы сделали при помощи мышления"? Даже про разделы…
Older posts →

About this channel

How can I read @mim_research without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Исследовательское развитие инженеров-менеджеров (МИМ): recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Исследовательское развитие инженеров-менеджеров (МИМ) have?
Исследовательское развитие инженеров-менеджеров (МИМ) (@mim_research) has 179 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Исследовательское развитие инженеров-менеджеров (МИМ) know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →