TGViewer
Channel Public Channel
Матчасть

Матчасть

@matchast

Высшая математика в бизнесе и жизни
vk.com/mat.chast
botcamp.timepad.ru
www.youtube.com/channel/UCoO8ApMu4QM4KQ8oGRCgOHQ
Чат: t.me/matchast_chat
Subscribers
880
Photos
27
Videos
0
Links
176

Showing posts older than #149 · Back to latest

Older Posts 20 shown
Post #148 336
Нужно ли Data Scientist'у становиться ML-инженером? Об этом рассуждал Андрей Белов, руководитель команды подбора Яндекса, на встрече Data&Science. По роду службы он сталкивается с людьми, которые позиционируют себя как аналитики, разработчики, и всё такое. И вот так оказывается, что если разработчик и аналитик - один и тот же человек, от этого все выигрывают.
Post #146 338
Post #145 319
О создании предсказательных моделей, которые клиент действительно рад внедрить, рассказал Алексей Рустамов из Loginom Company на встрече Data&Science в Яндексе. Его компания уже лет 20 занимается анализом данных, в частности, кредитным скорингом, на примере которого и строится рассказ. Оказалось, что основная причина низкого проникновения ML - недоверие заказчика к моделям. Но этого можно избежать, превратив модель из "чёрного ящика" в "белый" или хотя бы "серый".
Post #143 317
Мы рассмотрели пять конкурирующих подходов к машинному обучению из "Верховного алгоритма" - логический, нейронный, эволюционный, вероятностный, и основанный на сходстве. У каждого есть свои сильные, но ни один сам по себе, кажется, не может породить алгоритм, который был бы универсальным.

Как объединить все классные модели в одну революционную? Бэггинг (голосование), стэкинг (последовательная связь), и бустинг (каждый следующий исправляет ошибки предыдущих) - простые и приятные способы объединения алгоритмов в ансамбли, но мы хотим цельную систему. Такой системой может быть марковская логическая цепь: давайте генетически подбирать структуры, обучать параметры градиентным спуском, чтобы выбрать модель с наибольшей постериорной вероятностью, с учётом штрафов, как в SVM, за неправильно предсказанные классы. Причём предсказывать мы будем вероятности логических формул, применённых к объектам, находящимся в различных взаимосвязях друг с другом. Такая модель может обучаться на начальном, затравочном наборе формул, и выводить свои формулы дальше; так работает созданный автором алгоритм Alchemy, который объединяет в себе практически всё, что есть в этой книге (естественно, работает он не очень быстро). Но зато обученный на всей информации мира, такой алгоритм может стать базой и генератором всех знаний (однако придётся хорошо поработать с биг датой). И тогда, возможно, ему удастся решить проблему рака.

В мире машинного обучения любое ваше действие превращается в данные, и вы можете пользоваться этим стратегически, обучая алгоритмы, как вам нужно (например, чтобы подбирать музыку или знакомства, нужные вам). В мире, где компьютеры знают о вас очень много, у вас будут настоящие виртуальные "двойники" с вашим опытом и предпочтениями, и возможно, они возьмут на себя часть ваших функций. В таком мире появится место для компаний, хранящих ваши денные и бережно с ними обращающихся, и, конечно, это потребует законодательных изменений. Конечно, может быть, вашу работу отберёт нейронная сеть, и, чтобы этого не произошло, лучше автоматизируйте её по собственной инициативе. Зато как хорошо будет, когда роботы будут воевать друг с другом вместо людей! Однако вряд ли компьютеры захватят власть, ведь у них нет собственных целей и предпочтений; скорее надо опасаться злоумышленников, контролирующих компьютеры. В конце, может быть, цифровая эволюция продолжит биологическую, когда мы начнём выходить за рамки наших тел.

Но пока что верховный алгоритм не создан, и вы можете принять участие в его создании. Покачайте датасетов с UCI, померяйтесь силами на kaggle, делитесь знаниями с другими, развивайтесь, и да пребудет с вами сила машинного обучения!

goo.gl/tP4pTV - статья Домингоса про марковские логические цепи
goo.gl/vawv4y - сайт алгоритма Alchemy
#матчасть #weirdMath #machinelearning #верховныйалгоритм #themasteralgorithm 
Post #141 288
А вот маленькие дети часто обучаются без учителей, просто наблюдая за миром, и в итоге, например, начинают группировать объекты на группы похожих: еда, игрушки, животные... Как они это делают? Для начала можно придумать группы (кластеры) какими угодно, и для каждого кластера вычислить эталонный (средний) объект. А затем принадлежность к кластерам легко переопределить, причисляя каждый объект к ближайшему эталону. Процедуру можно повторять много раз, пока не сойдётся, и называется всё это алгоритмом "k-средних". Более общий алгоритм, EM, может относить объекты не к одному классу, а ко многим сразу - вероятностно.

Другое семейство алгоритмов (метод главных компонент - самый популярный) учится вычислять по многочисленным признакам несколько самых важных интегральных признаков, например, свести личность человека к 5 качествам (модель OCEAN). Часть алгоритмов обучаются с подкреплением - смотрят на результаты прошлых действий и пытаются действовать так, чтобы получить наилучший результат в будущем. Возможно, что люди обучаются благодаря всё более высокоуровневой перекомбинации предыдущих навыков, что у машин пока получается плоховато. И ещё одна область для обучения - это обучение отношений между объектами (например, людьми в социальной сети).

#матчасть #weirdMath #machinelearning #верховныйалгоритм #themasteralgorithm #bayesian #svm
Post #140 276
Сегодня разбираем последние два подхода к машинному обучению из книги Педро Домингоса - байесовский и основанный на сходстве, а заодно обучение без учителя.

Шотландский священник 18 века Томас Байес смог описать формулу, позволяющую делать универсальные выводы о том, как устроен мир:
P(cause | effect) = P(cause) × P(effect | cause) / P(effect)
Всем возможным причинам (болезням, например), необходимо заранее присвоить вероятности, и тогда, наблюдая любой симптом, мы сможем обновлять эти вероятности, пока не будем достаточно уверены в диагнозе. Вместо моделей могут быть научные теории - и мы будем продолжать доверять сразу нескольким из них, пока одна не докажет убедительного превосходства. Подобные же модели (марковские), описывающие вероятности следования различных слов и звуков друг за другом, позволяют роботам типа Сири понимать и генерировать речь.

Достаточно полная байесовская модель может вычислить вероятность чего угодно при условии чего угодно.. Но на практике это огромные сети переменных, все связи между которыми (условные вероятности) приходится как-то определять. Кроме того, всевозможных событий в такой сети очень много, и вместо того, чтобы вычислять вероятности всех из них, приходится выбирать только некоторые события путём случайного блуждания (MCMC). Байесовские методы окутывают собой классическую статистику как частный случай, а в последнее время они сблизились и с нейронными сетями. Марковские сети - подобные модели, заменяющие часть вероятностных допущений на чисто оптимизационные (с подгонкой весов). Но даже такие вероятностные модели с трудом описывают сложные, многотипные явления. А ещё все вышеописанные подходы работают плохо, когда данных совсем мало.

Человеческое мышление основано на осознании сходства и проведении аналогий. На этом же основан метод ближайших соседей: для каждого объекта предсказывайте класс объекта из обучающей выборки, наиболее похожего на него (или класс k самых похожих). Так удалось создать, например, модели коллаборативной фильтрации, советующие вам товары, выбранные людьми со вкусами, похожими на ваши. Проблема, однако, в том, что в очень многомерных пространствах (миллион фильмов на Netflix) меры сходства не очень информативны - все соседи далеки, и границы между классами можно провести как угодно. Эту проблему решает SVM, выбирая из всех возможных границ самую широкую и устойчивую - обучаться получается, даже когда наблюдений сильно меньше, чем признаков. Но всё-таки для этого нужны размеченные наблюдения...
Post #138 303
Продолжаем пересказывать "Верховный алгоритм". За описанным вчера "логическим" подходом следуют "коннекционистский" и "эволюционный" взгляды на машинное обучение.

Коннекционизм основан на правиле Хэбба - между нейронами в мозге человека, которые часто срабатывают вместе, постепенно усиливается связь. Перцептроны (это простая математическая модель нейрона) были популярны в середине XX века, но они справлялись далеко не со всеми поставленными задачами. Интересна связь нейровычислений с термодинамикой - например, машины Больцмана, имитирующие сознание, то спящее, то бодрствующее, и основанные на процессе, напоминающем остывание вещества. Важная составляющая нейронок - логистическая кривая (сигмоида), придающая нелинейность.

Возродились нейронки, когда изобрели градиентный спуск с обратным распространением ошибки - способ обучать одновременно большую систему нейронов. В двухтысячных они уже вовсю распознавали картинки и предсказывали цены акций.

Клетка - система нелинейная, и описать её (в задаче борьбы с раком) может быть удобно как раз нейронкой. Автоэнкодер - нейронка, которая умеет сжато описывать сложные объекты. Взгромоздим их друг на друга побольше, и вот у нас уже глубокое обучение. Но есть вещи, которые легко даются людям, и сложно нейронкам (начиная с базовой логики). Как люди смогли научиться этому?

Представьте себе огромную фабрику роботов, где они хаотично создают сами себя, поколение за поколением. Нечто подобное создал Джон Холланд, когда в пятидесятых годах он описал генетические алгоритмы (хотя первым их описал таки Дарвин). Гены мутируют, скрещиваются, размножаются, подвергаются отбору - всё то же можно делать с алгоритмами, меняя случайные части, комбинируя, копируя, и оставляя самые эффективные. За счёт случайных мутаций и перекомбинаций, такие алгоритмы могут выскакивать из локальных оптимумов, но важно сохранять баланс между поиском принципиально новых решений и улучшением (эксплуатацией) имеющихся.

Представление алгоритмов как деревьев из блоков кода, выращенных генетически, позволило комбинировать их настолько эффективно, что с их помощью начали оптимизировать заводы. Кстати, оказалось, что для генетических алгоритмов рекомбинация не очень важна, и вопрос о роли секса в эволюции остаётся открытым.

ГА хорошо обучают структуру, а нейронки параметры, и неплохо бы их объединять - эдакая ламарковская эволюция. Но и те, и другие непрозрачны, хаотичны, и добиваются результатов лишь случайно. Поэтому дальше мы поговорим о более структурированных подходах к машинному обучению.

#матчасть #weirdMath #machinelearning #верховныйалгоритм #themasteralgorithm #deeplearning #нейросети #geneticalgorithm 
Post #136 295
Сегодня разберём первый подход к машинному обучению, описанный в книге "Верховный алгоритм": логический, aka символический. И заодно поговорим о главной проблеме машинного обучения.

Все люди делятся на рационалистов и эмпириков: первые при познании мира опираются на логику, вторые - на наблюдения. Юм в своё время задал правильный вопрос: как мы вообще можем верить в то, что наши наблюдения могут быть обобщены до знаний, пригодных для предсказания?

Можно накопить описания большого количества ситуаций из прошлого (например, случаи, когда ты приглашал подругу на свидание), но ни одна из них не будет совпадать с ситуацией из будущего (например, сегодняшним вечером), и потому невозможно получить предсказание (например, получишь ли ты сегодня отказ). Теорема "об небесплатном сыре" говорит, что на любой алгоритм обучения найдётся такой мир, в котором этот алгоритм будет не лучше подбрасывания монетки. Но мы будем надеяться, что если какое-то правило всегда выполнялось в прошлом, то оно будет выполняться и в будущем (хотя одну известную индейку это подвело).

Знания можно описывать правилами: "если сегодня будни и по телевизору ничего интересного, то девушка согласится", или "если заёмщик работает меньше 3х месяцев или имеет больше 4 активных кредитов, то он не будет гасить ещё один", и правила можно подбирать по имеющейся базе данных; Walmart прославился применением таких правил для расположения товаров в торговых залах (история про пиво и подгузники). Но проблема поиска правил в том, что их можно придумать очень много, и среди них, скорее всего, будут ложные: например, можно решить, что все письма, содержащие "free" - спам, и выкинуть в корзину сообщение о поступлении на бюджет. Генерация ложных закономерностей называется переобучением, и это одна из главных проблем машинного обучения. Важно проверять не слишком много гипотез, чтобы среди успешно принятых было бы не слишком много ложных, но если иметь очень мало гипотез, не подтвердиться может ни одна. Машинное обучение всегда балансирует на грани слепоты и галлюцинаций.

Одно из простых решений проблемы переобучения - проверять гипотезы на одном наборе данных (тренировочном) и перепроверять на другом (тестовом). Различают два вида неточности алгоритмов: разброс, когда ответы на тестовой выборке сильно отличаются друг от друга, и смещение, когда они все ошибаются в одну сторону. Между ними тоже можно балансировать.

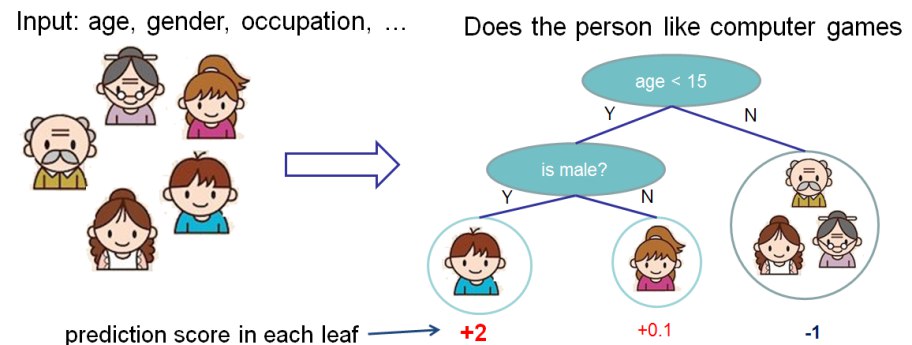
Индукция ("обратная дедукция") - способ порождать правила, связывая уже известные правила с имеющимися данными. Ещё один способ порождать правила - организовывать их в "дерево" из простых бинарных вопросов, с каждым следующим уточняя предсказания; такие деревья можно создавать рекурсивным алгоритмом очень быстро. А ансамбли из множества таких деревьев (в том числе случайный лес и градиентный бустинг) - один из сегодняшних state-of-the art подход ко многим задачам.

Подытожим. Символизм - школа AI, в основе которой стоит манипулирование символами; они добились больших успехов в управлении знаниями, но, увы, многие знания сложно определить как множество правил. Поэтому впереди нас ждут альтернативные подходы!

#матчасть #weirdMath #machinelearning #верховныйалгоритм #themasteralgorithm #decisiontree 
Post #131 287
Книга "Верховный алгоритм" Педро Домингоса - наверное, лучшее введение в машинное обучение, которое я встречал. Книга написана для самой что ни на есть широкой аудитории: в ней всего две формулы и ни одной строчки кода. Но автор умудряется за 300 страниц дать очень хорошую интуицию об основных направлениях и алгоритмах машинного обучения.

Как ему это удаётся? За счёт огромного, просто неприличного количества ярких метафор и ассоциаций, одновременно и связывающих у вас в мозгу воедино отдалённые области знаний и факты, и просто доставляющих удовольствие. Зачем автор это делает? Чтобы у вас загорелись глаза и вы тоже начали заниматься машинным обучением. Чего автор хочет добиться в итоге? Создать "верховный алгоритм", универсальный "решатель проблем", способный обучаться на любых данных. Если такой алгоритм будет создан, он изменит мир - например, сможет победить рак; без машинного обучения решить такую задачу невозможно.

Прелесть алгоритмов машинного обучения в их универсальности: одна и та же модель, обученная на разных данных, может предсказывать кредитный риск и диагностировать болезни. Однако полной универсальности нет: различные алгоритмы закладывают разные неявные допущения о решаемой задаче. Каждый из них имеет какие-то свои наиболее успешные зоны применения. Но автор верит в большее: можно создать единый алгоритм, способный извлечь из данных все знания —- "верховный алгоритм". Таким универсальным алгоритмом в некотором смысле является человеческий мозг, способный усвоить любое знание. Более того, универсальным алгоритмом является естественный отбор, создавший существ, приспособленных к любым условиям, в том числе и наш мозг. Всё устройство мира выводимо из весьма простых физических законов, а значит, возможно, есть путь предсказать на основе их всё, что угодно, если научиться применять их компактно к большим системам. В математической статистике существует теорема Байеса - универсальный способ обновлять гипотезы о мироустройстве на основе новых данных. В компьютерных науках огромный класс разнообразных задач, называемых NP-полными (проверяемыми за полиномиальное время), имеет быстрые решения, которые могут быть выражены друг через друга (в случае, если эти решения существуют - науке это пока неизвестно). Машинное обучение имеет больше перспектив, чем его конкурент, knowledge engineering (полуручной сбор экспертных знаний), т.к. справляется с теми же задачами - и с многими другими.

Конечно, в мире есть непредсказуемые явления ("чёрные лебеди") - но их невозможно предсказать ни одним методом, не только машинным обучением. Было бы хорошо, если бы верховный алгоритм мог предсказывать совершенно различные вещи, пользуясь одним и тем же методом - был "ежом", а не "лисицей". Если такой алгоритм будет создан, он сможет, например, пользуясь описанием ракового генома, смоделировать процессы, проходящие в раковых клетках данного конкретного пациента, и разработать лекарство, эффективное именно для него. Ни один человек и ни одна простая модель не в состоянии справиться с такой задачей. И в любой области жизни универсальный алгоритм может повлечь критические изменения - и вам было бы крайне полезно стать участником этих изменений. Возможно, такой алгоритм позволит учёным создать теорию всего, затягивая любые данные в одну модель.

Что может стать основой верховного алгоритма? Разные ответы дают на это разные школы машинного обучения: символисты, коннекционисты, эволюционеры, байесиане, и аналогисты. Познакомившись с этими школами в следующих постах, мы попытаемся извлечь лучшее из каждой.
#матчасть #weirdMath #machinelearning #верховныйалгоритм #themasteralgorithm
Post #128 255
Решил добавить ещё одну иллюстрацию ко вчерашнему конспекту - более детальный пример data science контракта, оцениваемого по часовой ставке. В статье по ссылке ниже описывается, как можно на пальцах оценить трудозатраты на проект по внедрению "умного" поиска по документам (и, конечно, в конце домножить результат на π).
#матчасть #weirdMath #datascience #machinelearning #projectmanagement #pricing
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →