Сегодня разберём первый подход к машинному обучению, описанный в книге "Верховный алгоритм": логический, aka символический. И заодно поговорим о главной проблеме машинного обучения.
Все люди делятся на рационалистов и эмпириков: первые при познании мира опираются на логику, вторые - на наблюдения. Юм в своё время задал правильный вопрос: как мы вообще можем верить в то, что наши наблюдения могут быть обобщены до знаний, пригодных для предсказания?
Можно накопить описания большого количества ситуаций из прошлого (например, случаи, когда ты приглашал подругу на свидание), но ни одна из них не будет совпадать с ситуацией из будущего (например, сегодняшним вечером), и потому невозможно получить предсказание (например, получишь ли ты сегодня отказ). Теорема "об небесплатном сыре" говорит, что на любой алгоритм обучения найдётся такой мир, в котором этот алгоритм будет не лучше подбрасывания монетки. Но мы будем надеяться, что если какое-то правило всегда выполнялось в прошлом, то оно будет выполняться и в будущем (хотя одну известную индейку это подвело).
Знания можно описывать правилами: "если сегодня будни и по телевизору ничего интересного, то девушка согласится", или "если заёмщик работает меньше 3х месяцев или имеет больше 4 активных кредитов, то он не будет гасить ещё один", и правила можно подбирать по имеющейся базе данных; Walmart прославился применением таких правил для расположения товаров в торговых залах (история про пиво и подгузники). Но проблема поиска правил в том, что их можно придумать очень много, и среди них, скорее всего, будут ложные: например, можно решить, что все письма, содержащие "free" - спам, и выкинуть в корзину сообщение о поступлении на бюджет. Генерация ложных закономерностей называется переобучением, и это одна из главных проблем машинного обучения. Важно проверять не слишком много гипотез, чтобы среди успешно принятых было бы не слишком много ложных, но если иметь очень мало гипотез, не подтвердиться может ни одна. Машинное обучение всегда балансирует на грани слепоты и галлюцинаций.
Одно из простых решений проблемы переобучения - проверять гипотезы на одном наборе данных (тренировочном) и перепроверять на другом (тестовом). Различают два вида неточности алгоритмов: разброс, когда ответы на тестовой выборке сильно отличаются друг от друга, и смещение, когда они все ошибаются в одну сторону. Между ними тоже можно балансировать.
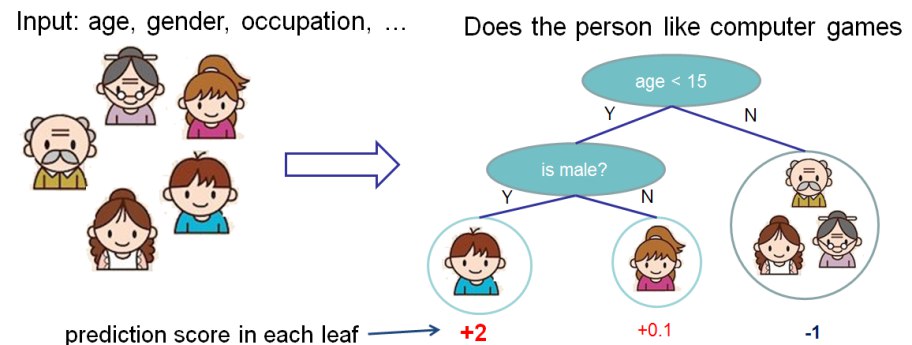
Индукция ("обратная дедукция") - способ порождать правила, связывая уже известные правила с имеющимися данными. Ещё один способ порождать правила - организовывать их в "дерево" из простых бинарных вопросов, с каждым следующим уточняя предсказания; такие деревья можно создавать рекурсивным алгоритмом очень быстро. А ансамбли из множества таких деревьев (в том числе случайный лес и градиентный бустинг) - один из сегодняшних state-of-the art подход ко многим задачам.
Подытожим. Символизм - школа AI, в основе которой стоит манипулирование символами; они добились больших успехов в управлении знаниями, но, увы, многие знания сложно определить как множество правил. Поэтому впереди нас ждут альтернативные подходы!
#матчасть #weirdMath #machinelearning #верховныйалгоритм #themasteralgorithm #decisiontree
Post #136
295