Все о машинном обучении
админ - @workakkk
@data_analysis_ml - анализ даннных
@ai_machinelearning_big_data - Machine learning
@itchannels_telegram -лучшие ит-каналы
@pythonl - Python
@pythonlbooks- python 📚
@datascienceiot - 📚
РКН: clck.ru/3FmrUw
Post #2037
1.92K
Forwarded from Machinelearning


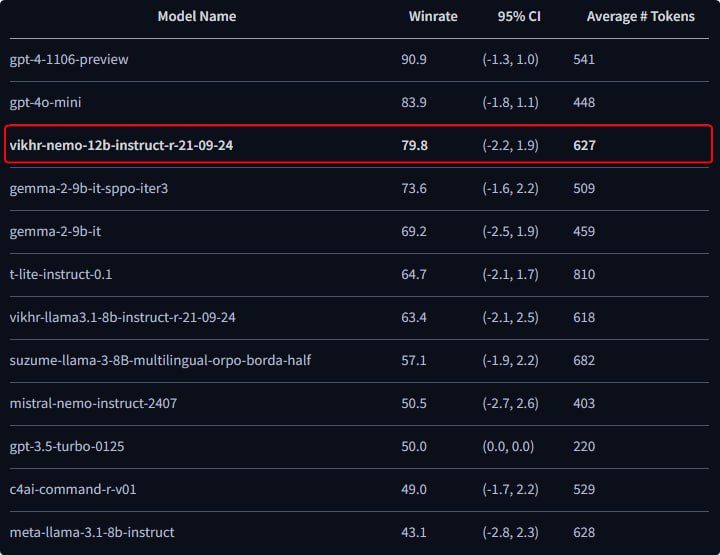

⚡️ Vikhr: новые модели на 12B и 8B для русского языка с уникальным методом выравнивания.
Vikhr Team — сообщество энтузиастов, занимающихся созданием и развитием русифицированных LLM, выпустили две новые модели, оптимизированные для русского языка в задачах генерации кода, решения математических задач, обобщения, ответов на вопросы и построения логических выводов. Обе модели адаптированы для RAG и могут выступать реранкером на уровне LLM.
▶️ Vikhr-Nemo-12B-Instruct-R-21-09-24 — инструктивная модель на базе Mistral-Nemo-Instruct-2407 с 12 млрд. параметров и контекстным окном в 128К токенов.
В бенчмарке Ru-Arena General, Vikhr-Nemo-12B-Instruct-R-21-09-24 достигла результата в 79.8, уступая только двум моделям семейства GPT-4 .
🟢Версии квантования Vikhr-Nemo-12B-Instruct-R-21-09-24 в разрядности от 3-bit (6.08 Gb) до 16-bit (24.5 GB) в GGUF формате.
▶️ Vikhr-Llama3.1-8B-Instruct-R-21-09-24 — инструктивная модель на базе Meta-Llama-3.1-8B-Instruct с 8 млрд. параметров, контекстным окном в 128К токенов. В Ru-Arena General она показала значение winrate 63.4. По словам Vikhr Team — это лучший результат среди 8B моделей с поддержкой русского языка.
🟠Версии квантования Vikhr-Llama3.1-8B-Instruct-R-21-09-24 в разрядности от 3-bit (4.02 Gb) до 16-bit (16.1 GB) в GGUF формате.
Для файнтюна базовых моделей Mistral-Nemo-12B и Llama-3.1-8B, Vikhr Team разработали уникальный метод выравнивания — Simple Margin Preference Optimization (SMPO).
Он представляет собой микс из техник, заимствованных из CRLFT, IPO и SimPO, с добавлением своей функции потерь. Метод опубликован в репозитории на GitHub в комплекте тулкита скриптов и конфигураций, использовавшихся для обучения представленных моделей.
В процессе обучения моделей использовался кастомный SFT-датасет GrandMaster-PRO-MAX, собранный Vikhr Team самостоятельно, для следования самым разным наборам инструкций на разных языках (в основном на русском) и отвечать также - на русском языке. В него была включена CoT-способность.
📌Лицензирование : Apache 2.0 License.
🟡Модель Vikhr-Nemo-12B-Instruct
🟡Модель Vikhr-Llama3.1-8B-Instruct
🟡GGUF Vikhr-Nemo-12B-Instruct
🟡GGUF Vikhr-Llama3.1-8B-Instruct
🟡Датасет
🟡Demo Vikhr-Nemo-12B-Instruct
🖥Github
@ai_machinelearning_big_data
#AI #ML #LLM #Vikhr
- ❤ 8
- 🔥 3
- 👍 2