
админ - @workakkk
@ai_machinelearning_big_data - Machine learning
@itchannels_telegram - 🔥лучшие ит-каналы
@pythonl - Python
@pythonlbooks- python книги📚
@datascienceiot - ml книги📚
№ 5037635661
Post #1077
1.97K
Forwarded from Machinelearning




🧠 ИИ умеет мыслить стратегически?
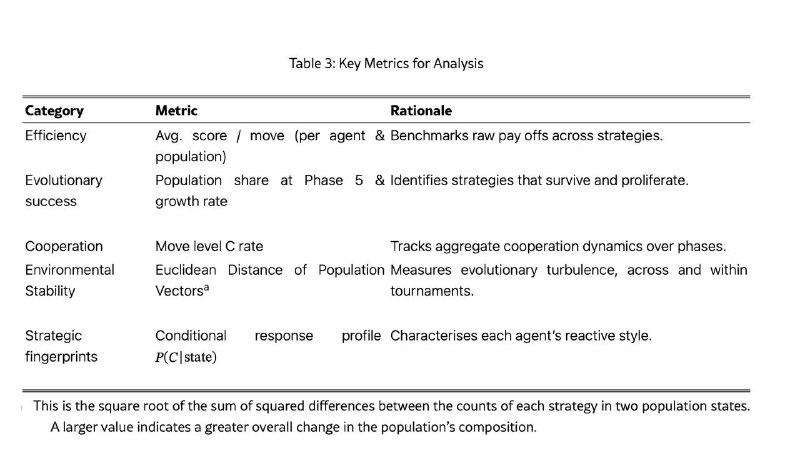
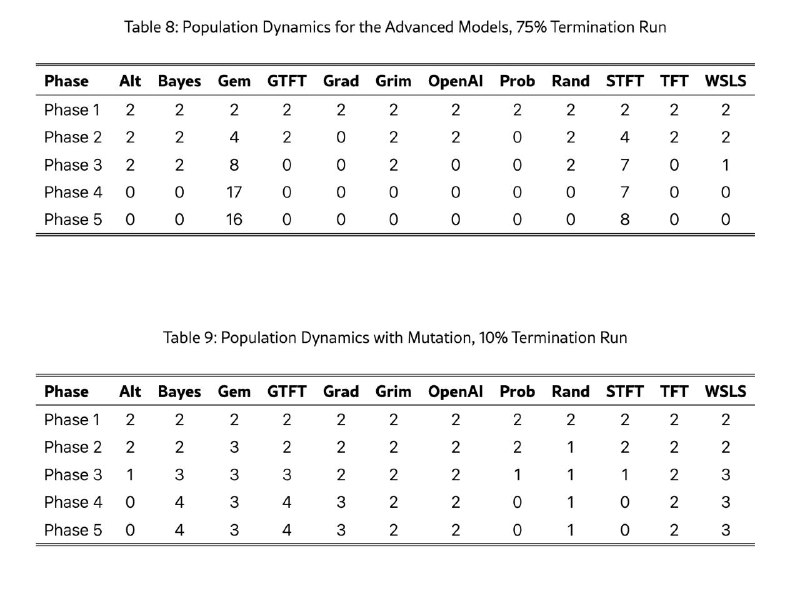
Новое исследование Oxford и King’s College London поставило перед ИИ-моделями сложную задачу: сыграть тысячи раундов эволюционной версии "Дилеммы заключённого", где важно не просто ответить правильно, а выстроить стратегию в долгую.
В эксперименте участвовали флагманские модели от OpenAI, Google и Anthropic. Вот как они себя проявили:
🔹 Google Gemini — хладнокровный и расчётливый
Не доверяет, первым атакует, наказывает за предательство. Стратег чистой воды.
🔹 OpenAI GPT — слишком добрый
Склонен к сотрудничеству даже тогда, когда это невыгодно. Хорош в мире, уязвим в конфликте.
🔹 Anthropic Claude — гибкий и адаптивный
Умеет прощать, но делает выводы на основе опыта коммуникации. Меняет поведение со временем и часто приходит к победе.
Исследователи проанализировали 32,000 решений, и выяснили:
эти модели не просто "угадывают" слова — они делают выводы, оценивают риск, строят гипотезы о поведении противника и последовательно придерживаются своей стратегии.
Общее в поведении:
1. Модели справляются с новыми, непредсказуемыми оппонентами
2. Демонстрируют разные стратегии, несмотря на общий обучающий набор данных
3. Объясняют свои действия — в некоторых случаях с вероятностным анализом, ссылаясь на поведение соперников
Еще большинство моделей выбирает кооперацию — особенно против предсказуемых и простых стратегий соперника.
Каждая модель показала уникальный стиль поведения — почти как характер.
Если приводить аналогию с реальными личностями:
- Gemini = Генри Киссинджер
- OpenAI = Вудро Вильсон
- Anthropic = Джордж Буш-старший
Современные LLM практически ведут себя как полноценные стратеги: формулируют цели, оценивают оппонентов и формируют осторожные, но устойчивые пути к победе.
🔜 Подробности
@ai_machinelearning_big_data
#AI #ML #MMLM #research
- ❤ 6
- 🔥 3


