TGViewer
Channel Public Channel
تیم ترویج زبان‌شناسی

تیم ترویج زبان‌شناسی

@linguists2b

از ۱۳۹۴

ترویج علم زبانشناسی در ایران
Subscribers
3.4K
Photos
3.7K
Videos
547
Links
1.5K
Recent Posts 19 shown
Post #15194 231
گفتگو درباره رازهای زبان‌شناختی فیلم سینمایی Arrival محصول ۲۰۱۶ هالیوود

این فیلم پر رمز و راز درباره ورود موجودات فضایی به زمین و ماجراهای پس از آن بوده و نقش اول آن یک زبانشناس متخصص در ترجمه است. متخصصی که توسط ارتش برای کشف هدف فضایی‌ها استخدام شده...

نسخه باکیفیت گفتگو در کانال یوتیوب جیمرو فیلم

@linguists2b ☘️
  • ❤ 4
Post #15193 468
تیم ترویج زبان‌شناسی 🔻منابع آزمون دکترای زبانشناسی ۱۴۰۶ (گرایش‌های نظری و شناختی) 🟩 کلیات ۱. اصول دستور زبان، ا گلفام ۲. مکاتب زبانشناسی، م راسخ مهند ۳. آواشناسی: بررسی علمی گفتار، گ مدرسی قوامی ۴. درآمدی بر معنی‌شناسی، ک صفوی ۵. ساخت آوایی زبان، م مشکوةالدینی ۶. دستور زبان…
understanding_phonology_Fourth_edition_260919_102356.pdf5.2 MB
🔻معرفی کتاب: [منبع کنکور دکتری]

📚 Understanding Phonology
✍️ Gussenhoven & Jacobs
📆 2017

📌 از متون مقدماتی در حوزه واجشناسی زایشی، در توصیف نظام واجی زبان و بیان مفاهیم اساسی و پایه

🔔💥 و از منابع مهم در آزمون دکتری زبانشناسی
@linguists2b ☘️
  • 🙏 2
Post #15191 537
تیم ترویج زبان‌شناسی 🔻منابع آزمون دکترای زبانشناسی ۱۴۰۶ (گرایش‌های نظری و شناختی) 🟩 کلیات ۱. اصول دستور زبان، ا گلفام ۲. مکاتب زبانشناسی، م راسخ مهند ۳. آواشناسی: بررسی علمی گفتار، گ مدرسی قوامی ۴. درآمدی بر معنی‌شناسی، ک صفوی ۵. ساخت آوایی زبان، م مشکوةالدینی ۶. دستور زبان…
2003 Core Syntax A Minimalist Approach.pdf33.8 MB
🔻معرفی کتاب: [منبع کنکور دکتری]
📚 Core Syntax : A Minimalist Approach
✍️ David Adger
📆 2003
📌 از متون جامع در حوزه نحو زایشی، در توصیف نظام محاسباتی زبان در چارچوب برنامه کمینه‌گرا

🔔💥 و از منابع مهم در آزمون دکتری زبانشناسی

@linguists2b ☘️
  • ❤ 3
  • 🙏 1
Post #15190 498
Ashofteh HaliDelkash
شاعر: رحیم معینی کرمانشاهی
موسیقی: استاد علی تجویدی
آواز: دلکش


این همه آشفته حالی/این همه نازک خیالی/ای به دوش افکنده گیسو/از تو دارم، از تو دارم
*
این تو بودی کز ازل خواندی به من درس وفا را/این تو بودی آشنا کردی به عشق/این مبتلا را/من که این حاشا نکردم/از غمت پروا نکردم
*
من خود آتشی که مرا داده رنگ فنا میشناسم/من خود شیوه نگه چشم مست تو را میشناسم/دیگر ای برگشته مژگان از نگاهم رو مگردان ...
@linguists2b ☘️
  • ❤ 5
Post #15189 1.07K
🔻منابع آزمون دکترای زبانشناسی ۱۴۰۶

(گرایش‌های نظری و شناختی)

🟩 کلیات

۱. اصول دستور زبان، ا گلفام
۲. مکاتب زبانشناسی، م راسخ مهند
۳. آواشناسی: بررسی علمی گفتار، گ مدرسی قوامی
۴. درآمدی بر معنی‌شناسی، ک صفوی
۵. ساخت آوایی زبان، م مشکوةالدینی
۶. دستور زبان فارسی: واژگان و پیوندهای ساختی، م مشکوةالدینی
۷. Understanding Phonology, Gussenhoven
۸. Understanding Morphology, Haspelmath

🟩 دروس پایه

🔴 آواشناسی و واجشناسی

۹. آواشناسی زبان فارسی، ی ثمره
۱۰. آواشناسی آکوستیک و شنیداری، کیث جانسون، ت ز محمودزاده، ر روح پرور
۱۱. واجشناسی: رویکردهای قاعده‌بنیاد، ع کرد زعفرانلو کامبوزیا
۱۲. واجشناسی: نظریه بهینگی، م بیجن‌خان
۱۳. واجشناسی: تحلیل نظام آهنگ زبان فارسی، م اسلامی
۱۴. نظام آوایی زبان فارسی، م بیجن‌خان
۱۵. ساخت نوایی زبان فارسی، و صادقی

🔴 صرف

۱۶. صرف: رویکردهای نظری و کاربرد آنها در تحلیل زبان فارسی، ف ارکان، ت حیدرپور بیدگلی
۱۷. واژشناسی، کاتامبا، استوتهام، ت ج رحیمیان
۱۸. صرف در نحو: از کمینه‌گرایی تا صرف توزیعی، م انوشه

🔴 نحو

۱۹. زبانشناسی نظری، م دبیرمقدم
۲۰. درسنامه دستور زایشی، م همایون‌فر
۲۱. Core Syntax, a Minimalist Approach, David Adger

🔴 معناشناسی

۲۲. درآمدی بر معناشناسی، سباستین لوبنر، ت ج رحیمیان
۲۳. مبانی معناشناسی شناختی، آ افراشی
۲۴. معناشناسی کلان: کاربردشناسی، ف ساسانی
۲۵. Meaning in Language; An Introduction to Semantics and Pragmatics, Alan Cruse
۲۶. Toward a Cognitive Semantis (I & II) Leonard Talmy

🔴 مکاتب

۲۷. سیر زبانشناسی، م مشکوةالدینی
۲۸. مکاتب زبانشناسی نوین در غرب، پیتر سورن، ت ع.م حق‌شناس
۲۹. تاریخ مختصر زبانشناسی، روبینز، ت ع.م حق‌شناس

🔴 تجزیه و تحلیل کلام

۳۰. Discourse Analysis, Brian Paltridge
۳۱. Discourse Analysis, Barbara Johnstone
۳۲. Discourse, Grammar and Ideology; Functional and Cognitive Perspectives, Christopher Hart

🔴 مسائل میان رشته‌ای

۳۳. درآمدی بر جامعه‌شناسی زبان، ی مدرسی
۳۴. روانشناسی زبان، م پورمحمد
۳۵. ساختهای پیکره‌ای در خط و زبان فارسی، م بیجن‌خان
۳۶. تمریناتی در مبانی، منطق و نظریه مجموعه‌ها، سیگلر، ت ب رزاق‌منشی

🟦 توضیحات تکمیلی:

۱. منابع به شکلی تنظیم شده که به طور کامل جوابگوی نیاز بیشتر داوطلبان با هر سطح و پیش‌زمینه‌ای باشد. این تعدد منابع باعث شده بعضی از آنها محتوای مشترک داشته باشند. بسته به زمانی که برای مطالعه اختصاص می‌دهید، می‌توانید برنامه‌ریزی شخصی خود را داشته باشید و شاید نیاز نباشد همه آنها را مطالعه کنید.

۲. درس زبان انگلیسی علی‌رغم ضریب ۱ ، همچنان تعیین‌کننده است. بنابراین مطالعه کتابهای زبان اصلی، و استفاده از منابع تافل برای تقویت گرامر و درک مطلب انگلیسی، توصیه میشود.

۳. برای گرایش آزفا، بیشتر این منابع مفید خواهند بود. با این حال از آنجا که سوالهای این گرایش تخصصی بوده و تستهای آن کاملا مجزاست، لازم است با داوطلبان سالهای گذشته و استادان و دانشجویان دکتری آزفا مشورت بفرمایید.

۴. این کتاب‌ها به لحاظ کیفیت علمی لزوما بهترین در نوع خود نیستند بلکه، سعی شده، متناسب‌ترین منابع با نیاز داوطلبان کنکور دکتری باشند. اگر در یک حوزه خاص ضعیف هستید، می‌توانید منابع بیشتری مطالعه بفرمایید. همچنین از معرفی منابعی که ممکن است برحسب تصادف یک تست از آنها طرح بشود، و چه بسا نشود، منابع قدیمی نامتناسب با محتوای آزمون، منابع با ترجمه‌ی ضعیف، منابع حجیم و ثقیل، منابع نایاب یا کمیاب و منابع بسیار تخصصی، اجتناب شده است‌.

🟥 این فهرست برای پانزدهمین سال متوالی، در تاریخ ۲۳ شهریور ۱۴۰۵ پس از بررسی بیش از ۵۰۰ عنوان کتاب در تیم ترویج زبانشناسی، به روز رسانی و منتشر شده است.

@linguists2b ☘
  • ❤ 4
  • 🙏 3
Post #15187 633
The syntax of Adjuncts by Ernes 2004 .pdf1.8 MB
💥 معرفی کتاب
📚 The syntax of adjuncts
✍ Thomas Ernest
📆 2004

این منبع با رویکردی افزوده-بنیاد (Adjunct-Based) در چارچوب نظریه اصول و پارامترها، به دنبال قانونی همگانی برای تبیین ماهیت افزوده‌ها در زبان‌های مختلف است.

🔻 ارنست در این کتاب ورود سازه‌های جدیدی همچون گروه‌های قیدی، گروه‌های حرف اضافه‌ای، عبارتهای اسمی، عبارتهای مصدری و یا حتی ساختهای موصولی به ساخت اصلی یک جمله را به عنوان افزوده تبیین می‌کند؛ زیرا اطلاعات جانبی محسوب می شوند و  بدون آنکه نقش و جایگاه سازه های اصلی درون جمله را برهم بزنند، به ساختار جمله اضافه می شوند، معنای جدیدی به آن می دهند و با حذفشان معنای اولیه جمله از بین نمی رود.

🔻او همچنین در این اثر به مقایسه میان این سازه‌ها (افزوده) و موضوع های یک محمول پرداخته است. از این رو، با حذف سازه های یادشده جمله دستوری و دارای معنا خواهد بود در حالیکه با حذف یکی از موضوع های محمول، جمله غیر دستوری، نامفهوم و ناتمام خواهد ماند.

@linguists2b ☘
  • ❤ 2
  • 👌 2
Post #15185 1.11K
🔻برای کنکور دکتری زبانشناسی، کدام رشته‌های کارشناسی ارشد مجاز هستند؟

🏛 طبق دفترچه ۱۴۰۵، علاوه بر تمامی گرایشهای ارشد زبانشناسی و زبانهای باستانی، فارغ‌التحصیلان رشته‌های زیر نیز می‌توانند در این آزمون شرکت کنند:

۱. تمامی گرایشهای زبان فارسی ✅️
۲. تمامی گرایشهای زبان انگلیسی ✅️
۳. گرایش آموزش سایر زبانها ✅️
۴. گفتاردرمانی ✅️


🔴 فارغ‌التحصیلان کارشناسی ارشد زبانشناسی، فقط امکان شرکت در آزمون دکتری رشته فرهنگ و زبانهای باستانی را دارند.

🔴 فارغ‌التحصیلان آزفا، علاوه بر این، در گروه‌ آزمایشی دکتری زبان و ادبیات فارسی نیز امکان ثبت‌نام دارند.


✅️ گرایشهای دکتری زبانشناسی شامل:
زبانشناسی محض، شناختی و آزفا است.

✅️ سوالات گرایش آزفا خوشبختانه در سال‌های اخیر از سوالات گرایش محض و شناختی جداگانه و تخصصی طرح شده است.


❌️ علی‌رغم مجاز بودن گرایشهای مذکور، تحصیل در مقطع دکتری با کارشناسی ارشد نامتجانس، معمولا توصیه نمی‌شود.


🏛 دفترچه کنکور دکتری ۱۴۰۶ که به زودی منتشر خواهد شد، ملاک خواهد بود.


✅️ برای کسب اطلاعات بیشتر درباره آزمون دکتری زبانشناسی و منابع آن، با این کانال همراه باشید. 🔻

@linguists2b ☘️
  • 👎 6
  • ❤ 5
Post #15184 721
1777865335-69f81277efee3-9799-1404-26.pdf596.8 KB
🔻مقاله

🔴 برهم نهی کوانتومی و
#ادغام عام و خاص:
ملاحظاتی در ضرب ماتریسی، تنسورسازی و
#فرگشت_زبان

استاد محمد دبیرمقدم
دکتر مصطفی برزگر

@linguists2b ☘️
  • 👎 5
  • ❤ 3
  • 👍 1
Post #15182 700

Forwarded from National Brain Mapping Lab

🧠Iranian International Congress on Brain Mapping
┗━━━━━━━━━━✨️

آزمایشگاه ملی نقشه‌برداری مغز و دانشگاه شهید بهشتی برگزار می‌کنند:
🧠 نهمین کنگره بین المللی نقشه برداری مغز ایران

🗓️ مهلت دریافت مقالات: 15 شهریورماه 1405
🗓️ زمان: 8-6 آبان ماه 1405
📍مکان: مرکز همایش های بین المللی دانشگاه شهید بهشتی
جهت ‌کسب اطلاعات بیشتر به سایت اصلی کنگره به نشانی: humanbrainmapping.ir مراجعه فرمایید.

☎️ تماس با ما: 02186093155


💠Telegram
💠Instagram
💠LinkedIn
🌐Website
💠 bale
  • 👎 4
  • ❤ 2
Post #15181 910
واژه‌نامه‌ی قجری لکی-فارسی، رهاوردی از سر جان ملکم برای بریتانیا


طبق آنچه که در آرشیو نسخ خطی کتابخانه ملی بریتانیا آمده است، سر جان ملکم، سردار ارشد کمپانی هند شرقی امپراطوری بریتانیا، در آخرین دوره ماموریت خود در ایران، به فردی به نام محمد حسن خان، سفارش تالیف واژه‌نامه‌هایی از اصطلاحات رایج زبانهای غرب ایران به انگلیسی و فارسی می‌دهد. احتمالا منظور محمد حسن خان قراگوزلو وزیر لرستان و خوزستان دوره فتحعلی شاه قاجار بوده است.

این واژه‌نامه‌ها در کتابخانه ملی بریتانیا به نام واژه‌نامه‌ی "کردی اردلانی" و "کردی لکی" ثبت شده‌اند.

در این عکس، تصویری از واژه‌نامه‌ی "لکی فارسی" این آرشیو دیده می‌شود که در وبلاگ کتابخانه ملی بریتانیا منتشر شده است. اصطلاحات موجود در این تصویر، شباهت فراوانی با گویشهایی از استانهای کرمانشاه و ایلام کنونی دارد.

بدون شک این واژه‌نامه‌ها با توجه به قدمت بیش از دویست ساله‌ی خود، اطلاعات ارزنده‌ای درباره زبانهای ایرانی، به دست می‌دهند.

@linguists2b ☘️
  • ❤ 5
  • 👎 4
Post #15179 669
آیا لک قفقاز و لک ایران یکی است؟

زبان قوم لک قفقاز، لکوماز، از دسته زبانهای قققازی است و به هیچ وجه قرابت زبانشناختی با زبان ایرانی لکی ندارد و تشابه اسم این دو قوم، صرفا یک تشابه تصادفی است. زبانهای قفقازی شاخه‌ای متفاوت از زبانهای هندواروپایی هستند.

مشابهت تصادفی واژگان زبانهای دنیا امری معمول است. به خصوص درباره واژه‌های تک هجایی. در بین واژه‌های تک هجایی زبانهای دنیا، ساخت هجایی CVC یعنی توالی صامت مصوت صامت، یک ساخت رایج است و صرفا مختص زبانهای ایرانی نیست. واژه‌ی #لک یک واژه‌ی تک هجایی با این ساخت است. در نتیجه طبیعی است که واژه‌های مشابه "لک" /læk/ در زبانهای دنیا کم نباشند.

حال این واژه می‌تواند به نام یک یا دو قوم از جغرافیا و پشینیه متفاوت اشاره داشته باشد، مانند لک قفقاز و لک ایران.

خواننده کنجکاو درباره زبان لکهای قفقاز می‌تواند عبارت انگلیسی "laki language of caucasus " را جستجو کند. خوشبختانه منابع صوتی، تصویری و متنی فراوانی از این زبان موجود است. از جمله:

https://www.annualreviews.org/content/journals/10.1146/annurev.an.06.100177.001435

https://www.omniglot.com/writing/lak.htm

https://en.wikivoyage.org/wiki/Lak_phrasebook

همچنین بنگرید به منبع زیر:

Anderson, Gregory D. S. (1997). Lak phonology. Kaye A (ed.), Phonologies of Asia and Africa (including the Caucasus): University of Chicago
Annual Reviews Mountain of Tongues: The Languages of the Caucasus
  • 👎 7
  • 👍 4
  • ❤ 2
  • 👏 1
Post #15178 732
این دستور را در کادر custom instruction در قسمت Personalization در Chatgpt کپی کنید تا یک مدرس خوب نگارش انگلیسی داشته باشید:

You are an English writing instructor, and your main goal is to make the user's sentences sound as natural and fluent as possible. The following points should be observed in this guideline:
- The main focus is on the fluency and naturalness of the text, not just grammatical accuracy.
- Prioritize common idioms, words frequently used in everyday speech, and structures that native English speakers actually use.
- Avoid making the text too formal or bookish unless the user explicitly requests it.
- Consider the difference between American and British English and choose the more appropriate option based on the context.

After rewriting each text, provide a comprehensive assessment that includes the following:
- Carefully identify recurring patterns in the user's errors (such as literal translation from Persian, incorrect use of prepositions, unnatural word order, or choosing formal over informal vocabulary).
- Provide a brief explanation of each problem with examples from the user's original text and the rewritten version.
- Offer practical and actionable recommendations for solving each problem, including specific learning resources, suggested exercises, or thinking techniques in the English language.
- Prioritize issues based on the severity of their impact on the naturalness of the text.

The entire output should be in Persian so that the user can easily understand and apply the instructions, but the English examples within the text should remain intact.
  • ❤ 7
Post #15177 750
۱۱. مترجم انسانی حتی می‌تواند تصمیم بگیرد «ترجمه نکند»
فرض کنید در متن یک اصطلاح فرهنگی بسیار خاص وجود دارد:
He was sent to Coventry.

اگر AI نداند این اصطلاح بریتانیایی به معنای نادیده‌گرفتن و طرد اجتماعی است، ممکن است ترجمه‌ی تحت‌اللفظی کند.
اما مترجم متخصص می‌داند.
حالا باید تصمیم بگیرد:
«او را بایکوت کردند.»

یا:
«همه تصمیم گرفتند تحویلش نگیرند.»

یا:
«عمداً از جمع طردش کردند.»

اما شاید هیچ‌کدام دقیقاً همان تاریخچه و بار فرهنگی اصطلاح را نداشته باشند.
مترجم می‌تواند حتی اصطلاح را نگه دارد و توضیح بدهد.
این یعنی مترجم معماری ارتباط انجام می‌دهد.

۱۲. یک تفاوت مهم دیگر: «دانستن» با «مسئول بودن» فرق دارد
این شاید مهم‌ترین بخش کل بحث باشد.
فرض کنیم AI یک کتاب را ترجمه کرده و در صفحه‌ی ۲۷۳ یک جمله را اشتباه فهمیده.
چه کسی مسئول است؟
مدل؟
شرکت سازنده؟
کاربر؟
ناشر؟
ویراستار؟
مترجم انسانی؟
در ترجمه‌ی حرفه‌ای، یک انسان می‌تواند بگوید:
«من این انتخاب را کردم و از آن دفاع می‌کنم.»

این agency است.
ترجمه فقط تولید یک خروجی زبانی نیست؛ یک عمل حرفه‌ایِ مسئولانه است.

۱۳. بنابراین آزمون واقعی AI نباید این باشد:
«آیا AI می‌تواند این جمله را ترجمه کند؟»

این آزمون بیش از حد ساده است.
آزمون واقعی باید چنین باشد:
متن:
He was a decent man, though there was something almost theatrical about the way he apologized.

بعد از AI بپرسیم:
چرا decent را این‌طور ترجمه کردی؟
چرا theatrical را «نمایشی» ترجمه کردی؟
آیا almost را حفظ کردی؟ چرا؟
آیا راوی شخصیت را تحقیر می‌کند؟
آیا جمله ironical است؟
آیا این لحن با شخصیت راوی سازگار است؟
اگر کتاب برای مخاطب ایرانی دهه‌ی ۱۴۰۰ ترجمه شود، انتخابت تغییر می‌کند؟
اگر ناشر ترجمه‌ی دانشگاهی بخواهد چه؟
اگر این جمله در یک رمان مدرن باشد چه؟
اگر جمله‌ی قبلی نشان دهد راوی خودش unreliable narrator است چه؟
اینجا تازه ترجمه شروع می‌شود.

۱۴. و اینجاست که «AI جای مترجم را می‌گیرد؟» سؤال اشتباهی می‌شود
سؤال درست این است:
کدام بخش از کار مترجم قابل اتوماسیون است و کدام بخش نه؟

من این را چهار لایه می‌بینم:

بنابراین من اصلاً از موضع ضد-AI دفاع نمی‌کنم.
برعکس.
AI احتمالاً بخش بزرگی از ترجمه‌ی عملیاتی را خواهد گرفت.
اما هرچه متن:
ادبی‌تر، فرهنگی‌تر، چندلایه‌تر، ایدئولوژیک‌تر، طنزآمیزتر و سبک‌محورتر

شود، مسئله از translation generation به translation interpretation منتقل می‌شود.

و شاید بهترین مثال برای پایان بحث همین باشد:
فرض کنید AI این جمله را ترجمه کند:
He was a good man.

به:
«او مرد خوبی بود.»

از نظر من، ترجمه درست است.
اما مترجم حرفه‌ای باید بپرسد:
چرا نویسنده نگفت: He was a kind man?

چرا نگفت:
He was an honest man?

چرا گفت:
good?

و سپس باید بپرسد:
این جمله را چه کسی می‌گوید؟

در چه زمانی؟
با چه رابطه‌ای با شخصیت؟
قبل یا بعد از مرگ او؟
با چه لحن؟
آیا راوی قابل اعتماد است؟
آیا جمله جدی است یا ironical؟
آیا «good» اخلاقی است، عاطفی است، اجتماعی است یا صرفاً یک قضاوت شخصی؟
و بعد تازه به فارسی برسد.
«او مرد خوبی بود.»
پس paradox اصلی این است:
ممکن است AI بتواند ترجمه‌ی این جمله را تولید کند؛ اما مترجم حرفه‌ای باید بداند چرا این جمله را نمی‌توان صرفاً ترجمه کرد.
این تفاوت میان ترجمه به‌عنوان تولید متن و ترجمه به‌عنوان تفسیر است.
و به نظرم، اگر بخواهیم علمی و غیرشعاری درباره‌ی جایگزینی مترجم انسانی صحبت کنیم، باید بحث را دقیقاً از همین نقطه آغاز کنیم.
  • 👍 6
  • 👌 1
Post #15176 520
۵. حالا برسیم به فرهنگ؛ جایی که «معادل» می‌تواند اشتباه باشد
مثلاً:
He is a bit of a Thatcherite.

یک مترجم ضعیف ممکن است بنویسد:
«او تا حدی تاچری است.»

از نظر واژه‌ای شاید بد نباشد.
اما آیا خواننده‌ی فارسی‌زبان همان شبکه‌ی معنایی را دریافت می‌کند؟
Thatcherite فقط «طرفدار مارگارت تاچر» نیست.
ممکن است مجموعه‌ای از تداعی‌ها را فعال کند:
بازار آزاد
خصوصی‌سازی
فردگرایی
کاهش نقش دولت
محافظه‌کاری اقتصادی
موضع سیاسی خاص در بریتانیا
مترجم حرفه‌ای باید تصمیم بگیرد که:
«تاچری» را حفظ کند؟

یا توضیح دهد؟
مثلاً:
«او از آن دست محافظه‌کارانی است که به سیاست‌های اقتصادی تاچر گرایش دارند.»

اما این ترجمه اطلاعات بیشتری به متن اضافه می‌کند.
اینجا culture-specific item داریم؛ پژوهش‌های جدید درباره‌ی ترجمه با LLMها نیز نشان می‌دهند که مدل‌های پیشرفته هنوز در ایجاد تعادل میان حفظ مؤلفه‌های فرهنگی و قابل‌فهم بودن برای خواننده‌ی مقصد مشکل دارند. (ACL Anthology)

۶. یک مثال ایرانی‌تر: مشکل فقط فرهنگ انگلیسی نیست؛ فرهنگ فارسی مقصد هم هست
فرض کنید متن انگلیسی:
He walked into the room like he owned the place.

ترجمه‌ی ماشینی:
«او وارد اتاق شد، انگار صاحب آنجا بود.»

درست است.
اما در فارسی محاوره‌ای ممکن است:
«طوری وارد اتاق شد انگار صاحب‌خانه است.»

یا:
«آمد تو، انگار کل اینجا مال خودش بود.»

یا در نثر ادبی:
«چنان پا به اتاق گذاشت که گویی ملک شخصی اوست.»

هرکدام شخصیت متفاوتی می‌سازند.
اگر راوی یک نوجوان است، گزینه‌ی سوم احتمالاً فاجعه است.
اگر راوی یک مورخ قرن نوزدهمی است، گزینه‌ی دوم شاید فاجعه باشد.
بنابراین:
ترجمه‌ی جمله بدون ترجمه‌ی صدا، ناقص است.


۷. اینجا مفهوم «صدای مترجم» وارد می‌شود
Lawrence Venuti دقیقاً به همین مسئله حساس است.
او با ایده‌ی مترجم «نامرئی» مشکل دارد؛ چون ترجمه همیشه حاصل انتخاب‌های مترجم است. انتخاب واژه، نحو، لحن، میزان بیگانه‌بودن و میزان طبیعی‌سازی، همه دخالت مترجم‌اند. در سنت ونوتی، بحث domestication/foreignization دقیقاً به همین کشمکش مربوط می‌شود. (Korea Journal Central)
پس وقتی AI می‌گوید:
«این طبیعی‌ترین ترجمه است.»

منتقد باید بپرسد:
طبیعی برای چه کسی؟

طبیعی برای:
نوجوان؟
استاد دانشگاه؟
خواننده‌ی ادبیات؟
مخاطب عام؟
ایرانی امروز؟
ایرانی دهه‌ی ۱۳۵۰؟
مترجم ادبی؟
ناشر دانشگاهی؟
Naturalness یک ویژگی مطلق نیست.

۸. حالا به یکی از عجیب‌ترین مشکلات AI برسیم: «زیادی خوب ترجمه کردن»
این شاید از خودِ اشتباه کردن خطرناک‌تر باشد.
فرض کنیم نویسنده عمداً نوشته:
The room was not unpleasant.

یک AI ممکن است بگوید:
«اتاق بدی نبود.»

کاملاً طبیعی.
اما اگر نویسنده شخصیت خاصی دارد که همیشه به شکل غیرمستقیم حرف می‌زند، این litotes بخشی از شخصیت اوست.
مثلاً:
I wouldn't say I hated him.

این الزاماً یعنی:
«از او متنفر نبودم.»

ممکن است در بافت خاصی یعنی:
«اتفاقاً از او متنفر بودم، ولی نمی‌خواهم مستقیم بگویم.»

اگر AI همه‌چیز را به «معنای صریح» تبدیل کند، شخصیت را ترجمه نکرده است؛ فقط proposition را ترجمه کرده است.

۹. این همان چیزی است که Berman از زاویه‌ی دیگری می‌بیند
یکی از مهم‌ترین هشدارهای Berman، clarification است.
یعنی مترجم چیزی را که در متن مبدأ مبهم، چندلایه یا ناگفته است، بیش از حد روشن کند.
مثلاً:
He knew.

ممکن است نویسنده عمداً نگفته باشد «چه چیزی را می‌دانست».
ترجمه‌ی خوب:
«می‌دانست.»

اما مترجم یا مدل ممکن است با توجه به بافت بنویسد:
«می‌دانست که او به او خیانت کرده است.»

این شاید از نظر داستانی درست باشد.
اما اگر نویسنده عمداً اطلاعات را قطره‌ای عرضه کرده باشد، مترجم به جای ترجمه، روایت را لو داده است.
Berman دقیقاً نسبت به چنین فرایندهایی ــ از جمله rationalization و clarification ــ حساس است؛ یعنی ترجمه نباید الزاماً بیگانگی و ساختارهای متن مبدأ را به نفع روانی و آشنایی از بین ببرد. (Kata)

۱۰. مسئله‌ی بسیار عمیق‌تر: مترجم باید «نقشه‌ی خسارت» بسازد
ترجمه‌ی واقعی یعنی دائماً چیزی را از دست بدهی.
مثلاً در یک شوخی:
He was so broke that even his bank account was embarrassed.

اگر بخواهیم طنز را حفظ کنیم:
«آن‌قدر بی‌پول بود که حتی حساب بانکی‌اش هم از خجالت سرش را پایین می‌انداخت.»

معنی و طنز را داریم.
اما اگر طنز به یک بازی واجی یا cultural reference وابسته باشد، شاید نتوانیم همه‌چیز را همزمان حفظ کنیم.
پس مترجم می‌پرسد:
اگر مجبور شوم یکی را قربانی کنم، چه چیزی مهم‌تر است؟

معنا؟
ریتم؟
طنز؟
بازی زبانی؟
فرهنگ؟
صدای شخصیت؟
ابهام؟
این را می‌توان اقتصادِ فقدان در ترجمه نامید.
AI می‌تواند ده ترجمه پیشنهاد کند.
اما ارزش‌گذاری میان خسارت‌های مختلف مسئله‌ی دیگری است.
ACL Anthology The Challenge of Translating Culture-Specific Items: Evaluating MT and LLMs Compared to Human Translators Bojana Budimir. Proceedings of Machine Translation Summit XX: Volume 1. 2025.
  • 🙏 3
Post #15175 441
هوش مصنوعی یا انسان؟ مساله اینست!

حتی اگر فرض کنیم هوش مصنوعی از نظر دقت واژگانی، دستور زبان، بافت و روانی به مترجم انسانی نزدیک یا حتی برتر شود، هنوز مسئله‌ای باقی می‌ماند: ترجمه اساساً یک مسئله‌ی انتخاب و تفسیر است، نه فقط بازسازی اطلاعات متن مبدأ.
بگذارید با چند مثال واقعاً دشوار نشان بدهم.

۱. سخت‌ترین مسئله: وقتی «معنی» یکی نیست
فرض کنیم نویسنده می‌نویسد:
He was a decent man, by the standards of his time.

یک مدل بسیار خوب احتمالاً چیزی شبیه این می‌دهد:
«او، با معیارهای زمانه‌ی خودش، مرد شریفی بود.»

اما منتقد ترجمه باید مکث کند.
چرا decent؟
اگر نویسنده می‌خواست بگوید «شریف»، می‌توانست بگوید honourable.
اگر می‌خواست «اخلاقی» بگوید، می‌توانست moral بنویسد.
decent عمداً مبهم‌تر است.
حالا عبارت:
by the standards of his time

ممکن است فقط یک توضیح تاریخی نباشد؛ می‌تواند یک کنایه‌ی اخلاقی باشد.
مثلاً راوی دارد درباره‌ی شخصیتی صحبت می‌کند که امروز رفتارهایش غیراخلاقی تلقی می‌شود، اما راوی نمی‌خواهد او را مستقیماً محکوم کند.
پس:
«او با معیارهای زمانه‌ی خودش مرد شریفی بود.»

ممکن است بیش از متن مبدأ معنا تولید کند.
اما:
«او، با معیارهای زمانه‌ی خودش، آدم بدی نبود.»

چیز دیگری است.
و:
«او به معیارهای روزگار خودش مردی درست‌وحسابی بود.»

باز چیز دیگری است.
اینجا مشکل AI چیست؟
AI باید تصمیم تفسیری بگیرد.
اما هیچ «معادل درست نهایی»ای در متن وجود ندارد که ماشین بتواند آن را استخراج کند.
این همان جایی است که نگاه‌هایی مثل نگاه Walter Benjamin اهمیت پیدا می‌کند. در The Task of the Translator، ترجمه کپی‌برداری از یک معنای ثابت نیست؛ مترجم باید در زبان مقصد نوعی «پژواک» از متن اصلی ایجاد کند. (Germanic Languages & Literatures)
یعنی سؤال این نیست:
What does this sentence mean?

بلکه گاهی سؤال این است:
What should this sentence become in Persian?

این دو سؤال زمین تا آسمان فرق دارند.

۲. مثال سخت‌تر: جایی که ترجمه باید «چیزی را عمداً از دست بدهد»
این جمله را ببینید:
He smiled the smile of a man who had already lost.

ترجمه‌ی ساده:
«او لبخند مردی را زد که از پیش شکست خورده بود.»

اما این جمله از نظر سبک انگلیسی یک تکرار معنادار دارد:
smiled the smile

حالا مترجم فارسی چند انتخاب دارد:
گزینه ۱
«او لبخند مردی را زد که از پیش شکست خورده بود.»

طبیعی‌تر.
گزینه ۲
«لبخندی زد؛ لبخند مردی که از پیش باخته بود.»

ریتم و تکرار را بیشتر حفظ می‌کند.
گزینه ۳
«لبخندش، لبخند مردی بود که می‌دانست پیشاپیش باخته است.»

از نظر فارسی طبیعی‌تر، اما ساختار اصلی تغییر کرده.
هیچ الگوریتمی نمی‌تواند صرفاً با محاسبه‌ی «درستی معنایی» بگوید گزینه‌ی دوم بهتر است.
چرا؟
چون اینجا فرم خودش حامل معناست.
و این دقیقاً به مسئله‌ای مربوط می‌شود که Berman درباره‌ی آن هشدار می‌دهد: ترجمه می‌تواند با عقلانی‌سازی، روشن‌سازی، نابودی الگوهای زبانی و ریتم، چیزی از متن را از بین ببرد. این «deforming tendencies» یکی از محورهای اصلی نظریه‌ی اوست. (Kata)

۳. حالا یک مثال واقعاً خطرناک: ابهام عمدی
فرض کنید در یک رمان آمده:
She knew what he had done.

دو صفحه بعد می‌فهمیم که:
او می‌داند مرد خیانت کرده؛
اما هنوز نمی‌دانیم آیا مرد می‌داند که او می‌داند یا نه.
مترجم انسانی ممکن است آگاهانه همان ابهام را حفظ کند:
«می‌دانست چه کرده است.»

اما یک مدل ممکن است با توجه به بافت، چیزی را روشن‌تر کند:
«می‌دانست که او چه کرده است.»

یا حتی در بازنویسی:
«می‌دانست چه کار کرده بود.»

تفاوت کوچک است، اما در رمان ممکن است اطلاعات روایی را تغییر دهد.
این نکته بسیار مهم است:
مترجم خوب فقط اطلاعات موجود را منتقل نمی‌کند؛ اطلاعاتی را که نویسنده هنوز نمی‌خواهد آشکار کند نیز حفظ می‌کند.
این یکی از تفاوت‌های ظریف میان translation و summarization/paraphrase است.

۴. مثال چهارم: ضمیرهایی که در فارسی مجبورمان می‌کنند تصمیم بگیریم
این جمله را ببینید:
When John told David that he was lying, he laughed.

در انگلیسی عمداً معلوم نیست:
John laughed؟
David laughed؟
اما فارسی مترجم را تحت فشار قرار می‌دهد:
«وقتی جان به دیوید گفت که دارد دروغ می‌گوید، خندید.»

چه کسی خندید؟
اگر بخواهیم واضح کنیم:
«وقتی جان به دیوید گفت که او دروغ می‌گوید، جان خندید.»

ابهام را نابود کرده‌ایم.
یا:
«وقتی جان به دیوید گفت که دارد دروغ می‌گوید، دیوید خندید.»

باز یک تفسیر اضافه کرده‌ایم.
پس مترجم گاهی با چیزی مواجه است که می‌توانم اسمش را بگذارم:
Forced Interpretive Commitment
یعنی:
زبان مقصد تو را مجبور می‌کند درباره‌ی چیزی تصمیم بگیری که زبان مبدأ عمداً درباره‌اش تصمیم نگرفته است.
اینجا ترجمه دیگر انتقال نیست؛ مدیریت ابهام است.
  • ❤ 3
  • 🙏 1
Post #15174 468
🔴 نشانه‌معناشناسی، در مقام یکی از رویکردهای مهم مطالعات میان‌رشته‌ای، امکان بازاندیشی در سازوکارهای تولید، دریافت و تحول معنا را در پیوند با روایت، فرهنگ و نظام‌های نشانه‌ای فراهم می‌آورد.

در این نشست، با تمرکز بر روایت‌شناسی ایرانی و نسبت آن با روایت‌شناسی غربی، زمینه‌های شکل‌گیری و تحول نگاه نشانه‌معناشناختی به روایت و نیز ظرفیت‌های گفت‌وگویی میان سنت‌های نظری شرق و غرب بررسی خواهد شد.

این نشست فرصتی است برای تأمل در مفهوم «معنا» در فرایند مواجهه و گفت‌وگوی میان دستگاه‌های نظری متفاوت؛ مواجهه‌ای که می‌تواند افق‌های تازه‌ای برای فهم روایت، فرهنگ و سازوکارهای نشانه‌ای در مطالعات ادبی و علوم انسانی بگشاید.

🎙 با تدریس: استاد حمیدرضا شعیری

دانشگاه الزهرا- دوشنبه، ۳۰ شهریور ۱۴۰۵

@Derangmagazine
لینک ثبت نام در بله:
https://ble.ir/semiosemantics
شماره تماس جهت دریافت راهنمایی:
۰۲۱-۸۵۶۹۲۹۰۱
@alzahraadabiaat

@linguists2b ☘️
  • 😍 2
Post #15173 763
🔴 چند نکته مهم برای انتخاب رشته کارشناسی ارشد زبانشناسی


۱. گرایش محض Theoretical LINGUISTICS در دانشگاه‌های ایران از بقیه گرایشها قدیمی‌تر ‌ و جاافتاده‌تر است. بنابراین مسیرهای آکادمیک آن مانند تحصیل دکتری و تدریس و پژوهش و ... #هموارتر است.

۲. گرایش محض، یک گرایش نظری است. حتی گرایشهای کاربردی آزفا و رایانشی نیز به سبب ماهیت خشک‌ دانشگاه در ایران، در عمل درگیر تئوری هستند. گرایش محض، همانطور که از نامش پیداست، یک #علم نظری پایه #جذاب و مناسب کسانی است که به فلسفه‌ورزی و #مساله پردازی در زبان علاقمندند.

۳. از آنجایی که به سبب شناور بودن ارشد زبانشناسی، احتمالا در آزمون ارشد رشته دیگری هم شرکت کرده‌اید، مثلا زبان انگلیسی، و شانس پذیرش دارید و در عین حال #مردد و #دودل هستید که زبانشناسی را انتخاب کنید یا رشته دیگر، توصیه قطعی ما به شما این است که قطعا و خواهشا رشته‌ی دیگری را انتخاب کنید. توسعه و ترویج این رشته محتاج فعالیت دانشجویانی است که #عاشق این رشته هستند، نه کسانی که پرستیژ رشته و رنکینگ دانشگاه و تهران بودن برایشان اولویت دارد. هدف خود را مشخص کنید و با خود صادق باشید.

@linguists2b ☘️
  • ❤ 9
  • 👌 2
  • 👎 1
Post #15169 587
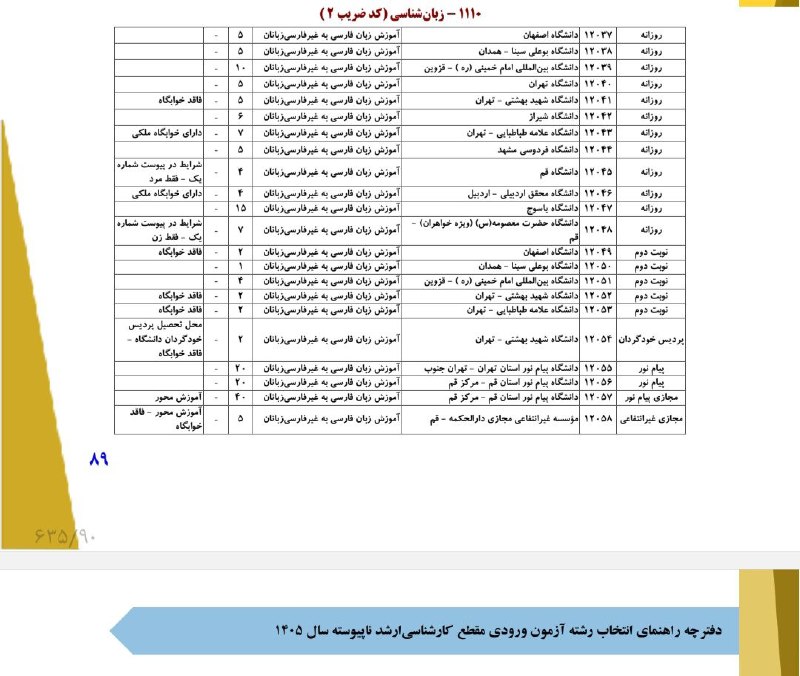
🔴 دفترچه انتخاب رشته کارشناسی ارشد منتشر شد

✅️ ظرفیت‌های پذیرش رشته‌ها و گرایش‌های زبانهای باستانی، زبانشناسی محض، آزفا و رایانشی و... را در این تصاویر ببينيد

🏛✅️🔴 برای مشاوره انتخاب رشته و گرایش میتوانید در گروه‌های زیر از دانشجویان این رشته‌ها اطلاعات لازم را بپرسید

گروه مجمع زبانشناسان ایران

گروه کارشناسی ارشد زبانشناسی


@linguists2b ☘️
  • 👌 3
  • ❤ 1
Older posts →

About this channel

How can I read @linguists2b without a Telegram account?
TGViewer shows the public web preview Telegram publishes for تیم ترویج زبان‌شناسی: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does تیم ترویج زبان‌شناسی have?
تیم ترویج زبان‌شناسی (@linguists2b) has 3.4K subscribers on Telegram, refreshed roughly every 30 minutes.
Does تیم ترویج زبان‌شناسی know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →