TGViewer
Channel Public Channel
Kotelok

Kotelok

@kotelok_longread

Паблик для анонсов длинных текстов
Subscribers
318
Photos
140
Videos
0
Links
95

Showing posts older than #96 · Back to latest

Older Posts 18 shown
Post #95 197
В этом есть определённая ценность (продолжение)

На основании данных из опросов выше исследователи Р. Инглхарт и К. Вельцель составили два важных индекса.
- Шкала "Ценности выживания/ Самовыражения". Если очень грубо обобщать, то чем больше этот индекс, тем выше вера в технический прогресс, права человека, экономический рост. Если индекс низкий, то у носителя в приоритете вопросы безопасности, но вероятна ксенофобия.
- Шкала "Традиционные/Секулярно-рациональные ценности". Чем выше этот индекс, тем выше ценность, например, достижения личного успеха. Низкое значение индекса предполагает, например, высокую роль семьи.

Вы вполне могли видеть диаграмму Инглхарта-Вельцеля, где страны распределяются по средневзвешенному значению этих индексов.

Чем же эти индексы хороши?

Утверждается, что у них высокая предсказательная сила. По сочетанию этих индексов можно предсказать мнение личности по широкому ряду вопросов.

Как следствие, респонденты по этим индексам очень хорошо кластеризуются в культурные группы. Например, все арабские страны похожи друг на друга, Латинская Америка отличается от всего мира и так далее.

А ещё индексы хороши своей компактностью. Для их определения не нужно задавать много вопросов.

Ну что, проверим социологию на прочность?
  • 🔥 4
  • 🫡 2
Post #94 166
В этом есть определённая ценность

Давайте поговорим о ценностях. Люди бывают разные, кто-то ценит одно, кто-то - прямо противоположное. Эти ценности очень сильно влияют на наши поступки.

А ещё ценности между собой как-то связаны. Например, если среди ценностей американца окажется такое понятие как "ходить в церковь", то, с очень большой вероятностью, среди его ценностей не будет "права на аборты".

Как это работает? Лучшие умы пытались ответить на этот вопрос, строили различные теории. К сожалению, проверку практикой прошли далеко не все.

Например, логично предположить, что набор ценностей как-то связан с политической позицией. Если ты сочувствуешь социал-демократам, то, наверное, ценности социальной справедливости должны играть в твоей жизни какую-то заметную роль.

К сожалению, не всё так просто. Под знамёнами тех или иных политических течений оказываются люди с разным набором ценностей. А непримиримые, на первый взгляд, враги могут быть согласны друг с другом по большинству вопросов.

Я хочу внимательно рассмотреть одну попытку объяснить и классифицировать человеческие ценности напрямую - через серию опросов по всему миру. Эту попытку назвали Всемирным обзором ценностей.

На данный момент это 7 волн очень хороших с методологической точки зрения опросов по всему миру. Выборки - большие, представительство - разнообразное, сырые данные опросов - открытые, формулировки вопросов - умные.

Для понимания уровня. Там есть поля, в которых отмечено
- какое вознаграждение получил респондент за участие в опросе,
- насколько сильно респонденту было всё равно,
- был ли в помещении опроса ещё кто-то посторонний.

Это очень хороший материал, который поможет ответить на многие вопросы о нас.
  • 🔥 6
Post #93 183
И вот оно интервью!

Михаил Водолагин очень долго руководил командами дата саентистов и аналитиков, строил команды с нуля, внедрял аналитические системы. CDOдля него - уже пройденный этап.

Надеюсь, вам будет интересно!

Жду ваших огонёчков и обратной связи. Как по этому интервью, так и по формату в принципе
kotelok.info Михаил Водолагин: "Люди умудряются выстрелить себе в ногу очень по-разному!" Интервью с Михаилом Водолагиным, ex-CDO ряда больших компаний об аналитике, найме, нейросетях, карьере.
  • 🔥 10
  • 👀 2
  • 🐳 1
Post #92 188
Завтра вечером на канале будет интервью!

Интервью вышло длинное, интересное, весёлое. Выделяйте время, запасайтесь попкорном.

Задавать вопросы я будут человеку, который имеет широкий опыт в
- машинном обучении,
- аналитике данных,
- управлении людьми,
- построении дата-команд с нуля.
Эмпатия и чувство юмора тоже на месте.

Будем обсуждать
- что общего у аналитиков и дата инженеров
- разные аспекты найма специалистов в наше необычное время
- какие навыки нужны, чтобы стать лидером команды (в разных смыслах)
- какие подводные камни появляются на самом высоком уровне управления
- не забудем обсудить нейросети
- без рекомендаций по контенту мы тоже не останемся

Надеюсь, вам будет интересно!
  • 👀 7
  • ⚡ 3
  • ❤‍🔥 1
  • 🔥 1
Post #90 233
#мемасик
Возможно, автор переоценивает знание культуры возрождения
  • 😁 2
Post #89 184
Ошибка выжившего. Рейтинг и ретеншн

Представьте себе, что вы играете в какую-то популярную онлайн игру, сутью которой является прямое противостояние участников один в один. Например, шахматы.

Давайте представим себе, что сила игроков считается тут с помощью системы, похожей на рейтинг ЭЛО.
Совсем в двух словах: если ты побеждаешь, то получаешь плюс к рейтингу (и чем противник сильнее, тем этот плюс больше), если проигрываешь, то минус (и чем противник слабее, тем страшнее минус).

И вот, по идее, если ты сталкиваешься с игроком с низким рейтингом, он должен играть слабо. Но с очень большой вероятностью, этот игрок покажет высокий результат. И, неожиданно, чем ресурс популярнее, тем эта вероятность выше!

Как так?

Игрок с низким рейтингом - это такой игрок, который проиграл много раз. Он либо слабый, либо ему просто сильно не повезло. Если ресурс популярный, у него есть ядро, число игроков, которые там зависают давно. И размер этого ядра больше числа новичков, которые приходят.

Вот вы - новичок, играете слабо (или вам не повезло). И вот у вас через из большого числа поражений. Что, с наибольшей вероятностью вы сделаете? Скорее всего, вы бросите эту дурацкую игру и пойдёте читать Котелок заниматься своими делами.

Вероятность того, что какой-то старожил рано или поздно поймает череду поражений, невероятно высока. Но на то он и старожил, что вероятность того, что он уйдёт, не так велика.

Что это значит? Если брать всё множество игроков с низким рейтингом, там будет большинство слабых игроков. Но если брать множество тех, кто хочет сыграть прямо сейчас и имеет низкий рейтинг, то там большинство составят сильные игроки.

Да, с этим можно бороться. И просить указать свой рейтинг новичку. И всякие туториалы, уровни, ачивки.

Но суть не меняется: нам недоступна вся выборка игроков с низким рейтингом, а только тех, кто готовы играть, так что ошибка выжившего в полной мере.

Какой практический вывод? Брюс Ли был прав.
  • 🔥 2
  • 🤔 1
Post #87 165
Ошибка выжившего. Какой чай вы любите?

Представьте себе классический офис на 20+ человек. В этом офисе есть кулер, печеньки и две коробки с чайными пакетиками, в одной коробке лежат заготовки для чёрного чая, в другом - для зелёного.

Теперь давайте представим на минуту, что в этом конкретном офисе подавляющее большинство любит чёрный чай. Буквально через неделю типичная картина на чайном столе будет следующая: полная коробка зелёного чая и 1-2 пакетика чёрного.

Если зашедший в офис гость, посмотрев на эту картину, решит, что тут больше любят зелёный чай (смотрите как его много!), он совершит классическую ошибку выжившего. Он сделает выбор по доступной ему выборке, а не по полной.
  • 👍 6
  • 👀 1
Post #86 143
Ошибка выжившего. Новые примеры

Есть такая известная вещь, как ошибка выжившего.

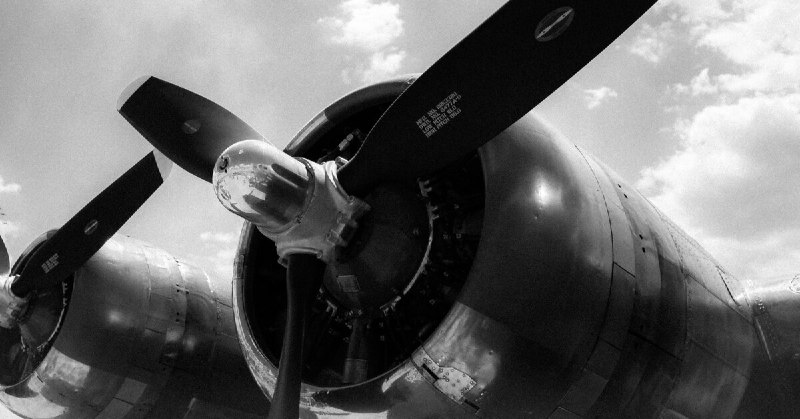
Чаще всего рассказывают на примере данных о самолётах второй мировой.

Пример интересный и драматичный, как всегда, когда решаются вопросы жизни и смерти. Если не знакомы, обязательно прочитайте.

Приведу пару примеров, более близких к нашей жизни.
www.techinsider.ru «Ошибка выжившего»: как венгерский математик спас жизни сотен летчиков во времена Второй мировой войны Математики, физики и инженеры не раз становились героями военных действий, разрабатывая технику, совершенствуя оружие, подбирая нужные патроны и расшифровывая вражеские шифры. Венгерский статистик Абрахам Вальд во времена Второй мировой войны подсказал американцам…
  • 👍 3
Post #85 162
Кто-то будет завтра на конференции Матемаркетинг? Если планируете - напишите, пообщаемся очно.
  • 🤔 1
Post #83 208
Аналитическая машинка для "Что? Где? Когда?"

Я много играю в спортивное "Что? Где? Когда?" (ЧГК) и, конечно, не могу не включить какую-то аналитику для улучшения игры или хотя бы впечатления от неё. Сапожник с сапогами, получается.

Одной из популярных (не вообще не факт, что полезных) форм досуга в перерывах на турнирах по ЧГК является попытка найти ответ на вопрос "что же мы упустили?". Игроки общаются с представителями других команд, пытаются восстановить текст того или иного вопроса и понять, как же так сложилось.

Занятие это неблагодарное и малоэффективное. Но вообще разобраться в том, что пошло не так, конечно, полезно.

Давным-давно я писал статью , в которой вводил такое понятие как "творческая команда". Это такая команда, которая берёт сложные вопросы, но упускает простые.

Было даже обобщение, которое мало кому понравилось:
В каждом туре команда реально играет примерно 3 вопроса, которые определяют её силу. Для каждой команды это разные вопросы и никто наверняка не знает, как они будут


С тех пор технологии ушли вперёд и API турнирного сайта выдаёт гораздо больше, за что большой респект команде, которая его поддерживает.

Теперь можно вывести эти самые вопросы в явном виде, причём без подключения машинного обучения, как это было в стародавние времена.

У нас есть результат команды на конкретном вопросе в конкретном турнире. У нас есть сложность этого вопроса (то есть число команд, которые этот вопрос взяли). Как из этих данных получить наши ожидания и наши проблемы?

Делаем важное приближение: вероятность взятия вопроса зависит от силы команды, который определяется её рейтингом. Звучит достаточно очевидно, но в общем случае это, конечно, не так. Например, даже у сильной команды может не быть определённых знаний. Тем не менее, как стартовая гипотеза приемлемо.

Тогда что у нас получается?

Вероятность того, что команда возьмёт данный вопрос = сложность вопроса * рейтинг команды / средний рейтинг турнира.


Если мы из фактического результата (1, если взял, 0, если не взял) отнимем эту вероятность, мы как раз и получим контраст ожиданий.

Как это работает. Возьмём команду подписчика этого канала под названием Правый Зелёный. Возьмём какой-нибудь турнир с их участием, например, массовый синхронный турнир Лига Плюша-9: Совунья.

Средний рейтинг участников этого турнира - 4811 (это примерно 850 место мирового рейтинга). Рейтинг команды, которую мы рассматриваем, на данном турнире - 6406 (это примерно 230 место мирового рейтинга), то есть сложность мы будем домножать на 6406 / 4811 = 1.33

Например, вопрос №1. Его взяли 69% команд. Значит, ожидаемая вероятность того, что команда Правый Зелёный его возьмёт - это 69 * 1.33 = 92%. Такое вот простое неправильное, но рабочее приближение.

Полный список "особенных" вопросов данной команды в данном турнире:
- вопросы № 31, 6, 19 - это epic wins, команда не должна была брать эти вопросы, но взяла, это круто. Тут они молодцы.
- вопросы № 1, 11, 8, 7, 22,4,23 - это продолбы, по прогнозу, команда эти вопросы должна была брать, но не вышло. Тут зона роста.

Если из 7 продолбанных отнять 3 эпика, то будет резульат -4 взятых: именно столько отделяет команду от её прогнозного места.

Если бы команда справилась с названными выше вопросами, то сыграла бы "в ноль". А если бы смогла при этом ещё и сохранить свои эпики, то сыграла бы на уровне команды, которая занимает сейчас 130 место в мировом рейтинге. Такая быстрая оценка текущего потенциала состава на одном турнире.

Есть пища для размышлений, согласитесь?

Минусы у подхода, конечно, есть.
- У синхронных турниров расплюсовка приходит достаточно поздно, уже забываешь, что там было, но для очников никаких проблем обычно нет
- Тексты вопросов появляются ещё позже, надо просить пакет у ведущего. Или иметь в команде человека, который нормально записывает вопросы
- Не даёт автоматического улучшения навыка. Надо хотеть разбираться, анализировать вместе с командой. В сочетании с записью обсуждения на микрофон выходит интересно.

Какие у вас мысли? Как эту простую логику можно обогатить?
  • ❤ 2
  • 🔥 2
  • 🤔 1
  • 😱 1
Post #82 190
Ещё одна #байка, близкая к реальной жизни.

Числа все проставлены произвольно, не имеют никакого отношения к реальным показателям никакого бизнеса, все сходства - совпадения.

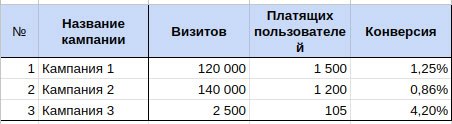
Провёл какой-то бизнес три разные рекламные кампании, получил результаты как на картинке. А потом, ход конём, ответственный гордо говорит о том, что итоговая конверсия всех рекламных кампаний больше 2%.

Как он это получил? Ну вот есть три кампании, у них конверсии 1,25%, 0,86%, 4,2%. В среднем 2,1%. Мы молодцы!

Так делать, конечно, нельзя просто по правилам арифметики. И среднюю скорость так считать тоже нельзя.

В данном случае мы видим две большие кампании, которые привели много платящих с "обычной" конверсией около 1%. И имеем одну кампанию с маленькими охватами, но очень высокой конверсией. Как так вышло? Могут быть разные варианты, но скорее всего, это была кампания на более узкую, но более готовую к покупке аудиторию. Здорово, что так получилось. Но, скорее всего, если бизнес попробует масштабировать кампанию №3 на более широкие охваты, то получит снижение конверсии, увы.

А как правильно посчитать итоговую конверсию?

Вообще это делать необязательно, это будет та самая "средняя температура по больнице": усреднение очень разных показателей (кампаний "на охват" и "целевых" кампаний), результат которого даст мало информации о ситуации сейчас и ещё меньше о ситуации завтра. Так что мы имеем полное право не считать среднюю конверсию вообще.

Но если очень надо, то арифметика простая: 1) складываем всех платящих (надеюсь, у нас один человек не может быть привлечён несколькими кампаниями одновременно, но это отдельный долгий разговор), 2) складываем всех посетителей, 3) делим одно на другое.

В результате шикарный эффект маленькой кампании практически не будет заметен: итоговая конверсия всех кампаний будет 1,07% (и будет соответствовать средней конверсии по рынку по данным некоторых источников).

Похоже, это неинтуитивно, потому что похожую ошибку делали при мне десятки очень умных людей. Но против арифметики не попрёшь.

Что можно тут сказать? Проверять даже банальные вещи на калькуляторе (или на тайной вкладке в экселе) не стыдно и совершенно нормально.

Поделитесь в комментариями похожими случаями в вашем опыте?
  • ❤ 6
Post #81 143
#мемасик для тех, кому про музыку и футбол совсем неинтересно
  • 🐳 4
  • ❤‍🔥 1
Post #80 159
Финты справедливости (продолжение)
Целый ряд сильных игроков, в том числе Родриго Касканте попросили меня написать ещё один фрагмент в этой серии.

Да, мы смогли оцифровать справедливость. Да, мы поняли, что не так уж и важно упарываться по формату. Но всё-таки, хочется иметь хороший турнир и не играть бесконечное количество матчей, как в круговике.

Можно ли найти какой-то формат, оптимальный как по справедливости, так и по числу игр?

Самое простое - это разделить наш "индекс справедливости" на число игр в турнире. Типа, да, признаём, "круговик" у нас в 2,9 раз более справедлив, чем случайный турнир, но игр пришлось сыграть в 3,2 раза больше. Получается, не так уж и круто.

По этому показателю, ожидаемо, с отрывом будет лидировать игра на вылет. Очень мало игр, зато все - самый сок.

И, на самом деле, особо опций не так много. Единственный формат, в котором можно попробовать найти оптимум - это швейцарская система. Там можно менять число туров произвольно. Возможно, где-то баланс сойдётся.

Оказалось, теоретики не дураки. Та самая формула, по которой нужно считать число матчей - она как раз про баланс справедливости и числа матчей.

При увеличении числа туров индекс справедливости швейцарки не растёт, а при очень большом - может и упасть. Большое чтение логов помогает объяснить почему. При большом числе туров лидеры уже сыграли друг с другом, начинаются поиски оптимального соперника, который находится всё ниже и ниже. И это перестаёт быть той "швейцаркой", что мы знаем (играешь против тех, кто играет примерно как ты) и начинается быть больше похожим на случайный турнир. А вес первого и последнего тура одинаковый. Вот индекс и падает.

Так что никакой волшебной таблетки.

Кто сказал МакМагон?
#футбол #аналитика
Post #78 138
Финты справедливости (продолжение)
Моделирование подтвердило наши интуитивные представления.

Есть хороший формат (круговик), который более чем в два раза более справедлив, чем другие.

Другие форматы больше чем в два раза лучше, чем просто случайный набор матчей. А вот разница форматов между собой не такая уж и большая. Например, добавление группового этапа улучшает меру справедливости по сравнению с обычной игрой на вылет всего на 24%

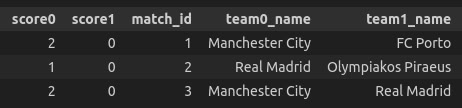
В табличке для иллюстрации кроме абстрактного индекса добавил ещё и простую метрику: шансы рейтинг-фаворита занять первое место.

У вас ещё остались вопросы, почему у Манчестер Сити с момента прихода шейхов только одна победа в лиге чемпионов, зато 8 побед в чемпионате Англии?

В заголовок поста вывел тепловую карту круговика, для остальных турниров - будет в комментариях.
  • 🔥 1
Post #75 151
Финты справедливости (продолжение)
Комбинированная система


Это та система, по которой проводилась раньше лига чемпионов, и до сих пор проводятся чемпионаты мира и Европы: сначала круговой турнир, но в малых группах, потом игра на вылет.

На всякий случай, сделал формат "швейцарка + плей-офф". Так мало где играют, но вообще может быть весело.

Все перепетии смотреть не будем, посотрим, где играет полуфинал\финал.

Турнир 1. Классика: 2 группы + на вылет.
3 и 4 места посева не вышли из группы. В финале наши частые гости.

Турнир 2. Упоротый: одна группа на 8 команд, 4 лучшие выходят в полуфинал.
Никаких сенсаций: лучшие 4 вышли из группы. Две лучшие в финале.

Турнир 3. Лига чемпионов здорового человека: швейцарка + на вылет.
Порту не вышел из группы. Две лучшие в финале.
#футбол #аналитика
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →