TGViewer
Channel Public Channel
dev notes

dev notes

@junsenior

Пишу про Go, Vim, и про то, как я медленно ползу в сторону FAANG.

С предложениями: @junsenpub
Subscribers
1.39K
Photos
33
Videos
6
Links
189

Showing posts older than #192 · Back to latest

Older Posts 20 shown
Post #191 1.42K
Как я уже писал выше - перечитываю "Высоконагруженные приложения" и кидаюсь в вас конспектами с самым соком. К слову, зачем читать книгу второй раз? Лично для себя открыл, что второе чтение оставляет в памяти максимальное количество полезной информации (а параллельное конспектирование основных тем - цементирует прочитанное). Прочитав же 1 раз - в течении пары месяцев 90% забывается.

Итак, сегодня у нас 3-я глава: подсистемы хранения данных. Клеппман описывает, как и на основе чего устроены индексы в современных СУБД и раскрывает 2 основные структуры данных, на основе которых индексы строятся. Зачем это знать? Во-первых, на больших нагрузках нужно понимать, как оптимизировать или скорость, или чтение индексов, в зависимости от задачи. Во-вторых, понимание того, как устроены индексы полезно для выбора СУБД на очередной проект. В-третьих, это просто очень интересно :)
Глава большая, поэтому ниже - конспект первой половины.

Любые индексы в реляционных СУБД, как правило, замедляют запись. Индексы надо подбирать так, чтобы чтение было быстрым, но и запись осталась быстрой.

При любой записи на диск - индекс тоже обновляется, всегда.

Хеш-индексы - индексы, на основе hash-таблицы - один из самых распространённых типов индексов. Например, так работает подсистема хранения Bitcask в NoSQL СУБД Riak.

Уплотнение (compaction) сегментов журнала - операция, отбрасывающая дублирующиеся ключи и сохраняющая только последний ключ, тем самым уменьшая дисковое место, занимаемое файлами журнала. Уплотнённые сегменты, если их размер значительно уменьшился - можно слить между собой.

SS-таблица
Отсортированная строковая таблица (sorted string table, SS-таблица) - отсортированная по ключу таблица, хранимая на диске, где каждый ключ встречается 1 раз (благодаря автоматическому процессу уплотнения и слияния сегментов). Преимущества перед журнальными сегментами с хеш-индексами:
1. Объединение сегментов выполняется просто и эффективно, благодаря тому, что сегменты отсортированы. При слиянии мы читаем сразу все сегменты, и оставляем последний записанный ключ в результирующем сегменте.
2. Чтобы найти в файле конкретный ключ, не нужно хранить индекс всех ключей в оперативной памяти. Если мы знаем индекс соседних ключей от искомого - точно можно сказать, что он будет между ними, и нам достаточно посмотреть срез данных между соседями.
3. Блоки, на которые есть индексы в ОП можно сжимать пачками по несколько килобайт, так как расжать и просмотреть несколько Кб данных можно очень быстро.

Красно-чёрные деревья или AVL-деревья позволяют записывать ключи в любом порядке, а читать только в нужном.
Процесс записи в SS-таблицу выглядит так:
1. При поступлении записи помещаем её в оперативной памяти в сбалансированную структуру данных, например в красно-чёрное дерево.
2. Когда размер записи превышает определённое пороговое значение, например несколько мегабайт, записываем его на диск в фиде файла SS-таблицы. Это операция выполняется достаточно быстро, так как записи на выходе отсортированы. Файл становится последним сегментов базы данных.
3. При поиске данных сначала ищем их в memory-сегменте, если там нет, то в последнем, затем в предпоследнем и так далее.
4. В фоне время от времени запускается процесс уплотнения и слияния данных.
5. Так же на диске нужно держать отдельный журнал - копию со всеми записанными в memory-таблицу данными, чтобы в случае фатального сбоя восстановить memory-таблицу.

А это вообще где-то применяется, спросишь ты? Да, например в levelDB и rocksDB - библиотеках, которые можно юзать сами по себе, а можно в рамках других СУБД. Так, levelDB используется в СУБД Riak. Аналогичные системы используются так же в Cassandra и HBase.

Подсистемы хранения, основанные на принципах слияния и уплотнения, часто называют LSM (Log-Strucrured Merge-Tree) подсистемами.

Часто с LSM-системами используют фильтры Блума - структуру данных, позволяющую узнать, есть ли в множестве заданный элемент. Это позволяет не просматривать все сегменты в поисках элемента, которого в них нет.
Post #190 1.48K
Почему ещё НЕ следует использовать документоориентированные СУБД: если документ большой, то при update требуется перезаписать весь документ (невозможно внести локальные изменения)
Некоторые драйверы для MongoDB разрешают, автоматически, ссылки на БД как в реляционных СУБД.

Декларативные языки (SQL, напр.) могут автоматически задействовать параллельную реализацию языка запросов, что гораздо сложнее сделать в случае с императивным описанием.

MapReduce - модель программирования для обработки большого количества данных от Google. В ограниченном виде поддерживается MongoDB и CouchDB в качестве механизма, выполняющего только чтение запросов по многим документам.
Например, аналогичные запросы в PostgreSQL и MongoDB с использованием mapreduce:
SQL:
SELECT date_trunc('month', observation_timestamp) as observation_month,
sum(num_animals) as total_animals
FROM observations
WHERE family = 'Sharks'
GROUP BY observation_month;

MongoDB с mapreduce:
db.obsercations.mapReduce(
// вызывается однократно для каждого документа
function map() {
var year = this.observationTimestamp.getFullYear()
var month = this.observationTimestamp.getMonth() + 1;
emit(year + '-' + month, this.numAnimals) // на выходе порождает строку вида (дата, кол-во животных)
},
function reduce(key, values) { // все пары из map автоматически группируются по ключу (т.е. с одной и той же датой)
return Array.sum(values); // для них однократно вызывается reduce, суммирующий количество животных
},
{
query: { family: "Sharks" }, // отсеиваем только акул декларативно, это расширение MongoDB модели MapReduce
out: "monthlySharkReport" // итоговые результаты записываются в коллекцию minthlySharkReport
}
)

map и reduce должны быть чистыми, т.е. могут только выполнять однозначную работу и передавать данные, но не могут делать доп. запросы

В Mongo с версии 2.2. добавлена поддержка декларативного описания запросов - конвейер агрегирования, где тот же запрос будет выглядеть так:
db.observations.aggregate([
{ $match: { family: "sharks" } },
{ $group: {
_id: {
year: { $year: "$observationsTimestamp" },
month: { $month: "$observationsTimestamp" }
},
totalAnimals: { $sum: "$numAnimals" }
} }
])
Post #189 1.47K
Спрашивают тут, куда пропал: никуда не пропадал, просто было много работы и параллельно пилил небольшой пет-проект, который продолжаю пилить по мере времени.
Тем временем, спустя несколько месяцев после первого прочтения "Высоконагруженных приложений" решил перечитать и забить в памяти интересные моменты. Пока успешно повторил и законспектировал 2 главы, и ниже представляю краткий конспект главы "Модели данных и языки запросов". На днях будет конспект 3-ей главы: "Подсистемы хранения и извлечения данных".

Какие причины широкого внедрения NoSQL-решений?

1. Потребность в бОльшей масштабируемости, чем у реляционных СУБД: возможность обрабатывать очень большие объёмы данных и возможность большой пропуской способности
2. Открытый исходный код
3. Некоторые запросные операции, плохо поддерживаемые реляционной моделью
4. Стремление к более динамичным моделям, выходящим за рамки реляционных схем

Какой вопрос стоит себе задать чтобы понять, можно ли для набора информации использовать документоориентированную СУБД?
- Вполне очевидный: является ли самостоятельным документом набор информации?

Извлекая документ (например, резюме), представленное в реляционном виде, придётся сделать множество запросов (к каждой таблице по внешним ключам). Если документ лежит в документоориентированной базе, то его можно извлечь одним запросом.

Идея исключения полного дублирования (напр, хранение внешних ключей вместо строк) лежит в основе нормализации баз данных
ЭМПИРИЧЕСКОЕ ПРАВИЛО: если значения, которые могут храниться в одном месте - дублируются, то база НЕ НОРМАЛИЗОВАНА

В древовидной структуре, которую пропагандирует документоориентированная модель, соединения (по внешним ключам) - не нужны, и их поддержка очень слаба (сложно сделать свзяь многие-к-одному (напр, многие люди к одному городу))
Соединения поддерживаются в RethinkDB, не поддерживаются в MongoDB и поддерживаются в заранее описанных представлениях в CouchDB.

В реляционных СУБД оптимизатор запросов автоматически принимает решение о том, в каком порядке выполнять запрос, и делает это так, чтобы это было максимально эффективно. В случае, если был объявлен новый индекс - оптимизатор запросов перестраивает логику выполнения запроса.

Основные доводы в пользу документноориентированных СУБД - гибкость схемы, лучшая производительность вследствие локальности и большая близость к применяемым структурам данных (не всегда). Реляционная модель отвечает на это лучшей поддержкой соединений, а также связей "многие-к-одному" и "многие-ко-многим".

Если структура приложения представляет собой дерево связей "один-ко-многим", причём всё дерево загружается сразу - документоориентированная модель - ОК.
Если в приложении используется множество связей "многие-ко-многим", то документоориентированная модель не так привлекательна. Количество соединений можно снизить за счёт денормализации, но придётся написать больше кода для поддержки согласованности. Соединения эмулируются в коде, а не в СУБД, что обычно медленнее, чем через СУБД.

Документоориентированные базы не требуют проверку схемы и часто их называют бессхемными. По-факту, они проверяют схему при чтении (schema-on-read), в отличии от проверки схемы при записи в реляционных СУБД (schema-on-write). Схема при чтении аналогично динамической проверке типов в ЯП, в то время как схема при записи аналогична статической (во время компиляции) проверке типов.

MySQL - известный пиздец, когда требуется выполнить alter table. Есть утилиты, которые позволяют сделать это более комфортно:
* https://www.percona.com/software/database-tools/percona-toolkit
* https://github.com/soundcloud/lhm
* https://github.com/github/gh-ost

Оператор UPDATE будет выполняться медленно в любой базе данных на большой таблице, как так требуется перезаписывать все строки.

"schema-on-read" предпочтительна, если:
* существуют множество различных типов объектов, и нет смысла помещать их в разные таблицы
* структура данных определяется внешними системами, которые могут изменять данные, и это нам не подконтрольно
Post #186 2.31K
Интересная мысль из "Чистой архитектуры": последние полвека мы, как разработчики, учимся тому, как делать не надо.

Судите сами: первый подход, выделенный как подход к разработке и доживший до наших дней - это структурное программирование. Используя 3 основные конструкции: последовательность, итерацию и выбор - мы можем написать любую программу. Когда Дейкстра проводил свои исследования и доказал, что прямая передача управления посредством оператора goto - опасна, он выделил структурное программирование как одну из парадигм разработки, которая дожила до наших дней.
Структурное программирование запрещает нам передавать управление напрямую.

Вторая парадигма - объектно-ориентированное программирование. Мы привыкли думать, что ООП дало нам наследование, инкапсуляцию и полиморфизм. Это не совсем так. Инкапсуляция была до появления ООП: отличный пример - .h файлы в С. Клиенты этих файлов могут работать с методами, зная только их сигнатуру, описанную в заголовочном файле.
Наследование, хоть и в менее удобном виде, тоже было задолго до появления ООП: имея 2 структуры с одинаковой сигнатурой первых функций, мы можем дописать в одну из структур ещё несколько методов, и создавать её через родительскую, приводя тип. Вторая структура занимает то же состояние стека, что и первая, дополняя его своими методами. По-сути, так и работает наследование в ООП, только выполнено оно в более красивой обёртке.
Что-то похожее на полиморфизм тоже проделывали до появления ООП: оперируя указателями на функции, можно было подменять дочерние функции на другие, с такой же сигнатурой. ООП только лишь усилило полиморфизм и позволило нам работать с ним гораздо удобней. Таким образом, вторая парадигма лишь отнимает у нас возможность косвенной передачи контроля - она делает полиморфизм более строгим.

Третья парадигма - функциональное программирование. Функциональная программа делает удивительную вещь: она ограничивает нас в присваивании. Каноничный функциональный код не имеет изменяемых переменных, только инициализируемые.

Индустрия обрастает новыми технологиями, под капотом которых - старые и базовые знания, которые с годами становятся всё строже.
Post #185 2.1K
Выходя из праздничного анабиоза решено было вернуться к чтению всякого полезного. Начал читать "Чистую архитектуру" дяди Боба. И вот вам оттуда интересная история.

Был один учёный, оказавший огромное влияние информатику - Эдсгер Дейкстра. Из под его пера в середине двадцатого века вышла статья "Go To Statement Considered Harmful" - статья, доказавшая с точки зрения математики то, что программы, где слишком часто используется оператор goto - опасные.
А пришёл Дейкстра к этому вот как: в далёких пятидесятых он решил найти универсальный способ писать качественные программы. Проделав огромную работу длиною в пару лет, он пришёл к выводу, что если программу раздробить на маленькие части, выделив под каждое атомарное действие один метод, эти атомарные части можно интерпретировать как математический алгоритм, и доказать с помощью типичных математических доказательств, таких как, например, доказательство по индукции.
И тут обнаружился интересный момент: те программы, где использовался оператор goto - часто не доказывались математически. "Чистые" же программы, которые не использовали оператор передачи управления - доказывались и их можно было назвать корректными.

После публикации статьи в журналах - Дейкстра, по-факту, устроил первый холивар в it мире. Споры продолжались много лет, но факты остаются фактами: через 10 лет с момента публикации во многих языках оператор goto был ограничен, а какие-то и вовсе реализовывлись без него. Вот как правильно устраивать холивары :)
Post #184 2.21K
Интересная мысль, описываемая Клеппманом в его "Высоконагруженных приложениях" - это внедрение паттерна репликации master-slave в рамках разных систем. Если просто, то: есть реляционная СУБД, пусть будет Postgres. Она выступает как master-реплика. И есть, например, система с поисковыми индексами, пусть будет ElasticSearch - она выступает как slave-реплика.

У большинства СУБД есть такой механизм, как журнал репликации. СУБД записывает туда все операции, производимые с этой базой данных и даёт возможность репликам вычитывать оттуда данные и применять их.

Основываясь на этом журнале, были разработаны инструменты, которые декорируют работу с журналом в виде API. Например, для Postgres - https://github.com/confluentinc/bottledwater-pg (или https://debezium.io/documentation/reference/connectors/postgresql.html), для MongoDB - https://github.com/stripe/mongoriver. Мы можем вычитывать данные из этого журнала и перекладывать их в журнал брокера, например, Apache Kafka. Потребители, в свою очередь, смогут последовательно и в том же порядке применять эти данные на другую систему, в нашем примере - ElasticSearch.

Таким образом, мы можем записывая данные в один источник реплицировать их на разные системы хранения данных.
GitHub GitHub - confluentinc/bottledwater-pg: Change data capture from PostgreSQL into Kafka Change data capture from PostgreSQL into Kafka. Contribute to confluentinc/bottledwater-pg development by creating an account on GitHub.
Post #183 1.73K
По какому принципу обычно выбирают брокера сообщений? Из моего опыта, как правило, звучит что-то вроде "да давайте kafka возьмём, я о ней на конференции слышал, попробуем". И берут. Даже, если kafka не подходит под задачи, которые приходится решать.

Как выбрать правильно? Клеппман даёт простой алгоритм: если задача, обрабатываемая брокером, занимает много времени - лучше подходит стиль обработки сообщений формата JMS/AMQP (из самого известного - RabbitMQ). Если задача выполняется быстро и без задержек - можно взять брокера на основе журнала, например, Kafka.
Почему?

Потому что обработка журнала, даже с учётом секционирования, последовательная. И тут встаёт та же базовая проблема, что и в реляционных СУБД при последовательной обработке транзакций: если одна транзакция (в нашем случае - сообщение из очереди) выполняется очень долго, все остальные встают в ожидание. Теряется скорость, переполняется очередь, и последствия могут быть печальными.
Конечно, отчасти эта проблема решается правильным секционированием журнала (разделением журнала на группы, где каждую группу читает один или несколько получателей): в случае, если журнал сильно секционирован, и только одна секция зависает из-за длительной обработки, то эту ситуацию можно обработать. Но всё же, если задача выполняется долго или может начать выполняться долго - предпочтительней будет RabbitMQ или его не журналируемые аналоги.
Post #182 1.65K
Много раз слышал восхищение разработчиков касательно Apache Kafka: "Этот брокер позволяет даже в случае отключения сервера восстановить все сообщения в очередях!"
Многие говорят о том что Kafka - единственный брокер, гарантирующий доставку в случае любых сбоев. И так оно и есть, практика это показывает.
Но только сегодня, с подачи Клеппмана в его "Высоконагруженных приложениях" я узнал, почему это так работает.
Apache Kafka - брокер на основе журнала. Т.е. вместо прямой доставки сообщений через очередь, читай через оперативную память (как это работает, например, в RabbitMQ), Kafka всё записывает в файл, указывая каждому сообщению соответствующее смещение. Подписчики, вычитывая смещения, точно знают, откуда читать свежую запись. В случае, если произошёл сетевой сбой - журнал остался нетронутым, и Kafka считывает оттуда сообщения обратно в очередь.
Теперь на вопрос на собеседовании: можно ли сломать Kafka - можешь смело отвечать, что достаточно дискового сбоя.

Возникает вопрос: как достигается такая пропускная способность? По скорости и объёму передаваемых данных Apache Kafka не уступает своим конкурентам с прямой доставкой сообщений. А достигается это за счёт крутой системы секционирования сообщений, и системы репликаций по журналам, что даёт журналируемому подходу ещё больше надёжности.

Так же заблуждением является то, что Kafka единственный брокер с таким подходом. На основе журналов так же работают: Amazon Kinesis Streams и Twitter DistributedLog. Есть ещё Google Cloud Pub/Sub, но этот парень чтение и запись в журнал абстрагирует в виде API.

Всем новых знаний, пацаны 🤙
Post #181 1.72K
Как при анализе файла восхититься сортировкой, философией Unix и понять, где украл идеи пресловутый Agile

10-ая глава "Высоконагруженных приложений", помимо всего прочего, начинается с небольшого примера анализа файлов в Linux. Анализируем - стандартный nginx-лог файл:

cat /var/log/nginx/access.log | awk '{print $7}' | sort | uniq -c | sort -r -n | head -n 5

"На выходе получаем 5 самых запрашиваемых сайтов нашего веб-сервера" - говорит автор. Ради эксперимента подключился к рабочему ssh, выдал этой цепочке команд лог на 4гб - молниеносно получил ответ: 5 строк, на каждой сайт и цифра слева от него - число запросов, отсортированных в порядке убывания. Далее Клеппман описывает, почему ответ при анализе нескольких Гб получается так быстро, и резюмируя, вот почему:

Каждая из этих утилит в Linux выполняет ровно одну функцию, и выполняет её удивительно хорошо. Например, sort под капотом автоматически обрабатывает данные большого размера, умеет записывать их на диск, оптимизировать различными структурами и параллелить сортировку там, где это нужно по нескольким ядрам процессора. Всё это - следствие философии Unix.

Что такое философия Unix? Это набор правил, описанных сообществом разработки и пользователей Unix в 1978 году:
1. Каждая программа - делает что-то одно, но делает это хорошо. Для решения новой задачи напишите новую программу, а не усложняйте старую.
2. Выходные данные каждой программы могут быть входными следующей, которая заранее неизвестна. Не засоряйте выходные данные, возвращайте атомарные и чистые результаты.
3. Проектируйте и разрабатывайте программное обеспечиние, даже операционные системы, так, чтобы протестировать их можно было как можно раньше, в идеале - за пару недель. Если какая-либо часть ПО написана плохо - без колебаний выбрасывайте её и переписывайте.
4. Чтобы упростить программирование - используйте инструменты, вместо неквалифицированной помощи, даже если для их создания приходится отвлечься от разработки основной задачи, а впоследствии - отказаться от некоторых из них.

Ничего не напоминает? Автоматизация, быстрое прототипирование, инкрементная итерация, поощерение экспериментов, разбивка крупных проектов на управляемые блоки - привет, современный Agile. Теперь понятно, кем вдохновлялись ребята, подписывая Agile-манифест в 90-ых годах. Удивительно мало изменений за 40 лет.
Post #180 1.79K
По моему опыту - многие не понимают, зачем нужны хранимые процедуры. Вот есть они, можно туда какой-то код унести, а зачем это всё?
Кто-то переписывает на них весь backend, ловя потом сотни ошибок (https://habr.com/ru/company/lingualeo/blog/515530/), кто-то использует их не по назначению, а кто-то не использует совсем.
И я тоже не понимал, где их можно применять, а сегодня как понял.
Клеппман в "Высоконагруженные приложения" приводит отличный пример их применения, и я попробую его кратко резюмировать:

Есть огромное количество ошибок, связанных с состоянием гонки в различных СУБД: грязное чтения и грязная запись, потерянное обновление, фантомные записи.
Всё это происходит из-за того, что 2 транзакции в конкурентном режиме, очень условно говоря - параллельно, выполняют запросы над одним объектом.
Как этого избежать?

Лет 30 назад умные ребята предложили избавиться от конкурентности и пускать всё в одном потоке, а все транзакции хранить в оперативной памяти и, очень быстро их оттуда доставая, применять.
Лет 15 назад оперативная память стала стоить настолько дешёво, что это удалось реализовать.

Но тут встал другой вопрос: часто сервера базы данных и сервера приложения физически располагаются в разных местах.
Приложение формирует запрос, скажем, включив туда 1.000.000 id пользователей, и отправляет эту огромную строку на сервер СУБД, где СУБД в однопоточном режиме пытается её считать, а потом применить.
Приём и передача данных по сети становится серьёзной проблемой, сильно аффектит скорость и выполнение в одном потоке становится невозможным.
Тут и приходят на помощь хранимки - формирование запроса можно унести в СУБД, а по сети передать только вызов хранимой процедуры из пары строк.

Таким образом: мы избавились от проблем конкурентного доступа и более-менее наладили скорость.

Сегодня несколько СУБД позволяют работать в таком режиме, одна из них, о которой ты скорее всего слышал - Redis. Но, надо помнить, что хранимки таят много проблем, которые нужно учитывать прежде чем применять такой радикальных подход.

На сегодня всё, мир 🤙
Post #179 1.73K
​​Книга "Высоконагруженные приложения: программирование, масштабирование, поддержка" Мартина Клеппмана оказалась скорее справочником, чем линейным пособием для изучения.
Много, нет, ОЧЕНЬ МНОГО сложных технических моментов, порой с переходом в математические абстракции, да так, что у меня флешбеки с универа начинали пролетать.
Некоторые главы главы забросил на середине, некоторые наоборот - читаются с огромным интересом за один подход.
Учитывая бэкграунд автора в Кэмбридже, литература у него получается вполне себе университетская :) Но, дочитаю обязательно. И, вероятно, некоторые главы буду
перечитывать второй раз уже с ручкой, чтобы лучше усвоить информацию.

А в качестве бонуса вот тебе список из 4-х пунктов, старательно собранных в первой половине книги, и объясняющих, почему стоит забыть MySQL в пользу других реляционных баз данных:
1. Большинство реляционных БД выполняют оператор ALTER TABLE за доли секунд, работая с указателями.
MySQL - полностью копирует таблицу, изменяет её, и записывает назад, что порой занимает несколько часов.

2. Репликация - мастхэв для больших проектов, и вероятно у тебя на проекте есть что-то подобное.
Так вот MySQL не умеет делать снимок состояния ведущего узла, а многие другие СУБД, например Postgres, - умеют.

3. Изоляция снимков состояния - тема, которая, вероятно, много раз спасала твою задницу от ошибок, а ты об этом даже не знал, потому что эта технология поддерживается автоматически
некоторыми СУБД. Но если из MySQL убрать подсистему хранения InnoDB - MySQL и тут ничего не сможет.

4. Есть такой приятный механизм - автоматическое обнаружение потери обновлений. Это когда 2 процесса в один момент прочитали из базы, а затем, например, делают инкримент прочитанного значения.
Один сделал быстрее, второй - медленнее. И второй перетёр то, что записал первый, таким образом мы увеличили значение не на 2, а на 1.
Postgres и другие умные пацаны умеют решать такие проблемы автоматом: они повторяют цикл чтения - записи и не теряют обновления. А MySQL что? Правильно, а MySQL не умеет.

Чем этот список полезен? Ну, во-первых, у меня как-то проект прогорел из-за того, что MySQL не справлялся с данными и ALERT TABLE вешал таблицу на пару часов. Во-вторых, многие (например S7)
спрашивают на собесе, чем плох MySQL. Полезно подготовиться и набросать так, чтобы после этого вопроса тебя сразу взяли :D

Вообще, автор не очень жалует MySQL, так что к концу книги, думаю, найдётся ещё пара-тройка пунктов, почему MySQL - не тру, которыми я обязательно поделюсь.
Post #178 1.69K

Forwarded from PHP Digest

PHP 8.0 релизнут!

https://www.php.net/releases/8.0/ru.php?lang=ru

Основные изменения:

• Именованные аргументы
• Атрибуты
• Объединенные типы
• Объявление свойств в конструкторе
• Выражение match
• Оператор nullsafe
• Улучшенное сравнение строк и чисел
• Ошибки согласованности типов для встроенных функций
• JIT

В релизе еще много других фич, а также улучшений синтаксиса, консистентности и обработки ошибок.

Подробно: php.watch/versions/8.0
Видео на русском: обзор Валентина Удальцова
Полный список изменений: php-8.0.0/UPGRADING
www.php.net PHP 8.0 Released PHP 8.0 — большое обновление языка PHP. Оно содержит множество новых возможностей и оптимизаций, включая именованные аргументы, тип union, атрибуты, упрощённое определение свойств в конструкторе, выражение match, оператор nullsafe, JIT и улучшения в системе…
Post #174 2.5K
🔥 Стрим с PHP-митапа Нижнего Новгорода

- 14 ноября (суббота)
- Старт в 11:00
- Пройдет по ссылке

3 доклада: про MySQL vs Postgres, причины успеха пхп-проектов и полезные привычки программистов.

Можно будет включиться в эфир текстом или голосом из браузера, а еще сыграть в квиз (и даже выиграть билет на PHP Russia или лицензию от JetBrains). Подробнее о митапе
Post #173 2.08K

Forwarded from PHP Digest

Ребята из ВКонтакте заопенсорсили свой компилятор — KPHP. Как и 6 лет назад.

Разработчики рассказывают, что он долгое время не развивался, а 2 года назад его решили возродить. Успели сделать кучу всего — догнать синтаксис современного PHP (приблизительно на уровне PHP 7.2), покрыть ООП и даже плагин для PhpStorm написать. На синтетических тестах KPHP быстрее PHP 7.4 в 5–7 раз.

При этом ребята открыто признаются, что "в бою" вне ВКонтакте он всё ещё неприменим, потому что поддерживает только ВК-шные движки, а стандартные базы данных им никогда не были нужны. Но планируют развивать это направление, чтобы KPHP стал полезным инструментом и вне VK.

А пока можно посмотреть, что это за монстр, побенчмаркать простые скрипты. Через докер это делается одной командой. Да и всегда интересно, когда большие компании делятся своей внутрянкой.

https://habr.com/ru/company/vk/blog/527420/
Хабр ВКонтакте снова выкладывает KPHP Привет! Сейчас будет дежавю. Мы снова выложили на GitHub наш PHP-компилятор — KPHP. Он проделал большой путь, и чтобы рассказать о нём, сначала телепортируемся...
Post #171 1.95K
​​Читаю книгу Мартина Клеппмана "Высоконагруженные приложения. Программирование, масштабирование, поддержка" и решил поделится интересными выводами, которые лично у меня структурировали знания о том, как и в какой ситуации выбирать СУБД для проекта или задачи.

Если модель данных подразумевает небольшое количество связей один-ко-многим (или большое, но логика приложения подразумевает, что документ загружается сразу, без или с минимальным количеством дополнительных запросов) - можно рассмотреть документоориентированные СУБД, где на хайпе до сих пор MongoDB. Ключевое слово тут - небольшое, потому что Mongo будет дублировать данные, из-за чего база будет денормализованной. Например, храним мы документы с пользователями, где к каждому пользователю опционально привязаны машины, которыми он пользуется, если они у него есть. Маловероятно, что у пользователя может быть большое количество машин, поэтому сохранить машины в документе, обернув их в json - может быть неплохой идеей. Дублировать нам придётся машины, потому что ссылаться на тачку, которая добавлена где-то в другом документе мы не можем так же, как можем это делать в реляционных базах, только искусственно. Если модель данных в принципе не подразумевает связей один-ко-многим, то документы - отличный выбор.
Тем не менее, развитие NoSQL породило множество СУБД, некоторые из которых, например, пытаются решить проблему ссылок и тем самым показать, что их можно использовать для большого количества связей один-ко-многим, например - RethinkDB и некоторые драйверы для MongoDB.

Если же связей один-ко-многим у нас много, но при этом немного связей многие-ко-многим, отличный выбор реляционные СУБД. Из-за встроенного механизма ссылок и индексов поиск будет быстрее; внутренний оптимизатор, реализованный в реляционных СУБД, отработает гораздо эффективнее и раскидает запросы лучше, чем если бы мы это делали руками в документоориентированных базах.

Если же проект подразумевает большое количество связей многие-ко-многим - стоит посмотреть в сторону графовых баз данных, потому что большое количество связей хорошо ложится на графовую модель. Реляционная база тоже позволит хранить такие данные, но работать с ними будет гораздо сложнее, и в книге приводятся несколько сравнений запросов для одной и той же схемы данных в графовом представлении и в реляционном: запрос, занимающий 2-3 строчки в графовой модели может занять 20-25 в реляционной.

Конечно, это очень общее и поверхностное описание, и стоит учитывать множество других моментов, например важен ли контроль схемы данных на стороне СУБД, как часто будут меняться данные, какой объём данных обрабатывается и как. Но в общем и целом, как первичные маркеры для выбора - подходит.
Post #170 1.83K
Кто из нас не любит сюрпризы? :) Вот и я люблю. Сегодня встретил 2 ошибки, которые едва не поломали прод - благо, успели вовремя отменить деплой и исправить. Теперь о том, что никогда нельзя делать:

1. Переопределение стандартного geter'а в сущности и использование в нём инициализированного по-умолчанию параметра. Я много читал о том, как кто-то попадал на большие суммы из-за ошибок с копейками и рублями. И сегодня чуть не попал сам: когда-то давно в одной из сущностей по неизвестной мне причине добавили в один из get-методов параметр, по-умолчанию равный true. Если он равен true - внутри метода подразумевается возврат значения. Если false - деление значения на 100 и возврат результата. true - работа с копейками, false - с рублями. Затем по-историческим причинам этот метод везде вызывался с параметром false, чего я конечно же не знал. Если бы не успели исправить - это бы привело к ошибке у огромного количества пользователей, и ошибка связана с суммами. Добавлять такие параметры - точно не нужно :)

2. Пустая строка в конце crontab файла. Раньше я не знал, что crontab -e всегда добавляет в конце файла пустую строку, а если же её не добавить - будет ошибка во время попытки запустить задания. IDE автоматом отформатировала код и убрала пустую строку, затем код через CI/CD улетел в crontab-конфигурацию и весело выбросил ошибку, чуть не поломав деплой.

Вот такие вот интересные баги :)
Post #168 1.83K
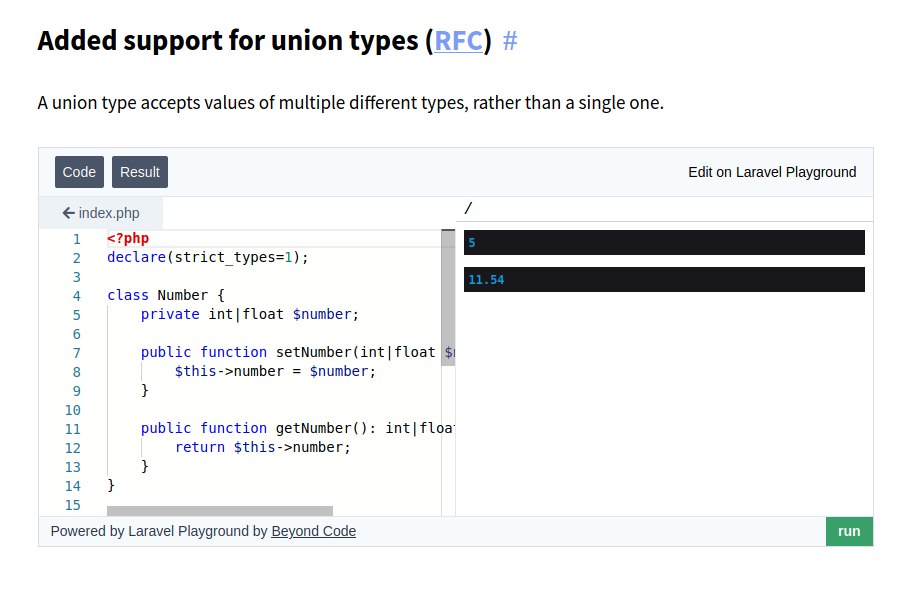
​​Нашёл сайт, где можно попробовать все фишки грядущего PHP 8 - https://pociot.dev/32-php-8-try-out-all-new-features

Каждая фича кратко описана, ссылаясь на соответствующий RFC, и ниже представлен редактор кода, где реализован пример её использования, который можно запустить! Наглядно и круто, заходи и оценивай :)
Post #165 1.94K
Статический анализ кода - отличный подход, позволяющий как привести код к единому стандарту, так и исправить множество ошибок до того, как код уедет в master.

Автор одного из популярных анализаторов - PHPStan - релизнул очень крутую фичу - веб-интерфейс. Запуск анализатора с флагом --pro запускает веб-сервер и открывает интерфейс, где можно переходить между файлами и в удобном интерфейсе смотреть на работу анализатора.

После исправления найденных ошибок, PHPStan продолжает работать в фоне, отслеживая файлы и повторно запуская анализ в случае, если они были изменены. Круто!

Ман по установке и настройке опубликован на официальном сайте - https://phpstan.org/blog/introducing-phpstan-pro
phpstan.org Introducing PHPStan Pro – Save Your Keystrokes and Get More Productive!
Post #161 3.19K
Ребята из Symfony выпустили бесплатную online-книгу с русским(!) переводом - "Symfony 5. Быстрый старт" - https://symfony.com/doc/current/the-fast-track/ru/index.html.

30 глав, в формате привычной нам документации с большим количеством примеров: от разворачивания проекта до асинхронности, работы с SPA и оптимизации. Было бы такое года 3 назад - изучение этого фреймворка шло бы быстрее :)
Добавляй в закладки, для начинающих полезно как учебник, для практикующих - как справочник.
Symfony Symfony. Быстрый старт (Symfony Docs) Благодарности О чём эта книга? Проверка рабочего окружения Знакомство �…
Post #159 2.75K
Привет, котаны

Работать с регулярными выражениями ― непростое занятие. Попадается задача с регулярками, вроде всё выучил, понял. Через неделю смотрю и думаю, как я это написал и что это значит. Знакомо?

Регулярки ― очень мощный инструмент, но очень ресурсоёмкий: сложно запомнить все конструкции, а если и запомнил ― всё равно приходится себя проверять. Вот бы иметь возможность строить регулярки так же, как Doctrine строит sql-запросы через свой билдер.

Хорошая новость: такая библиотека есть ― https://github.com/bassim/super-expressive-php

Пример из github:

Допустим, мы хотим отловить в строке шестнадцатеричный код 0xC0D3. Если бы нам пришлось составлять регулярное выражение, то вышло бы что-то похожее: /^(?:0x)?([A-Fa-f0-9]{4})$/. С библиотекой это можно сделать так:

 SuperExpressive::create()
->startOfInput()
->optional()->string('0x')
->capture()
->exactly(4)->anyOf()
->range('A', 'F')
->range('a', 'f')
->range('0', '9')
->end()
->end()
->endOfInput()
->toRegexString();


Что на выходе даст тоже самое регулярное выражение. Здорово! Подтяну в свои рабочие проекты, посмотрим, как оно покажет себя на практике :)
GitHub GitHub - bassim/super-expressive-php: super-expressive-php is a php library that allows you to build regular expressions in almost… super-expressive-php is a php library that allows you to build regular expressions in almost natural language - bassim/super-expressive-php
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →