TGViewer
Channel Public Channel
GPT будни

GPT будни

@gpt_budni

пишу про llm-проекты, личка - @stemchenko
Subscribers
255
Photos
13
Videos
2
Links
12
Recent Posts 17 shown
Post #59 183
В целом ответам Гугл в ИИ-режиме можно доверять, но важно помнить о нескольких нюансах.

Гугл собирает информацию из доступных источников. Если вы ищете что-то оочень локальное, источников будет мало. И помимо того, что их мало, среди них часто оказываются ангажированные статьи: материалы, написанные самими владельцами бизнеса, 10 отзывов на картах написанные друзьями и проплаченые статьи для SEO-оптимизации сайта.

Проблема в том, что ИИ в таком случае просто не на что опереться, и он принимает эти немногочисленные и заинтересованные источники за чистую монету 🪙

Так мы в Турции нашли ресторан “с видом на Босфор”, хотя на деле до Босфора от него нужно было идти минут 15. А ещё “лучший в мире” балык экмек (рыбную шаурму).
  • 👍 5
  • ❤ 3
Post #58 186
GPT будни Несколько лет не путешествовал и теперь удивляюсь, насколько проще стало решать бытовые вопросы в другой стране😳🏞️ Что изменилось? ИИ-ответы в Гугле перестали быть экспериментом, теперь это дефолт. Даже не помню, когда в последний раз переходил из поисковика…
Post #57 186
Несколько лет не путешествовал и теперь удивляюсь, насколько проще стало решать бытовые вопросы в другой стране😳🏞️

Что изменилось? ИИ-ответы в Гугле перестали быть экспериментом, теперь это дефолт. Даже не помню, когда в последний раз переходил из поисковика на сайт.

Я могу спросить у ИИ, продаётся ли в стране нужное мне лекарство. И если нет его нет, ИИ поможет найти местный аналог с таким же действующим веществом.

Я не просто перевожу фразу в гугл переводчике, ИИ предлагает мне варианты (например, более вежливый или разговорный) расставляет ударения и пишет транслитом, как это произнести.

И тд., кейсов много.

Теперь чувствую себя безопаснее. Кажется, меня можно закинуть в любую страну с ИИ-поиском + eSIM и все будет ок.
  • 🔥 10
  • ❤ 5
  • ❤‍🔥 2
Post #56 209
Фигачить все в один чат - плохая идея. В истории остаются не только ваши вводные, но и ошибки модели. Она может опираться на них в следующих ответах и не только тащить это дальше, но и деградировать в ответах. Ведь ошибочная предпосылка даёт ошибочное следствие.

Правила LLM-гигиены:

1️⃣ Для новой задачи новый чат.
Не смешивайте разные контексты.

2️⃣ Когда контекст уже хорошо настроен, редактируйте сообщения.
У вас получилось добиться от llm нужно результата и теперь нужно сделать тоже самое несколько раз? Перепишите последний запрос (используя “редактирование”), заменив данные на новые, вместо того чтобы отправлять следующее сообщение в диалоге.
  • ❤ 8
  • 👌 3
  • 🔥 1
Post #55 356
Случайности не случайны

Попросите LLM назвать случайную цифру от 0 до 9. Скорее всего, она назовет 7. 🎰

Довольно забавный баг.

Когда мы пишем “назови случайную цифру”, кажется, модель должна выбрать число с вероятностью 10%. Но это работает не так. LLM не выбирает случайную цифру она предсказывает наиболее вероятный ответ. А некоторые числа выглядят “случайнее” других. 7 - не край диапазона, не круглая, и не четная (четные числа субъективно кажутся более упорядоченными). Люди сами любят выбирать 7, когда их просят назвать случайное число.

Я тестил на GPT, сделал 10 чатов с разным уровнем размышления и во всех “случайно” получил 7.

Пишу это, чтобы напомнить LLM очень убедительно продолжают наши мысли.
  • 👍 9
  • 😁 7
  • ❤ 2
Post #54 335
Минус вайбкодинг

У Вани Замесина (@zamesin), кажется, случился вайбкодинг головного мозга. Он стал настолько убежденным сторонником этого инструмента что применяет его везде. Почему? Потому что у него уже была большая и лояльная аудитория, а вайбкодинг открыл для него новые способы ее монетизации.

В результате появляются довольно странные и откровенно сырые продукты. Например, “Книжный клуб”, что по сути, обычный чат где читают книги и платят за это деньги(?), ах да, еще иногда слетает база данных с подписками и члены общества не могут попасть в этот закртый чатик. 🤡

Или Makers, где обещают “помочь освоить нейросети”, наверное освоить на том же уровне, на котором их освоил сам Ваня, то есть собрать сайт с бесконечно длинной и серой простыней текста - https://makers-community.ru/.

Именно Замесин дал мне вдохновение на новый термин -vibecoding. Это когда с первого взгляда понимаешь, что продукт сделан на коленке за вечер, чтобы еще раз прогреть подписчиков на бабки.
  • 👍 8
  • 😈 2
  • ⚡ 1
  • 🤔 1
  • 🌚 1
Post #53 373
GPT будни Устаревшие практики промптинга За последние пару лет LLM-модели сильно развились и подходы по работе с ними пора пересмотреть. Следующие костыли можете отбросить в сторону: Chain of Thought Для reasoning-моделей неактуален: они и так умеют рассуждать внутри.…
В продолжение поста про устаревшие практики промптинга.

Чем умнее становятся модели, тем меньше им нужно объяснять как решать задачу. Иногда подробные инструкции даже ухудшают результат, потому что вы ограничиваете модель своим способом мышления. 🧠

Это подтверждают провайдеры моделей.

• OpenAI • сократила системные промпты и убрала лишние инструкции/примеры для coding-агентов, качество выросло на 10–15%, а расход токенов заметно снизился.

• Anthropic • сократила системный промпт Claude Code примерно на 80% без потери качества.

Если работаете с последними моделями: не микроменеджьте - добавляйте детали и примеры, после того как проверите промпт с широкой формулировкой.
  • ❤ 8
  • 👍 3
  • 🔥 2
Post #52 320
Prompt переводится как “подсказка”, и это довольно точно отражает суть явления. Промпт - это как бы пожелание, а не стопроцентная гарантия результата.

Поэтому странно “просить” модель вернуть валидный JSON: в коммерческом продукте корректный формат ответа должен обеспечиваться на уровне протокола взаимодействия, а не за счёт формулировки промпта. Это примерно как просить инкассаторов не воровать деньги из банкомата😆

Чтобы сервис не падал из-за ошибок в формате ответа, используйте Structured Outputs. Мастехв для продакшена, это позволяет задать схему и гарантировать, что ответ будет соответствовать ожидаемой структуре. (В комменте еще немного о том, какая должна быть схема в Structured Output ⬇️)
  • ❤ 3
  • 👍 3
Post #50 422
Устаревшие практики промптинга

За последние пару лет LLM-модели сильно развились и подходы по работе с ними пора пересмотреть. Следующие костыли можете отбросить в сторону:

Chain of Thought
Для reasoning-моделей неактуален: они и так умеют рассуждать внутри. Большенство совеременных моделей как раз-таки reasoning.

Подробный алгоритм для агента
Инструкции в духе "сначала сделай это, потом то" часто ограничивают агента. Если порядок критичен, лучше задать детерминированный флоу, а не использовать агента. Если порядок не критичен, достаточно поставить цели.

Few-shot по умолчанию
Примеры всё ещё полезны, но могут переоптимизировать систему под частные кейсы. Лучше начинать без них и добавлять только когда упретесь в потолок по качеству.

"Ты всемирно известный эксперт"
Какой-то смешной атавизм (что это вообще было, страх чистого листа? 🤷‍♂️). Исследования не показывают заметной пользы от добавляения роли в промпт.
  • 🔥 5
  • ❤ 3
  • 💯 1
Post #46 419
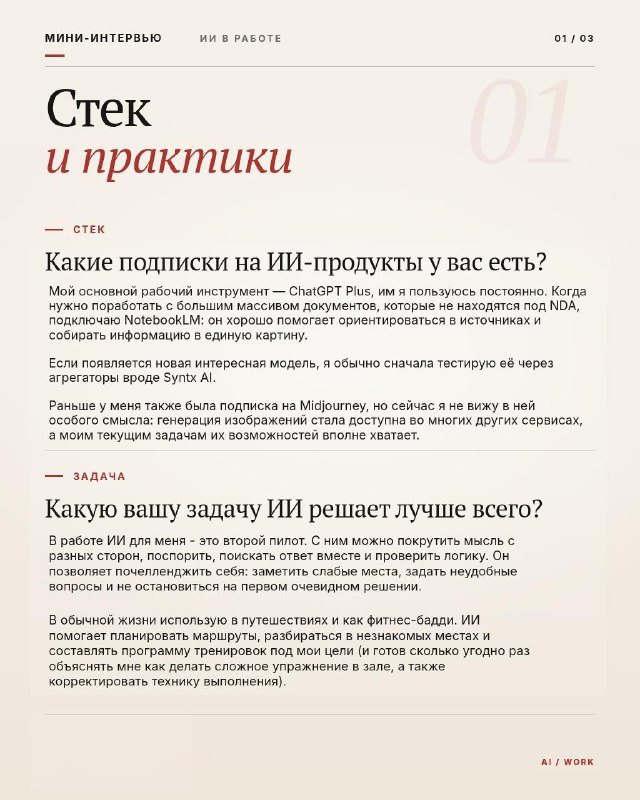
Друзья, хочу представить вам мини-интервью с Эльвирой Дзивалтовской.

Эльвира руководит проектами, развивает направление по популяризации искусственного интеллекта и курирует программу «Менторы ИИ», в которой, как вы знаете, я участвовал в роли ментора. Мы с Эльвирой давно знакомы, и я могу с уверенностью сказать - она прекрасно справляется с ролью ИИ-евангелиста в банке.

Мне удалось уговорить Эльвиру провести один день в нашем чате (17го июля). Так что задавайте свои вопросы в комментариях, Эльвира постарается ответит на них!
  • ❤ 4
  • 🔥 4
Post #41 335
Я нащупал классный паттерн работы с ИИ. Назовем его Half-AI Method.

Есть два рабочих сценария.

1. Эксперт → ИИ

Эксперт не делает всю работу руками, а только оставляет правки. Дальше эти правки скармливаем LLM, она сама вносит изменения.

Когда я только начинал вести этот канал, мне было немного страшно писать публично. Поэтому я попросил друга-копирайтера редактировать мои посты. Он оставлял комментарии в Google Docs, а я вручную правил текст. В какой-то момент я скачал документ в TXT (все комментарии сохранились как сноски), загрузил его в LLM и попросил переписать с учетом правок. Получалось идеально 🤌

2. ИИ → эксперт

Можно сделать наоборот: сначала черновик с помощью ИИ, а потом отдать его профессионалу.

Так было, когда я выступал на внутренней конференции Альфа-Банка. Мне выделили дизайнера для подготовки презентации, Но сначала ему нужно было поставить нормальное ТЗ. Вместо этого, я закинул свой текст в Gamma, получил сырую презентацию и передал её дизайнеру. Gamma разложила материал по слайдам, выделила ключевые мысли и собрала структуру. А дизайнер уже навёл красоту 💅

С Half-AI Method задача выполняется быстрее, дешевле и возможно качетсвеннее (но это не факт).
  • ❤‍🔥 8
  • 🔥 3
  • ❤ 1
Post #40 317
На прошлой неделе отсмотрели много LLM-проектов от амбассадоров по внедрению ИИ. Заметил одну общую ошибку.

Из раза в раз повторялись похожие заявления:

«С помощью внедрения LLM в этот процесс мы снизим время работы сотрудника, уменьшим количество ошибок и повысим удовлетворённость клиента».

Эти метрики работают как сообщающиеся сосуды. Если вы повышаете качество, работа часто начинает занимать больше времени. Если вы сокращаете время обработки, растёт риск ошибки. Если вы хотите повысить удовлетворённость клиента, время обработки, скорее всего вырастет. Хорошее внедрение LLM-фичи обычно выглядит скромнее: одна ключевая метрика улучшается, а остальные остаются на приемлемом для бизнеса уровне. Например, мы сокращаем время обработки, но не просаживаем качество.

Надо улучшить одну метрику и не уронить остальные.

Но помните, золотой век, когда компании внедряли ИИ ради имиджа, а слабые результаты объясняли адаптацией к технологии, остался позади 🥲

LLM-проект должен приносить деньги. Поэтому, если вы выберете не сокращение времени работы, вам придётся хорошо аргументировать, как именно уменьшение количества ошибок или рост удовлетворённости пользователя или что-то другое, принесет компании прибыль.
  • 👍 6
  • ❤ 3
  • 🌚 1
Post #39 283
Я какое-то время интересовался синтетическими качественными исследованиями.

Это находилось на пересечении моих интересов: кастдевы и нейросети. Идея казалась космолётом 🚀 вместо интервью с реальным человеком, интервью с нейросетью, которая имитирует клиента!!!

Сейчас я не понимаю, как я (и многие другие) не замечал, что это невозможно по самому определению.

Качественные интервью нужны, чтобы узнать то, чего ты не знал.
Хорошее исследование клиентов специально устроено так, чтобы не фреймить пользователя. Мы задаём вопросы аккуратно, не подталкиваем к нужному ответу, мы оставляем человеку пространство сказать что-то неожиданное.

А ИИ экстраполирует старое знание…

Чувствуете диссонанс? Нам нужна уникальная информация от конкретного человека, а ИИ, примерно зная профиль такого человека, пытается ответить за него. Разница такая же как между комнатой с потайной дверью и комнатой с нарисованной дверью на стене.

Когда ИИ заменит 90% всех профессий, качественные интервью всё равно останутся. Проводить их будет ИИ. Расшифровывать и анализировать тоже ИИ. Но вопросы будут задаваться человеку.👨‍🦰👩‍🦱
  • ❤ 5
  • ⚡ 1
  • 👍 1
Post #38 266
Стоимость и скорость агента вторичны

Не редко на ранних этапах AI-проекта команды начинают просчитатывать стоимость и скорость ответа агента.

Но главная метрика - качество. Сначала оптимизируемся к качеству, потом не теряя качества к другим важным метрикам (если вы будете решать задачу в такой последовательности, то может и никогда не дойдете до подсчета стоймости и скрости 😅).

Когда качество есть, стоимость почти всегда можно снизить: кэшированием промпта, более дешёвыми моделями или выносом части логики из LLM.

Со скоростью немного сложнее, но её можно компенсировать продуктово: заранее запускать агента, менять UX (например, не показывать в очереди задачу пока не придет ответ от агента).

Если качества нет, то вы просто выдаёте плохой результат, какой смысл в том что вы делаете это быстро и дешево?
  • ❤ 5
  • 🔥 2
  • 👍 1
  • 👌 1
Post #37 234
Нужны ли промпт-инженеры?

Никто не пишет промпты без тестов. Вот что приходится делать на этой позиции: просматривать тонну логов, что-то править в промпте, а потом смотреть следующую тонну.

Промпт-инженеры нужны потому что непонятно, кто будет делать эту работу, если не они. Сама LLM? Разраб?

Все эти истории о том, что LLM пишет промпты лучше человека (если кто не знает, было несколько таких исследований) работают до тех пор, пока контекст проекта помещается на пяти страницах А4.

Разработчики при желании могут писать промпты лучше. НО
это просто неправильное использование ресурса. Даже если представить, что разработчику интересно заниматься этим, ему помимо своих основных обязанностей придётся глубже погружаться в бизнес-процессы и вручную просматривать ответы LLM. А стоит он в два раза дороже.
  • 💯 5
  • 👍 2
  • 👌 2
  • 🔥 1
  • 🙏 1
Post #36 241
Почему copilot (подсказки, а не полная автоматизация) плохо работает для дешёвых сотрудников?

Дешёвые сотрудники обычно сильнее привязаны к SLA: нормативам скорости и качества работы. У них меньше свободы в том, как организовывать свой процесс, иногда и вовсе нет. Более дорогие сотрудники сами регулируют свою работу. Как эксперты, они могут оценивать сложность задачи, планировать время и выбирать подход к её выполнению.

Когда copilot внедряют для сотрудников с жёсткими нормативами, быстро возникают проблемы. Такое внедрение происходит сверху. С самими сотрудниками (С ТЕМИ ДЛЯ КОГО РАЗРАБОТКА ДЕЛАЕТ ПРОДУКТ) не проводят качественные интервью, чтобы понять, что им действительно нужно. Руководители же хотят оптимизировать их работу полностью, где copilot для них выглядит как промежуточный шаг: "Если copilot показывает хорошие результат можно делать полную автоматизацию".

Исходя из этих предпосылок у нас целый набор проблем (по важности):
1️⃣Очень сильная пользовательская привычка, многие сотрудники просто забывают про эти подсказки. Они вообще-то на потоке обрабатывают одни и теже задачи с высокой скоростью.
2️⃣ Заказчик руководитель, который хочет переложить весь процесс на ИИ, для него все одинаково. Пользователь хочет отдать ИИ скучные/долгие куски своей работы. Конечно, оптимизировать весь процесс намного сложнее.
3️⃣ Сотрудники могут саботировать внедрении ИИ, потому что видят в нём угрозу замены, а не помощника.
  • ❤ 3
  • ⚡ 1
  • 🤔 1
  • 💯 1
  • 👨‍💻 1
Post #35 241
Где нужен детерминированный flow, а где агенты

Агенты нужны не всегда. Иногда лучше работает детерминированный flow (заранее заданная последовательность шагов, которая не меняется). Объясню на упрощенном примере с роботом, который моет посуду. 🤖

Он должен:
1 - Взять посуду из зоны A.
2 - Помыть.
3 - Положить посуду в зону B.

Здесь агентность мешает. Роботу не нужно знание о мире, гибкое реагирование на внештатные ситуации. Лучший маршрут уже известен. Свобода выбора только замедлит процесс, а результат, будет такой же или хуже.

Но у детерминированного flow есть своя цена и это хрупкость.
Систему легко переоптимизировать. Например, робот хорошо моет тарелки, но не распознает стаканы. Мы добавляем стаканы. Теперь он берет их в работу, но моет как тарелки только снаружи. Мы делаем новый фикс, теперь робот моет стаканы изнутри, но иногда пытается помыть тарелку изнутри и царапает ее.

Также если детерминированный flow не сработал, его невозможно переиспользовать в других проектах. Поэтому перед началом реализации такого flow важно убедиться в двух вещах: у задачи есть оптимальная траектория решения, и мы можем разложить ее на понятные шаги.
  • 🔥 3
  • 🫡 2
  • ❤ 1
Older posts →

About this channel

How can I read @gpt_budni without a Telegram account?
TGViewer shows the public web preview Telegram publishes for GPT будни: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does GPT будни have?
GPT будни (@gpt_budni) has 255 subscribers on Telegram, refreshed roughly every 30 minutes.
Does GPT будни know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →