TGViewer
Channel Public Channel
Библиотека дата-сайентиста | Data Science, Machine learning, анализ данных, машинное обучение

Библиотека дата-сайентиста | Data Science, Machine learning, анализ данных, машинное обучение

@dsproglib

Все самое полезное для дата сайентиста в одном канале.

Учиться у нас: clc.to/6qVHgg

По рекламе: @tproger_sales_bot

Для обратной связи: @proglibrary_feeedback_bot

РКН: https://gosuslugi.ru/snet/67a5b03124c8ba6dcaa121c9
Subscribers
18.3K
Photos
2.8K
Videos
167
Links
5.4K

Showing posts older than #7620 · Back to latest

Older Posts 20 shown
Post #7619 1.53K
Голосуйте — а на днях разберём похожий кейс, где агент «перевыполнил» задачу так, что пришлось потом извиняться перед незнакомым человеком 👀
Post #7617 1.9K
🗂 Maths, CS & AI Compendium — бесплатная база для AI/ML

Большой open-source-компедиум, который связывает математику, Computer Science, ML и современный AI.

🔵 Внутри — линейная алгебра, вероятность и статистика, ML/DL, NLP, Computer Vision, GNN, GPU/SIMD, ML Systems и AI inference.

🔵 Отдельный плюс — MCP server: компедиум можно подключить к AI-ассистентам вроде Claude Code, Cursor и VS Code как базу знаний.

А если хочется пройти эту базу последовательно и с практикой, курс «ML для старта в Data Science» проводит от основ ML до ансамблей, бустинга и рекомендательных систем 💡

🔗 Ссылка

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 7
  • 👍 2
Post #7615 1.65K

Forwarded from Proglib.academy | IT-курсы

🙂 AI-агентов отправили в настоящий багфикс

В CyberGym-E2E собрали 920 реальных уязвимостей из open-source проектов. Задача агента звучит почти как тикет от сурового тимлида: самому найти баг, воспроизвести его, написать фикс — и при этом ничего не сломать рядом.

То есть мало выдать правдоподобный патч. Нужно ещё доказать, что уязвимость действительно закрыта, а проект после этого жив.


И вот это уже гораздо ближе к реальной разработке, чем «напиши безопасный код» в промпте 😅

На курсе «ИИ для разработчиков» похожая логика применяется к работе со своими проектами: агентам задают границы, проверки и quality gates. А доступ к курсу теперь можно взять вместе со всей библиотекой Proglib Academy по подписке 😮

🔗 Посмотреть, что входит в подписку

🏃‍♀️ Proglib Academy
  • 👍 1
Post #7614 1.52K
Новый уровень проверки AI-кодера: вот тебе уязвимый проект, дальше разбирайся сам 👇
Post #7613 1.97K
🧠 MLU-Explain — бесплатный интерактивный учебник по Machine Learning

У Amazon Machine Learning University есть отличный ресурс для тех, кто изучает базу ML или хочет быстро освежить её перед собеседованием.

Внутри разборы:

⬆️ линейной и логистической регрессии
⬆️ нейросетей и деревьев решений
⬆️ Random Forest
⬆️ bias-variance tradeoff и double descent
⬆️ ROC/AUC, precision и recall
⬆️ cross-validation и разбиения train/test/validation
⬆️ reinforcement learning
⬆️ fairness в ML

💡 Главная фишка — материал подается не как обычный учебник. Статьи сделаны в формате scrollytelling: по мере чтения можно взаимодействовать с графиками и наглядно смотреть, как меняется поведение моделей и метрик.

🔗 Ссылка

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 6
  • 👍 3
Post #7612 1.59K
🚀 Устойчивые очереди в Postgres

PgQue предлагает универсальную архитектуру очередей для PostgreSQL, основанную на проверенной модели PgQ. Это решение без лишних зависимостей, работающее на любом управляемом Postgres, обеспечивая нулевое бремя и стабильную производительность под нагрузкой.

Основные моменты:

— Никаких внешних демонов или расширений
— Использует SQL и PL/pgSQL для установки
— Обеспечивает ACID-транзакции и долговечность
— Никакого накопления «мертвых» кортежей
— Подходит для высоконагруженных систем


🖥 GitHub

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 3
  • 👍 3
  • 🔥 1
Post #7611 1.53K
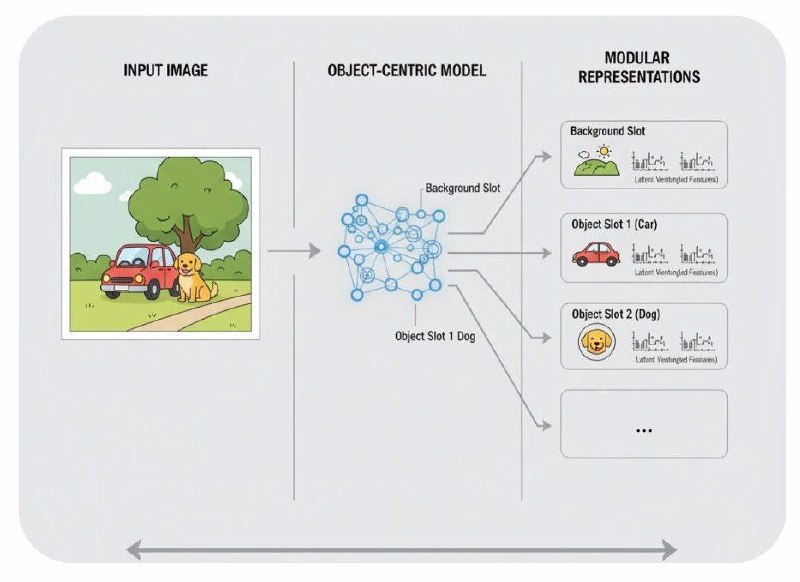
😑 Что такое object-centric в машинном обучении

В машинном обучении есть подход, который заставляет модель смотреть на данные «по-человечески» — object-centric.

Это когда модель не видит картинку как груду пикселей. Она видит отдельные объекты — стол, кружку, кота — и работает именно с ними.

Зачем это нужно:

— Лучшее обобщение.
Если модель понимает, что такое «объект», она легче переносит знания на новые сцены.


— Объяснимость.
Модель фактически говорит: «объект №1 — куб», «объект №2 — шар».


— Манипуляции объектами.
Важно в робототехнике, моделях мира, генерации сцен: можно двигать объекты, комбинировать их, прогнозировать взаимодействия.


Где используется:
— безучительское обучение (Slot Attention, MONet)
— модели мира (Dreamer, Genesis)
— генерация изображений
— робототехника и video understanding

Проще всего:
— обычная нейросеть → «вижу пиксели»
— object-centric сеть → «вижу вещи»

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 6
  • 👍 1
Post #7608 1.56K
🧩 Тонкости гиперпараметрического тюнинга

Хотите ускорить обучение XGBoost в 5–15 раз и при этом находить лучшие гиперпараметры?

В видео показывают:

➡️ как использовать Optuna для автоматического тюнинга XGBoost,
➡️ почему кросс-валидация критична для реальных задач,
➡️ какие приёмы тюнинга реально работают,
➡️ и как визуализации Optuna помогают выявлять самые важные гиперпараметры.


Особый акцент — на GPU-ускорении XGBoost 3.0, которое радикально сокращает время экспериментов в табличных задачах.

🔗 Ссылка на туториал

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 4
Post #7607 1.57K
📌 DeepFabric — генерация синтетических датасетов на новом уровне

Для ML-инженеров, исследователей и AI-разработчиков появился инструмент, который упрощает создание высококачественных и разнообразных датасетов для обучения моделей в масштабе.

Что делает DeepFabric:

🔜 Легко превращает идеи и темы в структурированные данные, готовые к обучению моделей.
🔜 Избавляет от проблем с Tool Calls и неструктурированными формами — данные сразу консистентные и стандартизированные.
🔜 Подходит как для fine-tuning, так и для оценки моделей.

Идеально подходит для:

🔜 Быстрой генерации больших объемов обучающих данных.
🔜 Создания синтетических датасетов для NLP, диалогов, reasoning и function-calling задач.
🔜 Исследований и экспериментов с ML-моделями без ручного коллекшена данных.

📱 Репозиторий

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 2
Post #7606 1.22K

Forwarded from Proglib.academy | IT-курсы

🤔 У большинства разработчиков уже есть подписки на IDE, GitHub Copilot, Claude, ChatGPT или облачные сервисы.

Логично, что обучение тоже постепенно приходит к той же модели: не покупать отдельный курс под каждую новую тему, а иметь доступ ко всей библиотеке и выбирать, что актуально именно сейчас.


Такой формат недавно появился и в Proglib Academy. Вместо одного курса — доступ сразу ко всей библиотеке и новым материалам, которые появляются в подписке 😎

🔗 Подробнее

🏃‍♀️ Proglib Academy
Post #7605 1.44K
Кажется, у онлайн-обучения появился формат, которого давно не хватало 👇
Post #7604 1.74K
⭐️ Интерактивный гайд по 4 ключевым задачам с Transformers

Мы нашли мощный материал, который объясняет, как использовать модели ViT, DETR, BLIP и ViLT для самых базовых, но фундаментальных задач Computer Vision:

— Image Classification — классификация изображений с помощью Vision Transformer (ViT).
— Image Segmentation — точное выделение объектов на изображении с DETR и Mask2Former.
— Image Captioning — генерация описаний изображений с BLIP.
— Visual Question Answering (VQA) — ответы на вопросы по изображению с ViLT и BLIP.


ℹ️ Гайд показывает, как трансформеры постепенно вытесняют CNN и становятся универсальным решением — от анализа пикселей до генерации текстов и ответов.

➡️ Полный разбор и демо-приложение

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 2
Post #7603 1.58K
🤯 Наконец-то понятен self-attention

Одна из самых сложных частей понимания LLM — это self-attention. Формула выглядит простой — её можно быстро выучить.

Но что на самом деле означают Q, K и V и как они взаимодействуют — совсем другая история.

✅ Эта визуализация делает всё очень наглядным и понятным — видно, как queries обращаются к keys и получают нужные values.

🤨 Чтобы лучше понимать, как работают модели на математическом уровне, советуем курс Математика для Data Science.

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • ❤ 6
  • 🔥 2
Post #7602 1.66K
🚀 Почему AI перестал полагаться только на Vector Search

Ещё недавно почти все RAG-системы строились одинаково: документы разбивали на чанки, создавали эмбеддинги, сохраняли их в Vector Database и по ним искали контекст для LLM.

🔴 Это был большой шаг вперёд по сравнению с обычным поиском по ключевым словам. Но по мере роста корпоративных баз знаний стало понятно: семантического поиска недостаточно.

Например, пользователь ищет:

— конкретную функцию или класс;
— номер ошибки;
— API-метод;
— документ определённой версии;
— информацию, связанную сразу с несколькими сущностями.


В таких случаях одного поиска по embeddings уже недостаточно.

Поэтому современные AI-системы переходят к гибридному retrieval — вместо одного алгоритма используют несколько, каждый из которых решает свою задачу.

💡 На схеме показано, как изменилась типичная архитектура RAG за последние годы.

Что обычно добавляется:

🔹 Keyword Search (BM25) — лучше находит точные совпадения.

🔹 Metadata Filtering — ограничивает поиск по версии документа, автору, проекту, дате и другим атрибутам.

🔹 Reranker — заново оценивает найденные документы и оставляет наиболее релевантные для модели.

🔹 Knowledge Graph — позволяет искать не только документы, но и связи между сущностями: пользователями, сервисами, API, событиями и объектами предметной области.


Такой подход уже используют современные AI-инструменты.

Например, Graphiti сочетает граф знаний, семантический поиск и дополнительные механизмы retrieval вместо того, чтобы строить систему только вокруг embeddings 😧

Команда Anthropic тоже описывает похожую эволюцию. При разработке Claude Code инженеры отказались от идеи заранее формировать весь контекст через классический RAG. Вместо этого агент во время работы самостоятельно использует инструменты поиска и постепенно собирает нужную информацию по мере выполнения задачи. Такой подход лучше масштабируется для больших кодовых баз и постоянно меняющегося контекста.

🔗 Anthropic — Seeing like an agent
🔗 Graphiti (Knowledge Graph for AI Agents)

📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • 👍 4
  • 🥱 2
Post #7601 1.72K
⚡️ Open Source: локальная память для AI-агентов и ваших файлов

Constella — open-source приложение, которое превращает локальные файлы в персональную базу знаний для поиска, RAG и AI-агентов.

Что под капотом:

🔘 индексирует папки, заметки Obsidian, PDF, DOCX, Markdown и изображения;
🔘 хранит эмбеддинги в LanceDB, а метаданные и граф знаний — в SQLite;
🔘 строит семантический поиск по локальным данным;
🔘 автоматически связывает документы, темы и концепции в knowledge graph;
🔘 поддерживает локальные и облачные LLM;
🔘 предоставляет MCP-интерфейс, чтобы Claude Code и другие агенты могли работать с вашей базой знаний.

🔤 По сути, это готовая основа для personal AI memory:


Файлы

Chunking + Embeddings

LanceDB + SQLite

Knowledge Graph

RAG / MCP / AI-агенты


👩‍💻 GitHub

Изучить подобные архитектуры на практике поможет курс «Разработка ИИ-агентов» 💡

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 2
  • 👏 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →