TGViewer
Channel Public Channel
Библиотека дата-сайентиста | Data Science, Machine learning, анализ данных, машинное обучение

Библиотека дата-сайентиста | Data Science, Machine learning, анализ данных, машинное обучение

@dsproglib

Все самое полезное для дата сайентиста в одном канале.

Учиться у нас: clc.to/6qVHgg

По рекламе: @tproger_sales_bot

Для обратной связи: @proglibrary_feeedback_bot

РКН: https://gosuslugi.ru/snet/67a5b03124c8ba6dcaa121c9
Subscribers
18.3K
Photos
2.8K
Videos
167
Links
5.4K

Showing posts older than #7599 · Back to latest

Older Posts 20 shown
Post #7598 1.7K
Полезная шпаргалка: как выбрать правильное распределение для данных

1️⃣ Начните с гистограммы

— Простая, но мощная визуализация.
— Помогает понять форму данных: колоколообразная (Normal), быстро падающая (Exponential), ровная (Uniform), с несколькими пиками (Mixture).
import matplotlib.pyplot as plt
import numpy as np

data = np.random.normal(50, 15, 1000)
plt.hist(data, bins=30, color='skyblue', edgecolor='black', alpha=0.7)
plt.xlabel('Values'); plt.ylabel('Count'); plt.title('Гистограмма данных')
plt.show()


2️⃣ Протестируйте разные распределения

— Используем библиотеку distfit для подбора распределений.
— Проверяет ~90 типов распределений автоматически:
from distfit import distfit
import numpy as np

my_data = np.random.normal(25, 8, 2000)
fitter = distfit(method='parametric')
fitter.fit_transform(my_data)

print("Лучшее распределение:", fitter.model['name'])
print("Параметры:", fitter.model['params'])


3️⃣ Визуализируйте подгонку

— Всегда проверяй глазами!
— Используй PDF (распределение) и CDF (кумулятивное распределение):
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15,6))
fitter.plot(chart='PDF', ax=ax1); ax1.set_title('PDF')
fitter.plot(chart='CDF', ax=ax2); ax2.set_title('CDF')
plt.show()


4️⃣ Не забывайте про нестандартные данные

— Дискретные счётные данные → binomial, Poisson.
— Сложные или многопиковые данные → non-parametric (quantile, percentile).

Пример:
from scipy.stats import binom
count_data = binom(20, 0.3).rvs(1000)
discrete_fitter = distfit(method='discrete')
discrete_fitter.fit_transform(count_data)
discrete_fitter.plot()


5️⃣ Проверяйте стабильность

— Бутстрэпинг помогает проверить, насколько выбранное распределение устойчиво к случайным выборкам:
fitter.bootstrap(my_data, n_boots=100)
print(fitter.summary[['name','score','bootstrap_score','bootstrap_pass']])


📍 Навигация: ВакансииЗадачиСобесы

🐸 Библиотека дата-сайентиста

#буст
  • 🔥 1
Post #7597 1.54K
Percentify: 80% проверок датасета в 20% кода

Каждый раз при старте нового проекта повторяем одно и то же: смотрим пропуски, считаем перекос классов, проверяем мультиколлинеарность, строим корреляции.

Percentify упаковывает это в одну строку. Работает с pandas и Polars — нативно, без конвертации.

🔍 profiler — главная функция


from percentify import profiler

report = profiler(df, target="churn")

report.to_frame() # все проблемы, от худшей к лучшей, с советом как починить
report.errors # только блокирующие проблемы
report.health # скор качества данных от 0 до 100


Можно прямо в CI:

assert not report.errors
assert report.health >= 80


📋 Остальные функции

· missing(df) — процент пропусков по колонкам
· outliers(df) — процент выбросов по колонкам
· skew_report(df) — перекос и рекомендованное преобразование (log1p, sqrt...)
· vif(df, flag=5.0) — мультиколлинеарность, возвращает список колонок для дропа
· correlate(df) — корреляции с p-value, можно сортировать по значимости
· imbalance(df, target="label") — дисбаланс классов
· pca_variance(df) + pca_loadings(df) — дисперсия и интерпретация PCA


Пример рабочего воркфлоу


from percentify import skew_report, vif, profiler
import numpy as np

# 1. Проверить качество данных
report = profiler(df, target="churn")

# 2. Найти колонки под логарифм
plan = skew_report(df)
for feat in plan[plan.skew > 1]["feature"]:
df[f"{feat}_log"] = np.log1p(df[feat])

# 3. Убрать мультиколлинеарные признаки
to_drop = vif(df, flag=5.0)["feature"].tolist()
df = df.drop(columns=to_drop)


pip install percentify


📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • ❤ 5
  • 👍 3
  • 🤩 2
Post #7596 1.48K
Context Engineering для DS — шпаргалка по работе с LLM агентами

Context engineering — это не prompt engineering. Это архитектура того что агент видит в каждый момент времени.

🧠 Что такое context rot

Агент начинает хорошо, потом теряет нить. Причина: тикеты, логи, старые идеи и ошибки накапливаются в контексте. Структура разрушается, модель галлюцинирует.

Симптомы:
· Агент повторяет уже отвергнутые подходы
· Игнорирует более ранние инструкции
· Начинает противоречить сам себе

📋 Что класть в контекст

Класть:
· Чёткое описание задачи и ожидаемый формат вывода
· Схему данных и примеры (не весь датасет)
· Ограничения и что уже попробовали (коротко)
· Примеры правильного и неправильного ответа

Не класть:
· Полные логи ошибок (только суть)
· Историю всех итераций (только последнее состояние)
· Данные которые агент не будет использовать

🏗 Архитектура для DS задач

Один большой контекст → плохо. Несколько специализированных агентов → лучше:
Агент 1: Data Inspector
→ анализирует датасет, возвращает краткий саммари

Агент 2: Feature Engineer
→ получает саммари, предлагает признаки

Агент 3: Model Selector
→ получает список признаков + метрику, выбирает алгоритм

Агент 4: Code Generator
→ получает только спецификацию, пишет код

Каждый агент видит только то что ему нужно.

📐 Правила для DS контекста

· Схема данных > примеры данных. df.dtypes и df.describe() лучше чем df.head(100)
· Формат вывода явно. «Верни JSON с полями X, Y, Z» вместо «верни результат»
· Один агент — одна задача. Не просите анализировать данные и писать код одновременно
· Саммари между агентами. Передавайте выводы, не логи
· Контекст сбрасывайте между независимыми задачами

🔄 Паттерн для итеративного анализа
# Плохо — один большой промпт со всем
prompt = f"""
Вот мои данные: {df.to_string()}
Вот мои ошибки: {error_log}
Вот что я пробовал: {history}
Сделай всё хорошо.
"""

# Хорошо — минимальный контекст на каждом шаге
context = {
"task": "predict churn",
"data_summary": df.describe().to_dict(),
"target": "churn",
"current_metric": {"roc_auc": 0.72},
"constraint": "inference < 100ms"
}


Чеклист перед запуском агента

· Задача сформулирована в одном предложении?
· Формат вывода описан явно?
· Убраны данные которые агент не будет использовать?
· Контекст из прошлой сессии не тащим если задача новая?
· Есть пример правильного ответа?

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • ❤ 1
  • 👍 1
Post #7595 1.58K
Инструмент для работы со временными рядами: sktime

Если вы работаете с временными рядами в Python — обязательно попробуйте sktime.

sktime — это библиотека с единой и удобной обёрткой для задач машинного обучения на временных рядах.

Поддерживает:
— Прогнозирование (forecasting)
— Классификацию временных рядов
— Регрессию
— Кластеризацию
— Обнаружение аномалий и точек изменений
— Композиции моделей, трансформеры и пайплайны

Features:
— Единый API для задач ML/AI с временными рядами: от построения моделей до валидации
— Поддержка разных задач: прогнозирование, классификация, регрессия, кластеризация
— Композиции моделей: пайплайны, ансамбли, тюнинг, редукции
— Удобный и интерактивный UX в духе scikit-learn

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 3
Post #7594 1.19K

Forwarded from Proglib.academy | IT-курсы

😱 Знакомо? Лимит уже закончился, а задача всё ещё не готова. Часть токенов могла уйти на повторное чтение файлов, лишний контекст и неудачные попытки.

⚡️ Этому посвящён отдельный блок курса «ИИ для разработчиков». Вы разберёте расходы на собственных проектах, сравните подходы и найдёте места, где агент выполняет лишнюю работу.

В итоге станет понятнее, сколько ресурсов выделять на запуск, когда его останавливать и в какой момент лучше изменить подход 🔍


До 31 июля курс можно купить со скидкой, а все материалы останутся в бессрочном доступе.

🔗 Узнать подробности о курсе

🏃‍♀️ Proglib Academy
Post #7593 1.6K
Куда на самом деле уходят токены во время агентного кодинга? ⚡️
Post #7592 2.14K
🔄 Superlog — open-source агентный мониторинг для продакшен ML-систем

Модель задеплоена. Трафик идёт. Что-то пошло не так — но в логах тысячи строк и непонятно где именно проблема.

Superlog решает именно это: принимает OpenTelemetry трейсы, логи и метрики, автоматически группирует шумные сигналы в инциденты и запускает AI-агентов для расследования.

🔧 Что внутри

· OTLP прокси для приёма телеметрии
· Автоматическая группировка событий в инциденты
· AI-агент который записывает саммари инцидента
· Postgres + ClickHouse под капотом
· Веб-интерфейс для дебаггинга

Если вы деплоите модели как сервисы — FastAPI, Triton, vLLM — стандартный вопрос: как узнать что что-то сломалось и почему? Superlog принимает OTel-метрики из любого фреймворка и сам разбирается в инцидентах пока вы спите.


docker compose up -d
pnpm dev
# OTLP: http://localhost:4101


📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 4
  • ❤ 1
Post #7591 1.98K
🎨 cnsplots: графики без боли с форматированием

Знакомая ситуация: модель готова, результаты есть, а половина времени уходит на подгонку размеров шрифтов, цветов и отступов под требования журнала.

cnsplots — Python-библиотека поверх matplotlib которая берёт это на себя.

🎨 Что внутри

Готовые стили под Cell, Nature, Science. Размеры в пикселях — точно под гайдлайны журналов. SVG с редактируемыми шрифтами для Adobe Illustrator.

25+ типов графиков: боксплоты, violin, scatter, ROC-кривые, volcano plots, heatmaps с кластеризацией, Kaplan-Meier, UpSet plots и другие.


pip install cnsplots


📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • ❤ 8
  • 👍 6
Post #7590 1.98K
Книга_ML.pdf6.5 MB
📚 Книга: Machine Learning with Neural Networks

Bernhard Mehlig, профессор физики University of Gothenburg, написал учебник по нейросетям с уклоном в математику и теорию. Доступна бесплатная версия без упражнений.

Охватывает всё от сетей Хопфилда и машин Больцмана до CNN, RNN и обучения с подкреплением.

Хорошо подходит если хотите понять теоретическую основу, а не только научиться пользоваться PyTorch.

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 3
  • ❤ 1
Post #7589 1.42K

Forwarded from Proglib.academy | IT-курсы

😳 Documentation Driven Development звучит как ещё один модный термин. Пока не попробуешь объяснить свой проект AI.

Агент работает только с тем контекстом, который ему дали. Если документация неполная или устарела, он начинает додумывать — отсюда появляется неверный код.

🔘 На курсе «ИИ для разработчиков» эту тему разбирает Арсений Харланов. Он покажет, как подготовить документацию и контекст, чтобы агент понимал архитектуру проекта, ограничения и связи между компонентами.

Также разберём, как выбирать модель под задачу: Claude, DeepSeek, Qwen и другие ✏️

Впереди 7 недель работы со своим репозиторием. Вебинары проходят вживую и остаются в записи.


Стартуем 31 августа. До конца июля можно присоединиться по ранней цене, а доступ к материалам останется бессрочным 😀

🔗 Посмотреть, что будет на курсе

🏃‍♀️ Proglib Academy
  • 🥱 2
Post #7588 1.49K
😏 Документация давно перестала быть формальностью. Особенно когда проект нужно объяснить кому-то ещё 👇
Post #7587 2.03K
🎯 TurboVec: 31 ГБ эмбеддингов в 4 ГБ без обучения

Хранение векторов для RAG быстро съедает память. 10 миллионов документов в float32 — это 31 ГБ RAM. Google выпустили open-source Rust-библиотеку которая меняет это соотношение.

TurboVec использует TurboQuant — квантайзер которому не нужно обучение:
· Нормализация вектора
· Случайный поворот
· Разбивка на бакеты через предвычисленную математику

Фиксированный пайплайн который работает на любых данных без калибровки под конкретный датасет.

Никакого managed сервиса который трогает ваши векторы. Работает с любой open embedding моделью. Получаете полностью air-gapped retrieval стек с Python биндингами.

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • ❤ 7
  • 😁 2
  • 🥱 1
Post #7586 1.69K
PCA видит паттерны которых нет и пропускает те что есть

Статья поднимает важный вопрос который многие игнорируют: простейший метод не всегда лучший.

PCA — один из самых популярных методов снижения размерности. Но у него есть системная проблема: он оптимизирует под дисперсию, а не под структуру данных.

⚠️ Три сценария где PCA ошибается

Данные гауссовы → PCA работает идеально, всё хорошо.

Данные — смесь гауссиан → PCA «видит» измерения которых нет. Проблема в ограничении ортогональности.

Данные нелинейно структурированы (например, динозавр из точек) → PCA не находит реальную структуру (1D-многообразие), зато находит «структуру» которой нет.


🎵 Phantom oscillations

Особенно коварный случай: если данные плавно меняются во времени (что почти всегда верно в реальном мире), PCA извлекает осциллирующие компоненты. Не потому что они есть в данных — а потому что PCA применён к гладким сигналам.

Это называется phantom oscillations.


🔧 Что делать

Альтернативы которые снимают ограничения PCA:

· ICA — убирает ограничение гауссовости
· NMF — убирает отрицательные значения, даёт parts-based представление
· Isomap, UMAP — работают с нелинейными многообразиями
· jPCA, GPFA — для временных рядов с динамикой

Но осторожно: более сложные модели тоже могут галлюцинировать. jPCA находит ротационную динамику даже там где её нет.

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • ❤ 5
  • 👍 3
Post #7584 1.56K
Git для дата сайнтиста: не только commit и push

Большинство DS знают базовые команды. Но несколько паттернов реально меняют качество работы с кодом.


🔀 merge vs rebase — в чём разница

Когда нужно влить изменения из main в свою ветку:


git pull origin main --no-rebase # merge: создаёт merge commit
git pull origin main --rebase # rebase: кладёт ваши коммиты поверх main


Rebase даёт чистую линейную историю — но осторожно если ветку используют другие.


↩️ revert vs reset — когда что


git revert <commit-hash> # создаёт новый коммит который отменяет изменения
git reset <commit-hash> # удаляет коммиты из истории (деструктивно)


Для командной работы — revert. reset только если история ещё не запушена.


📋 Что всегда должно быть в .gitignore


data/ # датасеты — не версионировать в git
.env # ключи и credentials
venv/
.vscode/
__pycache__/
*.pyc


Для версионирования данных — DVC поверх Git.


pre-commit — форматирование до коммита


# .pre-commit-config.yaml
repos:
- repo: https://github.com/astral-sh/ruff-pre-commit
hooks:
- id: ruff
- repo: https://github.com/psf/black
hooks:
- id: black


Ruff + Black запускаются автоматически перед каждым коммитом. Ревьюер фокусируется на логике, не на форматировании.


Правила которые реально помогают

· Маленькие коммиты с одной целью — легче ревертить и ревьюить
· Описательные названия веток: encode-categorical-columns вместо fix
· Никаких данных и секретов в репо

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 4
  • ❤ 1
  • 🤩 1
Post #7583 1.13K

Forwarded from Proglib.academy | IT-курсы

🤢 Чем больше разработчиков в команде начинают пользоваться Claude Code, тем заметнее одна проблема: кодовая база перестаёт выглядеть как работа одной команды.

Где-то есть тесты, где-то их забыли. Где-то агент следует архитектуре проекта, где-то предлагает решение, которое с ней не сочетается.

⚠️ И это не проблема Claude Code. Он просто следует тому контексту, который получает от каждого разработчика.

Сегодня покажем, как передать AI инженерный контекст команды и не превратить его внедрение в ещё один источник хаоса.

🗓 23 июля, 19:00 МСК
Бесплатно. 60 минут доклада + 30 минут вопросов.

🔗 Занять место на вебинаре и разобраться, почему так происходит

🏃‍♀️ Proglib Academy
  • 🥱 4
  • 👍 1
Post #7582 1.21K
Хороший разбор для тех, кто уже использует Claude Code в команде или только собирается его внедрять 🔥
  • 👍 1
Post #7581 1.53K
balance: библиотека для коррекции смещённых выборок

Классическая проблема в DS: есть данные опроса, но респонденты не репрезентативны — молодые отвечают чаще, богатые меньше. Как делать выводы о всей популяции?

balance решает именно это. Библиотека присваивает каждому респонденту вес — сколько людей из целевой популяции он представляет.

Как работает:

from balance import load_data, Sample

target_df, sample_df = load_data()

sample = Sample.from_frame(sample_df, outcome_columns=["happiness"])
target = Sample.from_frame(target_df)

sample_with_target = sample.set_target(target)
adjusted = sample_with_target.adjust()

print(adjusted.summary())
# Covar ASMD reduction: 62.3%
# ASMD: 0.335 → 0.126


ASMD (Absolute Standardized Mean Difference) — основная метрика качества балансировки. Чем ниже, тем лучше.


📊 Методы взвешивания

· IPW — логистическая регрессия с L1 регуляризацией
· CBPS — Covariate Balancing Propensity Score
· Post-stratification
· Raking

📊 Когда использовать

· Анализ опросов с non-response bias
· Observational studies (treated vs untreated)
· Любые данные с selection bias


pip install balance


📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 4
  • ❤ 2
Post #7580 1.83K
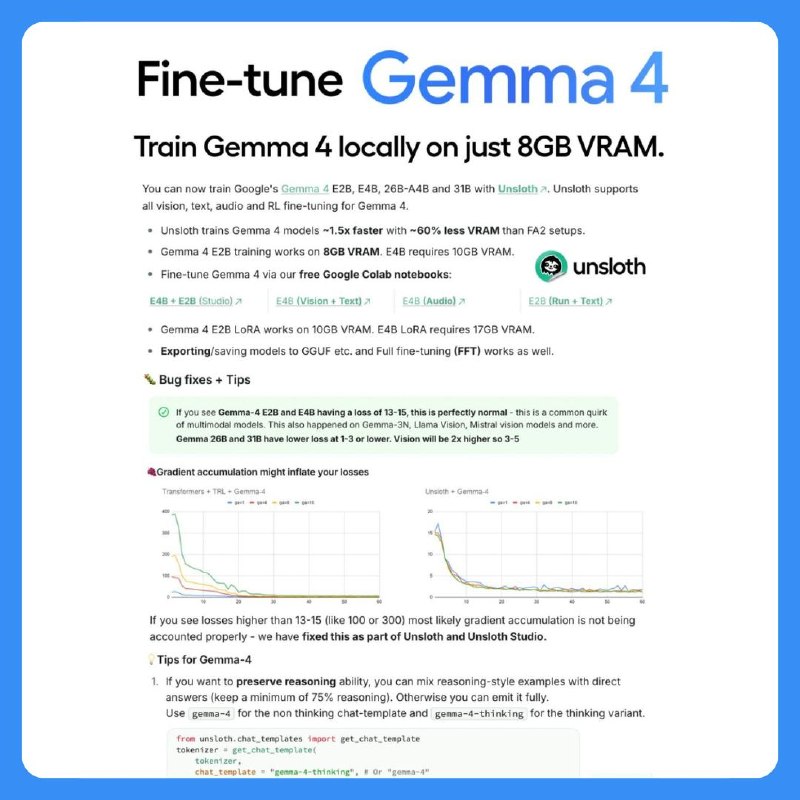
⚡️ Fine-tune Gemma 4 на ноутбуке

Тонкая настройка LLM больше не требует серьёзного железа. Gemma 4 через Unsloth можно дообучить на базовой GPU или даже в бесплатном Google Colab.

Что нужно

· Gemma 4 2B → 8 ГБ VRAM (бесплатный Colab T4)
· Gemma 4 4B → ~10 ГБ VRAM через LoRA
· Для большинства практических задач этого достаточно

Модели мультимодальные — одинаковый стек для:
· текстовых задач
· vision задач
· аудио задач

Ссылка на ноутбук

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 3
  • ❤ 2
Post #7579 1.85K
Инфографика.png4.9 MB
5 техник fine-tuning LLM

Инфографика по популярным методам тонкой настройки больших языковых моделей.
· Full Fine-tuning — все 100% параметров
· LoRA — только ~1.3% параметров
· LoRA-FA — ещё меньше, ~0.5%
· QLoRA — LoRA поверх 4-битной модели (140 ГБ → 35 ГБ)
· TinyLoRA — буквально единицы параметров

Смотрите инфографику выше 👆

📍 Навигация: ВакансииЗадачиСобесы

Библиотека дата-сайентиста

#буст
  • 👍 3
  • 🥰 2
  • ❤ 1
Post #7578 1.29K

Forwarded from Proglib.academy | IT-курсы

😸 Каждый разработчик подходит к задаче со своим опытом: помнит прошлые решения, знает ограничения проекта и понимает, какой код команда пропустит на ревью.

Для человека это естественная часть работы. У Claude Code этого контекста по умолчанию нет — только задача и инструкции, которые ему дали.

Поэтому в большой команде недостаточно просто выбрать хорошую модель.

❗️ Нужно ещё объяснить ей, как у вас устроена разработка: какие подходы приняты, что обязательно проверять и по каким правилам принимать решения.


🗓 23 июля в 19:00 МСК поговорим об этом на бесплатном вебинаре с Алексеем Жиряковым — он Executive Director в Сбере, руководит
GenAI Data Platform, и с этой проблемой сталкивался не раз 🔥

Покажет живое демо, разберём, как встроить AI в процесс разработки так, чтобы он реально помогал, а не добавлял ещё один повод для споров на ревью.

🔗 Занять место на вебинаре

🏃‍♀️ Proglib Academy
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →