TGViewer
Channel Public Channel
开发者工具箱|编程·开发工具·资源

开发者工具箱|编程·开发工具·资源

@devtoolboxhub

面向开发者的实用工具、库与效率技巧,写代码更快更爽。投稿 @BDHT1
#开发者 #编程工具 #效率 #程序员 · 开源总站 @GitHubTrendingHub
Subscribers
303
Photos
1.5K
Videos
0
Links
785

Showing posts older than #239 · Back to latest

Older Posts 13 shown
Post #238 2
Garudust: Rust 编写的日志 AI 分析 Agent

Garudust Agent 是一个基于 Rust 的 AI agent runtime,支持自托管,通过 LLM 自动检测日志异常,可实时或定时分析,并内置告警机制。

- 安装简单:提供预编译二进制或源码编译,支持 Anthropic、vLLM、Ollama 等 LLM 后端。
- 内置 log-analyst skill,可分析 syslog、应用日志等,自动识别异常模式并给出原因与修复建议。
- 支持 cron 定时检查,异常时通过 Telegram 自动告警;可自定义 skill 适配专有日志格式。
- 对比传统 grep/ELK :上下文理解更强,资源占用低(~10MB binary),支持中文分析,可完全自托管。

GitHub: GitHub
Hub: 原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #237 2
BuildPath:输入创意即获完整开发计划

创业规划工具 BuildPath 上线——输入想法、预算和技能水平,自动完成市场验证、技术栈推荐并输出执行计划。

- 输入创意、预算与技能,获取基于 Perplexity/ChatGPT/Claude 的定制验证方案
- 市场现实检查,评估可行性
- 完整技术栈推荐(AI 构建工具、IDE、托管、支付)
- 输出可执行计划 + PDF 导出
- 无需注册或信用卡,自带 API 密钥(Groq/OpenAI/Gemini)

🔗 原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #235 2
智能E2E测试:8轮揪出11个线上bug

作者发布基于六原则的 agentic E2E 测试系统实践报告,在 8 次运行中跨 5 个业务模块、3 种前端界面(管理后台/桌面版店铺/移动版店铺)发现 11 个生产环境 bug。系统知识库从 25 个 gotchas 增长至 42 个,首次尝试通过率从 14% 提升到 95%。

- 核心流水线由 4 个 agent 组成:分析(analyze)、规划(plan)、生成(generate)、修复(heal),每个 agent 独立职责,产出可审查的中间产物。
- 知识库(KB)分为项目本地与跨栈两类,通过 editorial gate 管理候选条目的自动升级,避免 KB 退化为错误日志;跨栈知识可在不同项目间复用。
- 该方法论已移植到第二套技术栈(FastAPI + Alpine 后端 + Next.js 管理后台),移植耗时数天,首次通过率从约 48.6% 升至 91.4%,验证了饱和曲线的可复现性。

GitHub
原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #234 2
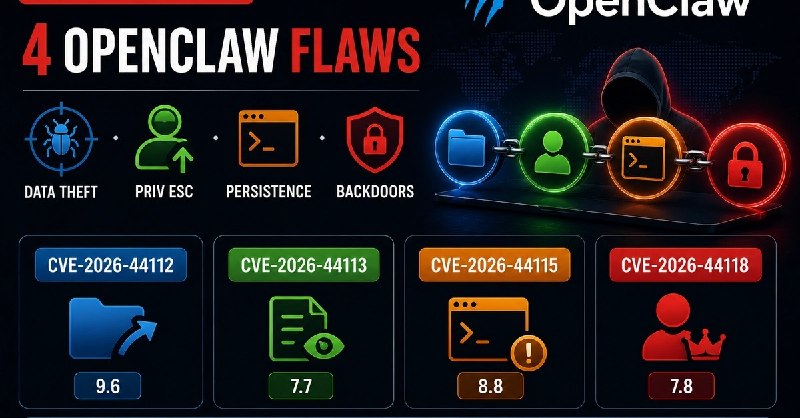
OpenClaw曝高危漏洞链

安全研究人员披露了开源AI agent平台OpenClaw的四个可链式利用漏洞(Claw Chain),可导致数据窃取、权限提升、沙箱逃逸和持久化控制。最严重的 CVE-2026-44112(CVSS 9.6)是沙箱写逃逸漏洞,允许攻击者重定向文件写入到沙箱外。其他三个漏洞涉及沙箱读逃逸、命令白名单绕过和所有者上下文伪造。建议用户立即升级到 2026.4.22 或更高版本,并审计插件和工作流。

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #233 2
Claude Code 清理上下文三规则

长时间混用 Claude Code 做不同任务,会引发跨话题混淆、纠正后错误反复、Token 配额超标。问题不在模型,在上下文管理。三条原则:

1. /clear 是卫生习惯
切换任务、经历“你说得对”死循环后立即清空会话,成本为零。

2. 上下文存在磁盘
把结论写进 markdown 文件,用文件替代历史对话(2k token 文件替换 25k 历史),避免错误残留。

3. 按阶段选模型
研究用 Opus,写计划到磁盘,再 /clear后用 Sonnet 执行。相同工作量可省一半以上 token 成本。

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #230 2
一周内发布两套生产级 AI Agent

一位开发者分享从想法到生产部署的全流程:两个 AI Agent 项目已上线,其中 Craftsman-Agent 在 Product Hunt 当日排名 #36(200+ 产品),正服务真实流量。

- Craftsman-Agent:根据提示生成 3D 组装图和步骤说明,支持乐高、Minecraft、特斯拉车贴等创意场景。技术栈包括 Gemini/OpenAI、DeepNLP OneKey Gateway 和 3D 渲染 API。
- CoachOwl Agent Timetable:AI 日程编排平台,允许人类和 AI Agent(Codex、Claude、Gemini)协作完成任务,支持日历集成、任务分配与跟踪。开源代码见 GitHub。
- 开发与成本:Craftsman 网站数分钟搭建,核心工作流 3 天;CoachOwl 数据库与执行系统耗时 4-5 天。LLM 和 API 调用成本约 $50-67/千次,托管免费基础版。

原文链接
相关链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #228 2
用GitHub Actions给每个PR配4个AI审阅

作者为单人项目Khetisahayak(农技应用)设计了一个GitHub Actions工作流,每个PR自动触发4个不同角色的AI审阅者(Senior Developer、CSO、Engineering Lead、Software Architect)和测试运行器,共产生5条独立反馈。

• 工作流仅需两个文件:workflow YAML(.github/workflows/code-review-agents.yml)和约120行的Python脚本(.github/scripts/review_agent.py),无额外基础设施
• 基于Gemini 2.0 Flash API,每次PR成本约$0.01,配合GitHub Actions免费额度
• 触发条件:PR targeting main/develop(非draft);权限仅限read代码、write pull-requests和issues
• 作者指出可改进点:顺序链浪费时间、review-gate未实际阻塞合并、API限流(429)处理、重复获取diff等

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #227 2
CVE-2026-44338漏洞4小时内遭扫描

PraisonAI(多智能体编排框架)遗留 Flask API 服务器存在认证绕过漏洞(CVE-2026-44338),默认禁用认证,允许未授权访问敏感端点。

- 影响版本:2.5.6 至 4.6.33,已修复于 4.6.34
- 攻击者在公告发布后 4 小时内开始探测,使用 User-Agent "CVE-Detector/1.0",对 GET /agents 请求成功返回 200
- 已观测扫描源 IP:146.190.133.49
- 建议立即升级,移除公网暴露,审核日志,轮换 agents.yaml 中的凭证

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #226 1
Veo 4 或在 I/O 2026 发布,70% 概率

Google 尚未发布 Veo 4。当前最新视频模型为 Veo 3.1,2026年4月新增低成本变体 Veo 3.1 Lite。根据发布节奏(2024年5月 Veo → 2024年底 Veo 2 → 2025年 Veo 3 → 2025年底/2026年初 Veo 3.1),Veo 4 最可能在 Google I/O 2026(5月19-20日)亮相,概率约 70%。

Veo 3.1 API 定价(单位:美元/秒):Standard 720p/1080p $0.40、4K $0.60;Fast $0.10/$0.12/$0.30;Lite $0.05/$0.08(无4K)。Veo 4 需改善可控性(长镜头、角色一致性、场景控制、音频对位、物理模拟等)。

当前可通过 Gemini App/API 或 Vertex AI 使用 Veo 3.1。建议开发者做好迁移准备:配置化模型 ID、建立 50 条 prompt 评估集、对比成本与可用性,再决定迁移。

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #224 1
三大AI Agent评测框架横评

近日一篇技术文章对比了 Strands Agents、PydanticAI 和 DeepEval 三种 AI Agent 评测框架,使用同一套测试用例和同一 judge 模型(gpt-4o-mini),结果得分却不一致。以下是关键点:

- Strands Agents 代码最简洁(7 行完成 LLM-as-Judge),原生支持 Amazon Bedrock,提供零成本的确定性工具检查(ToolCalled)。
- PydanticAI 配置最灵活,支持 YAML 数据集定义和报告基线对比,但工具评估依赖 OpenTelemetry 实时追踪,无法直接评测预计算的工具列表。
- DeepEval 内置 30+ 指标,含专用 HallucinationMetric,采用 G-Eval 技术(链式思考+对数概率加权),得分与直接 rubric 评分自然有差异。

文章附带了完整代码示例和对比表格。

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #223 1
AI Agent 评估框架对比:Strands vs PydanticAI vs DeepEval

一篇深度对比文章,在相同测试用例(Claude Sonnet 4 on Bedrock)下比较三个框架的评估效果。核心发现:

- Strands 最简洁(LLM-as-Judge 仅 7 行),原生支持 Bedrock,内置轨迹提取与零成本确定性校验
- PydanticAI 最注重类型安全与可重现管道,提供 YAML 数据集与基线 diff 报告
- DeepEval 框架无关,拥有 30+ 内置指标(含专用幻觉检测 HallucinationMetric),最适合只用评估不建 Agent 的场景

三个框架的评分因评估方法论(直接打分 vs G-Eval chain-of-thought)可能相差高达 40%,此为设计而非 Bug。

🔗 原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #222 1
编程 Agent 模型选型:匹配重于能力

AI 编码 Agent 的核心问题不是「哪个模型最强」,而是「哪个模型最适合当前任务」。模型能力只解决一半问题,另一半是任务类型与模型大小的匹配。一文梳理出以下要点:
- 编码任务分四类:机械操作、本地推理、仓库推理、长周期 Agent 任务,各有不同模型需求
- 小模型适合分类、摘要、简单编辑;中型模型适合日常编码;前沿模型留给高风险、高不确定场景
- 模型路由与级联策略(从小模型开始,失败则升级)可降低推理成本
- 最优模型还取决于执行环境(harness),不同框架对模型智能的消耗方式不同

原文链接

#开发者 #工具

📢 频道:@DevToolboxHub
Post #219 1
编译时AI:确定性 GCP Landing Zone 生成

LLM 辅助创建模板与规则,运行时不依赖模型,确保合规配置可重复、可审计。

- 两阶段方法:Phase A 由 LLM 构建结构化语料库(schema、合规映射、Jinja2 模板、验证器),经人工审核后版本化;Phase B 通过确定性管道生成 Terraform/YAML/图表,无 LLM 参与。
- 运行时不调用任何模型,相同输入与语料版本输出完全相同,消除采样随机性。
- 支持 HIPAA、FedRAMP 等合规框架自动映射,也可补充文档未覆盖的参数(如预算告警阈值、命名约定),默认值来自行业实践。
- 独立架构师可通过 Merlin 免费使用,支持访客模式验证生成结果的可复现性。

🔗 原文链接
🔗 相关链接

#开发者 #工具
📢 频道:@DevToolboxHub
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →