TGViewer
Channel Public Channel
开发者工具箱|编程·开发工具·资源

开发者工具箱|编程·开发工具·资源

@devtoolboxhub

面向开发者的实用工具、库与效率技巧,写代码更快更爽。投稿 @QLAI9
#开发者 #编程工具 #效率 #程序员
Subscribers
895
Photos
1.4K
Videos
0
Links
760
Recent Posts 16 shown
Post #1866 1
AI reshaping 全球服务外包市场

数十年来,企业扩张运营规模默认方案是将后台工作、一线客户服务和行政支持转移到低成本人力中心。

印度和菲律宾在全球服务贸易中占据了巨大份额,根据ISG市场报告,印度IT-BPO行业每年创收超2000亿美元,菲律宾IT-BPM收入达到400亿美元。加上更广泛的IT服务和共享企业运营,全球业务流程外包和IT服务每年总支出接近1万亿美元。
现在情况发生了根本性转变:基于人力套利、大规模人工协调和实体呼叫中心的传统离岸模式,正在让位给程序化智能。由xAI的Grok、OpenAI的Codex和Anthropic的Claude等模型驱动的软件栈,正在将价值从以人为中心的外包中心转移,直接拉回硅谷的基础设施中。
AI替代人类虚拟助手的技术流程分为三层:首先是感知解析层,处理非结构化输入,做实时语音转文字、上下文提取和意图分类;然后是认知合成引擎,由不同LLM负责特定任务,Anthropic Claude 3.5处理复杂逻辑与合规,xAI Grok做实时数据合成与平台上下文处理,OpenAI Codex完成代码转换和模式映射;最后是执行与工具调用层,通过标准协议直接触发API操作,完成数据库操作、企业系统更新、自动化响应等工作,无需人工录入。
随着这类软件栈从基础聊天机器人进化为完全自主智能体网络,多个核心外包岗位正在被替代:一级和二级客户支持代表、数据录入与行政虚拟助理、初级软件维护与QA工程师、后台运营与发票处理员。
相比传统外包BPO,基于硅谷AI栈的架构优势显著:单任务执行成本,传统离岸BPO是每小时8-14美元,AI栈每次API调用仅0.001-0.05美元;解决时间传统需要4-24小时,AI仅需亚秒到分钟;员工流动率传统是每年20%-45%,AI无需人力流动;运营可用性传统受排班和时区影响,AI全年无休持续运行。

依赖传统BPO模式的组织相比原生AI的竞争对手,面临明显运营劣势。资本正从离岸人力薪资转向算力基础设施,全球运营经济格局正在被改写,万亿美元规模的服务市场正从分散呼叫中心转向硅谷的API端点。
Post #1865 1
AI 代理端到端开发工作流

现有AI编码代理能较好完成单个开发任务,但处理包含多个关联任务的完整功能需求时,会遇到任务编排、依赖管理和风险控制等问题。近期有文章提出一套从Epic到合并的端到端AI代理开发工作流,可在减少人工干预的同时,保留变更风险所需的控制措施。

这套工作流的核心思路是将大型功能需求(Epic)拆解为粒度合适的独立任务,构建依赖关系图,让不同AI代理分工协作,再逐步集成验证。Epic作为需求意图的来源,应包含目标、背景、范围、验收标准等信息,实践中可将其作为GitHub父Issue,任务作为子Issue存放,贴近代码管理。

任务分解要关注内聚性而非代码量:一个足够粒度的任务,需要能独立交付、验证和回滚,可作为一个逻辑单元评审。如果一个任务同时包含调研和实现,应当拆分,先做调研减少不确定性,再执行实现,便于控制AI代理行为。

每个任务执行前需做就绪检查,确认结果清晰、范围明确、依赖已声明、架构决策已定等。任务运行采用隔离环境,每个任务有独立的Git分支、工作树或容器,避免文件冲突。任务依赖需要显式建模,编排器可并发执行无依赖任务,比让代理自行发现顺序更安全。

工作流设置三类核心角色:
- Planner:负责调研代码库,识别风险,制定执行计划,不修改生产代码。
- Builder:按批准的计划实现变更,更新测试,运行验证,提交变更,发起PR。
- Reviewer:独立评估变更结果,基于验收标准给出结构化的明确问题,而非模糊评价。

编排方式分为内部编排和外部编排,该工作流倾向于使用外部编排,支持确定性流程、显式并发和持久化状态。每次仅给任务提供完成工作所需的最小上下文,避免过多无关信息干扰决策,同时基于风险定义AI代理的自主权限:哪些操作可自动执行,哪些需要人工审批。

完整的实现流程从创建Epic开始,经过任务分解、构建依赖图、创建集成分支、生成任务上下文、运行Planner、创建隔离环境、执行Builder、发起任务PR、运行Reviewer、修正循环、合并到集成分支、Epic级验证、最终人工批准合并到主分支。可根据不同角色选择不同能力的模型,对工作流指标做量化测量,持续优化流程。

文章认为,AI辅助开发目前最值得关注的问题不是代码生成,而是编排。更强大的模型能提升单任务执行能力,但不能解决任务编排问题,合理的工作流可以把开发者从日常实现中解放出来,专注于需求、架构和风险等需要判断力的决策环节。
Post #1864 1
2026年LLM路由工具选型对比

选择LLM路由工具的核心依据是基础设施控制权,而非模型数量。LiteLLM支持100+模型提供商,已经成为混合部署自托管模型与云端模型团队的标准方案,它作为OpenAI SDK的即时代替,由用户自行负责更新、密钥管理和扩缩容。

OpenRouter刚完成1.13亿美元B轮融资,估值达13亿美元,其核心能力是通过单API密钥对接多厂商模型,方便开发者快速测试新模型,但不支持像专用网关那样暴露底层提供商信息。

若你自行运营GPU集群,可选择LiteLLM来抽象不同后端的差异。若你使用云端推理服务,Portkey和Cloudflare AI Gateway更合适,二者侧重可观测性与边缘性能;Vercel AI Gateway适合前端 heavy 应用,通过无服务器基础设施处理请求。

不同选型各有局限:LiteLLM需要工程投入维护;Portkey和Cloudflare绑定各自生态;OpenRouter会收取使用溢价,增加大规模使用成本;现成的轻量级客户端虽然无需配置、自带4个预设代理,方便快速启动工作流,但不支持自定义路由,也没有公开披露上游提供商信息,不适合企业生产环境使用。
Post #1859 1
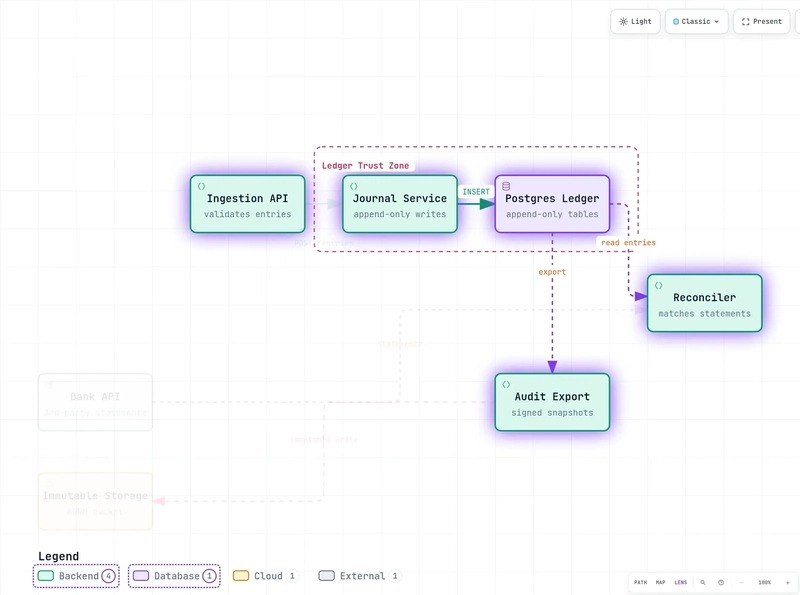
Archify 推出浏览器端交互式图表

Archify 是MIT许可的开源系统图表生成工具,2026年4月创建,截至2026年9月已收获超65000个Star,目前仅以Agent技能和CLI形式提供,需要安装到 Claude Code、Codex 等编码Agent中使用。官方设计决策明确将托管在线版本排除在项目范围外,没有官方在线版本可用。

第三方开发者基于Archify的MIT许可渲染引擎,移植推出了浏览器端版本,无需安装Agent和CLI即可使用。该移植保留了Archify核心的确定性渲染能力,支持点击聚焦节点、路由追踪、语义分层筛选、引导式浏览和节点搜索等交互能力,导出的自包含HTML文件可离线使用所有交互功能,适合附加到PR中分享。

浏览器端版本新增了原Archify不支持的输入类型:
• 支持粘贴Mermaid流程图
• 支持粘贴docker-compose、Terraform、Kubernetes清单
• 支持粘贴SQL schema
• 支持直接用自然语言描述系统

浏览器端版本免费提供前10次图表生成,之后使用付费 credits。如果你已经在使用 Claude Code 等编码Agent,推荐使用官方免费的CLI版本;如果需要零安装快速生成交互式图表,浏览器端版本可满足需求。
Post #1858 2
PostgreSQL 参数 max_parallel_apply_workers_per_subscription 解析

max_parallel_apply_workers_per_subscription 用于控制单个订阅可同时应用大型未完成事务的并行应用工作进程数,超过该数量的事务会被写入文件延后处理。默认值为2,可配置范围是0到1024,从 PostgreSQL 16 开始引入,到PostgreSQL 19 beta 3 都没有变化。

PostgreSQL 18 开始,CREATE SUBSCRIPTION 默认开启该参数,通过 pg_upgrade 升级的订阅会保留原有配置。该参数仅限制单个订阅可同时处理的事务数量,调大该参数不会加快单个事务的应用速度,其优势是大型事务的大部分内容在提交前就已完成应用,能显著降低后续小事务的可见延迟。测试显示,在发布端插入40万行数据后紧跟一个单行事务,使用该参数默认值时订阅端约0.2秒就能看到单行事务;参数设为0时,延迟在3.2到4.0秒之间。

当该参数设为默认值2时,如果同时有3个大型事务开启,只有两个能获得工作进程,第三个会被写入临时文件且默认日志级别不会输出提示。参数需要重新加载配置生效,而工作进程池需要重启服务生效,修改时需要先扩容工作进程池。

存在三种会强制将所有流式事务写入临时文件的场景:发布端版本低于16;订阅中有任意一张表处于初始同步或刷新同步状态;存在待处理的 ALTER SUBSCRIPTION ... SKIP 操作。
Post #1857 2
全端离线AI助理新增拒答能力

FamiliaSync 是一款离线优先的加密家庭 organizer 应用,所有数据都存储在用户自有设备中,因此内置助理的所有查询也必须在手机本地运行,不调用云端服务。

开发团队将原手写规则的意图路由,替换为小型端上意图分类器。分类器基于人工整理的训练语料,包含105种意图和约2400条示例语句,其中35种意图对应应用内实际工具,剩余70种意图用于标注当前暂不支持的请求类型,确保不支持的请求会转交给端内大模型处理,而非强制匹配到错误工具。

分类器额外设置置信门槛,若模型对分类结果不确定,则直接转由大模型处理,全程训练、推理都在设备本地完成,查询数据不会离开手机。

上线当日真实测试就暴露了三类错配问题,开发团队针对性调整了关键词处理规则、补充训练语料,优化了结果输出格式。更新后助理支持多轮对话,可主动追问缺失参数,优化了非正式日期格式解析,也能正确处理未指定成员的日程创建请求。目前 FamiliaSync 处于预 launch 阶段,开放等候名单。
Post #1856 3
AI漏洞发现速度超人工修补引发安全危机

AI技术正在改变网络安全领域,现代AI模型可帮助研究人员分析大型代码库,梳理攻击路径,复现漏洞,甚至给出修复建议,大幅加快了漏洞发现速度。

到2026年9月中旬,已记录超过66000个CVE,增速是2025年的两倍以上。Oracle 2026年7月的 Critical Patch Update 是其有史以来最大规模的安全更新,包含1449个安全补丁、1434个不同CVE,覆盖334款产品,Oracle明确表示增量部分来自AI助力的漏洞识别。

漏洞发现变成机器速度,但修复仍然是人工速度,这种不平衡是真正的问题。攻击者同样可以利用AI加速发现和利用漏洞,Google Mandiant团队2026年数据显示,平均漏洞利用时间为负7天,也就是部分漏洞在补丁发布前就已经被利用。

Google已经开源了Mantis系统,帮助自动化完成从发现漏洞到分类、复现、修复的全流程,结合智能代理技术和沙箱复现来验证结果,降低AI误报。开发团队需要调整安全流程,将扫描自动化加入CI/CD,按实际风险排序优先修补,加快补丁周期,用AI辅助修复而不是仅用来发现漏洞,最终保留人工审核环节。
Post #1855 2
MySQL慢查询排查优化实战指南

数据库变慢是运维和DBA最常遇到的问题,但这类问题排查往往没有明确方向,容易盲目猜测导致效率低下,甚至引发新的生产问题。本文梳理了一套从定位问题到验证优化的完整闭环排查方法,针对MySQL 5.7和8.0的版本差异也做了明确说明,方法主要基于主流的InnoDB存储引擎展开。

排查的整体流程为:先通过慢查询日志或SHOW PROCESSLIST定位问题SQL,再用EXPLAIN分析执行计划找到原因,在测试环境验证索引优化方案,最后在生产环境审慎实施并做好回滚预案。排查前需要先判断是全局性变慢还是局部性变慢,全局性问题优先排查资源层面问题,局部问题优先分析具体SQL执行计划。

开启慢查询日志需要先手动配置,可以在线动态开启,也可以写入配置文件持久化。long_query_time一般以1秒为排查起点,可根据业务需求调整。开启后推荐使用mysqldumpslow或pt-query-digest对日志做汇总分析,重点关注单次耗时过长和执行频次高的SQL。如果问题正在发生,可直接通过SHOW PROCESSLIST查看当前会话状态,定位锁等待或正在执行的慢查询。

定位到问题SQL后,通过EXPLAIN分析执行计划判断问题,重点关注type、key、rows等核心字段。MySQL 8.0还可以使用EXPLAIN ANALYZE得到更精确的实际执行信息,但生产环境使用需要谨慎评估成本。常见优化场景为补充合适的联合索引,联合索引的字段顺序建议将区分度高、等值查询频率高的字段放在前面,优化后需要重新验证执行计划和实际耗时。生产环境创建索引推荐使用ALGORITHM=INPLACE, LOCK=NONE降低锁表风险。
Post #1854 4
构建自动生成TikTok内容的机器人

这是一个全自动化流程,可自动抓取 Reddit 热门帖子,生成语音旁白,拼接音频和截图导出为视频,最后发布到 TikTok,全程无需人工干预。

预计整体搭建时间为 4-6 小时,包含测试和账号绑定。

用到的工具及各自作用:
• Reddit API(OAuth):免费额度,获取热门帖子
• Python 3.11+:免费开源,编排工作流
• ElevenLabs TTS API:免费试用额度,生成语音旁白
• CapCut Desktop (Windows):免费额度,视频剪辑导出
• TikTok API(第三方服务或手动上传):免费额度,发布最终视频
• n8n(可选):社区版自托管免费,或使用云方案,可视化编排和webhook触发
• GitHub:免费额度,版本控制

该流程共分为 10 步搭建:
1. 在 Reddit 创建脚本类型应用,获取 OAuth 所需的凭证。
2. 创建 Python 虚拟环境,安装依赖包:requests、python-dotenv、elevenlabs-sdk。
3. 在项目根目录创建 .env 文件存储密钥信息,避免凭证出现在源代码中。
4. 通过 Reddit API 认证后,拉取当日点赞最高的 5 篇帖子。
5. 清洗文本内容,去除链接和 Markdown,限制长度,转为短视频脚本。
6. 调用 ElevenLabs TTS 接口生成音频,保存为 MP3 文件。
7. 通过 puppeteer 调用无头 Chrome 对帖子网页截图,保存为图片文件。
8. 使用 CapCut 通过 JSON 项目文件拼接图片和音频,导出为适配 TikTok 的 MP4 视频。
9. 通过 n8n webhook 接收视频路径,调用第三方服务上传到 TikTok。
10. 将步骤 4 到 9 封装为 main 函数,通过定时任务每 4 小时执行一次,保证持续产出新内容。

常见故障及解决方法:
• Reddit OAuth 令牌过期(1小时),返回 401:每次运行刷新令牌,或使用新版 OAuth2 流程存储长时效刷新令牌。
• ElevenLabs 配额超限,返回 429 或空音频:通过 ElevenLabs 面板监控用量,添加指数退避,超限后切换到其他低价 TTS。
• CapCut CLI 在处理大图时卡住,没有输出 MP4:导入前将截图调整为 1080×1920,限制图片时长不超过 5 秒。
• 第三方上传工具拒绝文件,返回 HTTP 400:确保 MP4 使用 H.264 视频和 AAC 音频编码,可通过 ffmpeg 重新编码。
• n8n webhook 无法访问:将 n8n 部署到静态 IP 后,开发阶段可使用 ngrok 等隧道服务,添加健康检查告警。
• 产生意外账单:在脚本中设置每日生成视频数量上限,记录使用情况方便审计。


这个流程是模块化的,可以替换不同的 TTS、编辑器或内容来源,控制好调用频率和成本,就可以持续自动产出内容。
Post #1853 6
**Cloudflare 部署项目的静默失效问题

开发者部署了三个新的区块链工具端点,想检查使用情况,却发现统计端点本身已经崩溃。

问题出在生产环境中 env.PRESEND_ANALYTICS 未定义,KV 命名空间存在但从未绑定到 Pages 项目,因为 wrangler.toml 配置覆盖了仪表盘 UI 设置。

修复绑定后,统计端点恢复,查到三周内已有 4852 次真实 API 调用,同时还发现所有端点的限流全程无效,因为它也采用了相同的静默降级策略。

接着检查反馈表单,又发现两处问题:反馈数据库是几周前创建的 D1 实例,但从未创建反馈表,所有提交都被静默丢弃,只有一条 8 月中旬的反馈留存下来;CSP 头部禁止了 challenges.cloudflare.com 加载,导致反机器人小部件一直被自身安全策略拦截;修复 CSP 后又发现密钥不匹配,复制时两次选错字段。

四个不同问题都有相同的失效模式:因为设计成“故障开放”,缺失绑定不会崩溃,只会静默失效,不主动检查根本发现不了。

故障开放对用户体验来说是正确设计,缺失分析绑定不应该影响正常流量的限流,但这意味着需要单独的定时检查来主动告警绑定缺失,而不是靠人工手动调用端点发现问题。

开发者目前还没有实现这样的检查,下一步计划补充,同时提问:如果在 Cloudflare Workers/Pages 上使用 KV 或 D1 绑定,大家都是怎么验证生产环境绑定正确的?有没有现成的标准方案?
Post #1852 5
AI 生成警报规则,人工把关不让误触

在 Taabi Mobility 的 taabi Nexus 平台中,驾驶员的行车记录仪会触发多种警报(疲劳、手机使用、座椅安全带、急刹车等)。管理者只需用一句英文描述想要的动作,系统会把这句话翻译成 JSON 规则并执行。规则示例:在 60 km/h 以上行驶时,若同一车在 10 分钟内出现两次疲劳警报,先通知经理;若 10 分钟后仍未解除疲劳,则拨打司机电话。

规则通过 Pydantic v2 定义,生成 JSON Schema 与 TypeScript 类型,保证 UI、模拟器、评测等所有组件使用同一结构。

关键流程
- 写规则:管理者输入一句话,LangGraph 先检查阈值与通道是否完整,若缺失则中断并提示。
- 验证与回放:规则通过约 30 条语义检查后,在过去 7 天的历史数据上回放,返回“会触发 27 次,58 次被节流”。
- 审批与激活:审批仅保存草稿,激活需手动点击按钮,模型无法直接触发。
- 调用与跟进:拨打电话由通知器排队,模型不直接发起,所有后续跟进需人工关闭。

技术要点
- Postgres 16 + RLS,tenant_id 通过 JWT 强制,防止跨租户访问。
- Kafka 处理规则更新,aiokafka 读取压缩主题,重启后可从 Kafka 重新构建规则。
- 监控:Grafana、Prometheus、OpenTelemetry 追踪每条警报,p99 94 ms,99.9 % 无死信。
- 语言与框架:Python 3.12、FastAPI、React 18、Playwright、Docker Compose。

经验教训
- 规则阈值与通道必须在摘要中明确,避免“每小时最多一次”误解。
- 现场电话决策需避免全流程代理,单次 API 调用可在 1.2 s 内完成。
- 语音识别对司机说话不稳定,建议多轮确认并在通话后重新检查警报流。


如果你也在构建自然语言规则或带人工审核的代理,欢迎交流你如何放置“切换”点。
Post #1851 4
多租户 Node.js 应用:请求上下文演变为基础设施

在多租户 Node.js 应用中,最初只需从请求头读取 tenantId 并传递给服务即可。随着业务增长,tenantIdrequestId、数据库选择、事务会话、日志元数据、调试状态等信息也会随请求携带。此时,单纯把这些值作为函数参数传递已无法满足需求,应用层需要手动维护并传递所有上下文信息,导致错误频发且难以维护。

核心问题

- 执行状态传播:手动传递 tenantId、事务会话等会导致遗漏或错误。
- 职责混乱:业务逻辑与基础设施(数据库路由、事务、日志)交织在一起。
- 可维护性差:每个层级都需关注同一组上下文,代码冗长且易错。

解决方案
Node.js 提供 AsyncLocalStorage,可在异步调用链中存储共享状态。通过在请求边界(或任何执行边界)调用 runWithContext,将 tenantIdrequestId、事务会话等放入共享上下文,后续所有业务代码可通过 getContext() 读取,无需显式传递。

优势
- 职责分离:业务层只关注业务逻辑,基础设施层负责租户解析、数据库路由、事务管理等。
- 事务统一:在事务边界设置会话后,所有模型操作自动使用同一事务,无需手动传递。
- 日志与监控统一:上下文中的 requestIdtenantId 自动附加到所有日志与指标,便于追踪与分析。
- 灵活扩展:同一机制可用于 HTTP 请求、队列任务、CLI 命令等多种执行源。

实践示例
```js
const storage = new AsyncLocalStorage();

function runWithContext(context, fn) {
return storage.run(context, fn);
}

function getContext() {
return storage.getStore();
}

// HTTP 中间件
app.use(async (req, res, next) => {
const tenantId = req.header('x-tenant-id');
if (!tenantId) return res.status(400).json({ error: 'Tenant is required.' });
const requestId = crypto.randomUUID();
await runWithContext({ tenantId, requestId }, async () => next());
});
```


结论
当多租户应用需要在业务层、事务、日志、监控等多处共享执行状态时,单纯的请求上下文已不足以满足需求。通过 AsyncLocalStorage 等执行上下文机制,将这些状态提升为运行时基础设施,既简化了代码,又提升了系统的一致性与可维护性。
Post #1850 3
AI 编码助手的仓库安全风险

AI 编码助手在打开仓库时会读取代码、配置、脚本和专属指令文件。
如果仓库包含恶意配置或脚本,助手会在执行常规 Git 操作(如 git statusgit diff)时触发攻击,甚至通过提示注入泄露环境变量或执行不受信任的命令。

主要威胁

- Git 配置攻击:如 core.fsmonitor 指向恶意程序,导致助手执行攻击代码。
- 提示注入:仓库中的指令文件可直接影响助手行为,可能绕过安全规则并泄露凭证。
- 权限滥用:助手往往拥有终端、浏览器、凭证等多重权限,若被攻击可造成大范围破坏。

防护建议
1. 先审查再信任:打开未知仓库前检查 .git/config、脚本、AI 指令目录等。
2. 最小权限原则:限制助手访问生产凭证、云账号、SSH 密钥等。
3. 沙箱执行:对不熟悉的项目使用容器或临时 VM,降低风险。
4. 预览并审查技能:GitHub 等平台的 AI 技能需先预览,确认无恶意脚本。
5. 隔离敏感变量:确保助手不必访问 AWS_SECRET_KEYGITHUB_TOKEN 等敏感环境变量。


结语
AI 编码助手是强大工具,但其对仓库的深度访问也带来了新的安全边界。开发者需像对待任何特权系统一样,对仓库、助手指令和凭证进行严格审查与隔离。
Post #1849 3
标题

BootSaaS:schema‑per‑tenant 方案防止跨租户数据泄露

正文

在 B2B SaaS 中,单一查询缺失租户过滤即可让用户看到其他客户的账单。
BootSaaS 采用 schema‑per‑tenant 架构:
- 每个租户拥有独立的 PostgreSQL schema(如 acme.invoicesglobex.invoices)。
- 业务查询保持简洁:SELECT id, amount FROM invoices,连接层根据租户上下文自动切换到对应 schema。
- 通过 Spring Security 解析 JWT 中的 tenantId,填充 CurrentTenantIdentifierResolverMultiTenantConnectionProvider,确保请求在正确的 schema 下执行。

核心优势
- 业务表隔离:不同租户的数据完全分离,避免误读。
- 共享连接池:单一数据库角色与统一 HikariCP 池,资源利用率高。
- 统一迁移:Liquibase 负责所有租户的 schema 变更,迁移脚本可复用。

实现要点
- 租户注册后异步创建 schema,完成迁移才标记为可用。
- 迁移历史与锁表放在各自租户 schema,防止跨租户冲突。
- 通过测试覆盖:租户导出不泄露他人数据、ID 访问隔离、错误迁移恢复等。


BootSaaS 为想要在 Spring Boot + Angular 环境下快速搭建安全、可扩展 SaaS 的团队提供了完整的架构与实现参考。
Post #1848 4
日本站点字体错误:隐藏的视觉缺陷

日本站点的文字在大多数设备上会被错误渲染成中文字体。
- 109 家全球品牌中有 5 家在 CSS 里优先使用中文字体,导致所有访问者看到的日文文字采用中文字形。
- 81% 的日本公司已声明日文字体,而全球品牌仅 42%。
- 87% 的全球品牌在无日文字体环境下(如 Linux、服务器渲染)会出现中文字形。

根本原因
Unicode 将日中共享字符统一编码,视觉差异由字体决定。若 CSS 未声明日文字体,浏览器会使用设备默认字体;若声明中文字体且排在前面,所有日文字会被渲染为中文字形。

三步修复
1. 在 <html>lang="ja"
2. 明确声明日文字体:font-family:"Noto Sans JP","Hiragino Sans","Yu Gothic",sans-serif;,并确保中文字体不在前。
3. 如需 Web 字体,可使用子集(几十 KB)并配合 unicode-range

检测工具
使用免费扫描器(glyphchecker.com)可对比有无日文字体环境下的渲染差异,并给出修复 CSS。

只需一行 CSS,即可消除设备差异,保证所有用户看到正确的日文字形。
Post #1840 4
突破 DynamoDB 向量搜索 TopK=100 限制

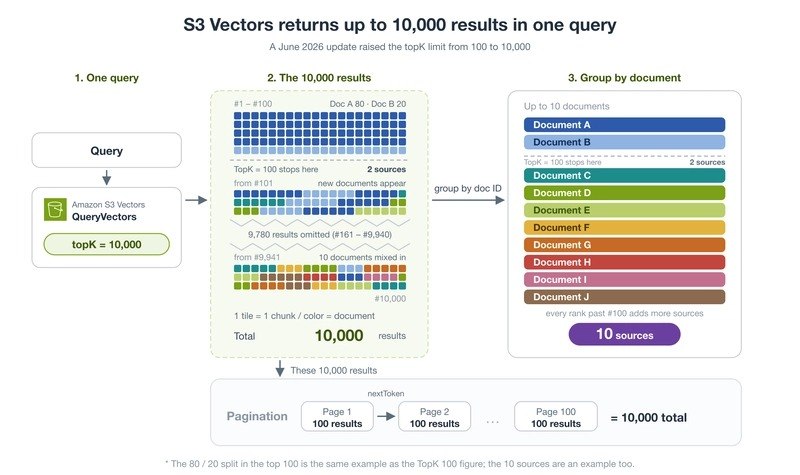
DynamoDB 在 2026 年 8 月正式支持向量数据,但单次查询最多返回 100 条结果,限制了 RAG 方案中“先广泛检索再重排”的实现。
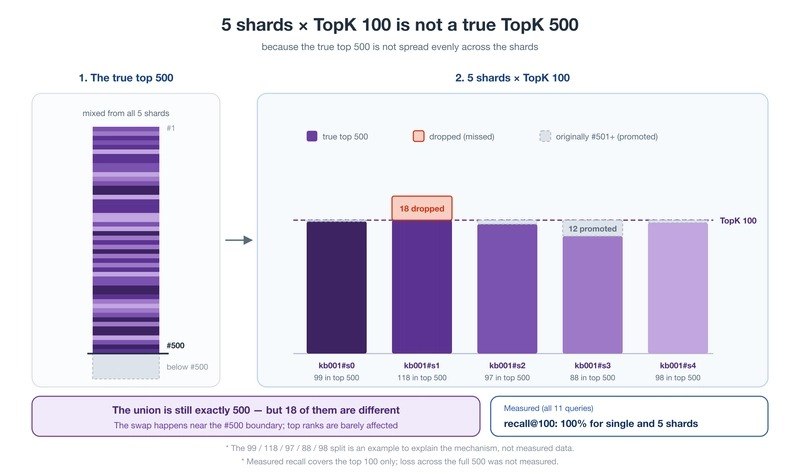
通过把分区键拆成多值(分片)并并行查询,每个分片返回 100 条,再合并排序,可实现等价于 TopK=500 的效果。

- 分片方案:使用 hash(chunk_id) % N_SHARDS 将数据均匀分配到 5 个分片。
- 查询流程:并行发起 5 次查询 → 合并去重 → 按距离排序。
- 效果:单次查询 500 条候选块,源文档数从 1 增至 10。
- 成本:单查询 112 KB,5 分片 367 KB,月 1 M 次查询成本从 0.24 USD 提升至 0.78 USD。
- 注意:分片数变更需重新导入;并行查询受调用方 CPU 限制,单线程 CPU 低时并行无效。

此方法将分区键从“限制搜索范围”转为“扩展结果数量”,为想用 DynamoDB 进行 RAG、重排且不想额外管理 S3 Vectors 的开发者提供了可行方案。
Older posts →

About this channel

How can I read @devtoolboxhub without a Telegram account?
TGViewer shows the public web preview Telegram publishes for 开发者工具箱|编程·开发工具·资源: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does 开发者工具箱|编程·开发工具·资源 have?
开发者工具箱|编程·开发工具·资源 (@devtoolboxhub) has 895 subscribers on Telegram, refreshed roughly every 30 minutes.
Does 开发者工具箱|编程·开发工具·资源 know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →