

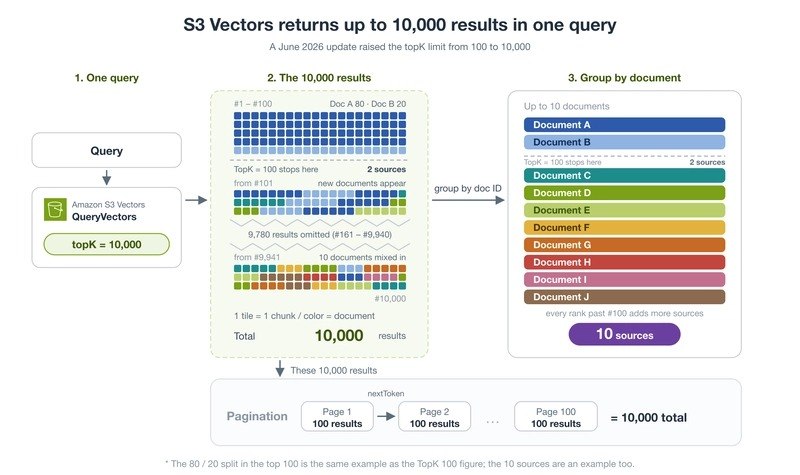


DynamoDB 在 2026 年 8 月正式支持向量数据,但单次查询最多返回 100 条结果,限制了 RAG 方案中“先广泛检索再重排”的实现。
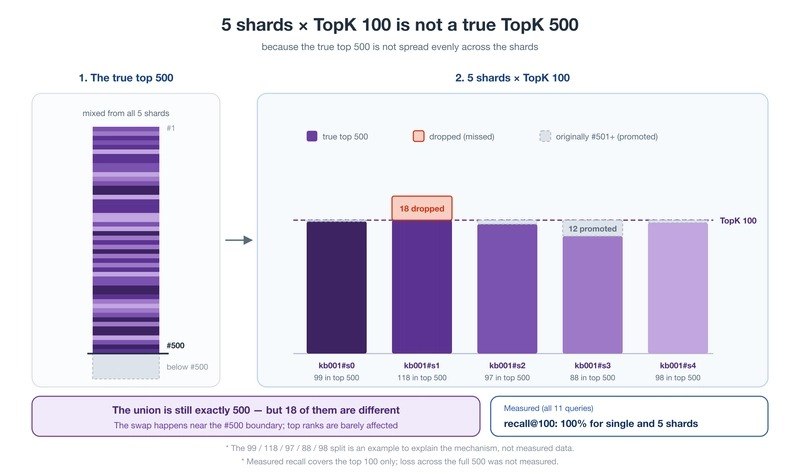
通过把分区键拆成多值(分片)并并行查询,每个分片返回 100 条,再合并排序,可实现等价于 TopK=500 的效果。
- 分片方案:使用
hash(chunk_id) % N_SHARDS 将数据均匀分配到 5 个分片。- 查询流程:并行发起 5 次查询 → 合并去重 → 按距离排序。
- 效果:单次查询 500 条候选块,源文档数从 1 增至 10。
- 成本:单查询 112 KB,5 分片 367 KB,月 1 M 次查询成本从 0.24 USD 提升至 0.78 USD。
- 注意:分片数变更需重新导入;并行查询受调用方 CPU 限制,单线程 CPU 低时并行无效。
此方法将分区键从“限制搜索范围”转为“扩展结果数量”,为想用 DynamoDB 进行 RAG、重排且不想额外管理 S3 Vectors 的开发者提供了可行方案。