Все о Data Science, машинном обучении и искусственном интеллекте: от базовой теории до cutting-edge исследований и LLM.
MAX - https://max.ru/devsp
Личный блог - @just_genych
По вопросам рекламы или разработки - @g_abashkin
РКН: https://vk.cc/cJPGXD
Post #5676
1.4K
Label Leakage: когда валидация врет, а метрики — это иллюзия
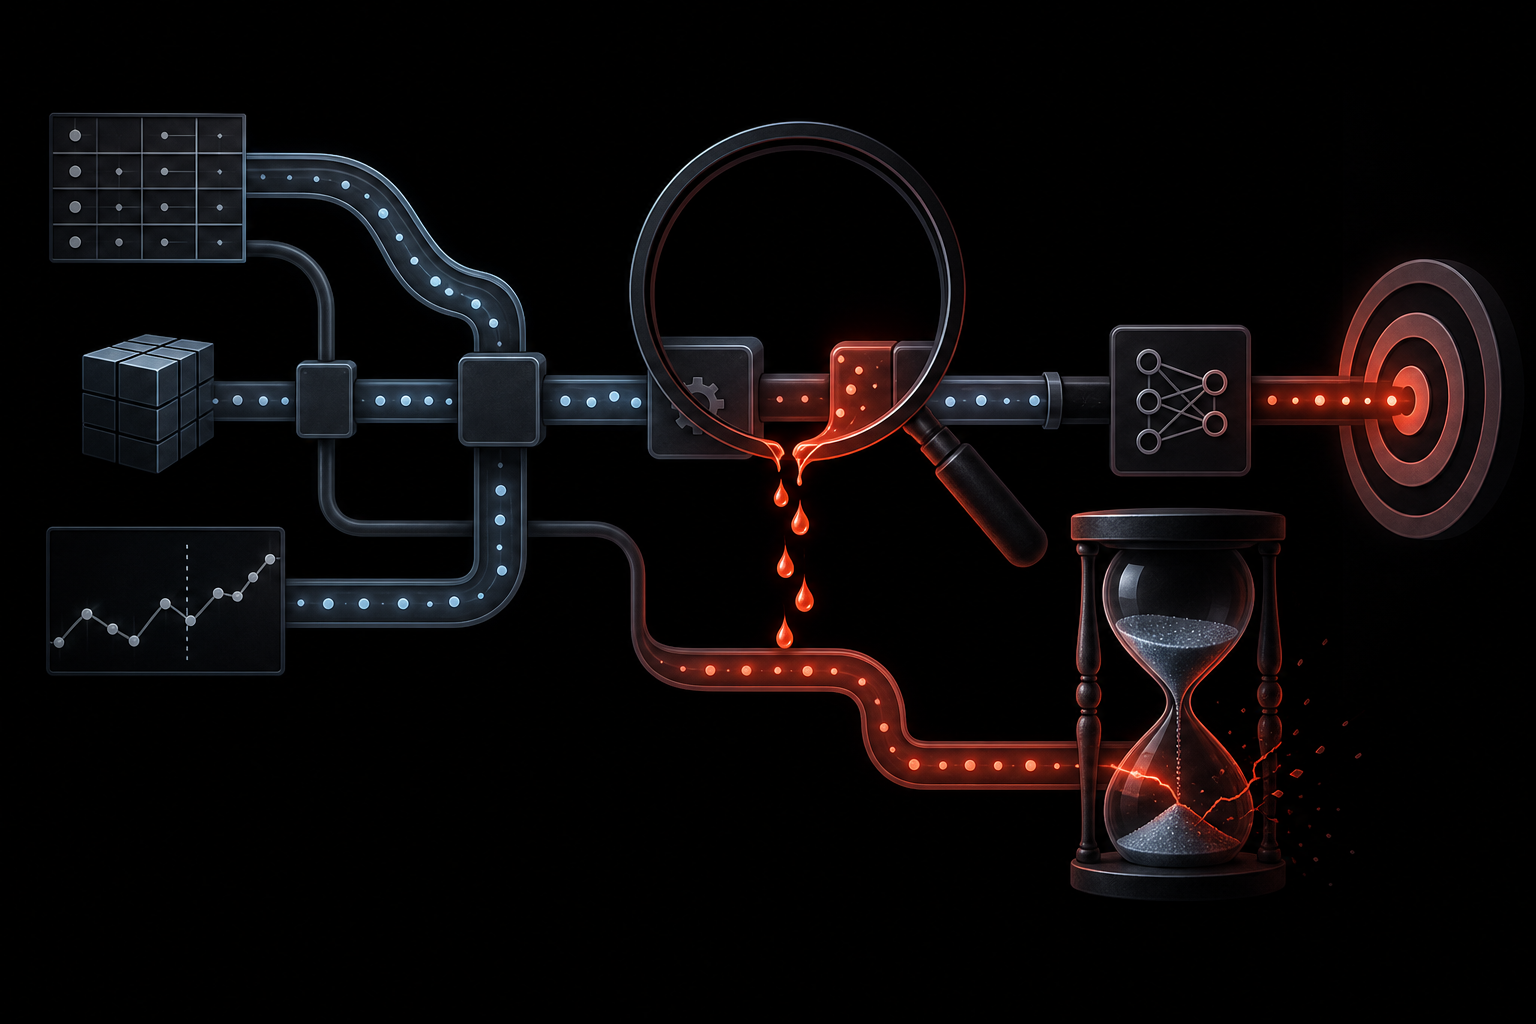
Радуешься ROC-AUC 0.99 на сложном пайплайне, а в проде модель выдает 0.6? Знакомо. Это label leakage — утечка таргета. Но часто проблема не в банальной ошибке вроде scaler.fit(X_train, y_train). Скрытые пути хитрее, и они любят засады на middle/senior уровнях.
1. Агрегаты с прицелом на будущее
Классика в feature engineering. Допустим, считаешь среднее по категории:
Если делаешь это на всем датасете до разбивки на train/val, модель на валидации видит среднее, посчитанное с учетом future-меток. Метрики взлетают, в проде — провал. Решение: агрегаты строго в рамках train-фолда через target_encoding в Pipeline или GroupKFold. И никаких transform до split.
2. Time-aware валидация: иллюзия порядка
Временные ряды без строгого разбиения по времени — утечка из-за shuffle. Модель на валидации подсматривает данные из будущего. Простое правило: никакого train_test_split с random_state. Используй TimeSeriesSplit или PurgedGroupTimeSeriesSplit. И проверяй lag-фичи — они любят заглядывать вперед. Типичная ошибка: добавление rolling-агрегатов на всем датасете, а не в рамках временного окна.
3. Фичи-строки, которые знают ответ
Бывает, поле user_flag появляется только после события (таргета). Или transaction_id коррелирует с таргетом: новые транзакции — выше риск дефолта. Удали ID-поля, проверь корреляцию с таргетом. Значение >0.95 — явный leakage. Еще один production-пример: в NLP пайплайне, когда токен документа использется как фича, но он присваивается после разметки таргета. Это ломает валидацию в LabelPropagation на stream-данных.
Как детектировать скрытые утечки
* Lasso-регрессия: если модель оставляет 1-2 фичи с огромными весами — red flag.
* Permutation importance: аномально высокое падение метрики при перестановке одной фичи.
* Lookahead bias audit: проверь, что признаки вычисляются на момент t-1, а не t. Используй reverse-engineering на отложенной выборке по времени.
Вывод: Label leakage убивает ML-продукт — лучше потратить час на аудит пайплайна с time-aware валидацией и permutation tests, чем два месяца на восстановление репутации.
Радуешься ROC-AUC 0.99 на сложном пайплайне, а в проде модель выдает 0.6? Знакомо. Это label leakage — утечка таргета. Но часто проблема не в банальной ошибке вроде scaler.fit(X_train, y_train). Скрытые пути хитрее, и они любят засады на middle/senior уровнях.
1. Агрегаты с прицелом на будущее
Классика в feature engineering. Допустим, считаешь среднее по категории:
df['avg_target_by_city'] = df.groupby('city')['target'].transform('mean')Если делаешь это на всем датасете до разбивки на train/val, модель на валидации видит среднее, посчитанное с учетом future-меток. Метрики взлетают, в проде — провал. Решение: агрегаты строго в рамках train-фолда через target_encoding в Pipeline или GroupKFold. И никаких transform до split.
2. Time-aware валидация: иллюзия порядка
Временные ряды без строгого разбиения по времени — утечка из-за shuffle. Модель на валидации подсматривает данные из будущего. Простое правило: никакого train_test_split с random_state. Используй TimeSeriesSplit или PurgedGroupTimeSeriesSplit. И проверяй lag-фичи — они любят заглядывать вперед. Типичная ошибка: добавление rolling-агрегатов на всем датасете, а не в рамках временного окна.
3. Фичи-строки, которые знают ответ
Бывает, поле user_flag появляется только после события (таргета). Или transaction_id коррелирует с таргетом: новые транзакции — выше риск дефолта. Удали ID-поля, проверь корреляцию с таргетом. Значение >0.95 — явный leakage. Еще один production-пример: в NLP пайплайне, когда токен документа использется как фича, но он присваивается после разметки таргета. Это ломает валидацию в LabelPropagation на stream-данных.
Как детектировать скрытые утечки
* Lasso-регрессия: если модель оставляет 1-2 фичи с огромными весами — red flag.
* Permutation importance: аномально высокое падение метрики при перестановке одной фичи.
* Lookahead bias audit: проверь, что признаки вычисляются на момент t-1, а не t. Используй reverse-engineering на отложенной выборке по времени.
Вывод: Label leakage убивает ML-продукт — лучше потратить час на аудит пайплайна с time-aware валидацией и permutation tests, чем два месяца на восстановление репутации.
- 🔥 3
- ❤ 1