Есть совет,
который почти все слышат в начале изучения ML:
«Всегда нормализуй данные».
Проблема в том,
что это не универсальное правило.
Иногда после scaling
модель становится не лучше, а хуже.
Особенно это удивляет людей
после перехода с учебных задач на реальные данные.
Зачем вообще нужна нормализация
Она приводит признаки к одному масштабу.
Например:
👉 возраст: 18–60
👉 зарплата: 1000–300000
Для некоторых моделей это действительно критично.
В первую очередь:
👉 Logistic Regression
👉 SVM
👉 KNN
👉 нейросети
Они чувствительны к масштабу признаков.
Без scaling:
👉 обучение может быть нестабильным
👉 градиенты становятся странными
👉 одна фича начинает доминировать над другими
Но дальше начинается самое интересное
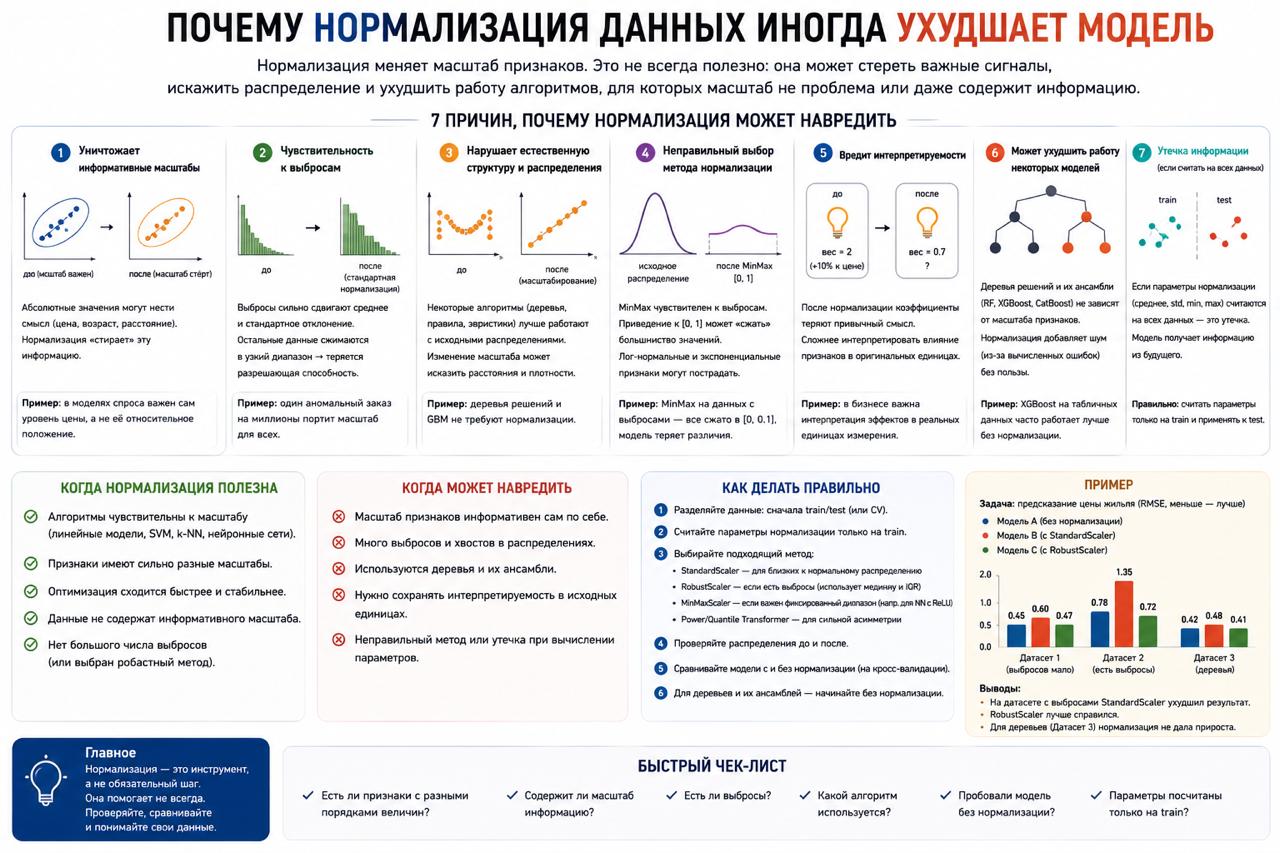
Для деревьев scaling обычно почти бесполезен.
👉 Random Forest
👉 XGBoost
👉 LightGBM
👉 CatBoost
работают через split’ы:
feature < threshold
Им не особо важно:
👉 0.5 это
👉 5000
👉 или 500000
Структура дерева от этого почти не меняется.
И поэтому люди иногда строят огромный preprocessing pipeline,
который вообще ничего не улучшает.
Иногда scaling реально портит модель
Особенно если:
👉 много выбросов
👉 странные распределения
👉 heavy tails
👉 шумные данные
После StandardScaler часть фич
может стать менее информативной.
Автоматический scaling — частая ловушка
Многие делают scaling,
даже не задавая вопрос:
«А моей модели это вообще нужно?»
Просто потому что:
👉 «так принято»
Хотя на практике:
👉 CatBoost отлично работает на сырых данных
👉 табличные бустинги сами справляются с масштабами
👉 лишняя обработка только усложняет pipeline
Отдельная классика — leakage через scaling
Когда человек:
👉 нормализует весь датасет
👉 потом делает train/test split
И модель уже косвенно «видела» test.
Метрики после такого обычно очень красивые.
До первого прода.
Главная мысль
Одна из главных проблем в ML —
привычка применять техники автоматически.
Scaling — это не улучшение данных само по себе.
Это инструмент под конкретный алгоритм.