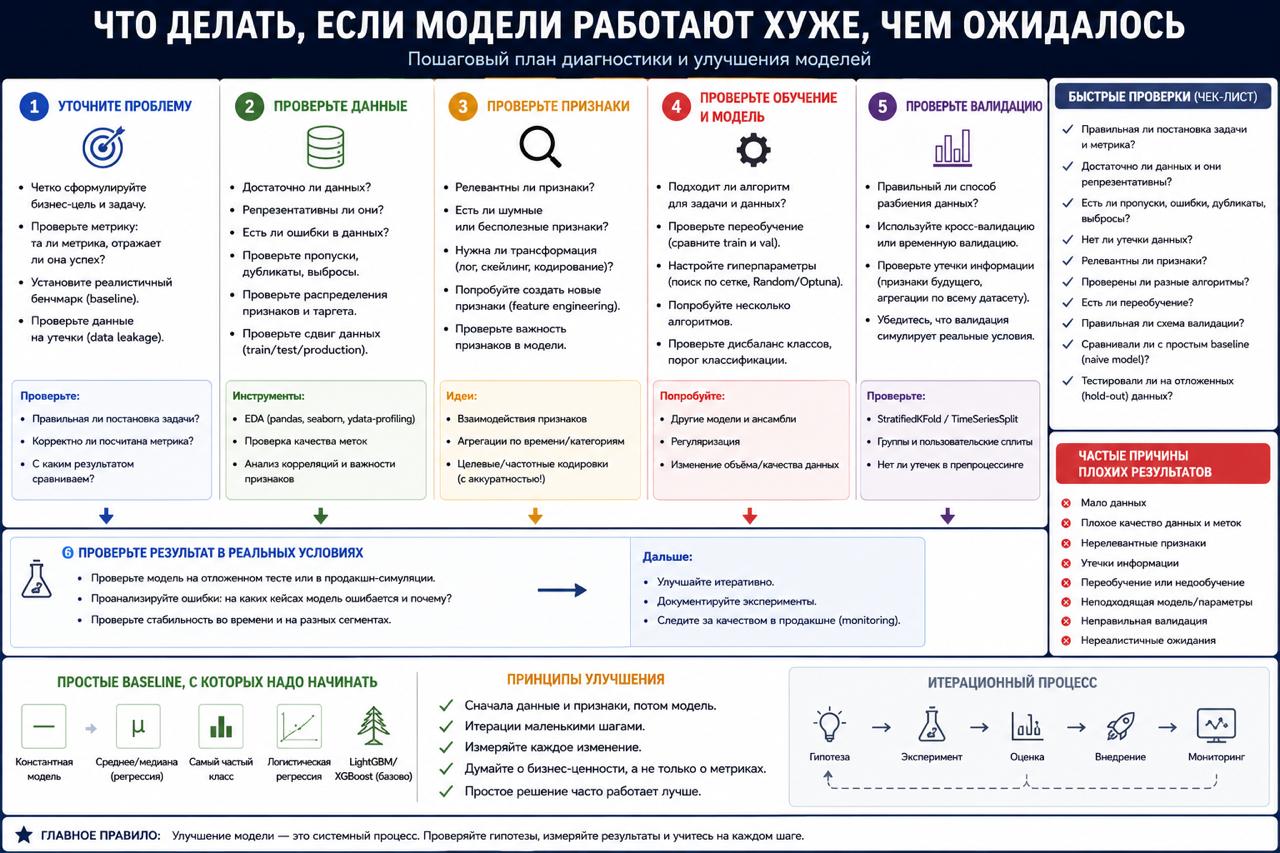
Почти у всех в ML есть этот момент.
Ты:
👉 почистил данные
👉 обучил модель
👉 потратил кучу времени
👉 посмотрел метрики…
И качество оказалось намного хуже,
чем ты ожидал.
Первая мысль обычно:
«Нужна модель посложнее».
По опыту,
это ошибка процентов в 80 случаев.
Чаще проблема вообще не в модели.
Первое, что стоит проверить — данные
Очень часто оказывается, что:
👉 target шумный
👉 классы плохо разделяются
👉 половина фич бесполезна
👉 в данных мало сигнала
Некоторые задачи в принципе плохо предсказываются.
И это нормально.
Есть ощущение,
что многие ждут от ML магии:
«Если модель умная —
она всё найдёт сама».
Не найдёт.
Если в данных нет устойчивой закономерности,
XGBoost её не создаст.
Вторая проблема — leakage или плохой split
Особенно в табличных данных.
Иногда offline всё красиво:
👉 ROC-AUC = 0.95
👉 accuracy почти идеальная
А потом модель разваливается на новых данных.
И наоборот тоже бывает:
Метрики низкие,
потому что split слишком жёсткий и реалистичный.
Ещё одна частая история — неправильная метрика
Например:
👉 оптимизируют accuracy при сильном дисбалансе
👉 смотрят ROC-AUC там, где важен precision
👉 радуются хорошему loss, который ничего не значит для бизнеса
Модель может быть «математически хорошей»
и бесполезной одновременно.
Baseline почти всегда недооценивают
Иногда:
👉 логистическая регрессия
👉 среднее по группе
👉 простое правило руками
дают результат близкий к сложной модели.
И это не провал.
Наоборот.
Это хороший сигнал,
что задача либо почти линейная,
либо данных мало.
Есть ещё неприятная вещь
Некоторые задачи просто не стоят ML.
Серьёзно.
Бывает, что:
👉 данных недостаточно
👉 поддержка модели дороже выгоды
👉 бизнес-эффект минимальный
Но многие продолжают:
👉 тюнить learning rate
👉 менять архитектуры
👉 гонять AutoML
👉 перебирать 40 моделей
Потому что «мы же делаем AI».
Хотя даже нормально не посмотрели:
👉 распределения
👉 ошибки модели
👉 качество target’а
А именно там обычно и лежит ответ.