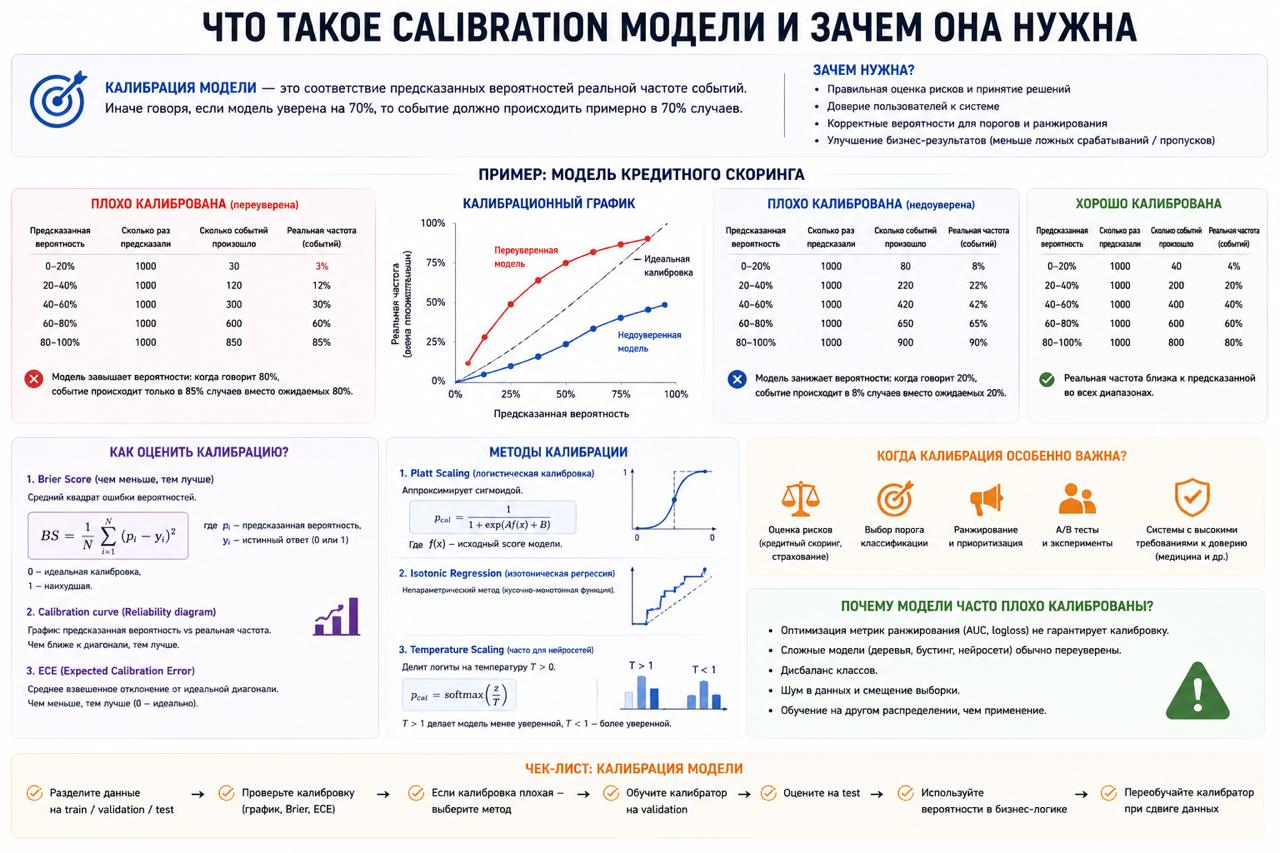
Многие смотрят на модель
только через:
👉 accuracy
👉 F1
👉 ROC-AUC
Но есть проблема.
Даже модель с хорошими метриками
может очень плохо оценивать вероятности.
И иногда это критичнее самой классификации.
Интуитивный пример
Представь две модели.
Обе предсказывают одинаково хорошо.
Но первая говорит:
👉 «вероятность дефолта 95%»
и оказывается права только в половине случаев.
А вторая:
👉 «вероятность дефолта 95%»
и реально попадает примерно в 95 случаях из 100.
Вторая модель calibrated.
Первая — нет.
Что вообще означает calibration
Calibration отвечает на простой вопрос:
«Можно ли доверять вероятностям модели?»
Если модель говорит:
👉 0.8 probability
то примерно в 80% таких случаев
событие действительно должно происходить.
Почему это важно
Особенно там,
где решение зависит именно от вероятности.
Например:
👉 кредитный скоринг
👉 медицина
👉 fraud detection
👉 ranking
👉 ad systems
Бизнес часто работает не с классом,
а с risk score.
Какие модели calibrated хуже
Некоторые модели
по природе оценивают вероятности хуже других.
Например:
👉 Logistic Regression обычно калибрована неплохо
👉 Gradient Boosting часто слишком overconfident
👉 deep learning любит завышенную уверенность
Почему ROC-AUC тут не спасает
Очень частая история:
👉 ROC-AUC отличный
👉 а вероятности мусорные
Почему?
ROC-AUC оценивает ranking,
а не качество probability estimates.
Модель может:
👉 идеально ранжировать объекты
👉 и ужасно оценивать сами вероятности
одновременно.
Как проверяют calibration
Обычно используют:
👉 calibration curve
👉 reliability diagram
👉 Brier score
Если calibration плохой,
применяют:
👉 Platt Scaling
👉 Isotonic Regression
👉 temperature scaling для нейросетей
Почему это недооценивают
На Kaggle calibration почти никого не волнует.
Там главное — leaderboard.
Но в реальном проде вероятность:
👉 0.97
👉 0.12
👉 0.83
часто становится бизнес-решением.
Например:
👉 выдать кредит
👉 заблокировать транзакцию
👉 отправить на ручную проверку
Главная мысль
В какой-то момент оказывается,
что качество вероятностей
важнее красивого ROC-AUC.