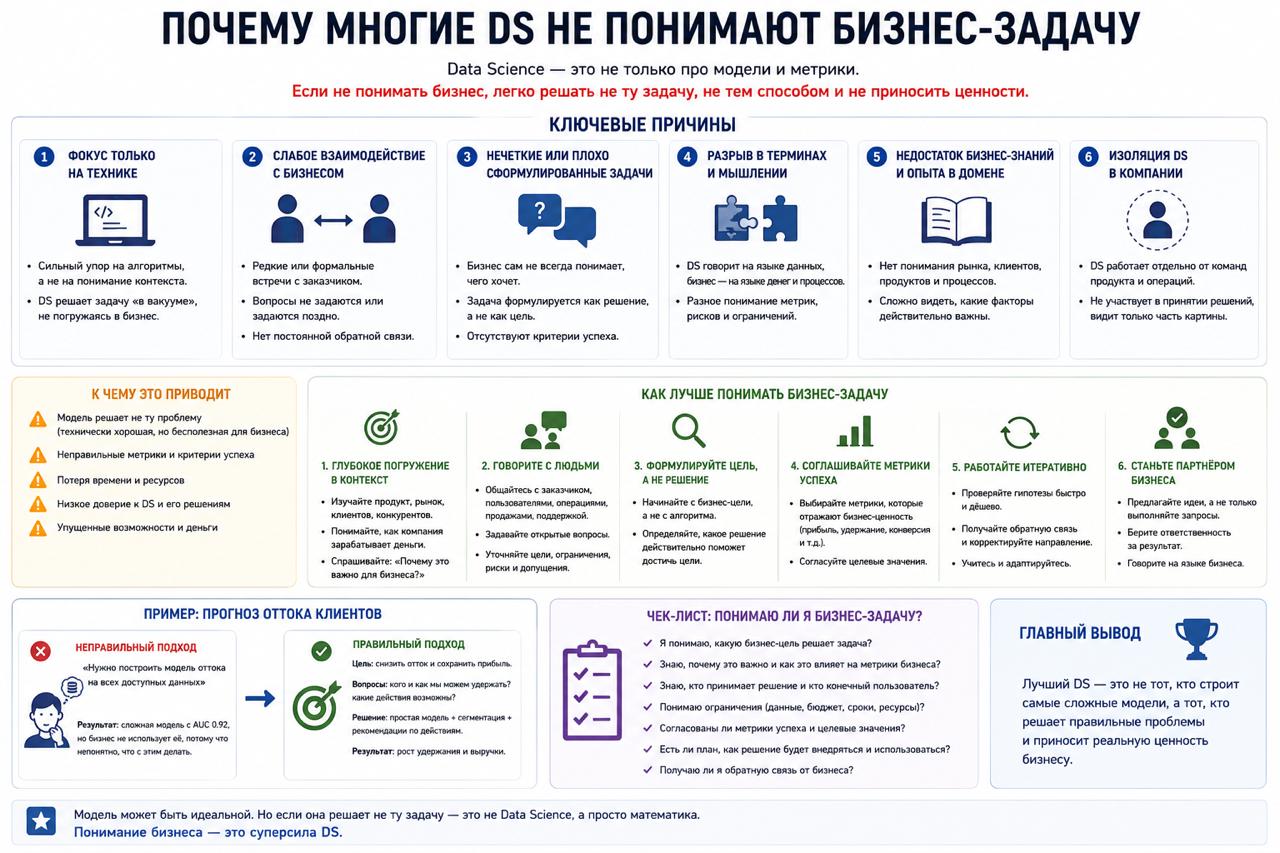
Одна из самых частых проблем в Data Science
вообще не связана с моделями.
Многие DS отлично знают:
👉 метрики
👉 архитектуры
👉 feature engineering
👉 Python
👉 математику
Но при этом плохо понимают,
зачем бизнесу нужна модель.
И это потом очень заметно в работе.
Когда ML уходит в вакуум
Например,
человек может месяцами улучшать ROC-AUC:
👉 с 0.91 до 0.93
Хотя для бизнеса разницы почти нет.
Или строить сложную систему там,
где хватило бы пары SQL-правил.
И наоборот:
👉 модель с «неидеальными» метриками
👉 может приносить много денег
потому что хорошо встроена в процесс.
Откуда начинается проблема
Большинство курсов учат:
👉 обучать модели
👉 подбирать гиперпараметры
👉 улучшать benchmark
Но почти не учат задавать вопросы:
👉 что именно пытается оптимизировать бизнес?
👉 сколько стоит ошибка?
👉 как модель будут использовать?
👉 кто принимает решения на основе предсказаний?
Хотя это важнее половины ML-стека.
Метрика ≠ цель бизнеса
Многие воспринимают задачу как:
«Получить максимальную метрику».
Хотя в реальности задача обычно звучит иначе:
👉 уменьшить churn
👉 снизить потери
👉 ускорить процесс
👉 сократить ручную работу
И иногда лучший ML-проект —
это вообще не ML.
Прод быстро возвращает в реальность
Бизнесу всё равно:
👉 какой у тебя encoder
👉 сколько слоёв
👉 какой learning rate
Его интересует:
👉 работает ли система
👉 экономит ли деньги
👉 не ломается ли каждую неделю
Частая ошибка
Люди начинают:
👉 с модели
👉 обсуждают архитектуру
👉 спорят про CatBoost vs XGBoost
Ещё до того,
как нормально поняли саму задачу.
Хотя хороший DS обычно сначала пытается понять:
👉 откуда берутся данные
👉 как принимаются решения
👉 где появляется ценность
И только потом думает про модель.
Главная мысль
Сильные специалисты часто отличаются
не тем, что знают больше алгоритмов.
А тем,
что умеют связывать:
👉 данные
👉 продукт
👉 ограничения
👉 деньги
👉 реальный процесс
Без этого ML очень быстро превращается
в дорогую игрушку.