TGViewer
Channel Public Channel
Делай RAG

Делай RAG

@delay_rag

https://delay-rag.ru/

Канал об исследованиях неочевидных способов применения ИИ в работе юриста: RAG-системы, вайбкодинг, внедрение.

Связаться с автором через сообщения канала или yakunenko.ekaterina@gmail.com
Subscribers
1.41K
Photos
47
Videos
0
Links
87

Showing posts older than #57 · Back to latest

Older Posts 19 shown
Post #56 1.63K
Готовлюсь в рамках курса Мурата Мазукова поделиться своим опытом вайб-кодинга, а также пережив (это наиболее подходящее слово, да) недавно создание еще одного секретного MVP, стала особенно восприимчива к этой теме. А еще и в последнее время многие мои коллеги-юристы и добрые друзья канала вывели в свет или напомнили о существовании своих замечательных навайбкоженных проектов, и мне очень захотелось о них здесь рассказать и, может быть, вдохновить кого-то из читателей на маленький подвиг. Может, вдохновлю настолько, что сложится целая традиция!

Сегодня тогда будет пост о том, как юристы сделали что-то очень классное не-юридическое или около-юридическое.

🏭 Александр, активный участник чата Нейросети | ilovedocs, активно поддерживающий и меня в моих ресерчах здесь на канале, сделал залипательную мини-игрушку, симулирующую управление ТЭЦ — ТЭЦ на триллион (актуалочка с невнятной московской погодой).
Я очень люблю вот такие системки, в которых есть разные балансирующие друг друга переменные, где нужно и глобальную стратегию держать в уме, и заниматься микроменджментом. Одна из моих любимых игр — Fallout Shelter, а примерно всю жизнь я every once in while играю в Sims 2. В общем, люблю тушить виртуальные пожары.
Надеюсь, у Александра получится и в магазины приложений игрушку довести, если ему захочется продолжить. И может Александр, если увидит пост, расскажет в комментах, чем вайбкодил и насколько долго!

🤑 Глеб и его товарищ Алексей, авторы канала «Технологии для юриста», сделали биллинг-бота. Отличной и гениальной в простоте идеей кажется кнопками «старт» и «стоп» фиксировать потраченное на задачу время. Телеграмом пользуются постоянно и все, привязки к компьютеру нет, и, кажется, с таким подходом забыть что-то забиллить просто нереально (особенно если закрепить бота рядом с любимым каналом с мемами).
Особенно классно, что ребята делали первые версии кода в Perplexity — я пока больше ни от кого не слышала, что кодили там, хотя почему бы и нет. Кодили, причем, в соответствии с лучшими, как я считаю, практиками предварительного планирования архитектуры (я лично сильно не сразу додумалась так делать — об этом скоро в канале, кстати, что-то будет…).
Ребята ищут тестировщиков, связаться с ними можно через канал. Канал-новостник, и мне очень по душе чувствуемая в нем системность ведения и выверенность стилистики (парни, признавайтесь, кто из вас дева по ЗЗ). Кстати, в канале, если немного покопаться в прошлых постах, даже можно найти меня 😇

🫥 Григорий, открывший в рамках курса Рунетлекс Академии мне глаза на тот факт, что юристы зачем-то могут что-то кодить, делал Тест «Lawyer / Not Lawyer». Сделан на java script и с авторской методологией, большим деревом результатов. Я с результатами конечно же согласилась, ведь тест отправил меня буквально сразу же в ильфы и четвёрки. А ещё посылала его своей приятельнице — перспективной актрисе, и тест совершенно точно понял, что ей юристом быть мягко говоря не подходит.
У Гриши тоже есть канал. А ещё у Гриши есть курс в, полагаю, тоже навайбкоженной обёртке.

В общем, мораль получается какая-то такая, что возможность кодить нейросетями очень развязывает нам руки в том, чтобы делать какие-то вещи и для души, и для дела. И начать никогда не поздно (а бросить всегда можно успеть 😏) #legalvibecode
  • ❤ 16
  • 🔥 9
  • 👍 6
Post #55 968
Заключительный пост о #делайRAG-пайплайне формирования базы знаний для бота. До этого я рассказывала о самом процессе наполнения базы, а здесь будет немного об организации и эффективности этой работы. Этот пост и все предыдущие для удобства собрала в одном длиннющем Телеграфе.

Почему воронка — это воронка
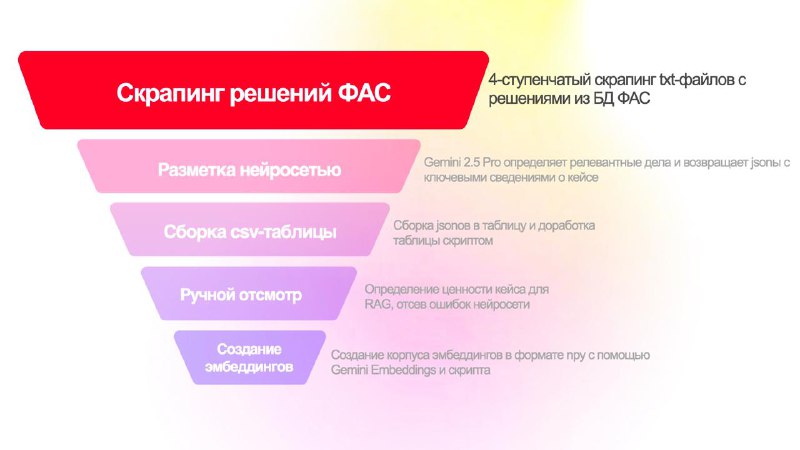
Всё просто — на каждом этапе воронки что-то отсекается: из-за особенностей ведения базы самой ФАС и моих представление о том, каким должен быть RAG для бота. На картинке анализ «потерь». Итоговая эффективность пайплайна, то есть процент ссылок, ставших знаниями в базе, 19.89%.

Технические особенности пайплайна
В пайплайне много технических фич, призванных делать его многоразовым и оптимизированным. Например, есть механизме «изоляции запусков» или сессий.
В коде есть переменная CURRENT_SESSION, и при каждом запуске скрапера этой переменной присваивается уникальный ID, который дописывается в JSON, возвращаемый нейросетью после разметки. Таблица, которую я отсматриваю, собирается с учетом этих ID, чтобы в неё не попадало то, что я уже видела.

Также есть логика кэширования, чтобы не тратить лишнее время на проходы скрапера и деньги на API-запросы. Кэширование реализовано в виде:
🤩логгера, записывающего все ссылки, по которым скрапер когда-либо ходил;
🤩 логики проверки наличия JSONа с нужным docID (если JSON есть, значит решение уже было размечено);
🤩специального кэша для корпуса эмбеддингов, чтобы перезаписывать корпус.
Всё это работает и на отказоустойчивость — если падает соединение с Интернетом или какие-то проблемы на стороне Gemini API. Также из кэширования вырастает логика прогона скрапера по тем ссылкам, на которых он был раньше, но не нашёл решения — вдруг решение появилось, и его можно скачать и далее отправить на разметку. 

Да как вообще этот пайплайн выглядит, это какая-то программа?
Это ноутбук (файл в формате .ipynb) в среде Jupyter Lab. Это не совсем IDE (Integrated Development Environment типа VS Code), в которой делаются приложения. У меня особый вайб-кодерский путь, и я использую именно ноутбуки.
В ноутбуках код поделен на ячейки, и выполняя каждую ячейку, ты сразу видишь результат ее работы в виде отчётов о выполнении.
Ноутбук в варианте последнего прогона ячеек можно послать кому-то, кто откроет его в своём Юпитере и увидит все те же отчёты (или прямо в нейросети, почти все читают .ipynb). Ноутбуки подходят для анализа данных, если вам не нужен непременно какой-то интерфейс. И, как мне кажется, формат хорошо подходит для пайплайна — это сильно проще, чем делать программный интерфейс. Можно быть достаточно гибкой в том, чтобы быстро добавить «аварийные» или аналитические ячейки. 
Но! Нюанс использования ноутбука в том, что надо хорошо понимать, какие ячейки с какими у тебя связаны — если не запустишь ячейку с импортами библиотек или активацией API-ключа, то другая нужная ячейка не заработает. А если Юпитер вылетел посреди скрапинга, то вылетает и вся история с сессиями, потому что переменная CURRENT_SESSION живет только в памяти. Чем больше ячеек — тем более тормозной ноутбук. И всё в таком духе. 
Если есть идеи, как можно реализовать пайплайн в более удобном виде — просветите, пожалуйста.

Что еще можно было бы исправить и добавить?
За несколько месяцев работы по наполнению базы несколько раз менялись параметры разметки и скриптованных добавлений в JSONы, которые возвращает нейросеть. Пару раз менялся промпт для разметки. И, собирая датасет, я споткнулась на том, что JSONы получились неоднородные, и их нужно было дополнительно унифицировать.
То есть для текущей версии пайплайна напрашивается какой-то механизм версионирования промпта. И вообще, кажется, нужно ветвить пайплайн на работу ещё и с датасетом, ведь его тоже нужно будет пополнять и дальше.
 
На этом всё! Спасибо всем, кто читал об этой моей работе. Для меня она оказалась одной из самых интересных в рамках всего проекта. И пусть процесс и неидеален, опыт получился совершенно бесценный.
  • ❤ 9
  • 🔥 7
Post #54
Делай RAG pinned «🤩🤩🤩🤩 Навигация 🤩🤩🤩🤩 Всем привет! Сейчас, к моему большому сожалению, у меня очень мало времени на более содержательные публикации, но я вижу, как на канал приходят новые подписчики. Я очень всем рада! 🥺 В канале несколько основных треков, и вот небольшая…»
Post #53 1.42K
🤩🤩🤩🤩 Навигация 🤩🤩🤩🤩

Всем привет! Сейчас, к моему большому сожалению, у меня очень мало времени на более содержательные публикации, но я вижу, как на канал приходят новые подписчики. Я очень всем рада! 🥺 В канале несколько основных треков, и вот небольшая карта по ним:

🤩 Если вы не знаете досконально, что такое RAG, так решительно заявленный в названии канала, то у меня есть вводный материал об этой технологии: everybody talks about RAG (он же на zakon.ru)
В целом в центре моих интересов тема построения баз знаний для реализации RAG-технологий, о чем я завела рубрику #rise_of_RAG, в рамках которой написала лонгриды:
🤩 Rise of RAG: от плоских векторов к темпоральным графам (она же в более ИТ-ориентированном виде на Хабре)
🤩 Document-Level Retrieval Mismatch: ищем иголку в стоге плоских чанков
🤩 RAG в эпоху агентного ИИ: существует ли Agentic RAG? Существует ли вообще ещё RAG?

🤩 Другие мои материалы и проекты
🤩 «Как испытать от вайб-кодинга радость» — сборник советов и методов организации кодинга с нейросетями, основанный на моём опыте
🤩 #делай_bench — фасилитация human-eval бенчмарка LLM для юридических задач (а также пост на Хабре).
🤩 книга «Юристы и нейросети» в коллективе лучших авторов

🤩 Канал начался (и в общем, конечно, продолжается) как канал о Telegram-боте @lastminute_legal_bot, проверяющем рекламные креативы нейросетью с небольшой RAG-базой. В основном публикации на этом треке можно найти по следующим хэштегам:
🤩 #ботоводство — о том, как создавался бот, с какими сложностями я сталкивалась, как их (не) преодолевала, как вообще развивается бот и я вместе с ним. Публикации по этому тегу могут быть интересны тем, кто практикует т.н. вайб-кодинг или любит следить за жизнью pet-проектов
🤩 #commits — о изменениях в коде и функциональности бота
🤩 #RAG_expansion — новости о пополнении базы знаний, которой пользуется бот
🤩 #делайRAG — о процессе создания базы знаний, которой пользуется бот. Настоящий кейс, рассказанный во всех деталях, который можно использовать как мануал в своих проектах, в едином лонгриде собран здесь. В перспективе хочу ставить этот тег и для рассказов о других своих RAG-проектах

Важные ресурсе о боте:
🤩 Github проекта (можно ставить звёздочки 😀)
🤩 Лендинг проекта

🤩 Значительная аудитория канала — юристы, работающие с рекламой. Для вас здесь есть:
🤩 https://search.delay-rag.ru/ — бесплатный сервис поиска по размеченной практике ФАС
🤩 открытый датасет с 7000+ размеченных дел с практикой ФАС по рекламе за прошедшие 6 лет, ставший основой для сервиса
🤩 любимая мной рубрика #мудростьФАС — о разных курьезах из практики ФАС по рекламным делам, на которые я обратила внимание, делая RAG для бота
🤩 публикация на vc.ru о типах субстантивных нарушений, на которые ФАС обращала внимание чаще всего в 2025-м году

🤩 Также я хожу на разные мероприятия в сфере legal tech и применения нейросетей в работе юристов
🤩 #spectacle — о событиях, где выступала я сама
🤩 #keytakeaways — о событиях, которые посетила

Пост будет пополняться.
Telegraph everybody talks about RAG Я уже больше трёх месяцев время веду Telegram-канал с названием «Делай RAG», в нём есть даже целая серия постов c одноимённым хэштегом о моём непосредственном опыте создания небольшой RAG-системы для бота-проверщика рекламы. Но всё ещё не было ни одного базового…
  • 👍 11
  • 🔥 7
  • ❤ 6
Post #51 1.78K
README_Датасет_решений_ФАС_России_по_рекламным_делам.pdf439.4 KB
Большая новость! 😐 Я опубликовала датасет с размеченной практикой ФАС по рекламным делам!

Это не RAG-база для бота, это лучше! Это более 7 тысяч дел с начала 2019-го года по ноябрь 2025 вообще всех категорий, собранных в одну большую аналитическую таблицу. Подробнее о том, что это и для чего читайте в приложенном readme.

Ссылки:
🤩 HuggingFace (для скачивания отсюда может потребоваться использование сервисов на три буквы)
🤩 Zenodo

Как пользоваться этой таблицей юристам?
Пока в меру своего разумения и умения пользоваться Excel (csv-формат прочитывается именно в нем). В планах создание удобного и продвинутого поискового интерфейса, но об этом, надеюсь, будут другие новости (с предложением высказаться о своих пожеланиях к интерфейсу, возможно даже).
Но возможности датасета в виде всякой интересной аналитики, статистики и кластеризации я буду постепенно показывать — это будет новый branch в моей нежно любимой рубрике #мудростьФАС. Для затравки пока сообщу, например, что из представленных 7283 дел ФАС обнаружила факт нарушения в 98,8% случаев.

Я не знаю, найдет ли отклик в текущем виде (без поискового интерфейса) датасет у кого-то, но это было, пожалуй, одно из самых интересных занятий в связи с ботом, и я горжусь проделанной работой 😀
  • 🔥 32
  • 👍 12
Post #50 1.07K
Кто видел предыдущий пост — пардон 😊 вот правильный! Со спокойной душой можно теперь написать про последний этап пайплайна — и пока еще не разойтись, есть несколько общих идей и накопленная за прошедшие месяцы рефлексия о том, какие в воронке минусы, и как её можно менять.

Итак, последний этап #делайRAG — сборка корпуса эмбеддингов. Он делится на 2 основных сущностных шага — подготовку «чанков», то есть текстов, которые и будут превращаться в эмбеддинги, и само превращение в эмбеддинги, то есть векторизацию.

🤩 Чанки
Обычно под чанками понимаются части документов, имеющие определенную длину (в символах или токенах). Но поскольку я делала RAG для бота по наитию, я не знала, что по классике чанкуются именно тексты. Я пошла по пути изготовления (на этапе разметки) резюме решений нейросетью. И именно резюме отправляются на векторизацию (я схлопываю в один текст содержимое двух колонок из волшебной csv-таблицы, но каких именно — не скажу. Ибо близится датасет, и кто захочет повторить, то будет свободен в своих экспериментах).
Я и сейчас думаю, что, учитывая характер исходного материала, это правильный путь: УФАС в решениях пишут много не несущих никакой (для моей задачи) ценности заклинаний, повторяют одно и то же, что просто нарезка текста решения на чанки блага не сделает.
Эту операцию скрипт проделывает моментально без моего особого участия.

🤩 Эмбеддинги
Далее код пайплайна обращается по API к эмбеддинговой модели (сейчас у Gemini она одна - gemini-embedding-001), по очереди векторизует каждый чанк, и все получившиеся координаты собирает в один файл формата NumPy. Кто читал лонгрид про RAG, тот в курсе, что RAGи вполне могут быть реализованы не в виде векторной базы данных, а просто вот таким массивом чисел. Учитывая мой объем (менее 2000 решений, в перспективе не более 3000), этого более, чем достаточно.
Если возникает необходимость корпус эмбеддингов расширить, то имеющиеся векторы не пересчитываются, так как уже обработанные записываются в кэш. Полностью пересчитать пришлось один раз, когда переезжала на другую эбеддинговую модель (на ранее упомянутую, её представили месяц назад).
Я делаю эмбеддинги 768 размерности и использую float64, то есть каждое число в эмбеддинге весит 8 байт: это как бы обеспечивает более высокую точность семантического подбора. Наверное. Я верю на слово всему, что мне говорят нейронки по этому вопросу 🙂

Вот и всё! RAG.csv и корпус эмбеддингов в .npy в паре представляют собой RAG. Коротко напомню, что происходит дальше (или чем занимается код в backend_logic.py):
1️⃣ пользователь вводит в боте запрос или грузит картинку, скрипт обрабатывает текст или описывает текстом картинку;
2️⃣ полученный текст тоже становится эмбеддингом с помощью той же самой эмбеддинговой модели (корпус эмбеддингов и входящие эмбеддинги должны делаться одной и той же моделькой из-за используемых ими таблиц токенизации);
3️⃣ для эмбеддинга запроса косинусным сходством высчитываются топ-10 наиболее похожих эмбеддингов;
4️⃣ топ-10 эмбеддингов откатываются обратно в текст и вставляются в шаблон промпта для нейросети;
5️⃣ нейросеть готовит заключение с учетом того, что нашлось эмбеддинговым поиском, цитирует релевантный кейс в заключении.

И здесь уместно рассказать, что я предпринимаю для повышения точности отбора (a.k.a костыли):
🤩 предобработка креатива — при обработке входящего текста или подготовке описания выкидывается все, что может «зашумить» эмбеддинговый поиск (часы работы, номера телефонов, сайты, всевозможные идентификаторы и т.п.);
🤩 нейросети дается задача критично относиться к тому, что притащено из RAG, и если действительно релевантного кейса нет, то не обращать на них внимания.

Знаю-знаю, не очень впечатляет, и можно и лучше. Техники есть (о них скоро будет новый #rise_of_RAG). И у меня еще с самого начала появилась идея делать привязку к тематическим тегам (о них здесь), то есть этакий гибрид с фильтром по ключевым словам, который активируется не сразу, а после первого эмбеддингового отбора. Очень хочу постараться до Нового года всё таки его реализовать 🎅
  • ❤ 12
  • 🔥 6
  • 👍 4
Post #48 937
Всем привет, почувствовала urge рассказать всякие новости! ☕️ #ботоводство

🤩 Свой недавний лонгрид я вынесла на Хабр. Страшно? Очень страшно! 😵 Когда интерфейс спрашивал меня, уверена ли я, что хочу опубликовать, я была очень не уверена. Там уже две закладки кто-то поставил даже.
Не знаю, есть ли у меня подписчики с профилями на Хабре, если есть кто, и у вас завалялся плюсик — поделитесь, пожалуйста! Самый последний «базированный» лонгрид про RAG тоже планирую вынести на не менее строгую публику zakon.ru, но юристов я боюсь меньше айтишников.

🤩 Если вам было интересно, в какой момент начинают приходить спам-боты в комменты каналов — примерно с 250 подписчиков. Стабильно раз в день удаляю из комментов предложение подзаработать. С глубокомысленными мыслями, что кто-то на моём блоге может заработать, но это не я.

🤩 Количество уникальных пользователей бота стало как-то быстро расти, близимся к уверенным двум сотням. Меня всегда забавляло, что на канале подписчиков намного больше, чем пользователей у продукта, которому канал посвящен. Но, кажется, скоро сравняемся!

🤩 Я в стадии максимальной готовности выкладывания в open-source датасета с размеченной практикой ФАС, а потом еще и кое-какие новости в связи с этим воспоследуют. И в стадии абсолютной неготовности миграции на актуальную genai библиотеку, это новое поле прокрастинации.

🤩 Google сделала инструмент для быстрого и весёлого создания RAGов File Search. Новость хорошая, не угнетающая. Наверное. Не решила пока. Поизучала документацию, вот мои выводы по ней:
⁃ обещают автоматический чанкинг просто по загруженным документам. Технику чанкинга не раскрывают, но дают возможность самим указывать количество токенов на чанк и оверлэп (это сколько токенов могут пересекаться в соседних чанках). Более тонкой настройки нет.
⁃ ваш оригинальный файл, загруженный в этот инструмент, удаляется через 48 часов. дальше хранятся только эмбеддинги в т.н. пространстве file search store — видимо, это такая как бы векторная БД. вот они уже хранятся бесконечно долго в связке с вашим проектом на google cloud. Параметры хранения следующие (довольно щедро и бесплатно):
• Количество хранилищ (stores) на проект: 100
• Максимальный размер одного хранилища: 10 ГБ
• Максимальное количество файлов в одном хранилище: 1 000 000
• Максимальный размер одного файла: 512 МБ
• Количество файлов в одном запросе на загрузку: 100
⁃ хранятся еще и метаданные, обеспечивающие цитирование и более высокую точность поиска. Метаданные можно делать как для всего файла (но это делается однократно при загрузке), так и для чанков (для этого надо заранее готовить jsonы с метками). С помощью метаданных может быть реализован SAC-метод, о котором писала недавно.

В общем очень здорово, очень круто, и главное, что есть на чём попробовать, что-нибудь еще про это напишу. Счастлива наконец написать пост, который влазит в лимиты одного поста 👍
  • 👍 13
  • ❤ 10
  • 🔥 5
  • 👏 1
Post #47 1.24K
Только я села писать предпоследний пост о моём RAG-пайплайне #делайRAG, а именно о создании корпуса эмбеддингов, как подумала: технически это самый простой этап, хоть за ним и стоит вся магия, и писать там в сущности нечего. Точнее с одной стороны нечего, с другой стороны даже это «нечего» проще всего вообще _не_ понять. И разве это не хороший хороший повод наконец уже рассказать подробнее о RAG как о технологии? Должен же в канале с соответствующим названием хотя бы на четвертый месяц появиться пост о том, да кто такой этот ваш RAG?

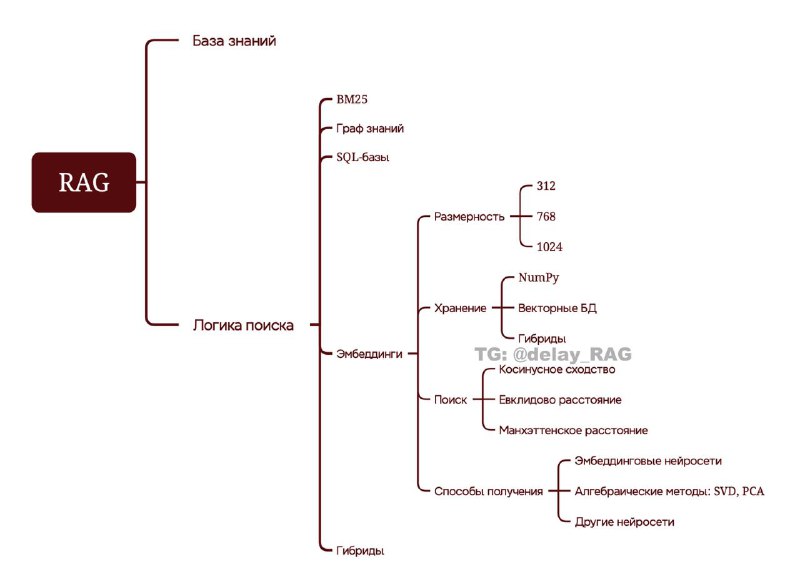
Рассудила я так, и начала писать всё, что знаю, будучи уверенной, что получится коротко, быстро, ещё и про ботовский корпус эмбеддингов останется рассказать. Но что-то пошло не так, поэтому держите новый телеграф: everybody talks about RAG ✌️
В нем схемы всякие, майндмап вот есть. Собственно все написанные на майндмапе слова в колонке и обсуждаются. Она действительно базированная: там информация для совсем новичков или для тех, кто в целом понимает суть технологии, но сильно глубоко в детали не погружался. Я старалась писать понятно без сложной математики (потому что я всё равно сама математику не понимаю), но не могу сказать, что текст получился прям совсем разжёванным, некоторое интеллектуальное напряжение можно и испытать (совсем простой вариант в КАРТОЧКАХ хочу тоже сделать). Зато после этого текста точно будет понятно всё и про пайплайн, и про предыдущие лонгриды, которые #rise_of_RAG, да и вообще многое в устройстве вселенной и нашем месте в ней.

Я знаю, что и на русском языке материалов по этой теме хватает, но мне хотелось написать что-то адаптированное для юристов, да и собственные познания в одном месте сложить (говоря по правде, для этого текста я выясняла некоторые вещи для себя впервые, например, как всё-таки эмбеддинговые модели делают эмбеддинги, и каким таким колдунством при векторизации сохраняется смысл).
Поэтому, коллеги, надеюсь, что это будет полезно — шерьте с другими интересующимися, отвлекайтесь от дел в короткую рабочую неделю, задавайте вопросы, на эту тему я всегда рада поболтать ☕️
  • 🔥 14
  • ❤ 10
  • 👏 2
Post #46 760
Я запустила бот 29 июля, то есть ему уже три месяца. Квартал! 🥺
Напрашивается подведение каких-то итогов, и, кажется, эта фотография очень красноречиво показывает проделанный путь.

Думала ли я, устанавливая на компьютер python в июне, что это приведет меня в переговорку под названием python в офисе HeadHunter? Обсуждали с Юрием Донниковым и его коллегами, как бот может быть полезен их работе с рекламой. Мне очень ценно, что в моём проекте-малыше видят потенциал и пользу такие сильные юридические команды.
Думала ли я, что выбрав самую понятную для себя точку входа в создание RAG-систем, попаду в какую-то востребованную нишу, в которой пытаются что-то делать и ИТ-гиганты, и независимые DIYщики, и крупные корпорации? Мысли были кардинально другими :)

Обновляла лендинг проекта впервые с создания 23 сентября. Даже уже за месяц многое изменилось и в метриках, и в функционале, идей по развитию стало еще больше.
Поэтому кажется, что три месяца — уже довольно приличный срок, в котором можно выступить с «тостом» 🥂 Хочу сказать спасибо большое всем пользователям, подписчикам, всем, кто поддержал на старте, рассказывал о боте, всем, кто видит перспективу и хочет работать вместе. 🌟🫂
Радуюсь, но не расслабляюсь, работы еще много!

#ботоводство
  • 🔥 29
  • 👍 12
  • ❤ 9
Post #45 721
Новая неделя, новый обзор новой статьи в рамках нового цикла #rise_of_RAG!
Хоть некоторые уже и похоронили RAG, убитый агентами, моё внутреннее убеждение не позволяет с этим соглашаться и сходить с этого направления ресерча, только на него встав. Поэтому предлагаю вам к чтению за обедом колонку с интригующим названием «Document-Level Retrieval Mismatch: ищем иголку в стоге плоских чанков».

Разбираемся, так ли мёртв плоский RAG применительно к юридическим задачам, попутно раскладывая в голове, что такое precision и recall, а также причем тут le sac в зубах у ретривера. Помимо пересказа статьи произвела также собственное интеллектуальное усилие, направленное на дальнейшую сборку методологии создания RAG-систем, проанализировав, при каких обстоятельствах и для каких задач придуманный авторами метод улучшения плоских RAGов может хорошо сработать.

Буду рада вашим комментариям и идеям, в том числе и скепсису и подсказкам: вдруг кто-то уже это давно умеет-практикует и сам додумался! ☕️
  • 🔥 10
  • ❤ 3
Post #44 554
Давно не было #commits. Только я начала заниматься наиболее приятными для меня делами, как вайб-кодинг с ноги ворвался обратно в мои будни (и выходные) 🤪 Я думала, что этот пост буду постить во вторник, но… впрочем, начну с приятного:

🤩 Ещё немного больше user-friendliness
Не все закоулки пользовательского пути оказались качественно освоенными! Теперь бот проверяет размер загруженного файла (раньше не проверял 😊 и можно теперь 20 МБ лить), и если файл слишком большой, а также если формат неверный, то пользователь получает единое сообщение с кнопочкой, позволяющей попробовать ещё раз. Также в мои админские сообщения об ошибках пользователей теперь добавляется @юзернейм, чтобы я могла оперативно связаться с потерпевшим.
Мелочи, а приятно, и накодилось это всё тоже с полпинка — с первых промптов, на тесте ничего не упало, сразу запушила, в общей сложности минут за 40 этой ночью. Вот всегда бы так!

🤩 Аналитика логов
Я писала недавно, что работа с логами вызывает у меня приступы прокрастинации, но я собралась с духом и в общем-то с первого раза накодился код аж целого нового файла на Гитхабеaggregator.py. Он парсит все логи, делает из них большую csv-таблицу, а также генрит мне красивые ежедевные отчеты о пользовательской активности в админку (пример см. в комментариях).
Код написался-то с первого раза, но не с первого раза удалось сделать так, чтобы вся эта красота действительно работала каждый день в 20:00 по Московскому времени, поэтому этот файл успел обрасти уже собственным подробным логированием, а также логикой повтора попыток отправить отчёт в Telegram. Не хочется вдаваться в скучные подробности, но теперь я знаю, что такое cron job, daemon, что именно делает команда print в коде.
Сохраняется интрига, придёт ли сегодня отчёт в 20:00. Ибо имеет место загадка дыры: отчёт не пришёл в четверг, когда эти изменения были впервые задеплоены (при этом создалась таблица), но пришёл вчера без какого-либо оконченного вмешательства с моей стороны (а ещё пытался отправиться около 17 часов) 🙂
Следующий шаг — аналитика всей этой таблицы, нужно будет трогать палкой синтаксис pandas и разворачивать специальный ноутбук в Jupyter Lab, чтобы по-разному эту табличку крутить. Всё про вас узнаю, наконец!
А из отчётов, кстати, видно, что образовался костяк регулярных пользователей при в общем-то небольшом притоке новых. Очень приятно, коллеги, что вы находите инструмент полезным! 🥺

Ну и новости (придумала название рубрике — #ботоводство)!
На этой неделе стала получать загадочную ошибку «Missing required parameter "ragStoreName"». Диагностика показала, что мой бэкэнд написан на библиотеке google-generativeai, которую перестали поддерживать ещё аж с 31 августа, и по-хорошему нужно переезжать на новую библиотеку google-genai. В некоторых моментах у них принципиально отличается логика обработки API-запросов в Gemini, и вот местами (не каждый раз, но уже с неприятной регулярностью) оно подтравливает и ломается.
Я уже пробовала подступаться к этому делу, и пока миграция не очень получается((( за следующую неделю постараюсь дожать, но в целом не удивляйтесь и отнеситесь, пожалуйста, с пониманием, если будут возникать проблемы. Например, в четверг поломалась именно с этой ошибкой обработка pdf-файлов, а вчера в ночи pdf-ку спокойно отработал. Почему так — не знаю и не чувствую сил погружаться прям сильно подробно, но ценный урок извлекла: таких глубоких привязок к библиотекам, специфическим для конкретной LLM-ки нужно как-то пытаться избегать.

Мытарства этой недели и очевидность мучений недели грядущей позволяют мне решительно посмотреть сегодня 2-3-4 серии Отчаянных домохозяек. И вам тоже хороших выходных! ☕️
  • 🔥 5
  • ❤ 4
  • 👍 3
  • 👏 1
Post #42 511
Сегодня была на очень классной конференции HeadHunter по рекламе: все узнаваемые лица рекламного права, самые животрепещущие темы — и базовая база, и насущное, отличные спикеры. С первого же выступления пленарной сессии представителя УФАС по республике Башкортостан Рината Хасанова пошла дискуссионная энергия с подачи столпа российского рекламного права Дмитрия Григорьева. Как мне кажется, компетентная дискуссия, тем более с регулятором, — это ни что иное, как успех мероприятия.

Еще мне было особенно приятно услышать от профильных коллег, что о боте знают, он на слуху, им пользуются 🥺 Получилось вынести с конференции #keytakeaways применительно к боту — нужно обязательно перепроверить, как он будет решать задачки в свете законодательных изменений (энергетики, например), и, возможно, раговать сам закон в актуальной редакции, и редакцию эту поддерживать. Так сказать, practice what you preach в плане качественных RAG-систем.

В свете всего этого есть ощущение, что я задолжала с рубрикой #мудростьФАС. Я не могла не посмотреть, что в моей базе есть от УФАС Башкирии: целых 33 кейса, и несколько примечательных дел по использованию ч. 5 ст. 7 Закона О рекламе, запрещающей умолчания о существенных обстоятельствах. Как я писала в своей не особо популярной, но, как мне кажется, весьма дельной колонке на VC, эта статья — это козырь в рукаве ФАС, который позволяет привлекать к ответственности за манипулятивную рекламу в отсутствие прямых законодательных запретов. Часто она используется для формирования практики, которая потом становится законом, как это произошло с рекламой юридических услуг по банкротству физических лиц. И вот где УФАС Башкирии увидело возможность прикрыть шальную рекламу этой статьёй:

🤩 лечение алкоголизма в одном ряду с услугами о гаданиях и приворотах. В газете «Мир вакансий» была размещена реклама с текстом «Гадания. Привороты. Снятие порчи. Лечение алкогольной зависимости», а рекламодательница пояснила, что все эти вещи она реализует с помощью карт Таро, а не предлагает медицинские услуги, как кто-то мог бы подумать. Реклама была признана ненадлежащей по причине (прямая цитата):
«В данном случае осуществление услуг приворот, порча, снятие алкогольной зависимости на гадальных картах ТАРО может привести к формированию у граждан неверного представления о существе оказываемых услуг.»


🤩 Не обошлось и без других способов подлечить население:
«СОЛЯНАЯ ПЕЩЕРА. SPELEON. ВДОХНИ ЗДОРОВЬЕ ВСЕЙ СЕМЬЕЙ! Повышает иммунитет. Способствует профилактике частых простуд, гриппа, ЛОР заболеваний, заболеваний органов дыхания. Оказывает благоприятное воздействие при аллергии и астме. Очищает и омолаживает кожу. Снимает стресс и переутомление. Способствует улучшению сна. Очищает легки от табачного дыма.»

Признавайтесь, кто бывал в таких? Я бывала, мне там бабулиты советовали в телефоне не сидеть. Но УФАС Башкирии, хоть и не пишет об этом прямо, видимо, на стороне докмеда, потому что Комиссия отметила, что в рекламе содержится информация, ничем не подтвержденная и вводящая потребителей в заблуждение, так как доказательства положительного действия используемого при оказании услуг аппарата представлены не были.

🤩 И напоследок о финансовом здоровье — рекламировали «торгового робота», то есть программу «которая может использоваться для предоставления индивидуальных инвестиционных рекомендаций», а такие программы должны иметь аккредитацию ЦБ. Раз информации об аккредитации в рекламе не было, то и ч. 7 ст. 5 нарушилась. Конкретный текст рекламы не приводится, и сложно судить — действительно ли просто увидели формальное нарушение, или использовали его как удобный аргумент, чтобы предотвратить использование гражданами какой-то скамной истории. Возрадуемся, что такие боты, как мой, не требуют ничьей аккредитации! ☕️

Закруглю пост тем, что конференция была просто прекрасно организована в очень красивой локации, спасибо большое Юрию Донникову и его команде за такое полезное мероприятие. А еще сегодня день работника рекламной индустрии, не знаю, планировали ли организаторы, или так удачно совпало. Если совпало, то знак просто отличный!
  • 👍 9
  • ❤ 6
  • 🔥 5
Post #41
Делай RAG pinned «Новый цикл общеобразовательно-рисерческих постов на канале под гордым названием #rise_of_RAG я начну с неожиданного вопроса: что вы знаете о Бразилии? Что бы вы о Бразилии ни знали ранее, сегодня вы узнаете, что в бразильском Сенате работают юристы-гигаумники…»
Post #40 512
Хочется завершить начатый #делайRAG рассказ про пайплайн — помимо сегодняшнего будет еще два поста о последнем шаге с эмбеддингами и заключительный.
Сегодня хочу рассказать об одном по сути этапе ручной проверки, но сборка таблиц — технически отдельный большой и не простой этап, который у меня, кажется, ни за одну сессию не сработал нормально 🙂

После разметки Gemini возвращает JSONы, в которых есть метки «session_ID». Этот ID появляется еще на первом этапе (скрапинге): это результат моих попыток сделать многоразовый пайплайн, в рамках которого самостоятельные сессии обрабатываются отдельно от других (грубо говоря, я сделала скрапинг практики за 2020-й год, и все дальнейшие шаги должны исполняться в отношении только этой пачки кейсов). В общем, сколько у меня в итоге было субститутных костыльных кодов, которые дособирали эти пачки — стыдно признаться.
Центральная функция этой части кода — собрать таблицу с релевантными для RAG (субстантивными) делами. Каждый ключ в JSONе становится колонкой таблицы (смотрите аттач со скринами в комментарии — этот аттач в отличие от предыдущих полезно посмотреть тем, кто не очень разбирается во всех этих жисонах, там наглядно). Затем таблица с релевантными делами дополняется скриптом тремя колонками:
🤩 колонка с полным текстом решения ФАС из папки, в которую помещаются все txt с решениями на этапе скрапинга;
🤩 колонка с caseID. Зачем это нужно — это довольно скучно, вынесла это в аттач;
🤩 колонка с «тематическими тегами».
Тематические теги — это описание статей из ФЗ «О рекламе» максимально короткими ключевыми словами по типу «некорректное_сравнение», «БАД_дисклеймер».
Основной функционал этих тегов — они помогают оценивать равномерное наполнение базы знаний кейсами разной тематики (чтобы не было перекоса, например, в рекламу финансовых услуг, и было побольше решений по темам, которые достаточно редко затрагиваются (например, правила о государственном языке)). У тегов есть еще и задел на будущее — они будут основой для reranking-а, который я планирую реализовать для повышения точности выдачи кейсов из базы, связью с кластером эмбеддингов для руководств ФАС, который я тоже хочу до Нового года всё же сделать.

Ну и затем я перехожу к ручному отсмотру. Делаю я его по нескольким причинам:
🤩 Нейросеть иногда плохо справляется с частью промпта, которая просит её считать нерелевантными дела, требующими наличия каких-то лицензий и разрешений, где содержание рекламы не совпало с реальностью. В каждом батче таких обязательно будет 20-30 дел, и, на мой взгляд, они не особо нужны для задачи, которую решает бот.
🤩 Нейросеть получает каждый новый кейс на рассмотрение без знания обо всех предыдущих, и ей невдомек, что база знаний распухнет от однотипных решений по фразе «мы лучше, чем ломбард!».
🤩 Мне просто это нравится! 🤗 Мне нравится рекламное право в целом, это расширяет мой профессиональный кругозор. Всё, что нейросеть оценивает на 6-9 баллов, как правило, довольно интересно смотреть.
🤩 Я искренне верю в то, что база знаний не должна быть свалкой документов, она требует кураторского подхода, и мои объемы не такие, чтобы всё отдавать на откуп нейросети.

Но нужно сказать, что вся эта система оценок действительно работает, и если лень, то можно и отдать всю задачу нейросети: просто смело брать из каждого батча дела от 5 баллов. Но и при мануальном отсмотре я полагаюсь на эти оценки: примерно с 5 баллов уже просматриваю по диагонали, подмечая только кейсы по редко освещаемым в практике вопросам, даже если там простая правовая позиция, и «поднимаю» им оценку. В принципе я читаю только колонку violation_summary, иногда смотрю аргументы ФАС с цитатами. Количество осечек при суммаризации минимальное, и я каждый раз радуюсь тому, как нейросети упростили такой тип задач.

Итогом этого этапа является то, что я беру и руками копирую строки с оценкой выше 4 или 3 (зависит от батча) и вставляю в файл с основной базой, святая святых, RAG.csv. Это тоже можно делать скриптом, но мне не лень 😊

Всё! Всех с понедельничком, отличной недели, друзья ☕️
  • ❤ 10
  • 👍 5
  • 🔥 1
Post #39 422
Возможно, новые подписчики не отлистывали до старых постов, и образ автора канала не ассоциируется с каким-то антропоморфным)) это я, всем приветик ☕

Подоспели фотки вот отсюда! #spectacle
  • 🔥 15
  • ❤ 6
  • 🤩 2
Post #38 1.08K
Новый цикл общеобразовательно-рисерческих постов на канале под гордым названием #rise_of_RAG я начну с неожиданного вопроса: что вы знаете о Бразилии? Что бы вы о Бразилии ни знали ранее, сегодня вы узнаете, что в бразильском Сенате работают юристы-гигаумники, которые куют своими руками будущее права. Вот такой кликбейтный зачин!

Как многие читатели уже знают, я не умею писать короткие посты. На этот раз я переплюнула вообще все собственные ожидания от самой себя, и разразилась лонгридом — вот ссылка на Телеграф.
Этот материал в основном является обзором нескольких статей из стремительно накапливающегося корпуса публикаций по теме методов составления баз знаний для технологии Retrieval-Augmented Generation. При описании методов я пересказываю идеи авторов, свою оценку полезности не даю и перепроверить конкретными метриками тоже, разумеется, не могу. Хотя возникают шальные мысли что-то попробовать и некоторые эксперименты поставить.
О чем будет речь? О трёх подходах, эволюционировавших из обычных векторных RAGов — плоских или, как их еще называют, «наивных». Первый - Multi-Layered Embedding-Based Retrieval (MLR), многоуровневый или иерархический подход. Второй - GraphRAG, графовый. Третий — SAT-GraphRAG (Structure-Aware Temporal GraphRAG, структурно-темпоральный подход). В статье рассказываю о том, как они реализованы технологически, какие задачи решают и в чём они, по мнению авторов, лучше других.

Но этот лонгрид — не только пересказ статей. Вообще, если не любите вдаваться в технические подробности, это всё можно будет скипнуть и читать только последний раздел. В начале я делюсь своими выработанными практикой догадками о минусах наивных RAG, а в конце пытаюсь выявить первые принципы будущей методологии составления баз знаний для RAG-технологии, возможные области применения разных подходов и высказать некоторые свои гипотезы о нашем с вами будущем в свете всего этого.

Мне очень интересно, что вы об этом всём думаете. Я лично чувствую что-то, копая в этом направлении 🙂 правильных ответов нет, никто не знает, как надо, никто не знает, действительно ли всё это нам будет нужно. Но это ужасно интересная область приложения интеллекта, и мне очень хочется, чтобы вокруг неё сложилась дискуссия.

Приятного чтения!
Telegraph Rise of RAG: от плоских векторов к темпоральным графам Что вы знаете о Бразилии? Что бы вы о Бразилии ни знали ранее, сегодня вы узнаете, что в бразильском Сенате работают юристы-гигаумники, которые куют своими руками будущее права Хоть подзаголовок получился пафосным и кликбейтным, но, думаю, дальше он оправдает…
  • ❤ 12
  • 👍 5
  • 🔥 4
Post #37 513
Раз-в-месяцевый #RAG_expansion! Прибыло 3️⃣6️⃣3️⃣ кейса, и теперь в базе 1️⃣8️⃣2️⃣5️⃣ решений. Уже выглядит весьма солидно! С определением охваченного временного периода теперь правда непонятно. Я вроде бы обрабатывала то, что наскрапилось за указанный в фильтрах период 01.01.2020–31.08.2020, но в выборке много дел за 2019-й. Варианта здесь два: либо ФАС в 20-м выложил многое за 19-й, либо я что-то накосячила в своём пайплайне.
Вместе с пополнением базы произошла также смена эмбеддинговой модели: в начале октября Гугл любезно сообщил, что у меня есть месяц для переезда на их новую суперскую cutting-edge модельку gemini-embedding-001, т.к. все предыдущие они перестанут поддерживать ради неё.

Определилась со своими планами по RAGу для этого проекта:
🤩 отсмотрю еще то, что у меня отскраплено за 2019-й и перестану копать вглубь;
🤩 периодически буду собирать копящуюся from now on практику, а так же то, что относится к периодам с 2019-го, но выложили только сейчас;
🤩 постараюсь победить те дела, в которых решения выкладывались не текстом на странице, а аттачами (об этой проблеме здесь).
Думаю, в итоге получится 2500-3000 дел под бот: оптимизированная структурированная база, задизайненная под конкретные задачи. Планы с кластером руководств ФАС и небольшим reranking-ом тоже в силе. И открытый датасет из всех дел тоже будет! Уложусь к декабрю, ваши ставки? 🤪

Еще я сегодня кое-где представила себя человеком, начинающим исследовать возможные стратегии и методики построения RAG-систем в юридическом домене. Надо бы объявить об этом и здесь! У меня по этой теме за последнее время случилось много интересных прозрений, и, по всей видимости, у канала начнется большее тематическое разнообразие (не разбегайтесь сразу, пожалуйста).

И на ночь короткая заметка на полях про вычитанные кейсы. Еще когда только я начала собирать базу знаний, я пошутила, что мы не думали-не гадали, а профеминистическая ячейка вон в питерском и ленобластном УФАСах засела: это на меня произвело впечатление несколько кейсов борьбы с объективацией женщин в рекламе. А дальше этого становилось всё больше, и вот в выборке, над которой я поработала к сегодняшнему экспеншену, из 900+ дел было не меньше трех-четырех десятков, где так или иначе пресекалась убогая сексистская реклама (вплоть до уровня использования слова «шкура»). И это 2019-2020й год!
Подумала шальную мысль, что аббревиатурой «ФАС» также пользуется некая обитающаяся за пределами РФ организация, признанная иноагентской и, не удивлюсь, если экстремистской. И у них Ф в названии отвечает за феминизм. Но оказалось, что ФАС, занимающийся конкретными делами на ниве борьбы с дискриминацией, литералли есть (и всегда был) у нас дома ☕️
Telegram Делай RAG Кто смотрел презентацию с моего первого спикерского инцидента, тот может помнить эту картинку — воронку, визуализирующую пайплайн моей работы над базой знаний. За прошедший месяц я собрала его в единый код в ноутбуке на JupyterLab, и он отработал уже раз…
  • 👍 5
  • ❤ 4
  • 🔥 2
Post #36 567
Воскресно-лирическое

В пятницу Рунетлекс Академия устроила замечательный выпускной вечер для завершивших курс по использованию нейросетей в работе юриста.

Я сама закончила второй поток, что был в мае-июне, и именно после него решила делать бота. Без курса я бы даже не то что не решилась бы, а у меня просто не возникло вообще такой идеи. Те самые три буквы, вокруг которых существует канал и бот (RAG, если вдруг кто не понял…), я просто никогда в глаза не видела до курса, и тем более мне не приходило в голову ещё и кодить с нейросетями. Вот настолько курс расширил границы моего познания, вот такое ускорение дал на абсолютно ровном месте.

Прошло уже три потока, и на третьем я была ментором. Менторы посильно подсказывают студентам курса что-то по материалу и организации, дают искорку движухе в чате потока и чатах вебинаров, поддерживают студентов в стрессовые моменты. Вроде бы просто пишешь в чатиках, а потом мама курса, Ксения Даньшина, зовёт нас вместе с командой Академии и спикерами выйти к студентам 🥰🥰

Будет четвертый поток — уже скоро, в ноябре. Я там тоже буду менторить. Если вы вдруг давно смотрели на курс, то не могу не посоветовать: вижу воочию, как он развивается, крепнет и становится всё круче, сохраняя при этом душевность и доступность. По моему опыту хождения на всякие повышения квалификации, это самый необычный образовательный продукт на рынке юр.образования. Если вам нужны детали о курсе, напишите мне в личку или комментарии 🙂

И про выпускной еще скажу, что я мало когда в своей жизни получала столько поддерживающей обратной связи, как в этот раз по теме бота. У меня сложно с принятием комплиментов, на самом деле, но когда мне на следующий день написала добрые слова экс-служащая ФАС, я просто отлетела от радости! Да и вообще знать, что кто-то реально поделкой пользуется на пользу себе — становится не жалко всех этих вайбкодинговых мучений.

Вот. Спасибо всем причастным за этот классный пятничный вечер! ❤️
  • ❤ 20
  • 🔥 18
  • 🤩 5
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →