
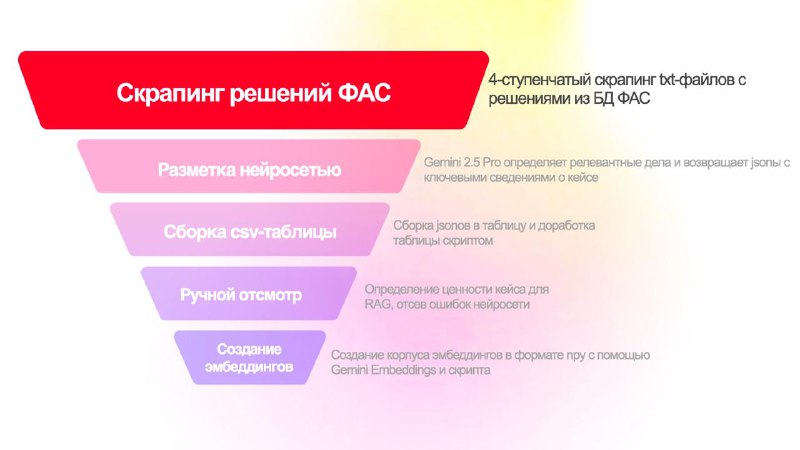
Скрапинг (кто-то говорит скрейпинг) — это автоматизированное извлечение информации с сайтов, то есть скрипт «читает» страницы сайтов, но примерно в стотыщ раз быстрее, чем это делает человек, попутно вытягивая их них всякие нужные данные. Это была первая вайбкодинговая задачка, которую я себе поставила и которую радостно очень быстро выполнила, и это задачка, которая может быть актуальна многим юристам, в том числе не собирающимся делать ни RAGов, ни тем более ботов. И я, знаете ли, могу даже дать некоторые, как мне кажется, полезные советы — они будут в конце.
Я попросила Claude описать функциональность скрапера как-то кратко, но максимально по сути, и он выдал «интеллектуальный веб-краулер с функцией инкрементального обновления данных». 😵 Имеется в виду, что скрапер умеет собирать дела за указанный пользователем временной период, причем как смотрит новые (отсутствующие в базе), так и отслеживает появление новых решений в уже известных делах.
Здесь нужно небольшое пояснение
ФАС структурирует базу данных (по крайней мере в части рекламных дел) так: создает карточку дела, которой присваивается UUID (здесь про это). Внутри карточки с делом размещаются документы по делу отдельными страничками (определение о возбуждении, решение, предписание и т.д). Соответственно, в разных моментах времени эта карточка может быть пустой или содержать разное количество документов. Меня для целей сборки RAGа интересуют только карточки с решениями. У каждой карточки с документов есть свой UUID (в моих файлах он идет как docID).
Скрапер делает поисковые запросы по 4 фильтрам, затем выкачивает тексты решений в txt и попутно ведет лог с записями всех caseID и относимых к ним docID. Это если кратко, более подробно расписанные этапы для особо любопытных прикладываю в pdf-аттаче, также там всякие скриншоты с анализом проблемных мест в базе ФАС.
Анализировать проблемные места сайтов, с которых вы хотите что-то скрапить — важно, если вам нужна достаточно полная база без мусора. Вот несколько бутылочных горлышек, с которыми пришлось поработать (причина у них по сути одна — неконсистентное ведение базы знаний, пополняют-то её люди):
🤩 выше говорила, что поиск ведется по 4 параметрам, а именно 1)
Управление - Управление контроля рекламы и недобросовестной конкуренции, 2) Процедура - Реклама, 3) Сфера - Рынок рекламы, 4) Доп. критерии - реклама. Подавляющее большинство проходит в параметре «процедура», но далеко не все: рекламный кейс может заваляться и по другим параметрам (например, здесь, в параметре
процедура указано «КоАП», а я по нему не проверяю).🤩 в подавляющем большинстве дел текст решения выкладывается на странице, и скрапер его собирает и создает на моем компьютере txt-файл. Но некоторые УФАСы выкладывают тексты решений в других форматах, которые подвешивают в карточку отдельным аттачментом, оставляя основной текст страницы пустым или заполненным какой-нибудь фразой.
Это остается проблемой, скрапинг таких аттачей я пока не делала. Но опытным путем было установлено, что если в Gemini на разметку послать написанный ерундовый текст, то она может из этого сочинить целое дело, поэтому этот нюанс учтен в пайплайне дальше - на отправку по API на разметку идут только тексты из файлов от 100 кб.
🤩 я докопала уже до 2018-го года и, кажется, ФАС начал более или менее консистентно вести базу, используя UUID с какого-то момента в 2018-м, потому что что-то там точно поменялось в названиях страничек с решениями.
Думаю пока, что с этим делать, много ли там вообще чего-то ценного для RAGа с учетом того, что законодательство за последние 7 лет достаточно сильно поменялось.
Ну и советы с обещанным аттачем ниже!