TGViewer
Channel Public Channel
Data Scientist | ML & AI

Data Scientist | ML & AI

@datascience_tg

Один из ведущих каналов по Data Science, Machine Learning и Big Data

Сотрудничество: @bape_ads
Прайс: @bape_media
Subscribers
3.05K
Photos
618
Videos
211
Links
697

Showing posts older than #792 · Back to latest

Older Posts 18 shown
Post #790 731
📰 Локальные LLM модели: обзор и тестирование

Большие языковые модели перестали быть только облачными сервисами — сегодня многие из них можно запускать прямо на обычном ПК.

В статье собран практический обзор популярных локальных моделей и результаты их тестирования в реальных сценариях.

Что внутри:
▶️ В чем преимущества локальных LLM по сравнению с облачными: конфиденциальность, доступность, бесплатный API, корпоративные сценарии;

▶️ Как работать с Ollama: загрузка моделей, запуск через чат и API, управление через терминал;

▶️ Сравнительное тестирование моделей (Mistral, Llama 3.1, Qwen, Gemma, GPT-OSS, DeepSeek) на задачах фактологии, математики, кода и текста;

▶️ Результаты по скорости и точности: где локальные модели справляются лучше, а где уступают облачным;

▶️ Практические выводы — для каких задач подходят быстрые «легкие» модели, а где уместны более крупные и «думающие» варианты.


Материал будет полезен тем, кто хочет разобраться в локальных альтернативах ChatGPT и протестировать их в боевых условиях.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 1
Post #789 590
⚡️ GPT 5.4 теперь в Telegram!

А кроме неё ещё и Nano Banana 2, Gemini 3.1, Sora 2 и куча других новейших моделей.

Попробуй сам: @visionai
Post #788 644
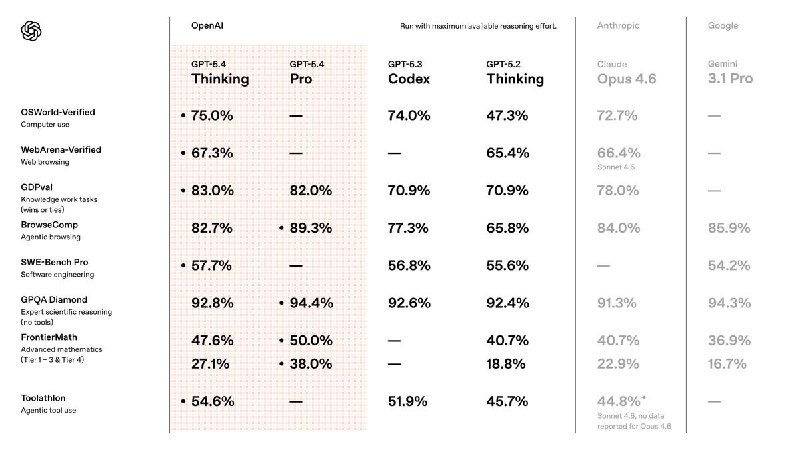
📰 OpenaAI релизнули GPT-5.4

Модель вышла в версиях Thinking и Pro: подросли метрики в кодинге и математике, а ещё сильно прокачали computer use.

Из приятного: GPT-5.4 теперь быстрее отвечает и тратит меньше токенов на рассуждения.

Что еще интересного:
– Ответ можно остановить прямо в процессе и докинуть новые инструкции;
– Контекст теперь до 1 миллиона токенов
– в Codex появился /fast — генерация быстрее в 1.5 раза, но токены в таком режиме считаются х2.


Протестировать модель уже можно в нашем боте — VISION AI.

tags: #новоости

➡ Data Scientist | Чат
Post #785 724
📰 GPT-5.3 и Gemini 3.1 Flash Light официально вышли!

Google и OpenAI почти одновременно обновили свои модели:

⚡️ Gemini 3.1 Flash-Lite — новая ставка Google на дешевую и быструю модель: до ~370 токенов/сек, цена около $0.25 за миллион входящих и $1.50 за миллион выходящих токенов. По качеству примерно уровень «GPT-5 mini».

⚡️ GPT-5.3 Instant — обновили поведение модели: меньше странных отказов, убрали раздражающий «вежливый» тон, подтянули веб-поиск и понимание контекста.

Фокус у обеих моделей одинаковый — быстрые агенты, API-интеграции и массовые продакшен-задачи, где важны latency и цена.

Обе уже доступны, так что можно тестировать.

tags: #новоости

➡ Data Scientist | Чат
Post #784 771
🔖 Нашли интересную платформу — аналог LeetCode для Data Science

DataLemur — платформа с реальными задачами из собеседований в Tesla, Meta, Twitter и других топовых компаниях.

Внутри задачи по SQL, статистике, Python и ML, которые можно фильтровать по уровню сложности и компаниям, чтобы прокачиваться точечно.

Идеально для подготовки к позициям Data Scientist и Data Analyst, забираем — здесь.

tags: #полезное

➡ Data Scientist | Чат
  • ❤ 4
  • 😁 1
Post #783 685
👍 Подборка инструментов для управления памятью и контекстом в LLM-системах

В репозитории собрана структурированная подборка инструментов для хранения, извлечения и организации контекста в LLM-приложениях.

Что внутри:
▶️ Подходы к организации памяти: векторные хранилища, графы знаний и гибридные модели

▶️ Инструменты для долговременной памяти LLM-агентов

▶️ Решения для agent-based и multi-agent архитектур

▶️ Сравнительная таблица с лицензиями, типом хранилища и сценариями использования

▶️ Ссылки на репозитории и документацию для быстрого выбора стека


Репозиторий поможет выбрать и спроектировать подходящий memory-слой для LLM-систем — забираем здесь.

tags: #полезное

➡ Data Scientist | Чат
  • ❤ 1
Post #781 711
🗂 Подборка материалов для реализации ML-алгоритмов

Делимся репозиторием с Google Colab-ноутбуками, где показано, как шаг за шагом реализовать классические алгоритмы машинного обучения с нуля.

Каждый ноутбук — это не только код, но и разбор идей: от линейной регрессии и деревьев решений до градиентного бустинга и нейросетей.

➡ Ссылка на GitHub

tags: #полезное

➡ Data Scientist | Чат
Post #780 790
🗂 Подборка материалов для реализации ML-алгоритмов

Делимся репозиторием с Google Colab-ноутбуками, где показано, как шаг за шагом реализовать классические алгоритмы машинного обучения с нуля.

Каждый ноутбук — это не только код, но и разбор идей: от линейной регрессии и деревьев решений до градиентного бустинга и нейросетей.

➡ Ссылка на GitHub

tags: #полезное

➡ Data Scientist | Чат
Post #778 725
📰 Nano Banana 2 официально вышла!

Google серьёзно прокачали генерацию: упор на консистентность, референсы и работу с внешними данными.

Что нового:
🤭 Сохранение персонажей и объектов в рамках сессии. Можно переиспользовать их без потери деталей.
🤭 Доступ к интернету в реальном времени: модель уточняет факты, погоду, контекст и строит графики.
🤭 Текст почти без артефактов — локализация и перевод теперь выглядят адекватно.


Отдельный кайф — демо «Window Seat»: вводите точку на карте, модель проверяет погоду и время суток, а затем генерирует вид из окна с учётом реальных условий.

➡ Читать подробнее

tags: #новости

➡ Data Scientist | Чат
  • ❤ 4
Post #777 816
💾 6 курсов по ИИ от Anthropic бесплатно

Если работаешь с AI, агентами или API — это база, которую сейчас проходят разработчики в топ-компаниях.

▶️ Работа с Claude API
https://anthropic.skilljar.com/claude-with-the-anthropic-api


▶️ Введение в Model Context Protocol (MCP)
https://anthropic.skilljar.com/introduction-to-model-context-protocol


▶️ Claude в Amazon Bedrock
https://anthropic.skilljar.com/claude-in-amazon-bedrock


▶️ Claude в Google Cloud (Vertex AI)
https://anthropic.skilljar.com/claude-with-google-vertex


▶️ Продвинутый MCP
https://anthropic.skilljar.com/model-context-protocol-advanced-topics


▶️ Claude Code на практике
https://anthropic.skilljar.com/claude-code-in-action


tags: #курсы #ai

➡ Data Scientist | Чат
  • 🔥 3
  • ❤ 1
Post #776 866
🗂 Один из лучших ресурсов для изучения Data Science и Machine Learning

На Kaggle собраны интерактивные курсы, которые помогут быстро разобраться в ключевых темах DS и ML.

Формат простой: короткие уроки, практические задания и сертификат по завершении — всё бесплатно.

Внутри:
• основы Python для анализа данных;
• машинное обучение и работа с моделями;
• pandas, SQL, визуализация;
• продвинутые техники и практические кейсы.


Каждый курс занимает всего 3–5 часов и сразу даёт практические знания для работы.

➡ Ссылка на платформу

tags: #полезное

➡ Data Scientist | Чат
  • 👍 2
Post #774 1.28K
🗂 По-настоящему понимаем как работают ML-модели

Drawdata — инструмент, который позволяет прямо в Jupyter нарисовать собственный 2D-датасет и сразу обучать на нём модель.

Вы сами создаёте точки через интерактивный виджет, добавляете данные — и в реальном времени видите, как меняется поведение модели.

Только визуализация, практика и открытый исходный код.

➡ Ссылка на инструмент

tags: #полезное

➡ Data Scientist | Чат
Post #773 794
Блог владельца «Data Scientist»

Жизнь в Telegram и за его пределами, бизнес на каналах и много программирования:

https://t.me/+6LFfq_FDocc4MTg6
Post #772 873
✏️ Как научить языковые модели рассуждать последовательно?

В этой статье автор разбирает подход Schema-Guided Reasoning (SGR) для повышения предсказуемости работы языковых моделей.

Вы узнаете, как с помощью структурных схем заставить LLM мыслить последовательно и избегать хаотичных ответов, что особенно критично для локальных моделей в корпоративной среде.

➡ Ссылка на статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 2
Post #771 775
😂 Мем дня: Сэм Альтман и Дарио Амодеи отказались держаться за руки

На AI-саммите в Дели устроили «Unity Raise» — участники берутся за руки и поднимают их вверх в знак солидарности.

Все взялись. Кроме двух человек, которые случайно оказались рядом: Сэма Альтмана и Дарио Амодеи.

Контекст сочный: раньше Дарио был VP по исследованиям в «OpenAI», а в 2020 ушёл из-за разногласий и основал «Anthropic». Сейчас это прямые конкуренты в гонке моделей.

➡ Data Scientist | Чат
  • 😁 4
  • ❤ 1
Post #770 769
📰 Вайбкодеры ликуют: Cursor обновился до 2.5

Обновление получилось жирным, из нового:
▶️ Появился собственный маркетплейс плагинов, первые партнёры — AWS, Figma, Stripe, Linear, Amplitude;

▶️ Запустили параллельную работу агентов и расширили Sandbox Network Controls: теперь агентов проще контролировать;

▶️ В CLI добавили Plan mode и поддержку Mermaid-диаграмм прямо в терминале;

▶️ Курсор теперь умеет подтягивать прошлые диалоги как контекст.


Бежим обновляться 💃

tags: #новости

➡ Data Scientist | Чат
  • ❤ 3
  • 🔥 1
Post #769 748
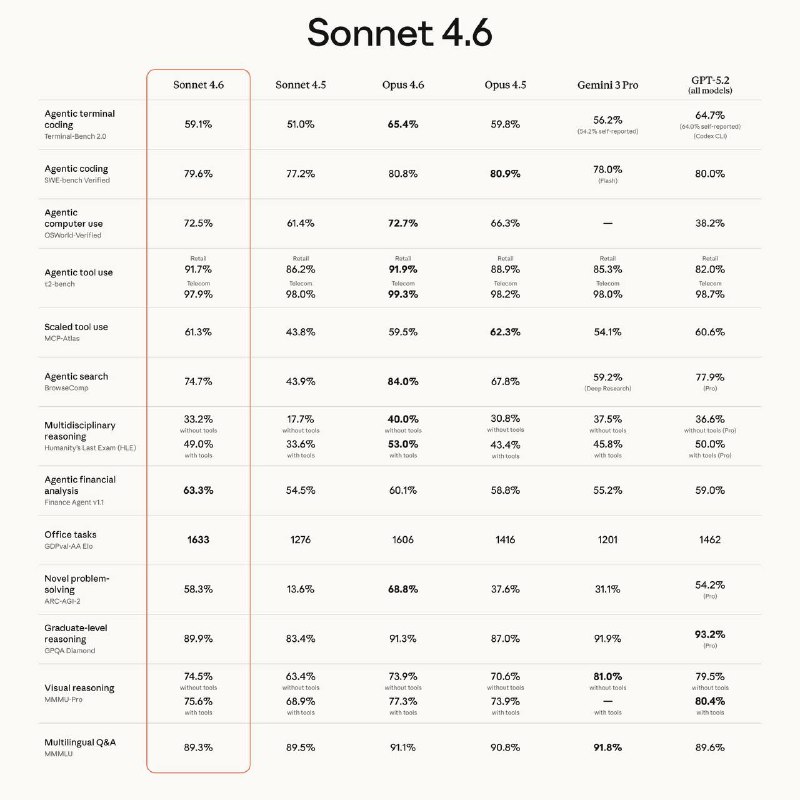
📰 Вышел Claude Sonnet 4.6: почти как Opus, но дешевле

Anthropic выпустили обновлённую «Sonnet 4.6» — и это уже не «средняя» модель, а серьёзный конкурент топовым версиям.

Главное:
▶️ Примерно на 40% дешевле «Opus» и доступна даже на бесплатных планах в «Claude Code» и других продуктах;
▶️ В бете — контекст до 1 млн токенов;
▶️ Серьёзный апгрейд в кодинге, reasoning и computer use;
▶️ По ряду бенчмарков вплотную приближается к «Opus 4.6» и в некоторых тестах обходит «GPT-5.2» и «Gemini 3 Pro»;
▶️ Улучшена работа с интерфейсами: сложные формы, таблицы и многошаговые сценарии выполняются почти на уровне человека.


Интересный момент — «Vending Bench»: модель выстроила стратегию и «заработала» $5639 против ~$4000 у «Opus 4.6». При этом исследователи отмечают, что Sonnet действует более жёстко и консервативно в стратегии.

➡ Читать статью

tags: #статья #новости

➡ Data Scientist | Чат
  • 🔥 1
Post #768 797
📰 Что такое эмбеддинги и как с ними работать: вводная для начинающих

Эмбеддинги — это способ представить объекты (текст, картинки, аудио) в виде числовых векторов, с которыми можно работать математически.

В статье разобраны основные подходы к созданию эмбеддингов и примеры их применения на практике.

Что вы узнаете в статье:
▶️ Что такое эмбеддинги и как они устроены с точки зрения векторного пространства;

▶️ Какие объекты можно преобразовать в эмбеддинги: текст, изображения, аудио и мультимодальные данные;

▶️ Как работать с расстояниями между векторами (евклидово, манхэттенское, косинусное);

▶️ Какие задачи можно решать с помощью эмбеддингов: классификация текстов, поиск по базе знаний, кластеризация.


Статья даёт базовое понимание эмбеддингов и показывает, как начать использовать их в реальных проектах.

➡ Читать статью

tags: #статья

➡ Data Scientist | Чат
  • ❤ 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →