
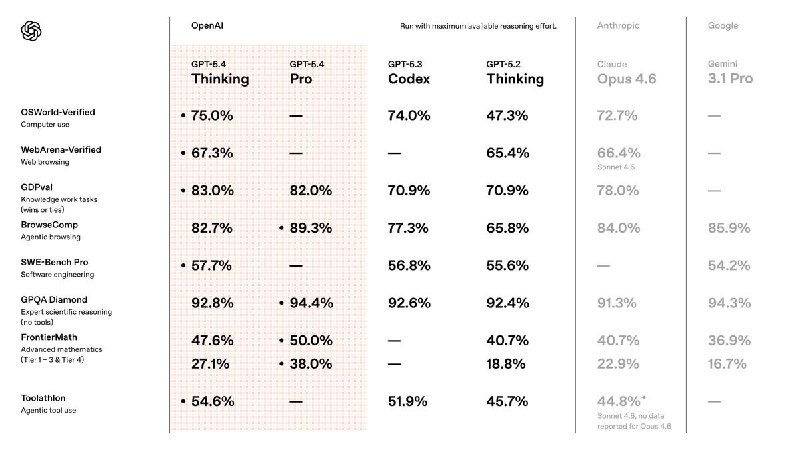
Модель вышла в версиях Thinking и Pro: подросли метрики в кодинге и математике, а ещё сильно прокачали computer use.
Из приятного: GPT-5.4 теперь быстрее отвечает и тратит меньше токенов на рассуждения.
Что еще интересного:
– Ответ можно остановить прямо в процессе и докинуть новые инструкции;
– Контекст теперь до 1 миллиона токенов
– в Codex появился /fast — генерация быстрее в 1.5 раза, но токены в таком режиме считаются х2.
Протестировать модель уже можно в нашем боте — VISION AI.
tags: #новоости
➡ Data Scientist | Чат