TGViewer
Channel Public Channel
Data elites

Data elites

@dataelites

📉 به نام خالق داده و الگوریتم📈
😁ما یه تیم خوش ذوق و خلاق از دانشجوهای آماری هستیم😁
ورودتون به دنیای علم داده رو خوش آمد میگیم😇
برای ارتباط با ادمین به آی دی زیر پیام بدید
@dataelite
ارتباط با پیام داخلی کانال:
https://t.me/dataelites?direct
Subscribers
1.38K
Photos
27
Videos
12
Links
128

Showing posts older than #227 · Back to latest

Older Posts 19 shown
Post #226 369
📊 پنجشنبه‌های DE | دیتاست هفته
اگر می‌توانستی کل دنیای پژوهش را مثل یک دیتاست تحلیل کنی، دنبال چه چیزی می‌گشتی؟ 👀
این هفته سراغ OpenAlex رفتیم؛ یک کاتالوگ باز از دنیای پژوهش که صدها میلیون مقاله و اثر علمی را به نویسندگان، دانشگاه‌ها، ژورنال‌ها، موضوعات پژوهشی، ناشران و منابع مالی پژوهش متصل می‌کند.
و اینجاست که ماجرا جذاب می‌شود؛ چون با این داده‌ها می‌توانی سؤال‌هایی را بررسی کنی که واقعاً ارزش تحلیل دارند:
🔹 کدام حوزه‌های AI و Data Science سریع‌تر در حال رشدند؟
🔹 چه موضوعاتی تازه دارند وارد جریان اصلی پژوهش می‌شوند؟
🔹 کدام دانشگاه‌ها در یک حوزه خاص بیشترین خروجی پژوهشی را دارند؟
🔹 شبکه همکاری بین پژوهشگران و کشورها چه شکلی است؟
🔹 کدام مقاله‌ها بیشترین تأثیر و citation را داشته‌اند؟
🔹 روند انتشار مقالات یک حوزه طی ۱۰ یا ۲۰ سال گذشته چطور تغییر کرده؟
حتی می‌توانی یک قدم جلوتر بروی و پروژه‌هایی مثل:
🎓 University & Professor Finder برای اپلای
📈 Research Trend Detector
🌍 Scientific Collaboration Network
🔥 Emerging Research Topics Dashboard
بسازی.
OpenAlex فقط یک فایل برای دانلود نیست؛ API رسمی هم دارد، بنابراین می‌توانی مستقیماً با Python یا R داده‌ها را بر اساس موضوع، دانشگاه، نویسنده، سال انتشار و فیلترهای مختلف دریافت کنی.
یعنی به‌جای اینکه فقط مقاله بخوانی، می‌توانی خودِ اکوسیستم پژوهش را تحلیل کنی. 🚀
🔗 OpenAlex:
https://openalex.org
  • 🔥 3
  • 🤝 1
Post #225 393
🚨 یک تراکنش بزرگ همیشه Anomaly نیست.
برای چهارشنبه‌های Data Elites، زهرا اسفندیار یک پروژه کامل برای تشخیص ناهنجاری در داده‌های تراکنشی طراحی کرده؛ پروژه‌ای که از ساخت دیتاست واقعی‌نما شروع می‌شود و تا پیاده‌سازی یک Alert Engine پیش می‌رود.
در این پروژه بیش از 80 هزار تراکنش و 5 هزار مشتری حقیقی و حقوقی بررسی می‌شوند و ناهنجاری‌ها فقط بر اساس مبلغ تشخیص داده نمی‌شوند؛ بلکه Context هر تراکنش مثل رفتار تاریخی مشتری، زمان، موقعیت، Merchant و Channel هم وارد تحلیل می‌شود.
برای Detection از ترکیب PELT، CAPA، PyOD / Isolation Forest و TimeSeriesOD استفاده شده تا انواع مختلف ناهنجاری، از Level Shift تا الگوهای چندمتغیره، شناسایی شوند.
🎯 ایده اصلی پروژه:
Anomaly یعنی رفتاری که با الگوی معمول خودش سازگار نیست؛ نه صرفاً یک عدد بزرگ

💻 کد کامل پروژه و Notebookها:نیست؛ نه صرفاً یک عدد بزرگ.
https://github.com/Zahra-Esfandiar/Context-Aware-Transaction-Anomaly-Detection.git
  • ❤‍🔥 3
  • 🥰 1
Post #224 1.54K
Audio
🎙 اولین اپیزود پادکست Data Elites منتشر شد!
برای شروع سه‌شنبه‌های DE رفتیم سراغ یکی از بهترین نقطه‌های شروع برای ورود جدی به Machine Learning:
فصل دوم کتاب An Introduction to Statistical Learning.
اما قبل از ورود به فصل دوم، یک مرور کوتاه و کاربردی از فصل اول هم داریم و مفاهیم اصلی Statistical Learning بشیم.
در ادامه، قدم‌به‌قدم می‌ریم سراغ مفاهیمی که پایه‌ی بخش بزرگی از این مسیر رو می‌سازن:
🔹 Prediction و Inference
🔹 Model Flexibility
🔹 Training vs Test Error
🔹 Overfitting
🔹 Bias–Variance Trade-Off
🔹 Regression و Classification
🔹 KNN
اگر تازه می‌خواید این مسیر رو شروع کنید، این اپیزود می‌تونه نقطه شروع خیلی خوبی باشه؛ چون از یک جمع‌بندی کوتاه از فصل اول شروع می‌کنیم و بعد وارد Chapter 2 — Statistical Learning می‌شیم تا مفاهیم کم‌کم کنار هم قرار بگیرن و تصویر بزرگ Statistical Learning ساخته بشه.
📚 Chapter 1 — Quick Review
📘 Chapter 2 — Statistical Learning
🎧 اولین اپیزود پادکست Data Elites
و اگر هنوز کتاب رو ندارید، می‌تونید نسخه رسمی و رایگان کتاب رو از لینک زیر دانلود کنید:
[لینک دانلود کتاب]
  • 👎 3
  • ❤‍🔥 2
  • 👏 2
Post #223 399
🎯 دوشنبه‌های Data Elites | مدل فقط پیش‌بینی نکند؛ بگوید چقدر مطمئن است!
فرض کنید یک مدل می‌گوید:
🏠 قیمت خانه: ۵ میلیارد
📈 فروش ماه آینده: ۱۰ هزار واحد
🩺 بیمار: پرریسک
اما سؤال مهم‌تر این است:
چقدر می‌توان به این پیش‌بینی اعتماد کرد؟
اینجاست که MAPIE وارد می‌شود؛ یک کتابخانه متن‌باز Python برای Conformal Prediction و Uncertainty Quantification که کمک می‌کند به‌جای یک پیش‌بینی خشک، عدم‌قطعیت مدل را هم ببینیم.
مثلاً به‌جای اینکه مدل فقط بگوید:
❌ قیمت خانه = ۵ میلیارد
می‌تواند بگوید:
✅ قیمت احتمالی با پوشش ۹۰٪ بین ۴.۳ تا ۵.۸ میلیارد تومان است.
MAPIE برای مسائل مختلفی مثل:
🔹 Regression
🔹 Classification
🔹 Time Series
🔹 Prediction Intervals
🔹 Prediction Sets
🔹 Calibration & Risk Control
قابل استفاده است.
نسخه جدید MAPIE 1.5.0 هم قابلیت‌های تازه‌ای در زمینه Conditional Conformal Prediction، Quantile Regression، Calibration و Risk Control اضافه کرده؛ یعنی ابزار دارد جدی‌تر وارد دنیای Trustworthy Machine Learning می‌شود.
و این دقیقاً همان چیزی است که در پروژه‌های واقعی اهمیت دارد:
یک مدل خوب فقط جواب نمی‌دهد؛ باید بتواند بگوید این جواب چقدر قابل اعتماد است

🔗 GitHub
🎞 YouTube
GitHub GitHub - scikit-learn-contrib/MAPIE: A scikit-learn-compatible library for estimating prediction intervals and controlling risks… A scikit-learn-compatible library for estimating prediction intervals and controlling risks, based on conformal predictions. - scikit-learn-contrib/MAPIE
  • ❤ 2
  • ❤‍🔥 2
Post #222 870
🎲 هوش مصنوعی فقط نباید پیش‌بینی کند؛ باید بداند چقدر می‌تواند به پیش‌بینی خودش اعتماد کند!
موضوع این هفته‌ی یکشنبه‌های Data Elites یکی از مهم‌ترین پایه‌های آمار، علم داده و AI است:
احتمال؛ زبان مدل‌ها برای فهم عدم‌قطعیت
چهار منبع رایگان انتخاب کردیم؛ دو مسیر نظری برای یادگیری عمیق مفاهیم و دو مسیر کاربردی برای دیدن احتمال در حل مسئله و Machine Learning🚀

🎯 مسیر نظری فارسی
آمار و احتمال مهندسی — دکتر محمدمهدی نایبی، دانشگاه صنعتی شریف ( دانشگاه صنعتی آریا مهر )
دوره‌ای کامل از اصول احتمال، بیز و متغیرهای تصادفی تا توزیع‌های مشترک، امید شرطی، انواع همگرایی، قانون اعداد بزرگ و قضیه حد مرکزی.
🔗 لینک

📊 مسیر جدید و مسئله‌محور فارسی
آمار و احتمال مهندسی — دکتر فرید آشتیانی مفرد طهرانی، دانشگاه صنعتی شریف ( دانشگاه صنعتی آریا مهر )
دوره‌ای مربوط به بهار ۱۴۰۵ با رویکرد مهندسی و حل مسئله؛ مناسب دانشجویان کامپیوتر، برق، Data Science و AI، این مجموعه دست‌کم تا جلسه ۲۵ به‌صورت رایگان منتشر شده است
🔗 لینک
🇬🇧 مسیر نظری انگلیسی — 2026
STATS 100A: Introduction to Probability — UCLA
یک دوره کامل از فضای احتمال، شمارش و بیز تا توزیع‌های مشترک، امید شرطی، Monte Carlo، قانون اعداد بزرگ و قضیه حد مرکزی؛ همراه با تمرین و شبیه‌سازی‌های Python
🔗 دوره و منابع
🔗 ویدئوهای Summer 2026

مسیر کاربردی و پیشرفته انگلیسی — 2026
CMPT 727: Statistical Machine Learning — Simon Fraser University
یک دوره برای ورود جدی‌تر به Probabilistic Machine Learning؛ شامل Maximum Likelihood، EM، Bayesian Networks، Markov Random Fields، MCMC، Variational Inference و Causal Inference. این دوره برای کسانی مناسب است که مبانی احتمال و یادگیری ماشین را از قبل می‌دانند.
🔗 صفحه کامل دوره
🔗 ویدئوهای دوره

🎁 منبع تکمیلی فارسی
ویدئوهای رایگان دوره دکتر علی شریفی زارچی دیگر در دسترس نیستند؛ اما مخزن عمومی دوره شامل Notebookهای زبان R، تمرین‌ها، آزمون‌ها و سیلابس همچنان باقی مانده است
🔗https://github.com/SharifiZarchi/Probability_Statistics

💡 مسیر پیشنهادی DE:
اگر احتمال را از پایه شروع می‌کنید:
دکتر نایبی برای ساختن پایه نظری
⬇️
دکتر آشتیانی برای حل مسئله و تثبیت مفاهیم
⬇️
UCLA STATS 100A برای مرور انگلیسی و شبیه‌سازی با Python
⬇️
CMPT 727 برای ورود به Probabilistic Machine Learning
در کنار این مسیر هم از مخزن دکتر شریفی زارچی برای تمرین‌ها و پیاده‌سازی با R استفاده کنید. 🚀
آپارات - سرویس اشتراک ویدیو آموزش درس آمار و احتمال مهندسی (دانشگاه صنعتی شریف) برای مشاهده ادامه این آموزش می توانید به این لینک مراجعه کنید. https://modernamooz.ir/EDU/lms/product/379
  • 🔥 2
  • ❤ 1
  • 😍 1
Post #221 411
📄 شنبه‌های Data Elites را با یک مقاله تازه و متفاوت شروع می‌کنیم!
🚨 آیا Claude Code دارد مرز بین زبان‌های برنامه‌نویسی را از بین می‌برد؟
پژوهشگران فعالیت بیش از ۵ هزار برنامه‌نویس GitHub و میلیون‌ها تغییر کد را بررسی کردند و به نتیجه جالبی رسیدند:
بعد از شروع استفاده از Claude Code، برنامه‌نویس‌ها سراغ زبان‌هایی رفتند که قبلاً تقریباً با آن‌ها کار نمی‌کردند.
یعنی شاید یک برنامه‌نویس Python بتواند بدون تسلط کامل بر Rust، Swift یا Go، با کمک یک AI Agent پروژه‌ای واقعی در آن زبان‌ها بسازد.
اما یک سؤال مهم باقی می‌ماند:
آیا Claude واقعاً مهارت برنامه‌نویس را بیشتر می‌کند، یا فقط فاصله میان ایده و اجرای کد را کوتاه‌تر کرده است؟
شاید آینده برنامه‌نویسی متعلق به کسی نباشد که همه زبان‌ها را بلد است؛
بلکه متعلق به کسی باشد که بداند چطور هوش مصنوعی را درست هدایت، بررسی و اصلاح کند. 👨‍💻🤖
📄 Agentic Delegation and the Language Frontier of Software Developers
🔗 https://arxiv.org/pdf/2605.25438
  • 🥰 2
  • 🔥 1
Post #220 492
🔥 این‌بار ChatGPT خودش وارد دنیای ترجمه شده!

قابلیت تازه Translate with ChatGPT منتشر شده؛ ابزاری که قرار نیست فقط متن را از یک زبان به زبان دیگر تبدیل کند.

با این قابلیت می‌توانی:

🌍 زبان متن را خودکار تشخیص بدهی
📄 متن یا فایل را مستقیم برای ترجمه وارد کنی
🎙 با صدا متن بدهی
✨ ترجمه را طبیعی‌تر و روان‌تر کنی
💼 لحن آن را حرفه‌ای‌تر کنی
💡 یا حتی بخواهی مفهوم متن خیلی ساده برایت توضیح داده شود

تفاوت جذابش همین‌جاست؛ بعد از ترجمه، هنوز می‌توانی با متن کار کنی، لحنش را تغییر بدهی، بازنویسی‌اش کنی یا بهتر بفهمیش.

یعنی دیگر فقط ترجمه نیست؛
ترجمه + درک مفهوم + بازنویسی + کنترل لحن، همه در یک محیط. 🚀

https://chatgpt.com/translate/
Chatgpt ChatGPT Translate | Fast, Natural, 40+ Languages ChatGPT translates across 40+ languages with accuracy, tone, and cultural nuance. Translate text, voice, or photos for everyday use, travel, school, and work — and learn grammar or phrasing as you go.
  • 🎉 2
  • ❤‍🔥 1
  • ❤ 1
  • 👎 1
Post #218 519
🗞 جمعه‌های DE | این هفته در دنیای Data و AI چه گذشت؟
قبل از اینکه هفته تموم بشه، بریم سراغ چند اتفاق مهمی که ارزش دنبال‌کردن دارن:
🔹 هوش مصنوعی ارزان‌تر شد
OpenAI قیمت GPT-5.6 Luna را ۸۰٪ و Terra را ۲۰٪ کاهش داد؛ اتفاقی مهم برای اجرای Agentها و پردازش‌های حجیم با هزینه کمتر.
🔹 Papers AI معرفی شد
یک محیط پژوهشی یکپارچه از تیم سازنده Overleaf که مقاله، کد، داده، نوت‌بوک و منابع پروژه را کنار هم نگه می‌دارد و Context پژوهش را فراموش نمی‌کند.
🔹 پایان GitHub Spark
GitHub ساخت اپلیکیشن جدید در Spark را متوقف کرده و کاربران فعلی تا ۳۱ آگوست فرصت دارند کد پروژه‌هایشان را Export کنند.
🔹 Agentها هنوز پژوهشگر کامل نیستند!
یک مطالعه جدید نشان داد Agentهای پیشرفته توانستند بخش مهندسی پژوهش را انجام دهند، اما در قضاوت علمی، اصلاح مسیر و حل سؤال‌های پژوهشی باز موفق نبودند.
🔹 کد بیشتر، Pull Request کوچک‌تر
GitHub پیشنهاد می‌کند کدهای بزرگ تولیدشده توسط AI به چند Pull Request کوچک، وابسته و قابل‌بررسی تقسیم شوند تا کنترل انسانی واقعاً حفظ شود.
📌 نتیجه این هفته:
هوش مصنوعی سریع‌تر و ارزان‌تر می‌شود، اما همچنان بدون نظارت، قضاوت و تفکر انسانی نمی‌توان به خروجی آن اعتماد کامل کرد.

با جمعه‌های Data Elites، مهم‌ترین اتفاق‌های دنیای داده و AI را از دست ندهید. 🚀
OpenAI Advancing the price-performance frontier with GPT-5.6 Explore lower GPT‑5.6 pricing for Luna and Terra—and how OpenAI’s more efficient models help enterprises deploy AI workflows at scale.
  • 🔥 2
  • 🫡 1
Post #217 898
🚀 دیگه قرار نیست یادگیری علم داده بین ده‌ها دوره، کتاب و ویدئو نصفه‌کاره بماند!
در Data Elites یک نقشه‌راه تعاملی ساختیم تا مسیر یادگیریت را از آمار و Python تا Machine Learning و پروژه‌های واقعی، منظم و قابل‌اندازه‌گیری پیش ببری.
داخل اپ می‌تونی:
✅ بیش از ۵۸ مهارت را مرحله‌به‌مرحله دنبال کنی
✅ درس‌ها و دوره‌های تمام‌شده را تیک بزنی
✅ درصد پیشرفتت را روی Dashboard ببینی
✅ تمرین‌ها، پروژه‌ها و ساعت مطالعه‌ات را ثبت کنی
✅ برنامه پیشنهادی ۲۴ هفته‌ای داشته باشی
✅ گزارش کامل مسیرت را به‌صورت Excel دانلود کنی
این فقط یک Roadmap نیست؛
یک سیستم مدیریت یادگیری شخصی برای علم داده است.
👩🏻‍💻 طراحی و توسعه: زهرا اسفندیار
🔗 لینک ورود به اپ:
https://x2utnj-zahra-esfandiar.shinyapps.io/data-elites-learning-system/
  • 🔥 2
  • 💯 1
Post #215 413
📊 پنجشنبه‌های DE | دیتاست هفته
برای ساخت یک پروژه جذاب همیشه لازم نیست سراغ دیتاست‌های تکراری مثل Titanic و Iris بروی!
این هفته یک دیتاست واقعی و متفاوت از Epoch AI داریم که اطلاعات هزاران مدل هوش مصنوعی را در خودش نگه داشته؛ از زمان انتشار و شرکت سازنده تا اندازه مدل، قدرت محاسباتی و داده‌های آموزشی.
این دیتاست به چه درد می‌خورد؟ 👀
می‌توانی با آن بفهمی:
🔹 مدل‌های AI در سال‌های اخیر چقدر بزرگ‌تر شده‌اند
🔹 کدام شرکت‌ها و کشورها در رقابت هوش مصنوعی جلوترند
🔹 آیا مدل بزرگ‌تر همیشه عملکرد بهتری دارد؟
🔹 هزینه محاسباتی مدل‌ها با چه سرعتی افزایش پیدا کرده است
🔹 مسیر پیشرفت هوش مصنوعی در آینده به کدام سمت می‌رود
بعد هم نتیجه تحلیلت را به یک داشبورد Power BI، پروژه Python یا تحلیل R تبدیل کنی و داخل رزومه و GitHub قرار بدهی.
یعنی این فقط یک دیتاست نیست؛ یک موضوع آماده برای ساختن یک پروژه متفاوت و حرفه‌ای در حوزه AI است. 🚀
🔗 لینک دیتاست:
https://epoch.ai/data
Epoch AI Data on the Trajectory of AI Our public datasets catalog over 3200 machine learning models. Explore data and graphs showing the growth and trajectory of AI from 1950 to today.
  • ❤‍🔥 2
  • ❤ 1
  • 👍 1
  • 😍 1
Post #214 773
AI Engineer for Data Scientists Associate.rar113.6 MB
🚀 چهارشنبه‌های Data Elites؛ این بار با یک آموزش ویدیویی از یک پروژه واقعی!
آیا می‌توان فقط با بررسی رفتار کاربران در یک فروشگاه اینترنتی، پیش‌بینی کرد چه کسی در نهایت خرید می‌کند؟ 🛒
در این آموزش ویدیویی، زهرا اسفندیار پروژه‌ای را که برای آزمون عملی مسیر
AI Engineer for Data Scientists Associate در DataCamp انجام داده است، از ابتدا تا خروجی نهایی و کاملاً قدم‌به‌قدم پیاده‌سازی می‌کند.
در این پروژه یاد می‌گیریم:
🔹 داده‌ها را مستقیماً از GitHub بخوانیم
🔹 مقادیر گمشده و داده‌های نامعتبر را مدیریت کنیم
🔹 متغیرهای عددی و دسته‌ای را برای مدل آماده کنیم
🔹 یک شبکه عصبی با PyTorch بسازیم
🔹 مدل را آموزش دهیم و روند Loss را بررسی کنیم
🔹 احتمال خرید مشتریان جدید را پیش‌بینی کنیم
🔹 خروجی مدل را از نگاه فنی و کسب‌وکاری تحلیل کنیم
این پروژه فقط اجرای چند خط کد نیست؛ یک مسیر کامل از تعریف مسئله و داده خام تا ساخت مدل و پیش‌بینی نهایی است. 🔥
👩🏻‍💻 مدرس و توسعه‌دهنده پروژه: زهرا اسفندیار
💻 GitHub:
https://github.com/Zahra-Esfandiar/Project-AI-Engineer-for-Data-Scientists-Associate
  • ❤‍🔥 4
  • ❤ 2
  • 👏 2
Post #213 597
🎓 ارشد آمار؛ کدام مسیر برای تو ساخته شده؟
انتخاب گرایش ارشد فقط انتخاب چند واحد درسی نیست؛ انتخاب مسیری است که می‌تواند آینده تحصیلی، پژوهشی و شغلی تو را شکل دهد.
برای اینکه این انتخاب را با شناخت بیشتری انجام دهید، در سه وبینار تخصصی به سراغ سه مسیر مهم و جذاب رفتیم:
📐 آمار ریاضی با زهرا اسفندیار
برای علاقه‌مندان به مبانی عمیق آماری، استنباط، مدل‌سازی و مسیرهای پژوهشی

https://t.me/dataelites/58
💻 علم داده با علیرضا ایرانی
برای کسانی که می‌خواهند از دل داده‌ها، الگو، بینش و راه‌حل‌های هوشمند استخراج کنند

https://t.me/dataelites/61
📊 بیم‌سنجی با محراب عتیقی
برای علاقه‌مندان به تحلیل ریسک، احتمال، بیمه و تصمیم‌گیری در شرایط عدم‌قطعیت

https://t.me/dataelites/64

در این مجموعه تلاش کردیم درباره درس‌ها، مهارت‌های لازم، فضای تحصیل، مسیر شغلی و واقعیت‌های هر گرایش شفاف و کاربردی صحبت کنیم؛ تا انتخاب شما نه براساس اسم گرایش‌ها، بلکه براساس علاقه، توانمندی و آینده‌ای باشد که برای خودتان می‌سازید.
✨ سه وبینار، سه مسیر متفاوت و یک هدف مشترک:
انتخاب آگاهانه‌تر برای آینده‌ای که با داده ساخته می‌شود.
Telegram Data elites با سلام خدمت همه شما همراهان عزیز Data Elites😍 همونطوری که قول دادیم خدمتتون در اولین فرصت فیلم جلسه‌ی وبینار آشنایی با گرایش آمار ریاضی رو قرار دادیم. همچنین برای دوستانی که شاید برای دانلود کردنش مشکل داشته باشند در کانال آپاراتمون قرار دادیم که اینجا…
  • ❤ 1
  • 🔥 1
  • 🥰 1
Post #212 400
DEfraud_detection_tutorial.rar199.7 KB
💳 وقتی ۹۹٪ Accuracy یعنی شکست کامل!
در اولین پست سه‌شنبه‌های AI Explained می‌ریم سراغ یکی از واقعی‌ترین کاربردهای هوش مصنوعی: تشخیص تقلب در تراکنش‌های بانکی.
در این آموزش می‌بینیم چرا Accuracy در داده‌های نامتوازن گمراه‌کننده است، مدل چطور Risk Score می‌سازد و نقش Precision، Recall، Threshold و Data Leakage چیست!!
همراه پست، دیتاست، کد Python، منابع و توضیحات کامل فارسی هم قرار می‌دیم تا پروژه رو خودتون اجرا و تحلیل کنید. 🚀
AI فقط تولید متن و تصویر نیست؛ گاهی باید میان هزاران تراکنش، همان چند مورد مشکوک را پیدا کند
  • ❤ 3
  • 🔥 2
  • 👎 1
  • 😍 1
Post #211 653
Catherine_Nelson_Software_Engineering_for_Data_Scientists_From_Notebooks.pdf6.5 MB
📘 دوشنبه‌های Data Elites؛ وقتی یک Notebook دیگر کافی نیست!
خیلی‌ها در پروژه های مختلف حوزه یادگیری ماشین می‌توانند مدل بسازند؛
اما تعداد خیلی کمتری می‌توانند همان مدل را به یک سیستم واقعی، قابل‌اعتماد و مقیاس‌پذیر تبدیل کنند.
کتاب Software Engineering for Data Scientists دقیقاً درباره همین فاصله است؛ فاصله میان یک کد آزمایشی داخل Jupyter Notebook و محصولی که بتوان آن را تست کرد، توسعه داد، نگهداری کرد و در دنیای واقعی به کار گرفت.
در این کتاب یاد می‌گیرید چطور:
🔹 کدهای Python را تمیز و ساختاریافته بنویسید
🔹 پروژه‌ها را تست، Debug و Refactor کنید
🔹 از Git، Logging و Type Checking اصولی استفاده کنید
🔹 با FastAPI، Docker و GitHub Actions کار کنید
🔹 Notebookهای پراکنده را به سیستم‌های قابل‌توسعه تبدیل کنید
این کتاب فقط درباره برنامه‌نویسی بهتر نیست؛
درباره تبدیل‌شدن از کسی است که «فقط مدل می‌سازد» به کسی که می‌تواند یک محصول داده‌ای واقعی بسازد.
📖 Software Engineering for Data Scientists: From Notebooks to Scalable Systems
کدی می‌نویسد که قابل‌اعتماد، قابل‌تکرار و آماده استفاده در دنیای واقعی باشد. 🚀
  • 😍 2
  • ❤ 1
  • 🥰 1
Post #209 409
1_یادآوری مفاهیم پایه.zip1.1 GB 2_الگوریتم_های_محاسبات_ماتریسی_و_کاربردها.zip1.9 GB
📐 یکشنبه‌مون را با یکی از مهم‌ترین پایه‌های Data و AI شروع می‌کنیم: جبر خطی!
از رگرسیون و شبکه‌های عصبی تا PCA، SVD، K-Means و پردازش تصویر، تقریباً همه‌جا با بردارها و ماتریس‌ها سروکار داریم. برای همین، امروز دو دوره کامل و رایگان فارسی و انگلیسی معرفی می‌کنیم:

✅ جبر خطی کاربردی — دکتر مجتبی تفاق، استاد دانشگاه صنعتی شریف( دانشگاه صنعتی آریا مهر)
دوره‌ای دانشگاهی با رویکرد محاسباتی و پیاده‌سازی در Julia؛ شامل دستگاه‌های خطی، QR و LU، مقادیر ویژه، Least Squares، Regularization، K-Means، PageRank، SVD و PCA

🇬🇧 Applied Linear Algebra in Data Analysis — ALADA 2025

دوره‌ای کاربردی همراه با ویدئو، تمرین، دیتاست و Notebookهای Python؛ مناسب برای تثبیت مفاهیم و دیدن کاربرد جبر خطی در تحلیل داده
🔗 ویدئوهای دوره:

https://www.youtube.com/playlist?list=PL8eY_HDc45x9AzRiRyL3Bl838yLd-vOmx
🔗 جزوه‌ها و کدها:

http://github.com/siva82kb/ALADA-Course

🚨 بدون جبر خطی می‌توان کد اجرا کرد؛ اما فهمیدن اینکه مدل واقعاً چه کاری انجام می‌دهد، بسیار سخت‌تر است

📚 یکشنبه‌های Data Elites؛ معرفی منابعی که واقعاً ارزش یادگیری دارند. 🚀
  • ❤‍🔥 3
  • 🔥 2
Post #208 650
2607.28432v1.pdf3.5 MB
📄 شنبه‌های Data Elites را با معرفی یک مقاله تازه شروع می‌کنیم!
🚨 بعد از ChatGPT برای متن، آیا حالا نوبت ChatGPT برای عددهاست؟
پژوهشگران در مقاله‌ای جدید، مدلی به نام UNICON معرفی کرده‌اند؛ یک Foundation Model که به‌جای تمرکز بر کلمات، تلاش می‌کند روابط پنهان میان داده‌های عددی را یاد بگیرد.
این مدل می‌تواند از داده‌های آماری، زیستی، اقلیمی و اقتصادی الگو استخراج کند و حتی دانشی را که در یک حوزه آموخته، به حوزه‌ای دیگر منتقل کند.
شاید نسل بعدی AI فقط بهتر حرف نزند؛
بلکه بتواند از دل عددها، قوانین پنهان جهان را کشف کند. 🔢🚀
📄 A Foundation Model of Numerical Intelligence with Cross-Disciplinary
Generalization

همراه ما در فضای مجازی باشید 🫶

Telegram
Instagram
  • 👏 3
  • 🫡 2
  • 👍 1
Post #206 626
🚀 مسیر درست یادگیری علم داده و هوش مصنوعی، از آمار می‌گذرد
یادگیری حوزه‌هایی مثل هوش مصنوعی، علم داده و Machine Learning فقط با دنبال کردن مطالب پراکنده اتفاق نمی‌افتد؛ برای ساختن یک مسیر حرفه‌ای، نیاز به پایه قوی، نظم، استمرار و انتخاب منابع درست داریم.
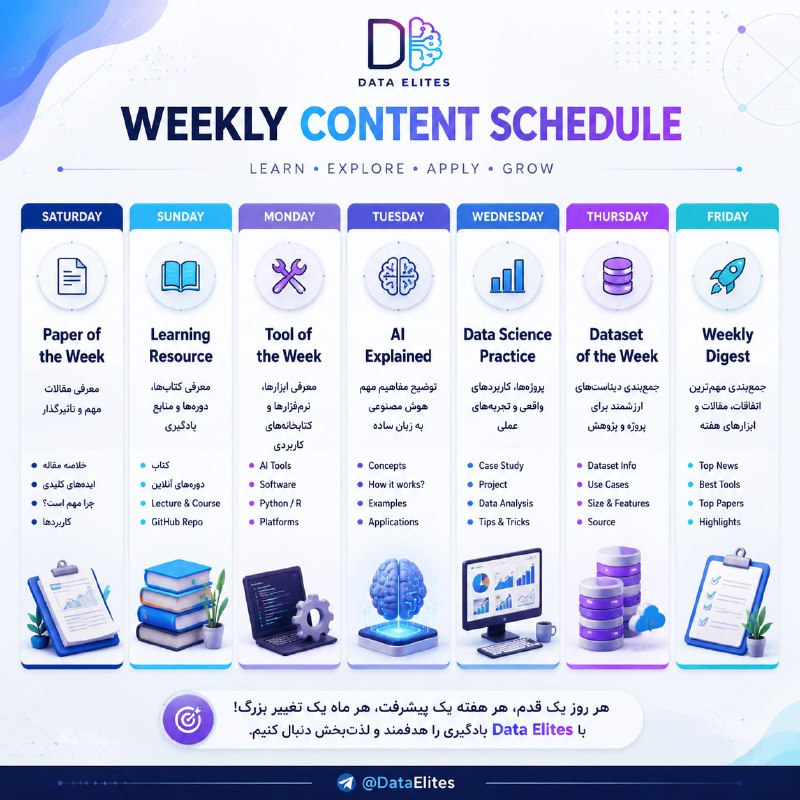
از این هفته در Data Elites تلاش می‌کنیم محتواها را منظم‌تر و هدفمندتر منتشر کنیم تا هر روز با یک موضوع مشخص، قدمی در مسیر یادگیری دنیای داده و AI برداریم.
در این مسیر با هم سراغ:
🔹 مفاهیم پایه و عمیق آمار و داده
🔹 ایده‌ها و پژوهش‌های جدید AI
🔹 ابزارهای کاربردی Data Science
🔹 پروژه‌ها و تجربه‌های عملی
🔹 منابع ارزشمند یادگیری
خواهیم رفت.
هدف ما ساختن یک مسیر یادگیری کاربردی، عمیق و به‌روز است؛ مسیری که از اصول آماری شروع می‌شود و تا جدیدترین تکنولوژی‌های هوش مصنوعی ادامه پیدا می‌کند.
با Data Elites همراه باشید. 🚀
  • 🔥 2
  • 👍 1
  • 👏 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →