TGViewer
Channel Public Channel
Data elites

Data elites

@dataelites

📉 به نام خالق داده و الگوریتم📈
😁ما یه تیم خوش ذوق و خلاق از دانشجوهای آماری هستیم😁
ورودتون به دنیای علم داده رو خوش آمد میگیم😇
برای ارتباط با ادمین به آی دی زیر پیام بدید
@dataelite
ارتباط با پیام داخلی کانال:
https://t.me/dataelites?direct
Subscribers
1.38K
Photos
27
Videos
12
Links
128

Showing posts older than #206 · Back to latest

Older Posts 20 shown
Post #205 797
Data Elites Dataset Handbook 2026.pdf171.1 KB
📂 بهترین منابع دیتاست، یک‌جا جمع شده‌اند!
یکی از اولین چالش‌های هر پروژه Data Science و هوش مصنوعی پیدا کردن دیتاست مناسب، معتبر و قابل اعتماد است.
برای همین یک Dataset Resource Handbook آماده کردیم؛ مجموعه‌ای از مهم‌ترین منابع داده برای:
🤖 AI و Machine Learning
🏥 Healthcare و Bioinformatics
🔬 Research و Open Science
🌍 Public و Economic Data
⚙️ Data Engineering و MLOps
از دیتاست‌های آموزشی و پژوهشی تا منابع عظیم مورد استفاده در توسعه مدل‌های مدرن هوش مصنوعی؛ همه را در یک مرجع کاربردی جمع‌آوری کردیم.
  • ❤‍🔥 3
  • ❤ 1
  • 🔥 1
Post #204 1.62K
🛡️ دو ابزار مهم برای کنترل ورودی داده در Python و R

گاهی داده‌ای که از API، فایل، کاربر یا حتی یک مدل هوش مصنوعی می‌گیریم، اشتباه یا ناقص است.
Pydantic در Python و checkmate در R قبل از اجرای تحلیل بررسی می‌کنند که نوع
داده، مقدارها و ساختار ورودی درست باشند.

🐍 Pydantic در Python

from pydantic import BaseModel, Field

class ModelInput(BaseModel):
age: int = Field(ge=18)
probability: float = Field(ge=0, le=1)

data = ModelInput(age=25, probability=0.8)


اگر سن منفی یا احتمال بیشتر از ۱ باشد، خطا می‌دهد.
کاربردها:
کنترل ورودی مدل‌های Machine Learning
اعتبارسنجی JSON و API
بررسی خروجی LLMها
کنترل فرمان‌های AI Agent قبل از اجرا

📊 checkmate در R

library(checkmate)

run_model <- function(data, target) {
assert_data_frame(data)
assert_choice(target, names(data))

summary(data[[target]])
}

اگر ورودی Data Frame نباشد یا ستون انتخاب‌شده وجود نداشته باشد، اجرای تابع متوقف می‌شود.
کاربردها:
کنترل ورودی توابع تحلیلی
جلوگیری از اجرای مدل با داده خراب
اعتبارسنجی Pipelineهای علم داده
کنترل ابزارهای AI Agent در R
در یک جمله:
Pydantic و checkmate مدل هوش مصنوعی نمی‌سازند؛
مطمئن می‌شوند داده درست وارد مدل شود.
🔗 Pydantic: https://docs.pydantic.dev/⁠�
🔗 checkmate: https://mllg.github.io/checkmate/⁠�
Pydantic Docs Documentation for the Pydantic stack. Validate data with Pydantic Validation, build production AI agents with Pydantic AI, and monitor LLM calls, agent behavior, and costs with Pydantic Logfire.
  • 🤩 2
  • 🥴 1
Post #201 624
📚 معرفی دو دوره رایگان و کامل «فرایندهای تصادفی»

فرایندهای تصادفی همیشه یکی از درس‌های موردعلاقه من بوده😍؛ چون احتمال، آمار و مدل‌سازی پدیده‌هایی را به هم متصل می‌کند که در طول زمان و تحت تأثیر عدم‌قطعیت تغییر می‌کنند. 😍
اگر دوست دارید این درس جذاب را به زبان فارسی یاد بگیرید، این دو دوره ارزشمند را از دست ندهید:
🔹 فرایندهای تصادفی — دکتر کسری علیشاهی
یک دوره دانشگاهی و نسبتاً نظری از دانشگاه صنعتی شریف که مفاهیم را با دقت ریاضی و توجه به تعریف‌ها، قضایا و استدلال‌های احتمالاتی آموزش می‌دهد.
در این دوره با مباحثی مانند فرایندهای تصادفی زمان‌گسسته و زمان‌پیوسته، امید شرطی، زنجیره‌های مارکوف، فرایند پواسون، زمان‌های توقف و رفتار بلندمدت فرایندها آشنا می‌شوید.
این دوره برای دانشجویان آمار، ریاضی و افرادی که به یادگیری عمیق و اثبات‌محور علاقه دارند، انتخاب بسیار خوبی است.
🔗 مشاهده دوره:
http://videos.math.sharif.ir/courses.php?course=stochastic_processes-spring94
🔹 فرایندهای تصادفی — دکتر عرفان صلواتی
دوره‌ای مفهومی‌تر و مسئله‌محور که تلاش می‌کند مفاهیم فرایندهای تصادفی را با مثال، حل مسئله و شهود ریاضی توضیح دهد.
این مجموعه مباحثی مانند قدم‌زدن تصادفی، فرایند پواسون، افراز و ترکیب فرایندهای پواسون، زنجیره‌های مارکوف، زنجیره مارکوف زمان‌پیوسته، تعادل و شبیه‌سازی فرایندها را پوشش می‌دهد.
بیان روان و ساختار منظم این دوره باعث شده برای شروع یادگیری و مطالعه خودآموز گزینه بسیار مناسبی باشد.
🔗 مشاهده پلی‌لیست:
https://www.aparat.com/playlist/859160


✅اگر تازه می‌خواهید این درس را شروع کنید، دوره دکتر صلواتی می‌تواند مسیر روان‌تری باشد؛ اما برای یادگیری عمیق‌تر و تقویت پایه نظری، دوره دکتر علیشاهی انتخاب بسیار ارزشمندی است.
فرایندهای تصادفی پایه بسیاری از موضوعات مهم مثل تحلیل بقا، سری‌های زمانی، مدل‌های مارکوف، صف، قابلیت اطمینان، ریاضیات مالی و مدل‌سازی رخدادهای تصادفی است. 🚀
  • ❤‍🔥 5
  • 👍 1
  • 👎 1
Post #200 414
📚 بهترین کتاب‌های رایگان برای یادگیری تحلیل داده‌های زیستی با R
اگر کتاب R for Data Science را دوست دارید اما می‌خواهید تحلیل داده را در فضای Bioinformatics، Computational Biology، Genomics و داده‌های زیستی یاد بگیرید، این منابع را ذخیره کنید! 🧬📊

1️⃣ R for Bio Data Science

نزدیک‌ترین منبع به R for Data Science در حوزه داده‌های زیستی است.
در این کتاب با رویکردی کاملاً عملی، موضوعاتی مثل موارد زیر را یاد می‌گیرید:
✅ پاک‌سازی و آماده‌سازی داده‌ها با tidyverse
✅ مصورسازی با ggplot2
✅ تحلیل اکتشافی داده‌ها
✅ مدل‌سازی آماری و Machine Learning
✅ برنامه‌نویسی تابعی
✅ Git و GitHub
✅ گزارش‌سازی بازتولیدپذیر
✅ ساخت R Package و Shiny App
📖 کتاب آنلاین:
https://r4bds.github.io/

2️⃣ Modern Statistics for Modern Biology

یکی از بهترین منابع برای یادگیری آمار مدرن در علوم زیستی است.
این کتاب نوشته‌ی Susan Holmes و Wolfgang Huber بوده و مفاهیم آماری را با کدهای R و داده‌های واقعی زیستی آموزش می‌دهد.
موضوعات مهم آن شامل:
📊 مصورسازی داده‌های زیستی
🧬 تحلیل داده‌های ژنومی
🔍 PCA و کاهش بُعد
🧩 خوشه‌بندی
🧪 آزمون فرض و Multiple Testing
🤖 یادگیری نظارت‌شده
🌐 شبکه‌ها و ساختارهای زیستی
📖 مطالعه رایگان کتاب:
https://www.huber.embl.de/msmb/

3️⃣ Orchestrating Single-Cell Analysis with Bioconductor

اگر به تحلیل داده‌های Single-cell RNA sequencing علاقه دارید، این کتاب یکی از کامل‌ترین منابع موجود است.
در این کتاب یک Workflow کامل تحلیل Single-cell با R و Bioconductor آموزش داده می‌شود:
🔬 Quality Control
📏 Normalization
📉 PCA، t-SNE و UMAP
🧩 Clustering
🧬 شناسایی Marker Geneها
🏷️ تشخیص نوع سلول
⚖️ Batch Correction
📊 Differential Expression
🧪 تحلیل چندنمونه‌ای
📖 کتاب آنلاین:
https://bioconductor.org/books/devel/OSCA/

4️⃣ Biological Data Science with R

این کتاب برای افرادی مناسب است که می‌خواهند اصول Data Science را با مثال‌های واقعی زیستی یاد بگیرند.
موضوعات آن شامل:
✅ مدیریت و پاک‌سازی داده‌ها
✅ تحلیل داده‌های ژنومی
✅ مصورسازی اطلاعات زیستی
✅ آمار کاربردی
✅ کار با داده‌های توالی‌یابی
✅ ساخت Workflowهای بازتولیدپذیر
📖 مطالعه رایگان:
https://bdsr.stephenturner.us/

5️⃣ R Programming for Bioinformatics

این کتاب توسط Robert Gentleman، یکی از بنیان‌گذاران پروژه Bioconductor نوشته شده است.
تمرکز اصلی آن روی برنامه‌نویسی حرفه‌ای R برای Bioinformatics است:
💻 ساختارهای داده در R
🧬 پردازش داده‌های ژنومی
📦 سیستم‌های شی‌گرایی R
🔧 طراحی توابع و ابزارهای تحلیلی
🏷️ مدیریت Annotation و Metadata
📚 آشنایی عمیق‌تر با ساختار Bioconductor
این کتاب قدیمی‌تر از منابع دیگر است، اما همچنان برای فهم پایه‌های برنامه‌نویسی Bioinformatics ارزشمند است.
📖 صفحه رسمی کتاب:
https://www.bioconductor.org/help/publications/books/r-programming-for-bioinformatics/

6️⃣ مجموعه کتاب‌های رسمی Bioconductor

Bioconductor مجموعه‌ای بزرگ از کتاب‌های رایگان و تخصصی برای تحلیل داده‌های زیستی دارد.
در این مجموعه می‌توانید منابع مربوط به موضوعات زیر را پیدا کنید:
🧬 Single-cell RNA-seq
🗺️ Spatial Transcriptomics
🦠 Microbiome Analysis
⚗️ Metabolomics
🔬 Mass Spectrometry و Proteomics
🧩 Hi-C و ساختار کروماتین
📊 Genomics و Transcriptomics
📚 فهرست کامل کتاب‌ها:
https://bioconductor.org/help/bioconductor-books/
🎯 از کدام کتاب شروع کنیم؟
اگر به‌تازگی وارد این حوزه شده‌اید:

R for Bio Data Science

Modern Statistics for Modern Biology

یکی از کتاب‌های تخصصی Bioconductor بر اساس حوزه موردعلاقه

اگر هدفتان تحلیل Single-cell است، مستقیماً بعد از یادگیری مقدمات R سراغ کتاب OSCA بروید.
به زبان ساده، این مجموعه منابع می‌تواند مسیر شما را از:
کار با داده‌های معمولی در R
به:
تحلیل داده‌های ژنومی، زیستی و Omics
تبدیل کند. 🚀🧬
Modern Statistics for Modern Biology If you are a biologist and want to get the best out of the powerful methods of modern computational statistics, this is your book.
  • 👏 3
  • 👎 1
  • 🔥 1
Post #199 488
🚨 داری برای Claude و Codex پول OCR می‌دی، بدون اینکه بفهمی!

وقتی یک PDF شلوغ یا اسکن‌شده را مستقیم وارد مدل می‌کنی، بخش زیادی از توکن و Context صرف خواندن تصویر، جدول و ترتیب صفحات می‌شود.

Unlimited-OCR از Baidu این کار را قبل از مدل انجام می‌دهد:

📄 PDF خام
⬇️
⚡ متن و Markdown ساختاریافته
⬇️
🤖 ارسال فقط بخش‌های مهم به Claude یا Codex

نتیجه:

✅ توکن و هزینه کمتر
✅ پاسخ سریع‌تر
✅ Context بیشتر برای تحلیل واقعی
✅ مناسب برای RAG، Agentها و اسناد طولانی

این مدل متن، جدول، فرمول و ترتیب خواندن ده‌ها صفحه را یک‌جا استخراج می‌کند؛ یعنی به‌جای خفه‌کردن مدل با فایل خام، فقط اطلاعات ارزشمند را به آن می‌دهیم.

🔗 GitHub:
https://github.com/baidu/Unlimited-OCR

📄 Paper:
https://arxiv.org/abs/2606.23050
  • ❤ 4
Post #197 821
🌐 اینترنت قطع شد؛ یعنی هوش مصنوعی هم از کار می‌افتد؟
شاید اولین چیزی که به ذهنتان برسد، از دسترس خارج شدن ChatGPT، Claude و Gemini باشد. اما واقعیت این است که بسیاری از مدل‌های هوش مصنوعی را می‌توان کاملاً آفلاین روی کامپیوتر شخصی اجرا کرد.
اگر مدل را از قبل دانلود کرده باشید، حتی بدون اینترنت هم می‌توانید از آن برای برنامه‌نویسی، تحلیل داده، تولید محتوا و بسیاری از کارهای دیگر استفاده کنید.
در این پست با چند مدل محبوب Local AI آشنا می‌شویم:
🦙 Llama 3.3 – گفتگو، تحلیل داده و برنامه‌نویسی
⚡️ Qwen 3 – Coding، Data Science و استدلال
💎 Gemma 3 – تولید محتوا و توسعه نرم‌افزار
🧠 Mistral 7B – سبک، سریع و مناسب استفاده روزمره
🚀 DeepSeek-R1 Distill – استدلال، ریاضیات و حل مسائل پیچیده
💻 Code Llama – یکی از بهترین مدل‌های متن‌باز برای برنامه‌نویسی
همچنین با ابزارهایی مانند Ollama، LM Studio، Jan AI و Open WebUI می‌توانید این مدل‌ها را به‌سادگی روی سیستم خود اجرا کنید.
✅ بدون نیاز به اینترنت
✅ حفظ حریم خصوصی داده‌ها
✅ بدون هزینه API
  • ❤‍🔥 2
Post #196 600
Ai-chapter 1.pdf95.4 KB
🚀 یک خبر جذاب برای همراهان Data Elites
از امروز مجموعه آموزش‌های هوش مصنوعی را به‌صورت مرحله‌به‌مرحله و رایگان در قالب اسلاید شروع می‌کنیم.
در این مسیر، مفاهیم AI را از پایه با رویکرد آماری، علمی و عملی بررسی می‌کنیم؛ از یادگیری ماشین و آمار موردنیاز آن تا شبکه‌های عصبی، LLMها، RAG، Agentها و پیاده‌سازی پروژه‌ها با Python,R.
هدف ما فقط یاد دادن ابزارها نیست؛ می‌خواهیم دقیق بفهمیم پشت هر مدل چه اتفاقی می‌افتد و چرا کار می‌کند.
💙 این تازه شروع مسیر است.
هوش مصنوعی را عمیق، کاربردی و با نگاه آماری در Data Elites یاد می‌گیریم.

یادتون نره این پست برای کسایی میخوان این مسیر، درست شروع کنند بفرستید 🤗
  • 🔥 4
  • 👍 2
  • 🎉 1
Post #194 541
🚀 وقتشه ARIMA و Prophet تنها گزینه‌های Forecasting نباشن!

سال‌هاست که وقتی صحبت از پیش‌بینی سری‌های زمانی (Time Series Forecasting) می‌شود، اولین ابزارهایی که به ذهن می‌رسند ARIMA و Prophet هستند.

اما دنیای هوش مصنوعی این حوزه را هم متحول کرده است.

امروزه مدل‌هایی توسعه یافته‌اند که روی میلیاردها نقطه داده آموزش دیده‌اند و بدون نیاز به آموزش مجدد روی داده‌های شما (Zero-shot Forecasting) می‌توانند پیش‌بینی انجام دهند. این مدل‌ها با عنوان Time Series Foundation Models (TSFMs) شناخته می‌شوند و نسل جدید Forecasting را شکل داده‌اند.

در ادامه با ۷ ابزار مهم این حوزه آشنا شوید:

🔹 1. Chronos (Amazon)

مدل پایه آمازون برای Forecasting که از داده‌های تک‌متغیره، چندمتغیره و متغیرهای کمکی پشتیبانی می‌کند و برای استفاده در محیط‌های Production طراحی شده است.

🔗 GitHub:
https://github.com/amazon-science/chronos-forecasting.git

🔹 2. TimesFM (Google)

مدل Foundation گوگل برای پیش‌بینی سری‌های زمانی که با BigQuery ML، Vertex AI و حتی Google Sheets نیز یکپارچه شده است.

🔗 GitHub:
https://github.com/google-research/timesfm.git

🔹 3. TimeGPT (Nixtla)

یکی از محبوب‌ترین ابزارهای Forecasting که علاوه بر پیش‌بینی، تشخیص ناهنجاری (Anomaly Detection)، Fine-Tuning و استفاده از متغیرهای خارجی را نیز پشتیبانی می‌کند.

🔗 وب‌سایت:
https://www.nixtla.io/

🔹 4. Moirai (Salesforce)

یک Transformer متن‌باز برای Forecasting که هم به‌صورت Zero-shot و هم با آموزش روی داده‌های اختصاصی قابل استفاده است.

🔗 GitHub:
https://github.com/SalesforceAIResearch/uni2ts.git

🔹 5. MOMENT (Carnegie Mellon University)

یک Foundation Model چندمنظوره که علاوه بر Forecasting، برای Classification، Anomaly Detection و Imputation نیز کاربرد دارد.

🔗 GitHub:
https://github.com/moment-timeseries-foundation-model/moment.git

🔹 6. numpyro_forecast

اگر به مدل‌های Bayesian علاقه دارید، این کتابخانه امکان تولید پیش‌بینی‌های احتمالاتی همراه با عدم قطعیت (Uncertainty) را فراهم می‌کند.

🔗 GitHub:
https://github.com/pyro-ppl/numpyro.git

🔹 7. skforecast-ai

یک دستیار هوشمند برای Forecasting که داده شما را تحلیل می‌کند، مناسب‌ترین مدل را انتخاب می‌کند و حتی کد آماده اجرا را تولید می‌کند.

🔗 وب‌سایت:
https://skforecast.org/latest/

💡 نکته مهم

همان‌طور که LLMها دنیای پردازش زبان را متحول کردند، Foundation Modelهای سری زمانی نیز در حال تغییر آینده Forecasting هستند. این مدل‌ها هزینه توسعه مدل‌های اختصاصی را کاهش می‌دهند و در بسیاری از مسائل، بدون آموزش مجدد عملکرد بسیار خوبی ارائه می‌کنند. البته هنوز در برخی کاربردهای خاص، مدل‌های سنتی یا مدل‌های آموزش‌دیده روی داده اختصاصی می‌توانند عملکرد بهتری داشته باشند

📌 این پست را ذخیره کنید؛ احتمال زیادی دارد در پروژه بعدی‌تان به یکی از این ابزارها نیاز داشته باشید.
GitHub GitHub - amazon-science/chronos-forecasting: Chronos: Pretrained Models for Time Series Forecasting Chronos: Pretrained Models for Time Series Forecasting - amazon-science/chronos-forecasting
  • 🔥 3
  • ❤ 2
  • ❤‍🔥 1
Post #193 1.8K
🎓 یادگیری Machine Learning نباید هزینه زیادی داشته باشه!
اگر قصد ورود به دنیای Machine Learning رو دارید، لازم نیست حتماً سراغ دوره‌های چند میلیون تومانی برید.
خبر خوب اینه که اساتید برجسته دانشگاه‌های ایران و حتی پژوهشگران دانشگاه‌های معتبر دنیا، سال‌هاست آموزش‌های باکیفیت و کاملاً رایگان در این حوزه منتشر کرده‌اند.
در این پست، مجموعه‌ای از بهترین دوره‌های فارسی یادگیری ماشین را یکجا جمع‌آوری کرده‌ایم؛ از آموزش مفاهیم پایه تا مباحث پیشرفته، توسط اساتیدی از دانشگاه‌هایی مانند:

🎓 دانشگاه تهران
🎓 دانشگاه صنعتی شریف
🎓 دانشگاه شهید بهشتی
🎓 دانشگاه امیرکبیر
🎓 دانشگاه علم و صنعت
🎓 دانشگاه فردوسی مشهد
🎓 دانشگاه صنعتی اصفهان
🎓 دانشگاه تبریز

و همچنین اساتید ایرانی دانشگاه‌های معتبر بین‌المللی مانند:

🌍 University of Manitoba
🌍 University of Waterloo

علاوه بر دوره‌های Machine Learning، آموزش‌های ارزشمند دیگری نیز در زمینه‌های:

🤖 هوش مصنوعی (AI)
🧠 مدل‌های بزرگ زبانی (LLMs)
🎯 یادگیری تقویتی عمیق (Deep Reinforcement Learning)
📊 تئوری یادگیری ماشین
📈 تشخیص الگو (Pattern Recognition)
📉 استنباط آماری
🕸️ نظریه گراف
💰 مقدمه‌ای بر رمزارزها

نیز در این مجموعه قرار گرفته‌اند.

📌 اگر به دنبال یک مسیر یادگیری منظم و رایگان هستید، این پست را حتماً ذخیره کنید؛ احتمالاً تا مدت‌ها به آن نیاز خواهید داشت.

✅ دوره کوتاه مدت یادگیری ماشین دانشگاه الزهرا تهران ( اساتید دوره:
🔰آقای دکتر محمد جعفری جوزانی دانشگاه Manitoba کانادا
🔰دکتر عبدالله صفری دانشگاه تهران
🔰دکتر رضا رمضان دانشگاه Waterloo کانادا )

لینک دوره
✅دکتر حامد ملک دانشگاه شهید بهشتی تهران
لینک دوره
✅دکتر محمد حسین رهبان دانشگاه شریف
لینک دوره
✅دکتر مهدیه سلیمانی مرکز درس افزار شریف
لینک دوره
✅دکتر صادق رئیسی دانشگاه شریف
لینک دوره
✅دکترسعید شیری دانشگاه امیرکبیر، آموزش ها بر اساس کتاب Machine learning by Tom Mitchell
لینک دوره
✅دکتر احسان ناظر فرد دانشگاه امیرکبیر
لینک دوره
✅دکتر محمدرضا محمدی دانشگاه علم و صنعت
لینک دوره
✅دکتر مهران صفایانی دانشگاه صنعتی اصفهان
لینک دوره
✅دکتر سید ناصر رضوی دانشگاه تبریز
لینک دوره
لینک دوره
✅دکتر رضا منصفی دانشگاه فردوسی مشهد
لینک دوره
✅دکتر احمد محمودی دانشگاه شهید بهشتی
لینک دوره
لینک دوره
✅آقای جواد وحید دستجردی بر اساس دوره ML آقای Andrew Ng
لینک دوره
✅محمدعلی کیوان راد دکتری دانشگاه امیرکبیر
لینک دوره

دکتر رهبان؛
هوش مصنوعی
مدل‌های بزرگ زبانی (سایت درس)
یادگیری تقویتی عمیق (بهار ۱۴۰۴)

دکتر بهرک:
استنباط آماری
مقدمه ای بر رمزارز ها
نظریه گراف

دکتر مداح‌علی:
تئوری یادگیری ماشین

دکتر فاطمی‌ زاده:
تشخیص الگو

📢 اگر به دنبال آموزش یا دوره رایگان در حوزه خاصی هستید (مثل Deep Learning، Computer Vision، NLP، آمار، Python، R، SQL، MLOps، AI Agent، LLM، Data Engineering و ...)، حتماً به ما بگویید.

ما سعی می‌کنیم بهترین دوره‌های رایگان فارسی و انگلیسی آن حوزه را جمع‌آوری و در قالب یک پست کامل معرفی کنیم. 🚀❤️
Telegram Data elites سلام به همراهان عزیز Data Elites😍😍 در این پُست قصد داریم که، ⭕️ ویدئو ضبط شده دوره کوتاه مدت یادگیری‌ماشین رو باهاتون به اشتراک بگذاریم. 🔸🔷🔸 برگزار کننده‌ی دوره: گروه آمار دانشکده علوم ریاضی دانشگاه الزهرا تهران با همکاری انجمن آمار ایران ♦️ استاد میزبان:…
  • 🥰 2
  • ❤ 1
  • 👏 1
Post #192 460
🚀 معرفی SurvSure | یک دستیار هوشمند برای تحلیل بقا (Survival Analysis)

اگر تا به حال با مدل‌های Survival Analysis کار کرده باشید، احتمالاً می‌دانید که قبل از تفسیر نتایج، باید مجموعه‌ای از فرضیات و آزمون‌های مختلف را بررسی کنید؛ از آزمون Proportional Hazards گرفته تا ارزیابی کیفیت مدل، بررسی فرم تابع متغیرها و حتی انتخاب مناسب‌ترین مدل.

به همین دلیل تصمیم گرفتیم SurvSure را توسعه دهیم.

SurvSure یک اپلیکیشن تعاملی مبتنی برR Shiny است که فرآیند تحلیل بقا را در یک محیط گرافیکی، ساده و کاربردی انجام می‌دهد و بسیاری از مراحل زمان‌بر تحلیل را به‌صورت خودکار در اختیار پژوهشگران قرار می‌دهد.

✨ قابلیت‌های نسخه فعلی

🔹 بارگذاری مستقیم فایل‌های CSV و Excel
🔹 برازش مدل Cox Proportional Hazards
🔹 بررسی فرض Proportional Hazards با استفاده از Schoenfeld Residuals
🔹 بررسی Functional Form برای متغیرهای پیوسته
🔹 بررسی Multicollinearity (VIF)
🔹 شناسایی مشاهدات اثرگذار (Influential Observations)
🔹 ارزیابی عملکرد مدل (C-index و سایر شاخص‌ها)
🔹 مقایسه مدل‌های مختلف تحلیل بقا
🔹Recommendation Engine برای پیشنهاد خودکار مناسب‌ترین مدل بر اساس نتایج آزمون‌ها
🔹 تحلیل Recurrent Event Data با مدل‌هایی مانند Andersen–Gill، PWP و Shared Frailty
🔹 تحلیل Competing Risks با مدل‌های Cause-Specific Cox و Fine–Gray و محاسبه CIF و Gray's Test
🔹 تولید گزارش و خروجی قابل دانلود

🌐 نسخه آنلاین برنامه:

https://wero8m-zahra-esfandiar.shinyapps.io/survsure/
💙 هدف از توسعه SurvSure، فراهم کردن یک ابزار جامع برای تحلیل بقا است تا پژوهشگران، دانشجویان و متخصصان آمار، اپیدمیولوژی، علوم پزشکی و علوم داده بتوانند بدون درگیر شدن با پیچیدگی‌های برنامه‌نویسی، تحلیل‌های پیشرفته Survival Analysis را انجام دهند.

منتظر نظرات و پیشنهادهای شما برای توسعه نسخه‌های بعدی هستیم. 🚀
  • 😍 2
  • 👏 1
Post #191 559
Machine_Learning_in_Modeling_and_Simulation_Bernhard_Schmidt_z_library.pdf12.8 MB
📚 معرفی کتاب | Machine Learning in Modeling and Simulation: Methods and Applications
اگر تصور می‌کنید Machine Learning فقط به طبقه‌بندی تصاویر یا پیش‌بینی داده‌ها محدود می‌شود، این کتاب دیدگاه متفاوتی به شما خواهد داد.

Machine Learning in Modeling and Simulation به بررسی این موضوع می‌پردازد که چگونه می‌توان از الگوریتم‌های یادگیری ماشین برای ساخت، بهبود و تسریع مدل‌های شبیه‌سازی استفاده کرد. امروزه در بسیاری از حوزه‌ها، از مهندسی و علوم پزشکی گرفته تا سیستم‌های مالی، حمل‌ونقل و تولید، شبیه‌سازی نقش مهمی در تحلیل و تصمیم‌گیری دارد و یادگیری ماشین توانسته این فرآیندها را هوشمندتر، سریع‌تر و دقیق‌تر کند.

در این کتاب با موضوعاتی مانند:

🔹 ترکیب الگوریتم‌های Machine Learning با روش‌های شبیه‌سازی
🔹 ساخت مدل‌های پیش‌بینی برای سیستم‌های پیچیده
🔹 کاربردهای عملی در مهندسی، صنعت، سلامت، انرژی و علوم مختلف
🔹 بررسی روش‌های نوین برای تحلیل داده‌های حاصل از شبیه‌سازی

آشنا خواهید شد.
  • ❤ 2
  • 🎉 2
  • 🔥 1
Post #190 637
😒 فعلاً که با دنیا قهریم...

اگر موقع نصب پکیج‌های R مدام با کندی دانلود یا Error مواجه می‌شید، احتمالاً مشکل از کد شما نیست!

یکی از راه‌حل‌های ساده، تغییر مخزن پیش‌فرض CRAN به آینه دانشگاه فردوسی مشهده که معمولاً دسترسی بهتری از داخل ایران داره.

کافیه قبل از نصب پکیج‌ها، این کد رو اجرا کنید:

options(
repos = c(CRAN = "https://cran.um.ac.ir"),
download.file.method = "wininet"

)

حالا می‌تونید پکیج موردنظرتون رو نصب کنید:

install.packages("package_name", dependencies = TRUE)

📌 با قرار دادن dependencies = TRUE، تمام پکیج‌های وابسته هم به‌صورت خودکار نصب می‌شن و بعداً با خطاهای مربوط به نبود بسته‌های موردنیاز مواجه نمی‌شید.
  • 👍 3
  • ❤ 1
  • 🔥 1
  • 🥰 1
Post #188 789
🐍 نمونه پروژه‌های پایتون | GPA Pilot
🎓 نزدیک فصل اپلایه و یکی از پرتکرارترین سؤال‌ها اینه:
«GPA من توی مقیاس ۴ چند می‌شه؟»
برای همین این بار یک GPA Calculator با Python + Streamlit ساختیم؛ ابزاری که با دریافت نمره و تعداد واحد هر درس، معدل وزنی رو محاسبه می‌کنه و GPA تقریبی شما رو در مقیاس ۴ نمایش می‌ده.
✨ برخی از امکانات پروژه:
🔹 رابط کاربری فارسی و انگلیسی
🔹 محاسبه معدل از ۲۰ و تبدیل به GPA
🔹 محاسبه معدل وزنی
🔹 نمایش نمودار نمرات
🔹 آپلود و دانلود فایل CSV
🔹 اعتبارسنجی اطلاعات ورودی
🚀 نحوه اجرا:
git clone https://github.com/Zahra-Esfandiar/GPA-Pilot.git
cd GPA-Pilot
pip install -r requirements.txt
streamlit run app.py

📂 GitHub Repository:
🔗 https://github.com/Zahra-Esfandiar/GPA-Pilot
اگر از این سری پروژه‌ها استقبال کنید، پروژه‌های کاربردی بیشتری با Python، Data Science و AI منتشر خواهیم کرد. 🚀
  • 😍 1
  • 🤓 1
Post #187 843
📚 معرفی مطالب | آمار و ریاضیات Machine Learning

اگر یادگیری Machine Learning را شروع کرده باشید، خیلی زود متوجه می‌شوید که بدون آشنایی با ریاضیات و آمار، درک بسیاری از الگوریتم‌ها سخت می‌شود.

به همین دلیل، امروز یکی از بهترین منابع رایگان GitHub را معرفی می‌کنیم:

🚀 Mathematics for Machine Learning

این مخزن مجموعه‌ای از منابع منتخب برای یادگیری مباحثی مانند:

📖 Linear Algebra
📈 Calculus
📊 Probability & Statistics
🧠 Information Theory
🤖 ریاضیات موردنیاز Deep Learning و Machine Learning

همراه با کتاب‌ها، مقالات، ویدیوهای آموزشی و منابع معتبر دانشگاهی؛ همه در یک مکان.

🔗 GitHub Repository:
https://github.com/dair-ai/Mathematics-for-ML

🔥 و یک خبر خوب برای همراهان Data Elites...

اگر مدت‌ها منتظر بودید آمار، ریاضیات، علم داده و Machine Learning را از دیدگاه آماری، اصولی و کاملاً رایگان یاد بگیرید، خبر خوب این است که...

Data Elites برمی‌گردد! 🚀

این بار آموزش‌ها را به‌صورت منظم، دسته‌بندی‌شده و پروژه‌محور منتشر می‌کنیم؛ از مفاهیم پایه آمار و ریاضیات شروع می‌کنیم و قدم‌به‌قدم به Data Science، هوش مصنوعی، Machine Learning و پروژه‌های واقعی می‌رسیم.

🎯 هدف ما فقط آموزش ابزارها نیست؛ بلکه می‌خواهیم مفاهیم را عمیق، کاربردی و از دیدگاه آماری یاد بگیریم.

❤️ این تازه شروع مسیر جدید Data Elites است...

📢 منتظر اولین آموزش باشید!

Telegram
GitHub GitHub - dair-ai/Mathematics-for-ML: 🧮 A collection of resources to learn mathematics for machine learning 🧮 A collection of resources to learn mathematics for machine learning - dair-ai/Mathematics-for-ML
  • ❤‍🔥 4
  • ❤ 2
Post #186 1.91K
🚀 معرفی PackagePilot

بعد از مدتی کار روی این ایده، نسخه v1.0 پروژه PackagePilot آماده شد.

PackagePilot یک اپلیکیشن متن‌باز مبتنی بر R Shiny است که با هدف ساده‌تر کردن یادگیری پکیج‌های R توسعه داده شده است.

در نسخه فعلی می‌توانید:

🔹 پکیج‌های R را مستقیماً از CRAN جستجو کنید.

🔹 اطلاعات، وابستگی‌ها و مستندات هر پکیج را مشاهده کنید.

🔹 با مهم‌ترین توابع و مثال‌های اولیه آشنا شوید.

🔹 مسیر یادگیری متناسب با سطح خود دریافت کنید.

🔹 به Manual و Vignetteهای رسمی دسترسی داشته باشید.

اما این فقط شروع مسیر است...

در نسخه‌های آینده قابلیت‌هایی مانند AI Package Mentor، RAG مبتنی بر مستندات رسمی CRAN، محیط اجرای کد R، تمرین و آزمون هوشمند و سیستم پیشنهاد پکیج‌های مرتبط به پروژه اضافه خواهد شد.

اگر از R استفاده می‌کنید، خوشحال می‌شویم نظرات و پیشنهادهای شما را برای توسعه نسخه‌های بعدی بدانیم. 💙

⭐ GitHub Repository:

https://github.com/Zahra-Esfandiar/PackagePilot

طراحی و توسعه توسط: Zahra Esfandiar ✨

#R #RStats #Shiny #OpenSource #DataScience #ArtificialIntelligence #PackagePilot #DataElites
  • ❤‍🔥 2
  • ❤ 1
  • 🔥 1
Post #185 442
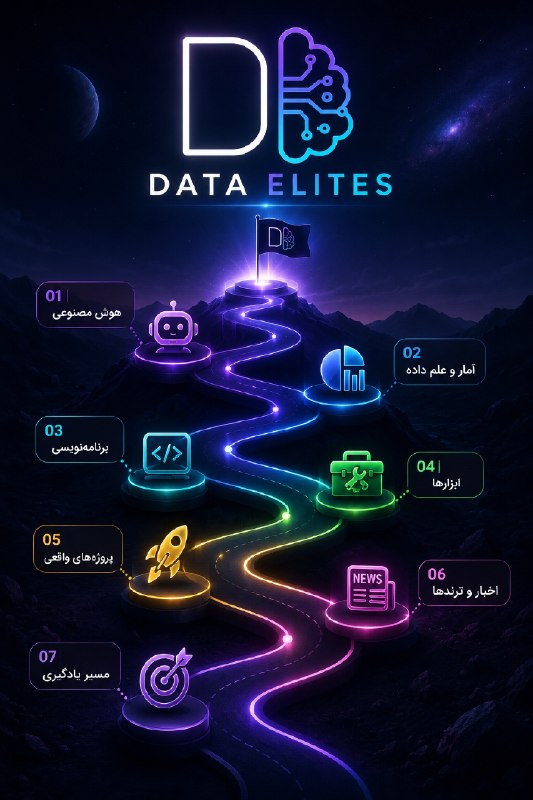
🚀 یه تغییر جذاب برای Data Elites!
از این به بعد محتواهای کانال به‌صورت منظم و دسته‌بندی‌شده منتشر می‌شن تا دسترسی به مطالب راحت‌تر باشه و هرکس بتونه موضوعات موردعلاقه خودش رو دنبال کنه.
📌 دسته‌بندی‌های اصلی:
🤖 هوش مصنوعی
📊 آمار و علم داده
💻 برنامه‌نویسی
🛠️ ابزارها و نرم‌افزارها
🚀 پروژه‌های واقعی
📰 اخبار و ترندها
🎯 مسیر یادگیری و شغلی
هدف ما اینه که Data Elites به یکی از مراجع فارسی حوزه هوش مصنوعی، علم داده، آمار و برنامه‌نویسی تبدیل بشه.
همراه ما باشید؛ تازه اول راهیم!♥

کانال ما رو به بقیه دوستان تون معرفی کنید ✌️😎
  • 🔥 3
  • 👍 1
  • 👎 1
  • 👏 1
Post #184
Channel photo updated
Post #183 581
یه تغییر کوچیک... ولی با کلی انرژی جدید! 🚀

بعد از مدت‌ها تصمیم گرفتیم لوگوی Data Elites رو عوض کنیم. 💙

حس کردیم وقتش رسیده هویت بصری‌مون هم مثل محتوایی که تولید می‌کنیم، مدرن‌تر و حرفه‌ای‌تر باشه.

همون تیمیم، همون علاقه به آمار، هوش مصنوعی و برنامه‌نویسی؛ فقط با یه ظاهر جدید. 😎

امیدواریم شما هم مثل ما دوستش داشته باشید.
  • 🥰 5
Post #182 937
🚀 وقتشه Vibe Coding رو کنار بذاری!

این روزها خیلی‌ها پروژه‌هاشون رو اینطوری شروع می‌کنن:

"یه داشبورد فروش با React و FastAPI برام بساز."

AI هم سریع شروع به تولید کد می‌کنه... اما کمی بعد:

❌ ساختار پروژه به‌هم می‌ریزه
❌ فیچرها ناقصن
❌ باگ‌ها یکی‌یکی ظاهر می‌شن
❌ هر تغییر کوچیک، چند جای پروژه رو خراب می‌کنه

چرا؟ 🤔

چون AI مستقیم رفته سراغ کدنویسی، بدون اینکه بدونه دقیقاً قراره چه چیزی ساخته بشه.

اینجاست که GitHub Spec Kit وارد بازی می‌شه.

به‌جای اینکه مستقیم کد بنویسه، اول:

📝 نیازمندی‌ها رو مشخص می‌کنه
🏗 معماری پروژه رو طراحی می‌کنه
📋 کارها رو به Taskهای کوچک تقسیم می‌کنه
💻 و در آخر کد تولید می‌کنه.

یعنی:

❌ Vibe Coding
Prompt → Code

✅ Spec-Driven Development
Prompt → Specification → Architecture → Tasks → Code

اگر با Cursor، Claude Code، GitHub Copilot یا هر AI Coding Agent دیگه‌ای کار می‌کنی، شاید وقتشه به‌جای فقط Prompt Engineering، کمی هم Software Engineering وارد بازی کنی. 😉

🔗 GitHub Spec Kit:
https://github.com/github/spec-kit
  • 🔥 5
Post #181 975
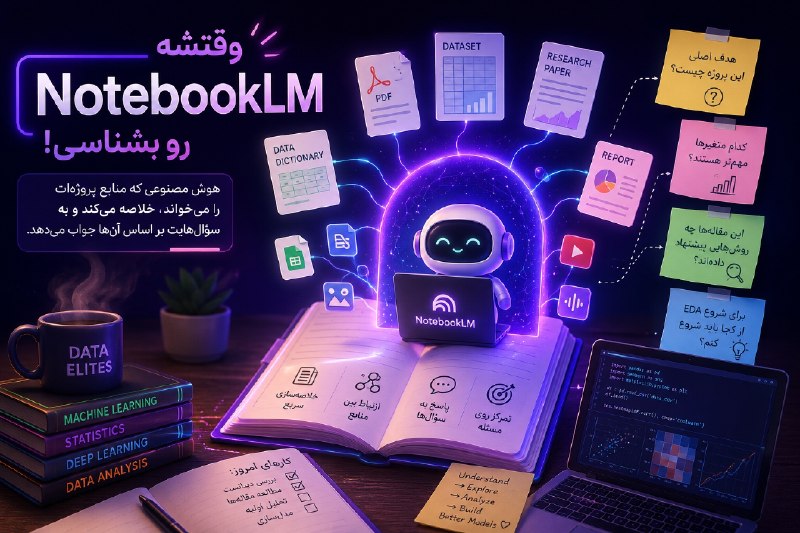
🚀 وقتشه NotebookLM رو بشناسی!

اگه توی حوزه Data Science کار می‌کنی، احتمالاً پروژه‌هات یه جایی شبیه این می‌شن:

یه پوشه با اسم final_final_v2_reallyfinal
چند تا PDF که معلوم نیست کدومش مهم‌تره
یه Data Dictionary که انگار برای رمزگشایی ساخته شده
و کلی تب باز که خودت هم نمی‌دونی چرا بازن! 😅

بعد وسط کار یادت میاد:

«اون مقاله‌ای که روش مناسب داده‌های من رو گفته بود کدوم بود؟»
«این متغیر دقیقاً چی بود؟»
«توی جلسه گفتیم اول کدوم بخش پروژه رو جلو ببریم؟»

اینجاست که NotebookLM می‌تونه خیلی به‌دردبخور باشه.

مقاله‌ها، مستندات دیتاست، گزارش‌ها و یادداشت‌های پروژه رو می‌ریزی داخلش؛ بعد به‌جای گشتن بین فایل‌ها، مستقیم از خودش می‌پرسی.

یعنی قبل از اینکه بری سراغ Python، R و مدل‌سازی، یک نفر هست که پروژه‌ات رو از روی منابع خودت جمع‌وجور کرده باشد. 🤖

NotebookLM برای Data Science یعنی:
کمتر «این فایل کجاست؟»
بیشتر «حالا با این داده چی بسازیم؟»

این تازه شروعشه؛ پست بعدی می‌ریم سراغ اینکه دقیقاً چه چیزهایی می‌تونی بهش بدی و چرا بعضی قابلیت‌هاش واقعاً خفنن. 🔥
  • ❤ 3
  • ❤‍🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →