TGViewer
Channel Public Channel
Аналитик данных

Аналитик данных

@dataanlitics

Аналитика данных, Дата Сеанс

@workakkk - по всем вопросам
Subscribers
6.25K
Photos
258
Videos
37
Links
238

Showing posts older than #202 · Back to latest

Older Posts 15 shown
Post #198 1.52K

Forwarded from Machinelearning

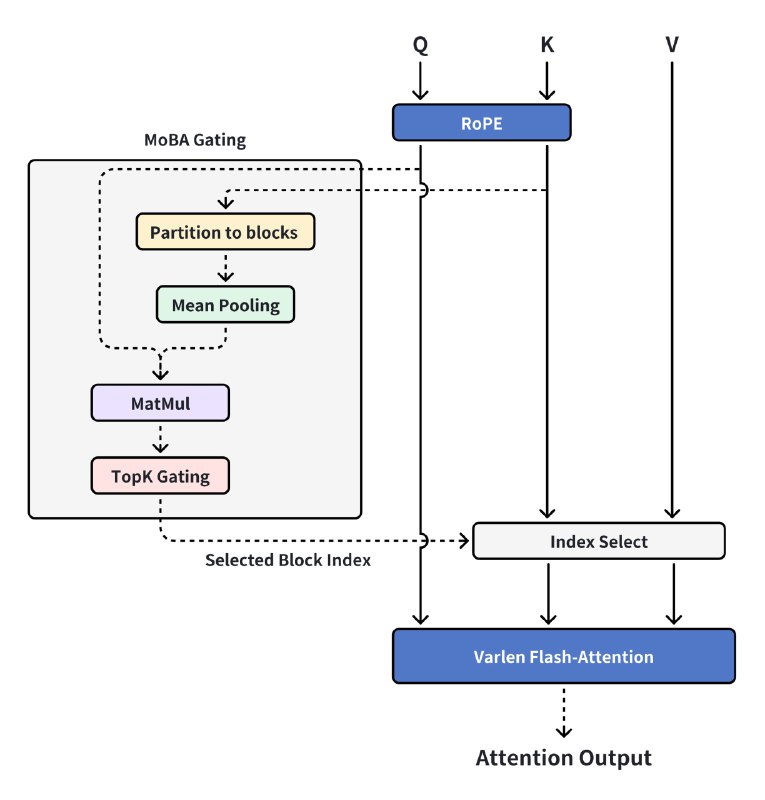
🌟 MoBA: Метод эффективной обработки длинных контекстов в LLM.

Mixture of Block Attention (MoBA) - метод, разработанный MoonshotAI для повышения эффективности обработки длинных последовательностей в LLM. MoBA основан на принципах Mixture of Experts и применяется к механизму внимания в архитектуре Transformers. Он позволяет динамически выбирать исторически релевантные KV-блоки для каждого токена запроса, снижая, как следствие, вычислительные затраты при обработке длинных контекстов.

MoBA разделяет контекст на блоки и использует механизм маршрутизации для выбора наиболее релевантных блоков. Такая конструкция помогает адаптивно фокусироваться на информативных частях контекста, что полезно для задач, требующих обработки длинных документов. Метод сохраняет причинность (causality) в авторегрессионных моделях за счет ограничения внимания только текущими и прошлыми блоками.

MoBA обладает гибкостью: модель может переключаться между полным и разреженным вниманием, экономя ресурсы при обучении моделей с длинными контекстами.

Эксперименты показали, что MoBA имеет сопоставимую производительность с Full attention при значительно меньших вычислительных затратах. Например, на Llama-8B-1M-MoBA с длиной контекста до 1 млн. токенов MoBA достигает разреженности до 95.31%, при этом сохраняя высокую точность на бенчмарках (AGIEval, BBH, CEval и др.).

На тестах с RULER с длиной контекста 128K MoBA показал результат 0.7818, что близко к результату полного внимания (0.7849).

⚠️ Актуальная реализация ядра полагается на flash-attn= =2.6.3. Данная реализация MoBA полностью совместима с transformers. Выбор бекэнда выполняется параметрами --attn moba и --attn moba_naive

▶️Локальная установка и запуск:

# Clone the repository
git clone https://github.com/MoonshotAI/MoBA.git

# Create a Conda venv
conda create -n moba python=3.10
conda activate moba

# Install dependencies
pip install .

# Quick Start
python3 examples/llama.py --model meta-llama/Llama-3.1-8B --attn moba

# Unit Tests
pytest tests/test_moba_attn.py


📌Лицензирование: MIT License.


🟡Техотчет
🖥GitHub


@ai_machinelearning_big_data

#AI #ML #LLM #MoBA
  • ❤ 2
  • 👍 2
Post #197 1.45K
🔥 Большой плейлист по изучению Deep Learning от Катарского университета!

🔗 Ссылка: *клик*

#курс #deeplearning
  • ❤ 2
Post #196 1.37K
🔥 Reflex LLM Examples — это репозиторий, демонстрирующий практические примеры использования больших языковых моделей от таких провайдеров, как Google, Anthropic, OpenAI, а также open-source моделей для локального хостинга!

🌟 Эти примеры построены с использованием фреймворка Reflex, который позволяет разработчикам создавать полнофункциональные веб-приложения исключительно на языке Python, без необходимости в знаниях JavaScript или веб-разработки.

🖥 Github
  • 👍 2
Post #194 1.32K

Forwarded from Machinelearning

🌟 Oumi: опенсорс-фреймворк полного цикла для LLM.

Oumi - открытая платформа для разработки, файнтюна, оценки и экспериментов с языковыми и мультимодальными моделями, созданная совместными усилиями исследователей из 13 ведущих университетов.

Oumi предоставляет инструменты и рабочие процессы для разработки и запуска масштабных экспериментов на кластере, развертывания моделей в рабочей среде и поддерживает методы распределенного обучения (FSDP, DDP):

🟢обучение и файнтюн моделей от 10M до 405B параметров методами SFT, LoRA, QLoRA и DPO;
🟢поддержку популярных семейств моделей: Llama, DeepSeek, Qwen и Phi;
🟢синтез и курирование обучающих данных с использованием LLM-judge;
🟢быстрое развертывание моделей в средах vLLM и SGLang;
🟢проведение комплексного бенчмаркинга моделей по стандартным тестам;
🟢возможность подключения по API OpenAI, Anthropic и Vertex AI;
🟢интеграция с библиотекой Transformers.

В репозитории проекта собраны готовые ноутбуки и скрипты для каждого из этапов жизненного цикла моделей, а подробная документация по использованию поможет легко освоить эту платформу.

📌Лицензирование: Apache 2.0 License.


🟡Статья
🟡Документация
🟡Сообщество в Discord
🖥GitHub


@ai_machinelearning_big_data

#AI #ML #Oumi #Framework
  • ❤ 1
Post #192 1.8K
🖥 Python — полный курс для начинающих!

🕖 Продолжительность: 5:27:41

🔗 Ссылка: *клик*

#курс #python
  • 👍 3
  • 🔥 3
Post #191 1.67K
📖 Эта статья посвящена оптимизации производительности моделей глубокого обучения!

💡 Автор рассматривает три ключевых компонента, влияющих на эффективность работы: вычисления (compute), пропускная способность памяти (memory bandwidth) и накладные расходы (overhead). Понимание того, какой из этих факторов является узким местом в конкретной системе, позволяет целенаправленно применять оптимизационные стратегии.

🔗 Ссылка: *клик*

#deeplearning
  • ❤ 2
  • 👍 1
Post #189 1.81K
🔥 В этой статье представлены 100 курсов на такие темы, как веб-разработка, искусственный интеллект, машинное обучение, программирование на Python, и другие навыки, которые востребованы на рынке труда!

🔗 Ссылка: *клик*
Post #187 1.6K

Forwarded from Machinelearning

🧠 Oh sh**, here we go again.

Alibaba релизнули еще одну модель: Qwen2.5-Max

- MoE
- предварительно обученная на масштабных датасетах и пост-обученная с помощью SFT и RLHF
- превосходит DeepSeek V3 на бенчмарках: Arena Hard, LiveBench, LiveCodeBench, GPQA-Diamond
- Может генерить видео, картинки, поддерживает поиск в интернете.

📖 Релиз: https://qwenlm.github.io/blog/qwen2.5-max/
💬 Chat: https://chat.qwenlm.ai (choose Qwen2.5-Max as the model)
⚙️ API: https://alibabacloud.com/help/en/model-studio/getting-started/first-api-call-to-qwen?spm=a2c63.p38356.help-menu-2400256.d_0_1_0.1f6574a72ddbKE
🤗 HF: https://huggingface.co/spaces/Qwen/Qwen2.5-Max-Demo

#Qwen #ml #llm #Alibaba #opensource
  • ❤ 1
  • 👍 1
Post #186 1.53K
  • 😁 12
  • 👍 3
Post #185 1.71K
🔥 IronCalc — это движок для работы с электронными таблицами!

🌟 Он включает инструменты для чтения и записи файлов формата .xlsx, с возможностью интеграции с различными языками программирования, такими как Python и JavaScript. Проект нацелен на создание более открытой и функциональной инфраструктуры для работы с таблицами, предлагая разработчикам гибкость в использовании как в веб-приложениях, так и в десктопных приложениях.

🔐 Лицензия: Apache-2.0

🖥 Github
  • 👍 2
  • ❤ 1
  • 🥰 1
Post #184 1.65K
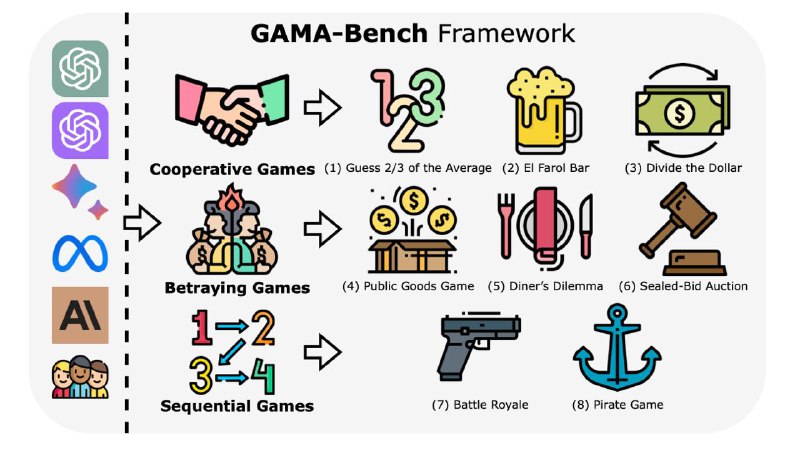
💰GAMA-Bench

Принятие решений - сложный процесс, требующий различных навыков, что делает его хорошим тестов для оценки больших языковых моделей (LLM).

В данной работе исследователи изучали процесс принятия решений LLM через призму теории игр.

Существующие оценки в основном сосредоточены на случаях с двумя игроками, где LLM соревнуется с другим.

GAMA(γ)-Bench, новую структура для оценки способностей LLM в многоагентных средах через призму теории игр.

Он включает в себя восемь сценариев из классической теории игр и динамическую схему подсчета баллов, специально разработанную для количественной оценки производительности LLM.

γ-Bench очень гибкие настройки игры, что позволяет адаптировать систему подсчета баллов к различным параметрам игры, чтобы всесторонне оценить стратегии принятия решений

▪Статья: https://arxiv.org/abs/2403.11807
▪Код: https://github.com/CUHK-ARISE/GAMABench
  • ❤ 2
  • 👍 1
  • 🔥 1
Post #183 1.74K
  • ❤ 3
  • 🔥 3
  • 🥰 1
Post #182 1.81K
🖥 Руководство: Создание нейронной сети с нуля на Python!

🕞 Продолжительность: 1:13:06

🔗 Ссылка: *клик*
  • 👍 3
  • ❤ 1
  • 🔥 1
Post #181 1.76K
🔥 Open Deep Research — это инструмент с открытым исходным кодом, разработанный для автоматизации исследовательского процесса и создания отчётов с использованием искусственного интеллекта!

🌟 Он выполняет три этапа: получение результатов веб-поиска через Bing Search API, извлечение и обработку релевантного контента из найденных источников с помощью JinaAI и генерацию итогового отчёта с использованием AI-моделей, таких как GPT-4, Gemini или Sonnet. Это позволяет пользователям быстро получать синтезированные данные и создавать информативные отчёты по заданным запросам.

🔐 Лицензия: MIT

🖥 Github
  • 👍 3
  • ❤ 2
Post #180 1.56K
⚡️Легкий способ получать свежие обновления и следить за трендами в разработке на вашем языке. Находите свой стек и подписывайтесь:

МАШИННОЕ ОБУЧЕНИЕ: t.me/ai_machinelearning_big_data
C++ t.me/cpluspluc
Python: t.me/pythonl
Linux: t.me/linuxacademiya
Хакинг: t.me/linuxkalii
Devops: t.me/DevOPSitsec
Data Science: t.me/data_analysis_ml
Javascript: t.me/javascriptv
C#: t.me/csharp_ci
Java: t.me/javatg
Базы данных: t.me/sqlhub
Python собеседования: t.me/python_job_interview
Мобильная разработка: t.me/mobdevelop
Docker: t.me/DevopsDocker
Golang: t.me/Golang_google
React: t.me/react_tg
Rust: t.me/rust_code
ИИ: t.me/vistehno
PHP: t.me/phpshka
Android: t.me/android_its
Frontend: t.me/front
Big Data: t.me/bigdatai
Собеседования МЛ: t.me/machinelearning_interview
МАТЕМАТИКА: t.me/data_math
Kubernets: t.me/kubernetc
Разработка игр: https://t.me/gamedev
Haskell: t.me/haskell_tg

💼 Папка с вакансиями: t.me/addlist/_zyy_jQ_QUsyM2Vi
Папка Go разработчика: t.me/addlist/MUtJEeJSxeY2YTFi
Папка Python разработчика: t.me/addlist/eEPya-HF6mkxMGIy
Папка ML: https://t.me/addlist/2Ls-snqEeytkMDgy
Папка FRONTEND: https://t.me/addlist/mzMMG3RPZhY2M2Iy

😆ИТ-Мемы: t.me/memes_prog
🇬🇧Английский: t.me/english_forprogrammers
🧠ИИ: t.me/vistehno

🎓954ГБ ОПЕНСОРС КУРСОВ: @courses
📕Ит-книги бесплатно: https://t.me/addlist/BkskQciUW_FhNjEy
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →