TGViewer
Channel Public Channel
EasyData

EasyData

@data_easy

Добро пожаловать!
Меня зовут Мария Жарова, и это мой блог про науку о данных✨

Лайфхаки из будней MLщика, полезности по Data Science и ответы на вопросы, которые волнуют новичков и не только🌝

Автор @NaNCat
Subscribers
1.37K
Photos
185
Videos
12
Links
116
Recent Posts 13 shown
Post #370 281
Привет, друзья!
Давайте разберём, как оценивать RAG-пайплайн. Тема довольно острая: например, на оффлайне Recall@10 может быть 0.99, но пользователи всё будут равно жаловаться на выдуманные факты...
Важно помнить, что RAG - это две системы в одной, и сломаться они могут независимо друг от друга:
• нужный чанк может не найтись
• может оказаться на 9-й позиции и утонуть в контексте
• может попасть в топ-1, но генератор всё равно ответит мимо
Каждую поломку ловит своя метрика, поэтому одной цифрой тут не обойтись.

🔗 Ссылки на библиотеки с последней карточки:
• RAGAS, DeepEval, TruLens, Arize Phoenix

Материалом поделились коллеги из Embedika

Листайте в карточках - идеальная шпаргалка для быстрого повторения!
И хороших выходных 🙂


#nlp@data_easy
  • 🔥 12
  • ❤ 6
  • 👍 4
Post #369 657
Привет, друзья!
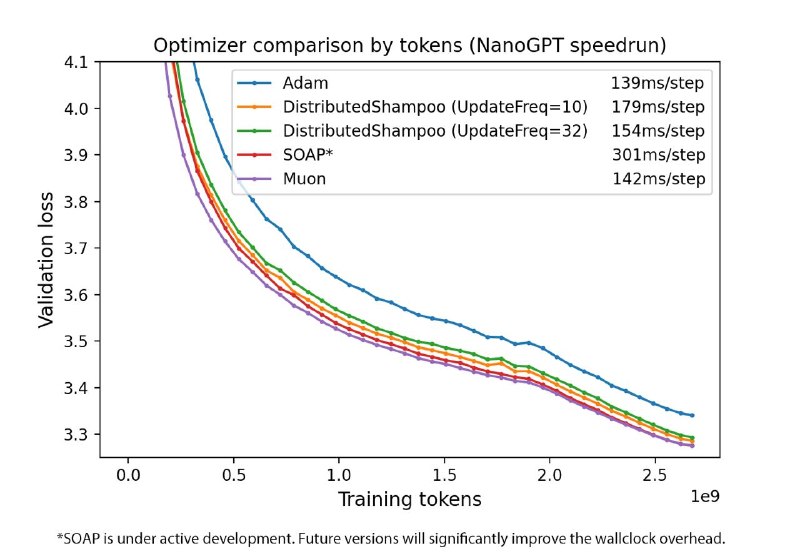
Adam и AdamW правят балом почти десять лет... Претенденты на замену были, но одно дело красивая идея на бумаге, и совсем другое - алгоритм, который реально закрепится. И вот появился Muon, который за последние 1.5 года тихо просочился в обучение крупнейших моделей. Давайте разберёмся, как он устроен! 🧐

🔠 Как было?
Классический градиентный спуск двигает все веса на один и тот же шаг вдоль антиградиента. Adam умнее: он хранит моментум (сглаженные предыдущие направления) + подбирает индивидуальный размер шага для каждого параметра, исходя из его истории. Но “взгляд” у него поштучный: каждый вес - сам по себе, а градиент по слою рассматривается как длинный вектор независимых чисел.


🔠 Как стало?
Например, веса полносвязного слоя записываются матрицей, физически она задаёт линейное преобразование (привет всем, кто спрашивал про практическое применение теории на парах по линалу✌️). Градиент по такой матрице весов тоже можно записать в матричной форме - а не вектором, как делают обычные оптимизаторы.
Так и поступает Muon: он берёт матрицу обновления (сглаженный моментумом градиент), оставляет её в родной матричной форме -> а затем превращает в ортогональную (как именно - вспомним ниже). Это основная идея, и отсюда пошло название: MomentUm Orthogonalized by Newton-Schulz.


🔠 Как ортогонализовать и зачем?
Есть проблема, что у матрицы обновления весов обычно пара направлений сильно доминирует, а остальные почти нулевые. Получается, обучение пойдет вдоль этих немногих осей, а вся остальная “ёмкость” слоя простаивает. Как раз с этим и помогает ортогонализация!
Теперь “как это реализуется”: вспомним SVD - он раскладывает любую матрицу на две ортогональные (которые задают повороты) + одну диагональную посередине (она задаёт растяжение/сжатие, числа на диагонали называют “сингулярными”). Ортогонализацией мы превращаем все сингулярные значения в единицу, как раз убирая проблему “перекоса”. За счёт этого шаг делается во все стороны поровну, и слой учится целиком.


🔠 Кто такой Newton-Schulz?
Итак, честно ортогонализировать матрицу можно через SVD - но высчитывать его на каждом шаге и для каждого слоя неподъёмно дорого... Поэтому, как обычно, пользуемся эвристиками: Newton-Schulz даёт почти тот же результат за несколько матричных умножений (а их видеокарта уважает). Обычно хватает 5 итераций - так что Muon вполне пригоден для реального обучения.


➕ Плюсы
• Быстрее сходится: примерно вдвое эффективнее AdamW по замерам Moonshot (они посчитали, что один прогон обходится в 2x дешевле).
• Экономит память: у Adam на каждый вес два состояния, у Muon - только моментум. Около трети памяти под оптимизатор долой.


➖ Минусы
• Применим только к слоям, где вес - это полноценное преобразование: например, полносвязные и attention. Но нормировки, свободные члены, выходной слой и эмбеддинги (обновляются построчно) учатся через AdamW.
• Каждый шаг дороже: Newton-Schulz добавляет матричные умножения, которых у AdamW нет. Шагов, конечно, нужно меньше, но с ростом модели расходы приходится отдельно оптимизировать.
• На больших моделях чаще всплывает нестабильность: значения внимания разгоняются и обучение может разойтись.


🤔 Это будущее?
Похоже, что да - Muon уже вышел из разряда экспериментов:
• Обучает топовые открытые модели: Kimi K2 (1 трлн параметров) и GLM-5 (744 млрд), DeepSeek-V4.
• Нестабильность научились лечить: например, Moonshot добавили приём MuonClip, который придерживает разгоняющиеся значения внимания.
• Уже адаптируется под инфраструктуру: NVIDIA встроила Muon в свой Megatron + команда DeepSpeed реализует поддержку.
• Оброс модификациями: за год вышли десятки ускоренных версий (Gram Newton-Schulz от Три Дао, NorMuon, Hierarchical Muon и другие) - так что направление живое.


🔗 Что почитать и где попробовать?
• Оригинальный пост Keller Jordan - с интуицией и картинками
• Референс-реализация
• Вывод "с нуля" для любителей математики
• Newton-Schulz в доках Modula - с визуализациями сходимости


Мораль такая: иногда научный прорыв - это не новая сложная формула, а свежий взгляд на привычное 🌿

#dl@data_easy
  • 🔥 9
  • ❤ 5
  • ⚡ 3
  • ❤‍🔥 2
  • 👍 2
  • 🙏 1
Post #368 936
Привет, друзья!
Автор возвращается с каникул с полным мешком пирожков полезных материалов для подготовки к собесам😄 Осенний сезон найма на носу, так что держите свежую подборку ресурсов, которых ещё не было в канале👇

🙂 Interview Query
Это интерактивная платформа с вопросами из 9300+ компаний - преимущественно международных, но есть и кое-какие из РФ. Прикольная фишка: загружаете туда своё резюме, выбираете роль и желаемые компании - и платформа сама подсказывает, какие навыки у вас уже прокачаны, а что стоит подтянуть + составляет персональную подборку заданий (начало бесплатное, но за полную версию ожидаемо придется платить 🤭).
По классике здесь собраны задачи по теории и программированию + продуктовые и поведенческие кейсы. Также найдете много статей и обсуждений. Ещё удобно, что для задачек на код есть встроенный редактор со всеми подключенными БД.
🔗 ссылка

🙂 MLStack.Cafe
А это просто огромная база задач - больше 2000 вопросов с ответами по ML, DS, Python, NLP, DL, LLM, MLOps и даже отдельные разделы по AWS и промпт инжинирингу. Все разбито по темам и уровням сложности: джуновские вопросы доступны с ответами бесплатно, а вот для middle/senior/expert уровней можно просмотреть только сами вопросы - для ответов нужна платная подписка (ну, или сходить за помощью к любимому LLM-другу🙂).
🔗 ссылка

🙂 Machine Learning Interviews Book
Легендарная бесплатная книга от ex-NVIDIA / Snorkel AI. Внутри не только 200+ вопросов с уровнями сложности, но и разбор того, как вообще устроен ML-собес в топ-компаниях: какие бывают роли (research vs production, MLE vs DS), из каких этапов состоит процесс, на что реально смотрят интервьюеры, красные флаги, как читать оффер... - словом, концентрат опыта, который обычно получают за годы практики. И всё полностью бесплатно!
🔗 ссылка

🙂 Stanford CS 229 / 230 / 221
Тут шпаргалки к курсам Stanford - вся классика ML/DL/AI в сжатом виде на нескольких страницах:
• CS 229 - классический ML
• CS 230 - простой deep learning: CNN, RNN, LSTM, backprop
• CS 221 - AI в широком смысле: MDP, RL, байесовские сети
Плюс отдельные странички по статистике, теорверу и линалу - идеально, чтобы освежить матан за пару часов. И ещё из приятного - есть официальный русский перевод.
🔗 офиц. ссылка, странички с переводом

PS: похожие посты с подборками
•
https://t.me/data_easy/276
•
https://t.me/data_easy/304
•
https://t.me/data_easy/310

Продуктивной осени!!!💪


#карьера@data_easy
  • ❤ 24
  • 👍 10
  • 🔥 7
  • 🤩 6
  • ⚡ 2
Post #367 1.27K
Привет, друзья!
Представьте: у вас есть паркет на 10 гигов, и надо всего лишь посчитать по нему пару агрегаций... А что если можно не тащить его целиком в память и не городить пайплайны, а просто написать SQL прямо по файлу - без всякой базы и серверов? 🦆

Есть такой инструмент - DuckDB, и за последние пару лет он потихоньку прописался в арсенале у многих DS-команд.

🦆 Что это такое?
Если в двух словах - это "SQLite для аналитики". Появился он ещё в 2019 году (кстати, вырос из амстердамского института CWI - того самого, откуда родом Python), но по-настоящему зрелым стал не так давно. Технически это встраиваемая колоночная база данных, заточенная под аналитические запросы.
Что это значит на практике:
• Работает прямо внутри вашего Python-скрипта - никаких серверов, подключений и конфигов.
• Читает CSV, Parquet, JSON, а также pandas- и polars-датафреймы напрямую, без предварительной загрузки в базу.
• Это полноценный SQL - с оконными функциями, подзапросами, джойнами и всем, что вы любите.
• Многопоточность из коробки + отлично работает с данными, которые больше оперативной памяти!

По сути это способ писать SQL по чему угодно: по файлам, датафреймам, бакетам в облаке, без построения пайплайнов и поднятия инфраструктуры.


🦆 Почему он такой быстрый?
• Хранение колоночное: если вам нужны две колонки из тридцати, DuckDB прочитает с диска только их (это называют projection pushdown).
• Фильтр из WHERE он старается применить как можно раньше, ещё на этапе чтения (это predicate pushdown) - то есть лишние строки даже не поднимаются в память.
• Плюс векторизованное исполнение: данные обрабатываются не по одной строчке, а пачками - отсюда и скорость на больших файлах.

🦆 Установка и использование
Ставится одной строчкой, без серверов и докера:

pip install duckdb

Самый частый сценарий - SQL прямо по паркет-файлу, без загрузки куда-либо:

import duckdb

result = duckdb.sql("""
SELECT category,
AVG(price) AS avg_price,
COUNT(*) AS orders
FROM 'sales.parquet'
WHERE price > 100
GROUP BY category
ORDER BY orders DESC
""").df()

Обратите внимание: файл указан прямо в FROM, никакой предварительной загрузки в таблицу. В конце .df() возвращает результат обычным pandas-датафреймом.
Можно так же легко пройтись сразу по нескольким файлам по маске:

duckdb.sql("SELECT * FROM 'data/2024_*.parquet'").df()

И самая приятная часть - дружба с pandas:

import pandas as pd
import duckdb

df = pd.read_csv("orders.csv")

# обращаемся к df по имени переменной прямо в SQL
result = duckdb.sql("""
SELECT user_id, SUM(amount) AS total
FROM df
GROUP BY user_id
HAVING total > 1000
""").df()

DuckDB видит переменную df в вашем Python-коде и работает с ней как с таблицей, причём без лишнего копирования данных туда-сюда - обмен идёт напрямую.
А ещё можно смешивать источники в одном запросе: сджойнить pandas-датафрейм, паркет с диска и CSV из интернета в одном SELECT 😏

🦆 Что почитать:
• Официальная документация: тык
• Раздел Guides с готовыми рецептами кода: тык
• Блог с разборами внутренностей и бенчмарками: тык

Пусть ваши запросы летают, а память не кончается! 💨


#аналитика@data_easy
#classic_ml@data_easy
  • 🔥 22
  • ❤ 8
  • 👍 7
  • 🆒 1
Post #366 1.3K
Why_machines_learn.zip48.2 MB
Привет, друзья!
Устали от стандартных учебников по ML? Материалов с каждым месяцем и правда становится всё больше - но среди них попадаются и оригинальные новинки! Держите две по-настоящему необычные книги "с изюминкой".

📘 Why Machines Learn?
Это не учебник в привычном смысле, а редкая смесь истории ML, математики и научпопа. Главы начинаются с живых историй про конкретных исследователей и читаются как увлекательная статья. Но математику автор при этом не прячет: тут есть честные выводы формул и геометрические соображения.
Зайдет и новичкам, и опытным. Кстати, сам Джеффри Хинтон назвал её шедевром - за то, что математика подаётся прямо в контексте живой истории.
➡️ Официальная версия на английском и неофициальный перевод на русский во вложениях.

🐰 Alice's Adventures in a Differentiable Wonderland
А это совсем другой жанр: книга рассказывает о нейросетях с нуля, причём повествуется как про путешествие Алисы по стране чудес - от самых основ (автоматическое дифференцирование, оптимизация) до современных архитектур: свёрточных, рекуррентных, attention-блоков.
Подача интуитивная и с юмором, но без потери глубины: теория честно стыкуется с кодом на PyTorch и JAX. Бонусом на официальном сайте автора можно посмотреть ещё и упражнения к теории.
➡️ Ссылки:
•
PDF с сайта автора
• версия на arXiv (самая новая)
•
сайт с доп. главами и упражнениями

Порой свежий взгляд на привычное помогает наконец понять самую суть 🌿


#dl@data_easy
#classic_ml@data_easy
  • ❤‍🔥 23
  • 🔥 6
  • 🤩 6
  • 👌 1
  • 👀 1
Post #365 1.33K
Привет, друзья!
Сегодняшний рассказ про marimo - реактивный блокнот для Python, который многие уже называют заменой Jupyter 👀

🤔 Что это вообще такое?
Если коротко - как Jupyter, только лучше.
Помните, этот вечный ужас, когда прогнали ячейки не по порядку, а потом непонятно, в каком состоянии сейчас ноутбук?
Здесь такого точно не случится - и это главная фишка marimo, которую называют реактивность: когда вы меняете переменную в одной ячейке, он сам автоматически пересчитывает все остальные ячейки, которые от неё зависят.

🤔 Какие ещё плюсы?
Зацепило ещё несколько моментов:
• Ноутбук хранится как обычный .py файл, а не как огромный json - а значит, git наконец-то будет нормально показывать различия.
• Никакого скрытого состояния - удаляете ячейку, и marimo вычищает её переменные из памяти автоматически.
• Встроенные интерактивные элементы управления - ползунки, выпадающие списки, таблицы. Например, двигаете ползунок прямо в ноутбуке - и связанные с ним вычисления пересчитываются.
• Тот же ноутбук можно развернуть как полноценное веб-приложение или запустить как обычный скрипт из командной строки.
• Есть нативная поддержка SQL - можно гонять запросы прямо по датафреймам и csv (под капотом DuckDB).
• Отлично дружит с ИИ-агентами - можно подключиться в пару кликов.


🤔 Как поставить?
Если по-минимуму:
pip install marimo

А если хотите сразу со всеми наворотами (SQL-ячейки, ИИ-автодополнение, серверный рендеринг графиков), то:
pip install "marimo[recommended]"

Дальше можете запустить обучающий ноутбук-туториал:
marimo tutorial intro

Создать свой новый ноутбук:
marimo edit notebook.py

Превратить его в веб-приложение:
marimo run notebook.py

Ставить можно куда угодно - локально, на сервер, в любое окружение (отлично дружит с pip, uv, conda). А если совсем не хочется - есть molab, облачная версия в духе Google Colab, достаточно просто зарегистрироваться.

Кстати, переезжать со всем нажитым добром не придётся - старые Jupyter-ноутбуки конвертируются одной командой:
marimo convert your_notebook.ipynb > your_notebook.py


🤔 Но было замечено и несколько минусов:
• Та самая реактивность поначалу непривычна - нельзя дважды определить одну переменную в разных ячейках, и переменные не должны ссылаться на то, что ещё не определено. Это сделано специально, но в первое время немного ломает мозг после Jupyter.
• Горячие клавиши и автодополнение работают иначе - придётся переучиваться.
• На GitHub ноутбук показывается как обычный .py, а не как красивый рендер с графиками. Удобно для код-ревью, но если вы привыкли делиться готовым ноутбуком "с картинками" прямо в репозитории - имейте в виду.
• Если ячейки тяжёлые и считаются долго, та самая реактивность может стать врагом... Но на этот случай есть ленивый режим - в нем marimo не пересчитывает всё сразу, а просто помечает ячейки как устаревшие.


🤔 Полезные ссылки:
• официальная документация: тык
• проект на GitHub: тык
• облачный molab: тык

В общем, штука и правда отличная, но надо привыкнуть. Кто уже пробовал marimo - делитесь впечатлениями✨


#mlops@data_easy
  • 🔥 16
  • ❤‍🔥 6
  • ❤ 6
  • 🙏 4
Post #364 1.25K
Привет, друзья!
Лучше один раз увидеть, чем сто раз услышать... Некоторые вещи бывает сложно объяснить словами, а если к ним ещё добавить формул - иногда вообще становится страшно🙈
На этот случай держите подборку интерактивных эксплейнеров по самым актуальным темам - где-то это просто гифки, а где-то можно покрутить руками гиперпараметры и данные:

📉 Градиентный спуск
ТОП-1 штука, чтобы прочувствовать алгоритм. Можете покрутить шаг обучения, моментум, начальное приближение - и увидеть, как меняется ситуация: аккуратно сходится или лосс скачет. Там же краткое описание происходящего с формулами.
Ссылка: тык (на соседних страницах найдёте ещё несколько других алгоритмов оптимизации)

🌳 EDA, дерево решений, bias-variance tradeoff
От этих авторов есть два шедевра:
• История решения любимой задачи по предсказанию стоимости домов.
• Рассказ про bias-variance tradeoff.
Просто листайте страничку вниз и сами всё увидите. В настройках можно выбрать русский язык.
Ссылка: тык

🧠 Нейросети
Чтобы детально понять, что происходит внутри полносвязной сети:
• В TensorFlow Playground можно покрутить архитектуру сети, активации, данные - и увидеть, как в зависимости от настроек модель определяет границу между классами.
Ссылка: тык
• Заметки от deeplearning.ai помогут разобраться с проблемами обучения - затухающие и взрывающиеся градиенты, плохая начальная инициализация, влияние функции активации...
Ссылка: тык

🤖 Трансформеры
• Transformer Explainer гоняет GPT-2 у вас на глазах: просто введите любой текст, и "черный ящик" в реальном времени покажет, как модель предсказывает следующие токены.
Ссылка: тык
• exBERT - похожая идея для моделей из Hugging Face, можно покопаться во внутренней логике механизма внимания.
Ссылка: тык
• А если вдруг захочется сделать такую визуализацию, как exBERT, самому - есть библиотека BertViz.
Ссылка: тык

Пусть сложное становится наглядным, а непонятное очевидным✨

#classic_ml@data_easy
#dl@data_easy
r2d3.us Experiments in expressing statistical thinking with interactive design
  • 🔥 23
  • ❤ 15
  • 👍 3
Post #363 1.14K
Привет, друзья!🤚
В прошлый раз говорили про то, как ИИ меняет саму разработку - а сегодня про то, чем эту разработку вооружать.
Держите подборку материалов для тех, кто строит агентов (или собирается) - от готовых наборов до фундаментальных гайдов 😌

👍 Everything Claude Code (ECC)
Огромный репозиторий всего и сразу для агентных сред от победителя хакатона Anthropic: готовые агенты, навыки, хуки, правила и конфиги, отточенные за 10+ месяцев ежедневного использования.
Внутри ~50 агентов, 185 навыков и куча совместимых заглушек команд. Работает не только с Claude Code, но и с Cursor, Codex, OpenCode и др. По сути - это готовая оболочка, которую можно ставить плагином и подключать только нужные куски. Сейчас у репозитория уже 210k🌟.
➡️ Ссылка: тык

👍 Awesome AI Agents 2026
А этот репозиторий - навигатор по экосистеме агентов: в readme собран список из 300+ инструментов, разбитых по 20+ категориям (coding-агенты, фреймворки, браузерные агенты, research, протоколы и т.д.), обновляется ежемесячно. Этот гайд - отличная отправная точка, чтобы понять, что вообще есть на рынке и не утонуть.
➡️ Ссылка: тык

👍 AI Agents for Beginners (Microsoft)
Фаворит для старта: здесь 12 уроков от Microsoft, которые по шагам проводят от "что такое агент" до рабочих примеров, включая Agentic RAG. Идеально, если хочется системный мини-курс с базой.
➡️ Ссылка: тык

👍 Гайды от Anthropic
Материалов у них ооочень много, вот несколько самых топовых по теме агентов:

➡️ Building Effective Agents - тот самый фундаментальный текст, на который все ссылаются (включая академические работы).
Ссылка: тык

➡️ Equipping agents with Agent Skills - про то, как оснащать агентов навыками через папки с инструкциями и скриптами. Anthropic представили Agent Skills в конце 2025 и открыли формат как общий стандарт в марте 2026 - так что концепция уже не экзотика.
Ссылка: тык

➡️ How we built our multi-agent research system - как у них устроен мультиагентный research-пайплайн. Забавный инсайт про то, что ведущий агент должен давать субагентам чёткие задачи с целью, форматом вывода и границами - иначе они дублируют работу или оставляют пробелы.
Ссылка: тык

P.S. Прошло больше недели с момента выхода Claude Opus 4.8 - первые отзывы в целом положительные...
Главный акцент Anthropic сделали на честности и надёжности: модель заметно чаще признаёт собственные ошибки, сама обращает внимание на проблемы во входных данных и лучше справляется с большими многошаговыми агентными задачами. Многие отмечают, что Claude стал больше похож на внимательного коллегу по ревью, чем на "генератор ответов".
Но есть и минусы: новый токенизатор расходует больше токенов на те же запросы, модель стала осторожнее и иногда отказывается выполнять вполне легитимные задачи:) А любителям вайб-кодинга может показаться менее удобной из-за более строгого отношения к расплывчатым инструкциям.
В целом сообщество сходится во мнении, что Opus 4.8 усилил сильные стороны Claude - код, математику и агентные сценарии, хотя местами пожертвовал удобством и креативностью.


Продуктивных агентов и рабочей недели! 🤖🌿

#полезный_ии@data_easy
#nlp@data_easy
  • ❤ 19
  • ❤‍🔥 6
  • 👍 4
  • 🔥 4
  • 🙏 2
Post #362 1.13K
Привет, друзья!🤚
Последнее время снова активно заговорили про роль ИИ в разработке и "заменят ли нас модели". Решила покопаться в более-менее официальной статистике и исследованиях - и наткнулась на несколько очень любопытных вещей.

Если коротко: ИИ уже массово вошёл в разработку, но эффект оказался совсем не таким, как многие ожидали.

🙂 Код правда стали писать быстрее - а вот всё остальное стало "бутылочным горлышком"
В крупном метаисследовании от Т-банка (45 исследований + опросы инженеров из разных компаний) 58% разработчиков сказали, что регулярно используют ИИ для генерации кода и автодополнения.

Но дальше интересное: для code review ИИ используют только ~24% разработчиков, а для работы с legacy-кодом - вообще <20%. Видимо, чем больше нужно контекста, тем меньше доверия к модели.

При этом ощущение продуктивности реально есть: 64% разработчиков говорят, что стали работать быстрее - но вот скорость доставки фич до прода почти не изменилась😄 ИИ не только ускорил этап написания кода, но и ярко подсветил старые добрые проблемы с тестированием, ревью, интеграцией и инфраструктурой.

Так что получается забавный парадокс: кода стало производиться больше, а способность компаний безопасно проверять этот код почти не выросла. Именно поэтому сейчас так резко выросла ценность хорошей документации, понятных процессов и платформенной инженерии.
ИИ, похоже, не упрощает хаос: он либо усиливает зрелые процессы, либо делает незрелые ещё более шумными.

🙂 А что с рынком труда?
Тут тоже всё интереснее, чем заголовки в духе "программисты больше не нужны". Андрей Карпаты недавно сделал интерактивную визуализацию по 342 профессиям в США и оценил их "AI exposure" - насколько разные профессии подвержены влиянию ИИ.
Сразу спойлер: у разработчиков показатель высокий. Но вот что пишет об этом Карпаты:
Разработчики программного обеспечения получают 9/10 баллов, потому что ИИ трансформирует их работу, но спрос на программное обеспечение может легко вырасти по мере повышения производительности каждого разработчика. Оценка не учитывает эластичность спроса, скрытый спрос, нормативные барьеры или социальные предпочтения в отношении работников-людей. Многие профессии с высоким уровнем воздействия будут изменены, а не заменены.

Как видим по предыдущему исследованию, тенденция такая: меньше времени уходит на рутину, но больше на архитектуру, диагностику, валидацию, понимание продукта и работу с контекстом. Так что можно будет больше заняться творчеством, а скучное делегировать ИИ.

🙂 И самое неожиданное - экономика пока почти не видит эффекта от ИИ...
Есть большое исследование NBER, где опросили почти 6000 CEO и CFO из США, Великобритании, Германии и Австралии.
Выяснилось, что 70% компаний уже используют ИИ, но:
• 89% не видят заметного роста производительности,
• более 90% не заметили влияния на занятость.

При этом сами руководители уверены, что изменения всё же придут в ближайшие 3 года: ожидают роста производительности и сокращения части рутинных ролей, в первую очередь в поддержке, продажах и административных функциях (про программеров не вспомнили фух).

Так что, кажется, пока мы находимся в точке перестройки процессов. И главный навык для нас - не уметь кодить с ИИ, а уметь проверять, структурировать и эффективно поддерживать сложные системы, в которых он участвует.

🔗Ссылки на оригиналы:
• AI4SDLC Research 2025
• визуализация Карпаты по AI Exposure
• исследование NBER про влияние ИИ на экономику

Хорошего завершения весны!🌸

#полезный_ии@data_easy
AI4SDLC Research AI Research 2025: влияние AI на разработку ПО | AI4SDLC Итоги AI Research 2025: мета-исследование индустриальных работ и собственный опрос о влиянии AI на продуктивность, качество и инженерную культуру.
  • 🔥 13
  • ❤ 7
  • 👍 4
  • 🕊 3
Post #361 1.22K
LLM Interview Questions.pdf72 KB
И ещё накопилась очередная подборка вопросов к собеседованиям по NLP и отдельно по LLM 🦸‍♂️

👉 ТУТ 100 вопросов по самым разным темам, начиная с TF-IDF. Неплохой ресурс, чтобы освежить в памяти всё-всё с основ.

👉 А в PDF 50 вопросов уже чисто по LLM. Там повторяются базовые вещи про трансформеры, но гораздо больше прикладных тем: RAG, alignment, CoT, fine-tuning, типичные проблемы и прочее.

Больших успехов в больших моделях!🤗

#nlp@data_easy
#карьера@data_easy
  • 🔥 14
  • ❤ 8
  • 🙏 6
Post #360 966
🗣 Как поступить в онлайн-магистратуру в 2026 году?

Расскажем на Дне открытых дверей онлайн-магистратур ИДО ТГУ 👀

13 мая в 18:00 по московскому времени разберём:
🟦 как устроено обучение в онлайн-магистратуре;
🟦 чем магистратура отличается от курсов;
🟦 какие навыки нужны для поступления;
🟦 какие карьерные возможности открываются после выпуска;
🟦 как проходит приёмная кампания в 2026 году.


Отдельно расскажем о программах:
🔵 «Науки о данных и искусственный интеллект»
🔵 «Компьютерное зрение и искусственный интеллект»
🔵 «Искусственный интеллект и обработка естественного языка»


Также на встрече выступят руководители программ, и команда приёмной кампании ответит на вопросы о поступлении, сроках и формате обучения.

Если давно присматриваетесь к магистратуре, хотите сменить направление или разобраться, как войти в сферу искусственного интеллекта — приходите!

Регистрация по ссылке: https://clck.ru/3TbwDP
  • ❤ 5
  • 🐳 3
  • 🤝 2
Post #359 883
Привет, друзья!
Коллеги из НИ ТГУ проводят день открытых дверей онлайн-магистратур по ИТ-направлениям. В том числе расскажут про направление «Науки о данных и ИИ», где я участвую как эксперт.

Если вам интересны Data Science/ML/AI и хотите посмотреть, как устроено обучение - обязательно заглядывайте😊
  • ❤ 5
  • 👍 2
Post #356 1.21K
Привет, друзья!
Неделя как никогда насыщенная😁 Совместно с МФТИ выпустили статью на Хабре "ТОП-7 графиков для вашей презентации" - про оригинальные и нестандартные визуализации, которые упрощают понимание (а не наоборот).

В ТОП-7 вошли следующие графики:
• Bubble chart
• Treemap
• Heatmap
• Sankey
• Sunburst
• Radar chart
• Choropleth


А что они из себя представляют - подробно рассказываем в статье! Всё легко строится в Plotly, полную версию кода можете взять в ноутбуке.

Главное в построении графиков - не переборщить🙃

👉 Полный разбор тут
Хороших выходных!🌼

#аналитика@data_easy
  • ❤ 14
  • 🔥 9
  • ❤‍🔥 5
  • 🤩 3
  • 👀 1
Older posts →

About this channel

How can I read @data_easy without a Telegram account?
TGViewer shows the public web preview Telegram publishes for EasyData: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does EasyData have?
EasyData (@data_easy) has 1.37K subscribers on Telegram, refreshed roughly every 30 minutes.
Does EasyData know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →