TGViewer
Channel Public Channel
EasyData

EasyData

@data_easy

Добро пожаловать!
Меня зовут Мария Жарова, и это мой блог про науку о данных✨

Лайфхаки из будней MLщика, полезности по Data Science и ответы на вопросы, которые волнуют новичков и не только🌝

Автор @NaNCat
Subscribers
1.37K
Photos
185
Videos
12
Links
116

Showing posts older than #356 · Back to latest

Older Posts 16 shown
Post #355 983
Привет, друзья!
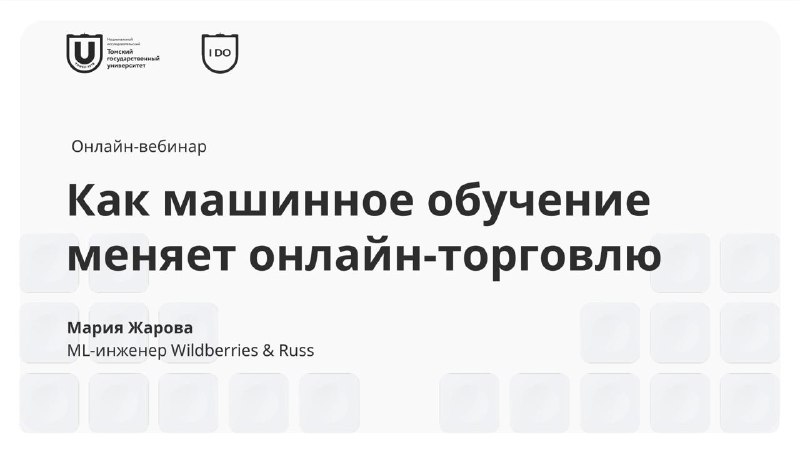
Давно хотелось обсудить что-то ближе к реальным продуктам - и вот наконец вместе с коллегами из Wildberries & Russ и Томского государственного университета собрали вебинар про рекомендательные системы в e-commerce💜 первый слайд презентации на картинке🙃

Встречаемся уже завтра, 30 апреля в 13:00 (мск).

План такой:
📱 обсудим, какие существуют типы рексистем и почему нет одной универсальной
📱 на простых примерах разберём основные подходы - что выбрать в зависимости от сценария и имеющихся данных
📱 посмотрим на типичные проблемы в рекомендациях и как с ними можно бороться на практике

В этот раз без кода - больше про логику и идеи, связь продукта и техники, как всё это реально применяется и с какими вызовами приходится сталкиваться 😎

Кстати, RWB и ТГУ запускают совместную онлайн-магистратуру по Data Science! Если задумываетесь про системное обучение с уклоном в практику - приёмная кампания на грядующий учебный год стартует 20 июня.

📱 Ссылка на регистрацию на вебинар: тык
📱 Подробнее про магистратуру RWB x ТГУ: тык
📱 UPD: запись будет в канале ТГУ


До скорых встреч! 🤗
  • ❤‍🔥 10
  • 🔥 7
  • ✍ 4
  • ❤ 2
Post #354 998
Привет, друзья!
Ответы немного задержались в пробке, но доехали 💨

Если обобщить, то во всех кейсах проблема не только в модели, но и в данных, постановке задачи и в том, как именно мы оцениваем качество.

❤️ Кейс 1 (NLP, RAG)
Основная мысль: одного хорошего retrieval’а недостаточно.

Recall@10 говорит лишь о том, что нужный документ где-то попал в десятку - но это вовсе не значит, что:
• он оказался достаточно высоко в выдаче и не потерялся среди других кандидатов,
• в контексте не было лишнего шума, и LLM действительно опиралась именно на нужный фрагмент (может, ТОП-10 вообще слишком много),
• финальный ответ получился фактически корректным - ведь в условии есть только метрики retrieval, но ничего не сказано про качество генерации.

То есть оффлайн метрика поиска и качество ответа - это разные уровни пайплайна.

Как исправить: смотреть не только на retrieval, но и на качество финального ответа, уменьшать шум в контексте и проверять, насколько модель реально опирается на источники. В чувствительных задачах ещё помогают цитирование и факт-чекинг.


❤️ Кейс 2 (NLP, классификация)
Тут тоже проблема не в самом BERT, а в валидации - из-за этого метрики были слишком оптимистичными и не соответствовали реальности.

Если случайно делить форумные тексты на train/test, легко получить утечку по пользователям - их стилю, повторяющимся формулировкам, темам или даже похожим сообщениям. Тем более раз часть авторов очень активная.

В таком случае модель на оффлайне может запоминать не только задачу, но и особенности конкретных людей. А в проде она может столкнуться с более реалистичным распределением, и качество на новых пользователях просядет.

Как исправить: строить сплит так, как модель будет работать в реальности - например, делить по пользователям, тредам или времени. И проверять, нет ли скрытых утечек или пересечений между train и test.


❤️ Кейс 3 (CV, детекция)
Здесь правда могли сыграть роль данные и разметка + команда могла не заметить проблему из-за неподходящей метрики.

Высокий mAP не всегда означает, что модель хорошо решает бизнес-задачу:
• мелкие дефекты часто детектируются хуже и теряются в общей метрике + усреднённая оценка может скрывать провалы на отдельных типах дефектов
• не самая точная локализация всё ещё может считаться "достаточно хорошей" - особенно по mAP@0.5

И вообще в производстве пропуск дефекта часто гораздо критичнее лишнего срабатывания - поэтому пороги и IoU-метрики важно подобрать под бизнес-ограничения.

Как исправить: конечно, перепроверить датасет, отдельно смотреть качество на выборке с мелкими дефектами и проверять, соответствуют ли IoU и метрики реальной задаче. Если нужна более точная локализация, можно вообще попробовать решать как сегментацию.


❤️ Кейс 4 (CV, классификация)
А тут подвох действительно очень классический: если сначала сделать аугментации, а потом случайный split - то в итоге одна и та же исходная картинка (пусть даже в разных версиях) может оказаться и в train, и в test.

Это даёт очень красивые метрики в оффлайне, но по сути модель уже подглядела часть теста во время обучения.

Как исправить: важно сначала разделять данные на train/test, и только потом уже делать аугментации(!) И вообще полезно следить, чтобы разные версии одного и того же исходного изображения не попадали в обе выборки - в таких случаях можно группировать данные по объекту/сцене/источнику.


Легкой рабочей недели! 🌱

#dl@data_easy
#nlp@data_easy
#cv@data_easy
#карьера@data_easy
  • 🔥 10
  • ❤ 3
  • ❤‍🔥 2
Post #353 1.16K
Привет, друзья!
Держите обещанные кейсы по NLP и CV - попробуйте догадаться, в чём здесь может быть подвох 🧐

😔 Кейс 1 (NLP, RAG)
Компания сделала внутреннего помощника для ответов на вопросы по базе знаний. Пайплайн - типичный RAG:
• сначала по запросу пользователя находятся 10 наиболее релевантных документов,
• а затем LLM формирует финальный ответ на их основе.

По оффлайн-оценкам всё выглядит весьма достойно: нужные документы в 99% случаях попадают в топ-10 при отборе, Recall@k радует.

Но в реальности оказалось:
• около 25% финальных ответов содержат фактические неточности (согласно оценкам пользователей)
• в ~15% случаев модель делает уверенные, но неверные утверждения

👉 Почему же оффлайн-метрики не гарантируют хороший финальный ответ? И что здесь можно улучшить - как в валидации, так и во всём пайплайне?


😔 Кейс 2 (NLP, классификация)
С небольшого форума собрали тексты сообщений. Из особенностей - пользователей не очень много, при этом часть из них довольно активна и пишет много ответов.

Решили обучить на этих данных модель классификации тональности: взяли предобученный BERT и дообучили его на сообщениях с форума. Примеров было достаточно, разметка корректная, дисбаланса нет - в плане данных всё чисто. Далее датасет случайно поделили на train/test, ну и обучили модель.

Результаты на оффлайне как всегда хороши:
• Accuracy около 0.95
• F1 высокий
• кросс-валидация тоже выглядит стабильно

Но после запуска качество стало заметно проседать.

👉 Почему же оффлайн-оценка оказалась такой оптимистичной и какой важный момент был упущен?


😔 Кейс 3 (CV, детекция)
Команда обучает модель для поиска дефектов на производстве. Модель выдаёт bounding boxes, на оффлайне всё неплохо:
• mAP высокий
• precision и recall тоже выглядят хорошо

Но в проде выясняется, что:
• мелкие дефекты модель часто пропускает
• иногда вместо точной локализации она рисует слишком большие области

👉 Почему метрики снова не отражают реальную эффективность модели? Что бы вы поменяли в постановке задачи или в оценке качества?


😔 Кейс 4 (CV, классификация)
Решаем обычную задачу классификации изображений: сначала датасет немного расширили с помощью аугментаций, дисбаланса не было -> затем набор случайно разделили на train/test -> взяли предобученную модель и дообучили её.

По оффлайн-оценкам всё выглядит почти идеально: accuracy около 99% и ошибок очень мало. Но в онлайне качество почему-то заметно хуже.

👉 Что здесь могло пойти не так?


Ответы придут в пятницу 😏

#dl@data_easy
#nlp@data_easy
#cv@data_easy
#карьера@data_easy
  • 🔥 10
  • ❤ 4
  • 👍 4
  • ❤‍🔥 1
Post #352 1.73K
Sebastyan_Rashka_Stroim_LLM_s_nulya.pdf8.4 MB
Привет, друзья!
Наткнулась на книгу, которую давно хотелось увидеть в таком виде - «Строим LLM с нуля» от Себастьяна Рашки 😔

В ней не про то, "как вызвать API и прикрутить RAG", а про честное устройство LLM изнутри. Вот что пишет сам автор:
Отличие этой книги от других состоит в том, что в ней подробно описан весь процесс создания большой языковой модели: от работы с наборами данных до реализации архитектуры модели, предварительного обучения на неразмеченных данных и тонкой настройки для конкретных задач. На момент написания книги ни один другой ресурс не предлагает такого полного и практического подхода к созданию LLM с нуля.

Материал по главам идёт довольно последовательно: сначала разбирают базу обработки текстов, трансформеры, вводят в PyTorch, а потом шаг за шагом собирают свою GPT-подобную модель - с кодом и описанием, что происходит внутри.

Отдельно понравилось, что в книге не ограничиваются обучением с нуля, а показывают, как работать и с предобученными весами, как адаптировать модель под задачи и даже как из генеративной модели сделать что-то более прикладное.

Для комфортного изучения авторы рекомендуют смотреть материалы тем, кто уже базово знаком с нейросетями и ML.

Вообще очень классный тренд на такие книги! Сейчас очень легко застрять на уровне "обернул всё в пайплайн и работает", но часто хочется более осознанно влиять на решение.

Pdf во вложении - полная версия книги.
Кто прочитает - пишите, как впечатления 🙂
С Праздником!

#dl@data_easy
#nlp@data_easy
  • ❤‍🔥 19
  • 🔥 12
  • ❤ 5
  • 👍 4
  • 🤩 1
Post #351 1.18K
Привет, друзья!
В дополнение к прошлому посту с мероприятиями держите ещё одну пометку в календарь на 15–16 апреля:
ФКН ВШЭ проводит онлайн-лекторий «Горячие клавиши в мир ИТ-возможностей»
🕸
Программа обещает быть насыщенной (посмотреть полностью можно тут), если коротко - за 2 дня пробегаемся по разным IT-направлениям с уклоном в data-профессии:
🧑‍🏫 про ИИ-агентов: от теории до прототипа собственного помощника
🤴 как внедряют ИИ в ритейле
🤴 технические секции про дашборды в DataLens
🧑‍🏫 роль аналитика на маркетплейсах и работа с данными в рекламе
🤴 no-code подходы и генерация приложений с ИИ
🤴 про карьеру в бигтехе и панельная дискуссия с экспертами

Я тоже выступлю с небольшим практическим мастер-классом про уже знакомый нам PyGWalker 🙂
Разберём:
🧑‍🏫 как уменьшить рутину в EDA и не писать десятки строк кода ради одного графика
🤴 когда классический стек pandas + matplotlib начинает тормозить
🤴 как превратить DataFrame в интерактивный BI-инструмент прямо в Jupyter

И покажу, как получить доступ к PRO-версии, если ещё не 😏

🧑‍🏫 15–16 апреля с 16:00 (мск)
🤴 Формат: онлайн
🤴 Ссылка на регистрацию: тык

До скорых встреч! 🤗
  • ❤‍🔥 13
  • 👍 10
  • 🔥 8
  • ❤ 2
  • 🐳 1
Post #350 1.38K
Привет, друзья!
Ближайшие пару недель обещают быть насыщенными на мероприятия ML и Data Science - держите небольшую подборку ближайших бесплатных конференций и митапов:

🚀 Data Fusion - уже ставшая известной конференция про данные, ML и AI с уклоном в индустриальные кейсы, в программе есть доклады и дискуссии на любой вкус
Когда: 8-9 апреля, офлайн + онлайн
Ссылка на регистрацию: тык

🚀 Data Summit - более "бизнесовая" конференция про работу с данными, data platform и AI в крупных компаниях: здесь про тренды, перспективы и насущные проблемы ИИ
Когда: 2 апреля, онлайн/офлайн
Ссылка на регистрацию: тык

🚀 ZVUK Research Meetup - небольшой, но любопытный митап с кейсами про рекомендательные системы, аналитику и исследования, в программе спикеры из Авито, 2ГИС и Звука
Когда: 2 апреля, Москва + онлайн.
Ссылка на регистрацию: тык

🚀 Dream Teamlead от Yandex - конференция про лидерство в IT-контексте: здесь доклады про эффективное управление + несколько интересных лекций про софты и полезные советы тимлидам
Когда: вчера, 28 марта:)
Посмотреть запись трансляции: тут

🚀 NVIDIA GTC - нельзя не упомянуть про ещё одну прошедшую конференцию по ИИ и ускоренным вычислениям от NVIDIA. В 2026 году она посвящена "физическому" ИИ - роботам, интеграциям в автомобили и производство + также агентным системам
Когда: 16-19 марта
Посмотреть записи трансляций: тут (видеозаписи доступны после регистрации, работает с любого email)

Приятного просмотра!

#полезный_ии@data_easy
  • ❤ 11
  • ❤‍🔥 5
  • 👍 5
  • 🔥 2
Post #349 1.35K
Привет, друзья!
Сегодня разберём громкую новинку уходящей недели - Gemini Embedding 2. Это первая омнимодальная модель от Google: она умеет мапить текст, изображения, видео, аудио и документы в единое векторное пространство.

👍 Технические детали:
- Длина вектора 3072, модель может принимать сразу несколько типов данных (но может и один).
- Есть ограничения по входу для каждой модальности:
• текст - до 8192 входных токенов
• изображения - до 6 файлов PNG или JPEG в одном запросе
• видео - до 120 секунд в формате MP4 или MOV
• аудио - принимается без транскрибации (обычно лимит ~80 сек, но здесь явно не пишут)
• документы - PDF до 6 страниц

- Доступ сейчас через Gemini API / Vertex (Public Preview) - а значит нужно учитывать квоты, биллинг, приватность данных и потенциальные задержки API.
- Благодаря MRL (Matryoshka Representation Learning) размерность эмбеддингов можно уменьшать без повторного вычисления.
- Отлично подходит для семантического поиска и мультимодального RAG.

👍 Но не спешите выбрасывать multi-vector архитектуры в окно!
Объединённый эмбеддинг удобен для общей семантики, но в реальных системах один объект всё равно часто представляют несколькими векторами - это помогает лучше решать разноплановые задачи и экономит время/место для простых задач (кстати, хранилища вроде Milvus тоже рекомендуют гибридные схемы).

Так что, Gemini Embedding 2 - важный шаг вперёд: единое пространство эмбеддингов для разных типов данных упрощает кросс-модальный поиск и RAG + позволяет быстрее собрать MVP.
Но в проде всё равно часто используют гибридные схемы - с доп. векторами, фильтрацией по атрибутам, а также ищут решения, которые можно запускать локально.

👍 Полезные ссылки:
• Официальный анонс
• Документация, Vertex и спецификации
• Ещё раз статейка от milvus


#полезный_ии@data_easy
  • 🔥 13
  • ❤ 3
  • 👍 2
Post #348 1.02K
Привет, друзья!
Время разбирать кейсы из прошлого поста 😔
Ниже скрыты разгадки…

🙂 Кейс 1 (про ранжирование)
Самая главная проблема: задача была про ранжирование, а модель обучалась как обычный классификатор.
Хоть такой подход и имеет место быть, стоит помнить, что ROC-AUC и LogLoss оценивают качество вероятностей - но не обязательно отражают качество порядка объектов. В ранжировании важно, какие статьи окажутся выше других, а не только насколько хорошо модель предсказывает вероятность клика в среднем.
Поэтому в первую очередь необходимо попробовать ранжирующие функции потерь (например, pairwise и listwise подходы), и на валидации оценить метрики ранжирования (NDCG, MAP, Precision@k).
Идеи взять более сложный алгоритм, учитывать популярность, временные факторы и т.п. также могут дополнительно улучшить модель:)


🙂 Кейс 2 (про калибровку вероятностей)
Почему так произошло? Идейно калибровка не меняет порядок объектов, а лишь монотонно преобразует вероятности, изменяя их распределение.
ROC-AUC как раз зависит только от порядка предсказаний и не зависит от порога - поэтому он почти не изменился. А вот Recall напрямую связан с порогом - и видимо, его старое значение перестало быть оптимальным.
Чтобы это исправить, достаточно просто переподобрать порог классификатора.


🙂 Кейс 3 (прогноз возврата товара)
Проблема кроется во фразе: “Команда обучила модель на данных за последнюю неделю…” Если таргет - возврат товара, то он, как правило, происходит через некоторое время после покупки. Поэтому если обучаться только на “самых свежих” данных, то для многих заказов возврат ещё просто не успел произойти - соответственно, такие покупки помечаются как returned = 0.
В качестве решения необходимо по историческим данным рассчитать типичную задержку между событием и таргетом и на её основе выбрать подходящий диапазон данных - чтобы обучаться только на заказах, для которых уже прошло достаточно времени, чтобы возврат мог произойти.


🐳 В следующий раз разбираем NLP и CV 🐳
Хороших выходных!


#карьера@data_easy
#classic_ml@data_easy
  • 🔥 12
  • ❤ 8
  • 🎉 2
  • 👍 1
Post #347 1.11K
Привет, друзья!
Сегодня вместо туториалов несколько реальных кейсов из жизни ML-щика. Попробуйте предположить, в чём могут быть проблемы 🧐

😔 Кейс 1 (про ранжирование)
Команда построила улучшенную модель (относительно текущей), которая ранжирует статьи на портале по вероятности клика.

Модель обучается как обычный бинарный классификатор: предсказывает вероятность клика для каждой статьи.

Offline-показатели (в т.ч. на валидации) выглядят отлично:
• ROC-AUC выше, чем у предыдущей версии модели
• LogLoss падает, переобучения нет

Но в онлайн-эксперименте CTR почти не вырос:(

👉 В чем проблема этой модели и как её улучшить?


😔 Кейс 2 (про калибровку вероятностей)
Есть модель бинарной классификации (например, обнаружение мошеннических операций). Команда решила откалибровать вероятности.

❤️Напомним: то что предсказывает классификатор - это "степень уверенности модели", а процедура калибровки переводит предсказания в интерпретируемые вероятности в математическом смысле.

После калибровки, на отложенной выборке:
• ROC-AUC почти не изменился
• Recall заметно упал...

👉 Почему это могло произойти и как исправить?


😔 Кейс 3 (прогноз возврата товара)
Модель предсказывает, вернёт ли пользователь товар после покупки. Таргет простой: returned = 1, если пользователь оформил возврат, и 0 - иначе.

Команда разработала улучшенную версию модели, метрики на offline-валидации получились отличными. Чтобы получить как можно лучшие результаты и в A/B-тесте, команда переобучила модель для тестовой группы на самых свежих данных за последнюю неделю.

Однако после запуска A/B-теста онлайн-метрики новой модели стали заметно проигрывать в первую неделю эксперимента...

👉 Где команда просчиталась?


Пишите ваши варианты в комментариях или в блокноте - в пятницу выложу ответы 😏
А если хотите кейсы из NLP или CV - ставьте 🐳

#карьера@data_easy
#classic_ml@data_easy
  • 🐳 26
  • 👍 7
  • ❤ 3
  • 🔥 2
Post #346 1.34K
Привет, друзья!
LLM хоть до сих пор и выглядят как «хайповая новинка», за последние пару лет вокруг них уже успело накопиться достаточно знаний, разборов и практических гайдов. Собрала несколько самых свежих/интересных материалов от статей до видеокурсов 😔

📝Hugging Face Smol Training Playbook
Компактный и прикладной гайд по обучению небольших и средних LLM: здесь всё про инфраструктуру, рецепты стабилизации и повышения качества в формате чек-листа.
Язык: english
Ссылка:
тык

📝 Alex Wa's Blog, Frontier model training methodologies
Более глубокий инженерный разбор того, как тренируют SOTA-модели. Можно освежить базу (трансформеры, лоссы, оптимизаторы), а затем погрузиться в современные архитектуры, этапы обучения и реальные инженерные приёмы - по сути, это мини-книга с множеством практических инсайтов.
Язык: english
Ссылка:
тык

📝 Курсы APXML
Тут найдёте огромную подборку мини-курсов: от базового Python до полного цикла работы с LLM. Есть как вводные материалы, так и про детали обучения, продакшен-аспекты и так называемый LLMOps. Всё в формате статей с указанием примерного времени прохождения - удобно планировать.
Язык: english
Ссылка:
тык

📝 GPT Week от Яндекса
Это относительно не новый плейлист лекций и демо по GPT-технологиям 2023 года. Но материалы остаются весьма актуальными - особенно для новичков или тех, кто хочет системно освежить фундамент.
Язык: русский
Ссылка:
тык

📝 LLM Scaling Week от Яндекса
А это свежий интенсив ноября 2025 с очень насыщенной программой: сначала теория, затем глубокое погружение в инфраструктурные вопросы, оптимизацию и инференс LLM. В описаниях к видео найдёте презентации и код - так что можно не просто слушать, а попробовать всё руками.
Язык: русский
Ссылка:
тык (видео доступны по ссылкам, список внизу страницы)

Стабильного обучения и быстрого инференса!

#nlp@data_easy
huggingface.co The Smol Training Playbook - a Hugging Face Space by HuggingFaceTB The secrets to building world-class LLMs
  • 🔥 20
  • ❤ 8
  • 👍 3
  • 🍓 3
  • 🙏 1
Post #343 1.36K
Привет, друзья!
Вышло очередное долгожданное исследование Habr-карьеры про ЗП IT-специалистов во 2-й половине 2025. Как всегда, можно посмотреть детализацию по языкам программирования, городам и направлениям - но отдельно про DS/ML снова не написали 😢

Однако благодаря логам нашего канала мы можем провести собственную аналитику 😏
Сравнение с точными прошлогодними цифрами для тех, кто назвал себя Data Scientist и ML-разработчик, можете оценить на первых двух скринах (указаны сумма ЗП и премий net). Общий вердикт таков:
• интенсивный рост остановился - в совокупности во всём IT в Москве медианная ЗП поднялась на 4%; если брать все города - не более чем на 2%
• в разрезе грейдов у джунов, стажеров и мидлов ЗП выросла; у сеньоров не особо; а у лидов упала (надеюсь, те кто выбыл из выборки, просто стали тех. директорами🙂)
• забавно, что у удалёнщиков не-джунов ЗП больше, чем у работающих в офисе! подтверждение на последнем скрине 😎
• на графике динамики ЗП производная >0, правда уже не такая большая по модулю относительно прошлого года 👋

По другому свежему исследованию HH.ru мы всё ещё сохраняем позиции в ТОПе самых высокооплачиваемых профессий: DS занял 2-е место с медианной ЗП 250k после... сварщика с ЗП 267k

Пишите ваши варианты, что случилось с лидами и почему удалёнщики больше ценятся:)

Всем хорошей недели и много 💸

#карьера@data_easy
  • 👍 13
  • ❤ 7
  • ❤‍🔥 2
  • 🕊 1
  • 🫡 1
Post #340 1.42K

Forwarded from МФТИ Digital

📊Создавать модели — недостаточно: как дата-сайентисту повысить свою ценность на рынке

Говорят, что сегодня дата-сайентист не только разрабатывает модели машинного обучения, но и помогает компаниям принимать решения и развивать технологии. Так ли это?

Редакция Пуска решила разобраться в этом вопросе и обратилась к Марии Жаровой, ML-инженеру в команде рекомендаций Wildberries и эксперту Центра «Пуск» МФТИ. В карточках Мария рассказала о востребованных навыках дата-сайентиста. 

⬇️ А в комментариях предлагаем поделиться, что сейчас влияет на вашу профессиональную ценность
  • 👍 13
  • ❤ 7
  • ❤‍🔥 5
  • 🙏 1
Post #339 1.15K
Поговорили с МФТИ о том, что нужно дата-сайентисту сегодня. Навыки, которые были полезны, становятся необходимыми😊
  • ❤‍🔥 5
  • 👍 3
Post #338 1.58K
Привет, друзья!
Занятный, но логичный факт: большинство AI-стартапов - это просто вызов LLM 🌚

Это выяснил инженер Теджа Кусиредди. Он решил проверить, сколько “прорывных ИИ-компаний” на самом деле имеют собственные модели. Для этого он проанализировал сетевой трафик, фронтовый код и API-вызовы примерно у 200 стартапов.
Результат оказался громким: около 73% не имеют своей ИИ-архитектуры. Под капотом просто вызовы к OpenAI, Claude и другим крупным провайдерам.

То есть формула получилась простая: LLM API + интерфейс + упаковка = AI-стартап.

Автор мониторил сетевой трафик приложений, смотрел SDK, разбирал JS-бандлы и отслеживал, куда реально уходят запросы. Поводом стало наблюдение за компанией, которая только что привлекла $4.3M - и при этом дёргала OpenAI API буквально каждые несколько секунд без какой-либо собственной инференс-логики.
Когда он масштабировал анализ, выяснилось, что это скорее правило, чем исключение… По статистике OpenAI выступает главным инфраструктурным слоем, Claude регулярно встречается как альтернативный бэкенд, а собственные модели - совсем редкость.

Сам факт использования API - не проблема; если продукт честно решает пользовательскую задачу, добавляет ценность поверх модели и не притворяется “новой AGI” - это нормальный продуктовый слой. Вопросы начинаются там, где стартап продаёт инвесторам историю про “уникальный AI-движок”, будучи по сути реселлером чужой модели.

Порог входа в AI-продукты сейчас настолько низкий, что многие “стартапы” из расследования можно собрать буквально за вечер. Я тоже решила проверить и накидала несколько десятков строк кода для тг-бота с запросами к бесплатному API - зацените! 😁

Оригинал расследования тут

Удачи вашим стартапам! 🥳🥳

#полезный_ии@data_easy
#nlp@data_easy
Google innovative_startup.ipynb Colab notebook
  • 🔥 16
  • ❤‍🔥 13
  • ❤ 2
  • 👍 2
  • 😱 1
Post #337 1.26K
Привет, друзья!
Если вы устали от медленного pip, сложных poetry.lock и зоопарка инструментов вокруг Python-окружений, то стоит посмотреть на uv.

🔥 uv - это современный менеджер зависимостей и окружений для Python, который написан на Rust. Почему это не очередной инструмент, а реально новая эра?

😐Все в одном бинаре: установка пакетов, создание и управление виртуальными окружениями, разрешение зависимостей, lock-файлы, запуск Python-команд в изоляции… раньше это приходилось собирать из pip, venv/virtualenv, pip-tools и poetry - а теперь достаточно только uv! Всего один бинарь, и ничего лишнего.
😐Скорость: Rust-реализация + собственная система расчёта зависимостей = мгновенные установки и пересборки, особенно на больших ML-проектах и при CI/CD. Говорят, что может достигать 100x по скорости в сравнении с pip!
😐Глобальный кэш: пакеты, уже скачанные для одного проекта, повторно используются и в других окружениях - как итог, меньше запросов и экономия места на диске.
😐Отличие от poetry / pip: uv не использует за основу существующие инструменты, а сам полностью управляет всем процессом. Это не только быстрее, но и гораздо более предсказуемо - lock-файл читаемый, стабильный и действительно воспроизводимый.

Главное тут, что uv не “оборачивает pip”, а заменяет его функциональность!

🔥 А основные команды до боли напоминают уже знакомые инструменты...

# установка самого uv
curl -LsSf https://astral.sh/uv/install.sh | sh
# проверка
uv --version
# создание окружения и установка зависимостей
uv venv
uv pip install numpy pandas scikit-learn


🔥 Полезные ссылки:
• официальная документация тут
• а для любителей покопаться в коде открыт официальный репозиторий

Вероятно, мы на пороге новой эры управления Python-зависимостями.
Всем продуктивного февраля!✨

#python@data_easy
#mlops@data_easy
  • 👍 11
  • 🔥 7
  • ❤ 5
  • ❤‍🔥 2
  • 😐 1
Post #336 1.62K
Привет, друзья!
Недавно наткнулась на классный образовательный ютуб-канал freeCodeCamp - кладезь уроков, многие из которых - полные университетские курсы от ведущих ВУЗов мира.
Ниже подборка видео по темам из DS и ML:

📚 Python с нуля
16-часовой курс от Гарварда по Python - от основ до ООП
➡️ ссылка

📚 Git для новичков
Свежее видео на 2026 про все основные команды за полтора часа
➡️ ссылка

📚 Алгоритмы и структуры данных
Целых 48 часов теории с примерами😱
➡️ ссылка

📚 Базы данных и SQL
Ещё один курс от Гарварда в одном 11-часовом видео
➡️ ссылка

📚 LLM с нуля
За 6 часов объяснение MoE, SFT, RLHF и разбор того, как обучаются современные LLM
➡️ ссылка

📚 Fine-tuning LLM
Продолжение темы: что, зачем и как дообучать, и где это вообще имеет смысл
➡️ ссылка

📚 Разбор Qwen
Отдельное видео про архитектуру и детали (здесь найдёте про muon)
➡️ ссылка

📚 Гайд по агентам
Если интересна агентная логика, пайплайны и взаимодействие LLM с окружением
➡️ ссылка

И конечно, всех с Днём Студента! Для нашей профессии пословица "век живи - век учись" особенно актуальна👩‍🎓

#python@data_easy
#nlp@data_easy
#classic_ml@data_easy
  • 🔥 29
  • ❤ 15
  • ❤‍🔥 1
  • 👍 1
  • 😍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →