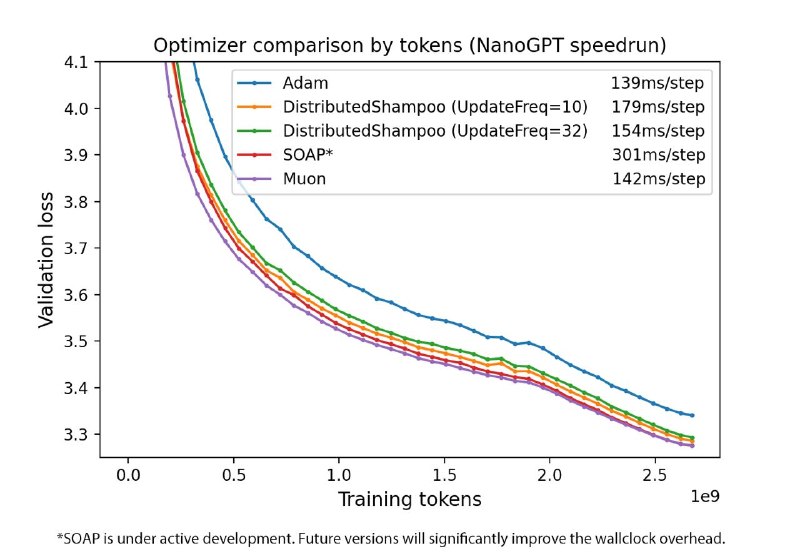
Adam и AdamW правят балом почти десять лет... Претенденты на замену были, но одно дело красивая идея на бумаге, и совсем другое - алгоритм, который реально закрепится. И вот появился Muon, который за последние 1.5 года тихо просочился в обучение крупнейших моделей. Давайте разберёмся, как он устроен! 🧐
🔠 Как было?
Классический градиентный спуск двигает все веса на один и тот же шаг вдоль антиградиента. Adam умнее: он хранит моментум (сглаженные предыдущие направления) + подбирает индивидуальный размер шага для каждого параметра, исходя из его истории. Но “взгляд” у него поштучный: каждый вес - сам по себе, а градиент по слою рассматривается как длинный вектор независимых чисел.
🔠 Как стало?
Например, веса полносвязного слоя записываются матрицей, физически она задаёт линейное преобразование (привет всем, кто спрашивал про практическое применение теории на парах по линалу✌️). Градиент по такой матрице весов тоже можно записать в матричной форме - а не вектором, как делают обычные оптимизаторы.
Так и поступает Muon: он берёт матрицу обновления (сглаженный моментумом градиент), оставляет её в родной матричной форме -> а затем превращает в ортогональную (как именно - вспомним ниже). Это основная идея, и отсюда пошло название: MomentUm Orthogonalized by Newton-Schulz.
🔠 Как ортогонализовать и зачем?
Есть проблема, что у матрицы обновления весов обычно пара направлений сильно доминирует, а остальные почти нулевые. Получается, обучение пойдет вдоль этих немногих осей, а вся остальная “ёмкость” слоя простаивает. Как раз с этим и помогает ортогонализация!
Теперь “как это реализуется”: вспомним SVD - он раскладывает любую матрицу на две ортогональные (которые задают повороты) + одну диагональную посередине (она задаёт растяжение/сжатие, числа на диагонали называют “сингулярными”). Ортогонализацией мы превращаем все сингулярные значения в единицу, как раз убирая проблему “перекоса”. За счёт этого шаг делается во все стороны поровну, и слой учится целиком.
🔠 Кто такой Newton-Schulz?
Итак, честно ортогонализировать матрицу можно через SVD - но высчитывать его на каждом шаге и для каждого слоя неподъёмно дорого... Поэтому, как обычно, пользуемся эвристиками: Newton-Schulz даёт почти тот же результат за несколько матричных умножений (а их видеокарта уважает). Обычно хватает 5 итераций - так что Muon вполне пригоден для реального обучения.
➕ Плюсы
• Быстрее сходится: примерно вдвое эффективнее AdamW по замерам Moonshot (они посчитали, что один прогон обходится в 2x дешевле).
• Экономит память: у Adam на каждый вес два состояния, у Muon - только моментум. Около трети памяти под оптимизатор долой.
➖ Минусы
• Применим только к слоям, где вес - это полноценное преобразование: например, полносвязные и attention. Но нормировки, свободные члены, выходной слой и эмбеддинги (обновляются построчно) учатся через AdamW.
• Каждый шаг дороже: Newton-Schulz добавляет матричные умножения, которых у AdamW нет. Шагов, конечно, нужно меньше, но с ростом модели расходы приходится отдельно оптимизировать.
• На больших моделях чаще всплывает нестабильность: значения внимания разгоняются и обучение может разойтись.
🤔 Это будущее?
Похоже, что да - Muon уже вышел из разряда экспериментов:
• Обучает топовые открытые модели: Kimi K2 (1 трлн параметров) и GLM-5 (744 млрд), DeepSeek-V4.
• Нестабильность научились лечить: например, Moonshot добавили приём MuonClip, который придерживает разгоняющиеся значения внимания.
• Уже адаптируется под инфраструктуру: NVIDIA встроила Muon в свой Megatron + команда DeepSpeed реализует поддержку.
• Оброс модификациями: за год вышли десятки ускоренных версий (Gram Newton-Schulz от Три Дао, NorMuon, Hierarchical Muon и другие) - так что направление живое.
🔗 Что почитать и где попробовать?
• Оригинальный пост Keller Jordan - с интуицией и картинками
• Референс-реализация
• Вывод "с нуля" для любителей математики
• Newton-Schulz в доках Modula - с визуализациями сходимости
Мораль такая: иногда научный прорыв - это не новая сложная формула, а свежий взгляд на привычное 🌿
#dl@data_easy