TGViewer
Channel Public Channel
Embedika | ИТ-решения для бизнеса

Embedika | ИТ-решения для бизнеса

@embedika

Научно-ориентированная ИТ-компания, разработчик корпоративных систем на основе технологий обработки естественного языка и машинного обучения. Data science, LegalTech, AI https://embedika.ru
Subscribers
472
Photos
1.1K
Videos
0
Links
465
Recent Posts 9 shown
Post #1301 68
Подборка полезных и интересных материалов

Господдержка ИИ-разработчиков, контроль над действиями агентов и экономика внедрения — в новой подборке собрали материалы о том, как отрасль решает вопросы регулирования, инфраструктуры и реальной отдачи от технологий.

Статьи:
📎 Материал «Ведомостей» о том, какие условия поддержки отечественных ИИ-разработчиков обсуждают в правительстве.
📎 Статья «Известий» о создании крупнейшими российскими технокомпаниями систем контроля за действиями ИИ-агентов.
📎 Публикация «Коммерсанта» о подорожании серверных комплектующих на фоне растущего спроса на ИИ.
📎 Интервью TAdviser с лидером направления «Сбер2B ИИ» об экономическом эффекте от ИИ-агентов и их практических задачах.
📎 Колонка Forbes о роли MCP и других протоколов для связки ИИ-агентов с сервисами.
📎 Колонка в Forbes о полной стоимости внедрения ИИ в бизнес.

Заметки: 
✍️ Презентации докладчиков с конференции «Яндекса» Deep Tech Night.
✍️ AvitoTech — о пути от LLM-портала до фабрики внутренних агентов и корпоративном ассистенте «Виталик».
✍️ Yandex Cloud & Infrastructure — об оптимизации инференса LLM: кешировании, времени ответа и GPU-ресурсах.
✍️ «Инфосистемы Джет» — об опыте передачи бухгалтерских процессов под управление ИИ.

Книги:
📚 «Человек + машина», Пол Доэрти, Джеймс Уилсон — о переосмыслении бизнес-процессов и создании новых рабочих мест с опорой на ИИ.
📚 «Искусственный интеллект на службе бизнеса», Аджей Агравал, Джошуа Ганс, Ави Голдфарб — как машинное прогнозирование снижает неопределенность и помогает принимать управленческие решения.

Подкасты:
🎤 «По проводам | MWS AI» — выпуск о цифровой трансформации промышленности и о том, где скрывается реальный экономический эффект.
🎤 «Путь ИИ» — выпуск о девяти принципах агентизации бизнеса и причинах провала большинства ИИ-пилотов.
  • ❤ 3
  • 🔥 2
  • 👏 2
  • 💯 1
Post #1300 72
Почему легкие модели обрабатывают большинство запросов к API

Мы продолжаем разбирать тренды из исследования AIANA RAI-2026 о рынке искусственного интеллекта России. В прошлом обзоре мы фиксировали ключевые цифры.
Сегодня разберем, как меняется спрос на модели и почему это важно для тех, кто внедряет ИИ в корпоративные процессы.

Еще недавно рынок выглядел как гонка за одной универсальной моделью. Сейчас же модели разделились на два класса, и у каждого своя задача.

✅ Фронтирные модели — для сложных рассуждений. Это тяжёлые модели, которые умеют работать с длинным контекстом и выстраивать многошаговые цепочки рассуждений. Они нужны там, где задача требует анализа, а не быстрого ответа.
✅ Лёгкие модели — для массовых, простых запросов. Они быстрее и дешевле, но не рассчитаны на сложные сценарии. 

В исследовании приведены данные по реальному использованию моделей через API: легкие модели занимают шесть позиций из восьми в топе по доле запросов и суммарно собирают 63% всех запросов при 34% токенов. Разницу объясняет длина задачи: тяжелой модели отдают 60-70 тыс. токенов контекста и длинную цепочку рассуждений, а легкой — 2-10 тыс. токенов, чаще всего это один шаг агента. 

Такой агент работает не одним запросом, а последовательностью шагов. Например, при подготовке ответа по внутренней базе документов он сначала находит подходящие источники, затем извлекает из них нужные фрагменты, сверяет данные между документами и только потом формирует итоговый ответ. Каждый шаг — отдельный вызов модели, и на него уходит немного токенов. Поэтому счет запросов растет быстрее счета токенов, а основную нагрузку берут на себя легкие модели.

Для компаний, которые внедряют ИИ в работу с документами и данными, этот тренд означает, что не все задачи необходимо решать через мощные и дорогостоящие модели.

Часть задач эффективнее и дешевле закрывать легкими моделями. А тяжёлые подключать точечно там, где действительно нужен глубокий анализ и длинная цепочка рассуждений.

Сегодня компании все чаще следят за тем, чтобы архитектура решения соответствовала задаче. Когда решение многократно обращается к модели, стоимость и скорость каждого из них становятся критичными.

#аналитика
  • 🔥 4
  • 👏 4
  • 💯 3
  • 👍 1
Post #1299 91
Галлюцинации ни при чем, качество ответа ИИ теряется еще на этапе запроса

Шаблонный или неточный ответ нейросети принято объяснять несовершенством технологий и галлюцинациями. Но часто причина кроется в самом запросе. Пользователь описывает задачу общими словами, а модель восполняет недостоющие вводные собственными предположениями.
В новой колонке для Techinsider Корней Мамруков, бизнес-аналитик в Embedika, разобрал, из каких элементов складывается запрос с предсказуемым результатом и что делать, когда одного промпта не хватает.

В статье разбираем ключевые причины неудачных запросов и приемы работы с ними:
▫️ Почему нейросеть додумывает требования к ответу, если не задать роль и критерии оценки результата;
▫️ Как одна фраза про уточняющие вопросы снимает несколько итераций доработки запроса;
▫️ Почему формулировки вроде «докажи, что...» заранее подсказывают модели нужный ответ и как получить объемную картину вместо односторонней;
▫️ Как декомпозиция и расстановка приоритетов помогают справиться с многоступенчатыми задачами;
▫️ Что делать с оценочными формулировками и почему стоп-лист работает лучше пожеланий;
▫️ Как учитывать ограничения памяти модели в длинных диалогах и когда проще начать новый.

🔗 Полная версия статьи — на сайте Techinsider

#сми_о_нас
  • ❤ 4
  • 🔥 4
  • 👏 2
  • 💯 1
Post #1298 82
Подготовка данных — обязательное условие эффективности корпоративного RAG

Контекст в компании распределен. Один и тот же процесс или объект могут описывать несколько документов: приказ, регламент, инструкция, шаблон. Эти документы живут в разных системах (СЭД, файловых хранилищах, порталах, почте) и редко синхронизируются между собой, а версии и приоритеты почти невозможно контролировать вручную.

Когда RAG-система получает запрос, она ищет ответ по всем доступным внутренним источникам. И если в базе одновременно лежат действующая и устаревшая редакции регламента, два противоречащих друг другу положения или разные версии одного договора, система найдет оба варианта, но не будет знать, какой из них правильный.

Поэтому главным фактором точности ответа становится не мощность модели, а проблемы источников:
➖ Противоречивые версии. Когда в базе есть и актуальная, и устаревшая редакция документа, RAG не может определить, какая из них действующая;
➖ Смысловые конфликты между документами. Регламент и инструкция описывают одну процедуру по-разному, при этом каждый документ по отдельности выглядит корректно.
➖ Разорванные связи. Документ ссылается на приложение, которого нет в системе, или на редакцию, которая уже заменена, поэтому ответ строится на неполном контексте.
➖ Неоднозначные формулировки. Условие допускает несколько трактовок, и модель выбирает ту, которая статистически вероятнее, а не ту, которая юридически верна.
➖ Некачественные сканы и метаданные. OCR распознал текст с ошибками, атрибуты заполнены неверно или отсутствуют — в таком случае ответ опирается на искаженный источник.

Отдельная проблема — права доступа. Если RAG не наследует ролевую модель из источника, он может показать сотруднику документ, который ему не предназначен. Из-за чего вопрос переходит в плоскость безопасности.

Начинать нужно с источников, т.к. пока в документах есть противоречия и устаревшие версии поиск будет менее результативным. Пошаговый порядок действий мы подробно разбирали в посте про аудит данных

RAG-система, построенная на непроверенных источниках — это не инструмент, а источник новых рисков. Сначала необходимо подготовить данные, а далее разрабатывать RAG. Без этого шага модель может ошибаться или предоставлять общие ответы на основе внутренних знаний.
  • 👍 4
  • 🔥 3
  • 👏 2
  • 💯 1
Post #1297 103
In-Context Learning — свойство языка, а не только архитектуры трансформера

Материал подготовлен на основе исследования от канала Ruslan Dev

Одно из ключевых практических свойств современных LLM — способность решать задачи, которым модель явно не обучалась. Достаточно нескольких примеров в промпте, чтобы модель смогла выучить их общий паттерн . Этот феномен называется In-Context Learning (ICL). Автор канала RuslanDev предлагает объяснение: ICL — это свойство структуры естественного языка, которое трансформер адаптирует через self-attention. Для бизнеса это важно, потому что объясняет, почему одни задачи LLM решают надёжно, а другие — нет.

Как работает attention
В классических нейросетях преобразования идут последовательно. В трансформере механизм attention устроен иначе: каждый токен формирует запрос, ключ и значение — что ему нужно, чем он полезен другим и что передаёт. Модель вычисляет, насколько запросы одних токенов соответствуют ключам других, и строит взвешенные связи между всеми токенами.

По сути, это граф: узлы — токены, рёбра — сила их взаимного влияния. Принципиальный момент: структура не задана заранее, а вычисляется из самих данных.

Аналогия с восстановлением функции
Задачу трансформера можно описать так: по отдельным точкам восстановить зависимость между ними. Чем больше точек — тем точнее результат. Точки — это токены контекста, правило восстановления — матрица внимания.

На практике это означает: качество ответа зависит от того, насколько хорошо подобран контекст — примеры, формулировки, структура промпта.

Почему это объясняет few-shot learning
Трансформер строит интерполяцию между примерами из контекста. Но по нескольким точкам произвольную функцию восстановить нельзя — это математический факт. Значит, распределение токенов языка не случайно: многообразие описывающих его функций ограничено и гладко. Именно это позволяет модели восстанавливать зависимость по малому числу примеров.

Для бизнеса это означает: LLM надёжно работают там, где язык подчиняется устойчивым закономерностям. Там, где данные хаотичны или предметная область плохо формализована, few-shot может давать сбои.

Почему это важно для внедрения

В классических моделях правило преобразования фиксировано. В трансформере оно вычисляется из данных — отсюда его зависимость от языка. Модели, где структура преобразования не зависит от контекста, не воспроизводят ICL.

Отсюда практические выводы:
— Качество промпта критично. Если контекст не отражает структуру задачи, модель не сможет восстановить нужную зависимость.
— Few-shot работает не везде. Задачи с хаотичными или плохо формализованными данными требуют дообучения или другого подхода.
— Выбор модели имеет значение. Не все архитектуры одинаково адаптируются к контексту — это влияет на надежность решений в продакшене.

С полной версией материала можно ознакомиться по ссылке.
  • 🔥 5
  • 👍 3
  • 👏 2
  • 💯 1
Post #1287 127
Системные ошибки управления в ИТ-проектах и правила, которые помогают их избежать

Успех ИТ-проекта не определяется выбором технологий или количеством ресурсов. Основные риски лежат в управленческих решениях и организации процесса. Арсений Блинков, руководитель проектов Embedika, на основе опыта реализации крупных проектов выделил несколько важных правил, которые помогают довести проект до результата.

👆 Делимся опытом в карточках
  • 🔥 9
  • 👏 4
  • 🎉 4
  • 💯 2
  • ❤ 1
  • ❤‍🔥 1
  • 👍 1
Post #1286 120
Диагностика данных — первый шаг к порядку в документах

Успешная трансформация работы с документами всегда начинается с объективной оценки текущего состояния. Прежде чем принимать решения о том, что менять, важно понять, с чем вы работаете сейчас.

Качество данных, их связность, соблюдение прав доступа, наличие устаревших версий и дублей — это определяет, какой объем работы предстоит и с какого процесса стоит начинать. Аудит помогает получить объективную картину текущего состояния документного контура и определить, с какого процесса или подразделения начинать изменения. 

Такой анализ включает несколько шагов:
карта источников и систем: где хранятся документы и какие из них участвуют в процессах;
выбор репрезентативного массива: на каких документах будет проводиться проверка;
анализ метаданных, версий, дублей и связей: насколько данные структурированы и связаны между собой;
проверка наследования прав доступа: соответствует ли ролевая модель требованиям безопасности;
выявление расхождений: где возникают противоречия между связанными документами и на что они влияют;
оценка текущего процесса поиска и работы с контентом: насколько быстро и точно сотрудники находят нужную информацию и каких бизнес-процессов это касается.

На выходе компания получает карту рисков и точек роста. Становится понятно, где данные дублируются, где теряются версии, где возникают противоречия между документами из разных систем. Это позволяет принимать решения о приоритетах и пилотных направлениях — с какого документального контура начинать изменения, какие метрики отслеживать и на что обращать внимание в первую очередь.
  • 🔥 3
  • ❤ 2
  • 👏 2
  • 💯 1
Post #1285 95
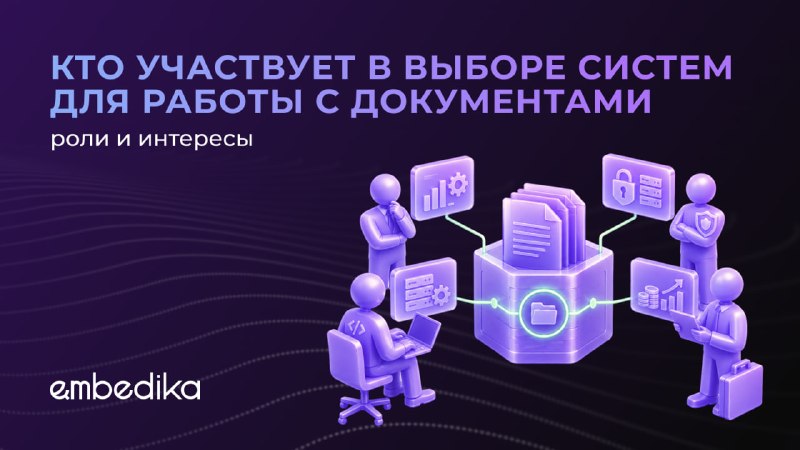
Почему выбор системы для документов — не только техническая задача

Внедрение нового инструмента для работы с документами и контентом часто воспринимается как техническая задача. На практике это процесс, в котором пересекаются интересы нескольких сторон, и каждая из них оценивает решение по-своему.

Понимать это важно до начала проекта. Функциональный заказчик хочет решить операционную проблему, ИТ-специалист думает об интеграциях и нагрузке на инфраструктуру, а руководство — об окупаемости. Если не учитывать это, решение может не получить необходимой поддержки.

Разберём ключевые роли и их ожидания:

1️⃣ Функциональные руководители (методологи, контракт-менеджеры, закупщики). Первыми сталкиваются с проблемой ручной проверки и высокой ответственности. Их интерес — решить конкретную операционную задачу, они инициируют запрос и заинтересованы в его реализации.
2️⃣ ИТ-специалисты и архитекторы. Оценивают интеграции, совместимость с существующими системами и стоимость поддержки. Их ключевой критерий — решение не должно создавать ещё одну систему, требующую отдельного обслуживания.
3️⃣ Служба информационной безопасности. Проверяет наследование прав доступа, хранение данных и отсутствие рисков утечек. Без их одобрения проект может остановиться на любом этапе.
4️⃣ Высшее руководство и директора цифровой трансформации. Оценивают отдачу от внедрения и наличие измеримых метрик для оценки успеха. Без понятного бизнес-кейса сложно получить финансирование.
5️⃣ Конечные пользователи. Оценивают удобство интерфейса и реальную пользу. Если решение сложное или неудобное, даже технически правильная система не будет использоваться.

Чтобы найти баланс между всеми этими интересами, важно на раннем этапе определить, кто будет принимать решение, а кто — влиять на него.

Функциональный руководитель, который инициирует запрос, помогает сформулировать проблему и собрать требования. Технические специалисты и ИБ-эксперты оценивают архитектуру и безопасность. Руководители задают критерии эффективности. Конечные пользователи проверяют решение на своих повседневных задачах.

Учет всех этих аспектов превращает выбор из технического вопроса в согласованное решение, которое работает на практике и приносит ощутимую пользу бизнесу.
  • 🔥 5
  • 💯 3
  • 👍 2
  • 👏 1
Post #1277 136
Рынок искусственного интеллекта в России: 316 млрд руб. и 883 компании

Агентство AIANA выпустило исследование RAI-2026, в котором впервые оценило российский рынок AI по данным отчётности компаний, а не на основе опросов или данных глобальных моделей. В отчёт вошли 883 компании — их суммарная выручка от продуктов и решений в сфере AI по итогам 2025 года составила 316,1 млрд руб.

👇 В карточках собрали главные цифры из этого отчёта, чтобы вы могли быстро ознакомиться с ключевыми выводами.

#аналитика
  • 🔥 8
  • ❤ 3
  • 💯 2
  • 👏 1
Older posts →

About this channel

How can I read @embedika without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Embedika | ИТ-решения для бизнеса: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Embedika | ИТ-решения для бизнеса have?
Embedika | ИТ-решения для бизнеса (@embedika) has 472 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Embedika | ИТ-решения для бизнеса know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →