TGViewer
Channel Public Channel
CTO для стартапов | Дмитрий Гончаров

CTO для стартапов | Дмитрий Гончаров

@ctoforstartups

Канал для фаундеров стартапов, которые хотят дойти от MVP до единорога без костылей!

В канале рассказываю:
• как найти баланс между скоростью, стоимостью и надёжностью разработки

Начни отсюда: t.me/ctoforstartups/16

Контакт: @DmitryCTO
Subscribers
34
Photos
2
Videos
0
Links
3
Recent Posts 20 shown
Post #33 231
Когда фундамент начинает требовать перестройки

В своей почти 20-летней карьере программиста я могу насчитать не так много моментов, когда приходилось реально расширять фундаментальные знания в области программирования.

Не просто выучить новый фреймворк или библиотеку, а именно расширить тот слой, на котором держится всё остальное.

Если оглянуться назад, такие переломные моменты были:

— Алгоритмы — с 7-го класса до 3-го курса универа, спортивное программирование на Pascal, C, C++.

— Программирование форм — когда впервые пишешь визуал, ставишь обработчики, и получается приложение, которое действительно что-то делает.

— Базы данных — момент, когда выносишь компонент во вне и начинаешь работать с ним на специализированном языке. SQL, документные, key-value — принцип одинаков.

— Веб-программирование — понимание сути клиент-серверного взаимодействия и того, что твоя программа может жить на сервере, а к ней обратятся по HTTP.

— Ассемблер — первый взгляд под капот, чтобы понять, что реально происходит с твоим кодом.

— IL-код C# — осознание, что есть прослойка между твоим кодом и машинными инструкциями.

— Операционные системы — когда на коленке пишешь свою и понимаешь, что такое прерывания, как программы взаимодействуют с железом.

— Линейная алгебра + программирование — прикладное применение в статистике и краевых задачах, когда математика и код начинают говорить на одном языке.

— Нейросети до хайпа AI — понимание принципов и направлений развития, ещё до прикладного бума.

Это был мой путь. У кого-то набор таких точек другой.

Но недавно я поймал себя на мысли:

последние 15 лет из этих 20 фундаментально нового я в себя не добавлял.

Всё строилось на том, что было заложено в универе и в первые годы практики. И это при том, что часть знаний я получил не из программы вуза, а решая прикладные задачи и читая книги.

Теперь же — момент, когда «докладывать сверху» уже не выходит.

Пришли новые методы: AI-агенты, MCP, новые стандарты коммуникации. И здесь уже нельзя просто «пощупать на практике» и сказать, что всё понятно. Без понимания, как это устроено внутри и как развивалось, ощущаешь себя в полутьме.

Да, можно продолжать работать «как раньше». Но тогда я останусь в стороне от природы происходящего.

А динамика последних месяцев поражает. За полгода Anthropic выкатил стандарт, который реально изменил рынок, и он уже доехал до версии 2.1.

И вот парадокс.

С одной стороны — кажется, в IT всё меняется катастрофически быстро. Каждую неделю маркетинг приносит «новую революцию».

С другой — если смыть слой хайпа, то по-настоящему фундаментальных сдвигов не так много. Это планомерное развитие тех самых базовых знаний, которые можно встретить в аналогах прошлых лет.

Революции — редкость, а ощущение, что они повсюду, — заслуга подачи, а не факта.

Возможно, в этом и есть настоящий вызов для нас, старых программистов: вовремя отличить мимолётный шум от момента, когда фундамент требует перестройки.
  • 👍 5
Post #32 190
CTO без рук — CTO без власти

Чем больше я погружаюсь в автоматизацию с помощью no-code и LLM, тем сильнее ловлю одну мысль:
если CTO сам не прошёл этот путь — он теряет силу.

Я не делегировал. Не поручил младшему разработчику.
Я сам решил задачу ревью pull request’ов через n8n, с контекстом, с подключением MCP, с моделью, которая действительно что-то понимает.
И внезапно началось совсем другое обучение.

Чтобы всё это заработало, мне пришлось разбираться:
– как работает LLM в деталях,
– чем внешний контекст отличается от встроенного,
– что давать в prompt, а что — подключать через MCP,
– как сжимать данные и куда деть всё лишнее, чтобы не мешало модели думать.

В какой-то момент я понял: прежнего багажа не хватает.
Фундаментальные знания, которые раньше позволяли уверенно держать интервью и легко менять язык разработки, — да, они помогают.
Но сейчас не про язык. Сейчас — про стэк, который меняет саму логику работы.

Или ты с этим стэком — и на волне.
Или просто наблюдаешь со стороны, как другие CTO растут быстрее, потому что понимают, как подключить «разум» к задаче.

Было ли сложно?
Да.
Было кайфово? Очень.

Поворотный момент — когда я увидел, сколько вариантов решений даёт один и тот же вопрос, если правильно работать с контекстом.
Это как заново учиться программировать — только быстрее, потому что фундамент есть. Но всё равно надо догонять.

Выводы:

1. Сам пройди путь.
Без личного опыта ты не соберёшь сильную команду. Не сможешь понять, кого нанимать и как оценивать.

2. Не прячься за «в команде есть специалисты».
Ты либо управляешь, либо наблюдаешь. Чтобы управлять — нужно понимать глубину. Иначе CTO превращается в бизнес-аналитика.

3. MCP, prompt, context, модель — это не buzzword’ы, а строительные блоки.
Научись собирать из них решения. Иначе останешься в прошлом. Быстрее, чем думаешь.


А вы уже пробовали на себе, что значит «CTO нового типа»? Или пока со стороны наблюдаете?
  • 👍 6
Post #31 159
Процессы в стартапе: меньше — значит больше

В прошлом посте я писал про бюрократию и как она душит стартапы. Хочу продолжить эту тему — но уже со стороны процессов.

Когда мы говорим “гибкость важнее строгости”, это не значит “хаос — хорошо”. Речь о том, что процессы нужно подбирать по размеру команды, а не копировать с больших компаний.

Например, мы в одном проекте сознательно упростили Scrum: синхронизировали спринты с релизами и отказались от идеального Agile, где всё по учебнику. Почему? Потому что:

– У нас была маленькая команда,
– У всех была высокая вовлечённость,
– И мы могли позволить себе не гоняться за ритуалами, а идти к результату напрямую.

Да, такие упрощения лишают каких-то “бонусов” от методологии — но зато дают эффективность здесь и сейчас. Это можно даже посчитать: меньше ресурсов уходит на синхронизацию, тестирование и поддержку окружений. Особенно если релизы идут почти руками, а команда может общаться напрямую без формальностей.

Стартап — это не про правильные процессы. Это про работающие процессы.

И чем раньше это осознаёшь, тем проще становится принимать решения. В том числе и неудобные, но правильные. В том числе и нарушать правила, если это помогает команде не тормозить.

Ваша методология — не религия. Это ваш инструмент. Подтачивайте его под себя.
  • ⚡ 3
  • 💯 3
  • 👍 1
  • 🔥 1
Post #30 113
Бюрократия, которую ты не просчитывал: как один пропущенный билет вывел меня из колеи

Сегодня я подавался на визу в Австрию.
У меня был почти идеальный комплект документов:
— отели,
— страховка,
— билет из Стамбула в Зальцбург,
— билет обратно в Таиланд через тот же Стамбул.

То есть всё, что должно волновать Австрию, — как я влетаю в Евросоюз и как вылетаю из него, — было на руках.
Но мне сказали: «У вас неполный пакет. Нет билета до Стамбула».

И я завис.
— А зачем вам вообще билет до Стамбула? Это же не Евросоюз. Это вообще никак не влияет на визу в Австрию.
Я прилетаю в Евросоюз из третьей страны.
У меня подтверждён вылет обратно.
Какая разница, как я попадаю в третью страну, из которой лечу в Евросоюз?

В VFS был абсолютно спокойный менеджер. Без агрессии. Просто чек-лист. Без этой бумаги — галочку не поставить.

И вот у тебя на руках бумажка, в которой ты подтверждаешь, что подаёшься с неполным пакетом документов.
Ты не злишься. Не паникуешь.
Ты просто теряешь опору.
Рационально ты понимаешь, что логика не работает.
Ты не пытаешься обмануть систему — ты просто не понимаешь, зачем ей билет в Стамбул, если у тебя всё ясно с въездом в ЕС.

Но VFS — это не консульство. Это машина.
Чек-лист.
И всё, что не по форме, — вне системы.
Никакого здравого смысла. Только формальность.

И вот ты сидишь. В голове начинает крутиться:
Почему я не забронировал билет до Стамбула? Почему не предугадал?
Хотя всё в тебе сопротивляется самой этой идее.
Зачем бронировать то, что не влияет на решение? Только ради галочки?

А потом — пауза. И понимание.
Ты просто переоценил уровень рациональности на другой стороне.

Вот в чём урок.
Ты можешь быть максимально логичным, спокойным, структурным —
но если перед тобой стоит человек (или система), у которой одна задача — сверить с формой,
твоя логика бессильна.

И дальше — две развилки:
— либо ты проговариваешь риск прямо в моменте и решаешь: «Окей, подаюсь так»;
— либо идёшь, покупаешь билет в Стамбул, которого тебе вообще-то не нужно, просто ради системы.

Я выбрал первое.
Но потом на пару часов вылетел из состояния.
Эта дурацкая галочка начала разъедать меня изнутри.
А если откажут? А если не поймут? А если не разберутся?

И в этот момент я себя поймал.
Зачем я это делаю?
Зачем возвращаюсь в ситуацию, которую уже прожил?
Почему даю системе разрушать мою фокусировку?

Сел, посчитал потери.
Финансовые — ок, пару тысяч батов.
Эмоциональные — огромные, если буду крутить это в голове.
Решил: подамся заново, если нужно. Зато не потеряю день своей жизни на самопожирание.

⸻

В стартапах — то же самое.
Ты выкатываешь MVP, у тебя всё логично, но форма не совпадает с ожиданиями.
Ты подаёшь на акселератор, но не хватает галочки в разделе «market size».
Ты обсуждаешь партнёрство, но в письме не хватает одного PDF.

И вот ты уже не о продукте думаешь, а о том, почему тебя не поняли.
Не трать на это себя.
В системе, где решения принимаются по форме,
лучше сыграть в форму. Или принять последствия — но осознанно.

⸻

Теперь я знаю: если перед тобой человек с чек-листом — не объясняй. Решай.
Либо выполняй. Либо отпускай. Но не застревай.
  • 💯 3
Post #29 94
Метрики — твой единственный способ управлять ростом, а не быть его жертвой

Каждый раз, когда получали траффик из маркетинговых каналов , повторялась одна и та же история.

Метрики? Да потом соберём.
Логирование? Вроде всё стабильно.
Нагрузку? Ну это ж ещё не прод.

А потом приходит рост… и вместе с ним — слепота.
Ты не видишь, где просадки, что тормозит систему и почему пользователи жалуются.

Один раз нам повезло. Перед масштабным запуском провели стресс-тест и заметили, что один из микросервисов не скейлится синхронно. Запросы приходили в очередь, а он — в одну трубу. При росте x10 нас бы просто раздавило. Но благодаря метрикам — мы успели.

С тех пор — одно правило:

Если ты не видишь цифры, ты не управляешь. Ты гадаешь.

И тут CTO и CEO очень похожи.
Путь в никуда — строить планы и принимать решения, не опираясь на данные.
Без цифр нет стратегии. Без стратегии — нет роста. Только хаос.

CTO, фаундер — неважно. Ты должен знать:
– Какой P95 у API при пиковой нагрузке?
– Где узкие места при росте?
– Как быстро скейлятся критичные сервисы?

Хорошая новость — появляются инструменты, которые на основе истории и AI сами подсказывают узкие места.
Сейчас тестирую такие в одном из проектов. Хочу понять: смогут ли они дать ту же уверенность, но с меньшими усилиями команды.

В любом случае — в основе всё равно данные.
Без них никакой AI не поможет.

📌 Хочешь кратного роста? Начни с цифр.
  • ❤‍🔥 1
  • 🔥 1
  • 💯 1
Post #28 100
Когда устройство — это не про мощность, а про то, как оно вплетается в твою жизнь

В школьные годы моим хобби было устанавливать ОС на домашний ПК.
Windows 98, Windows 2000, XP, Ubuntu, FreeBSD — я просто бесконечно переустанавливал их, иногда ради одного только процесса. Мне было важно разобраться, что стоит за разными системами. Это потом пригодилось на первой работе админом.

С тех пор я привык подбирать устройства строго под задачу.
Был период Windows Phone — когда нужен был просто "скайпофон". Потом Android, потом iOS. Без фанатизма — только практичность.

Три года назад я перешел с Windows на MacBook Air на M1. Легкий, тихий, автономный — всё, что нужно для путешествий и работы.
Да, поначалу раздражали привычки MacOS. Да, было тяжело. Но плюсы перевесили.

Позже купил прошку, в которой достаточно портов, окончательно привык и казалось забыл о "страданиях".

А потом... начались мелочи. Мне нужно было работать в Visual Studio, в Server Management Studio. И я понял, что тянуть это через Parallels неудобно.
Я заказал себе новый Windows-ноутбук. Вернулся к старой любви — ThinkPad.

И тут случилось самое интересное.

Я понял, сколько в моей жизни мелочей, которые были встроены в экосистему Apple — и которые я начал замечать только когда их потерял.

- Быстрая интеграция почты и звонков.
- Переброс ссылок между устройствами.
- Легкость без постоянного шума вентиляторов.
- Возможность работать без мыши.

И оказалось, что за удобство этих "мелочей" я готов страдать в 10% случаев, работая через RDP или виртуалку.
А не наоборот.

Настоящая ценность вещей раскрывается не сразу.
Пока не потеряешь — не поймешь, насколько они были важной частью твоего ритма.
И только опыт дает ответ, что стоит брать с собой в следующий этап жизни, а что — оставить.

Инсайты:
- Выбирайте устройство под реальную жизнь, а не под миф о характеристиках.
- Заранее невозможно оценить важность привычных мелочей — только через опыт и потери.
- Не существует универсального идеала — есть только идеал для вашей реальной задачи здесь и сейчас.
  • 👍 3
Post #27 77
Когда инструменты не выдерживают рост

На старте у нас всё было просто и удобно. Один сервер, Dokku, dev и прод в одной лодке. Контейнеры забирали ресурсы сколько хотели. Работало — значит, устраивало.

Но вот на горизонте появились первые серьёзные клиенты. Понимаем: пора переставать играть в песочнице. Нужно изолировать продакшн. Переезжаем в Яндекс Облако: управляемый Postgres, Kubernetes, автоскейлинг. Я ставлю девопсам задачу: развернуть окружение один в один, плюс настроить автоматическое масштабирование нод.

На бумаге всё выглядело как мечта. Но реальность быстро внесла коррективы. Ещё на внутреннем тестировании под нагрузкой вылезли первые пробои. Система ловила периодические даунтаймы. CPU и память — в порядке. А падал NATS, и за ним рушились все остальные сервисы.

Сначала я спокойно делегировал проверку девопсам. Ответ был стандартный: "Это просто NATS капризничает." Но что-то внутри не давало покоя. Лезу в логи — и картина становится яснее. Перед нами были не просто баги. Перед нами были две разные ошибки: тактическая и стратегическая.

Тактическая ошибка — спот-ноды.
Мы выбрали спот-инстансы. Дешевле, да. Но Яндекс мог в любой момент выдернуть сервер из розетки без предупреждения. Поднятие новой ноды занимало до четырёх минут — и за это время система успевала посыпаться, как карточный домик.

Стратегическая ошибка — архитектура NATS.
Этот сервис хранит своё состояние в памяти. А мы его начали горизонтально масштабировать. В результате любое колебание — и мы теряли события, рвали соединения, рушили стабильность. На таком фундаменте масштабироваться было всё равно что строить небоскрёб на зыбучем песке.

Решение принимали быстро. Изолировали NATS на отдельной микроноде без автоскейлинга, чтобы стабилизировать работу. Параллельно начали планировать переезд на управляемую Kafka — медленнее, но зато надёжно и с полноценным мониторингом из коробки.

И вот тут был настоящий кайф.
Не потому что «спасли ситуацию», а потому что вытащили проблему на свет и успели перестроиться до того, как ошибка ударила по реальным клиентам.

Инструменты, которые отлично работают на старте, чаще всего разваливаются в момент роста.
Масштабирование — это проверка на прочность всего, что вы собрали раньше. И если архитектура не выдерживает — виноваты не клиенты и не нагрузка. Виноваты ваши прежние решения.
  • ❤‍🔥 3
  • 👌 1
Post #26 57
Стартап без кода и без боли: как в 2025 году убить старые модели проверки гипотез

Ещё недавно запуск стартапа звучал как отдельная профессия. Прототипы, фуллстек-разработчики, месяцы работы ради первой гипотезы. Всё было долго, тяжело и дорого.

Сегодня всё иначе.

В 2025 году появился целый новый класс инструментов: Manus, DeepTurning, Cursor, ChatGPT с MCP-плагинами, no-code платформы для автоматизации флоу и аналитики. Стартап можно собрать как конструктор — быстро, без бесконечных ночных спринтов и дорогих команд.

Технический запуск нового решения сейчас строится иначе. На базу берём no-code платформу типа n8n, через неё интегрируем AI-ассистентов в типовой бизнес-процесс, подключаем базу данных вроде Clickhouse в облаке и даём бизнесу готовую конфигурацию с лёгкой возможностью кастомизации. Никакой тяжёлой разработки на старте — только сборка готовых блоков под конкретную боль.

Для этого нужна минимальная команда: no-code разработчик, который строит каркас и документирует работу, бизнес-аналитик, который помогает настроить интеграции и проверяет гипотезу на первых клиентах, и фаундер (опционально вместе с Sales-партнёром), который держит фокус на проблеме и росте. И да, это реальность — за 1–2 месяца можно собрать работающий MVP.

Мы сейчас сами идём по этому пути. Параллельно разрабатываем два решения в реальных нишах: собираем из готовых модулей, настраиваем AI-обработку данных, тестируем на первых бизнесах. Все технические детали, инструменты и шаги я буду раскрывать по ходу развития. Ниши пока приберегу. Чуть позже расскажу — будет интересно.

Главная мысль:
Сегодня идею стартапа проверяют не кодом, а скоростью. Найдите первых клиентов, решите их боль с помощью AI и no-code. Они довольны — значит, можно масштабировать. Нет? Отлично: вы это поняли за 1–2 месяца, а не за год.

Что важно помнить:

1️⃣ В 2025 году побеждает не тот, кто пишет больше кода, а тот, кто умеет собрать рабочее решение из лучших доступных компонентов.

2️⃣ Главный скилл фаундера — умение черри-пикить инструменты, выстраивать архитектуру и сразу думать о масштабировании.

3️⃣ Чем проще архитектура для первых бизнесов одного сегмента, тем легче потом масштабировать и расширять продукт.

4️⃣ Стратегия: запуск на коленке → первые продажи → реинвестирование в "коробку" → масштабирование.

В следующих постах я расскажу, какие инструменты реально сработали, какие ошибки мы допустили и как будет эволюционировать наше решение от MVP к платформе.

Оставайтесь на связи. Будет практично и без прикрас.

#стартап #aiflow #nocode
  • 🔥 2
Post #25 73
Когда стартап «завис» между фазами - что делать фаундерам?

1️⃣ Ты собрал команду, сделал MVP, потратил время, деньги, ресурсы. Но вот вы на перепутье:
— Метрики не позволяют идти к инвесторам
— Самоокупаемости нет
— Один или несколько фаундеров теряют веру или мотивацию
— Команда не может договориться, куда двигаться дальше

Я проходил это сам. Технически продукт был нормальный. Но не хватило маркетинга. И фокуса. Я пытался запускать проект как CTO на фуллтайме в найме, и одновременно строить с нуля. В какой-то момент стало понятно — я не вывезу.

Это часто недооценённый фактор: нельзя тащить стартап «в одного». Особенно если нет запаса по деньгам, времени и энергии. Комбинация «один человек — все роли — нулевой фокус» почти всегда заканчивается тем, что всё рассыпается.

2️⃣ Если команда всё ещё верит — можно попробовать рестарт. Пересобрать план, ужать фичи, сосредоточиться на одной гипотезе и дать себе чёткий дедлайн. Важно договориться, по каким метрикам вы примете решение «идём дальше» или «сворачиваемся».

3️⃣ Если часть команды теряет веру — стоит зафиксировать роли и обязательства. Кто остаётся в операционке? Кто остаётся как советник? Кто уходит полностью? Лучше проговорить это сразу, чтобы не было пассивной войны и обид.

4️⃣ Если никто не может продолжать, но бросать жалко — проект можно заморозить. Сохранить коды, доступы, минимальную инфраструктуру. Иногда спустя полгода всё оживает — с другим составом, другим фокусом или даже новым рынком.

5️⃣ Если все понимают, что пора заканчивать — это тоже результат. Принять, подвести итоги, написать postmortem, поблагодарить друг друга. Опыт провала — это тоже актив. Особенно если его разобрать и понять, где была ошибка.

6️⃣ В следующем посте я разберу, что делать, если команда не может договориться. Когда один фаундер тянет, второй сомневается, а третий молчит. Как выйти из тупика? Как принимать решение, если нет консенсуса?

Если ты уже был в такой ситуации — напиши, что сработало у вас. Это поможет тем, кто прямо сейчас стоит на этом распутье.
  • 👍 6
Post #24 71
Сингапур или Дубай? Как не перепутать глянец с системой
(и почему стартап без CTO — это Дубай)

Я был в обоих городах. И на первый взгляд — они похожи:
небоскрёбы, шопинг, вылизанная инфраструктура. Всё для туриста, всё с вау-эффектом.
Но когда начинаешь присматриваться — разница оказывается принципиальной.
1. Дубай — стартап без CTO
Всё сияет: топ-лендинг, красивая обёртка, шик.
Но как только появляется внешнее давление (например, ливень в 100 мм) — всё начинает сыпаться.
Ты стоишь в отеле, где вода течёт по стенам.
ТЦ затапливает.
Дороги парализованы.
Такое ощущение, что даже 20 мм воды были бы для города испытанием.
2. Сингапур — стартап, где CTO есть и система работает
Тоже небоскрёбы, но за ними — логика.
Я попал под ливень и прошёл весь центр не промокнув:
всё соединено навесами, канатка работает в дождь, такси ловится с первого светофора.
А когда едешь по городу — ощущение, что ты утопаешь в зелени.
Деревья повсюду. Даже вдоль хайвеев, даже между башнями. Это не декор — это философия.
3. Экология как часть подхода, а не фасад
Сингапур сейчас — один из лидеров по устойчивому развитию в Азии:
• 30% воды — повторное использование (NEWater)
• Солнечные панели — даже на воде
• Вертикальные сады, зелёные фасады, реальные парки в центре

Да, исторически было иначе — осушали болота, насыпали землю.
Но это было до тренда на устойчивость.
Важно не то, с чего ты начал, а куда ты повернул.
4. Еда. Маленький, но показательный маркер
Я не люблю шведские столы.
Но в Сингапуре — кайфовал.
Здесь ты выбираешь блюдо, и официант готовит его под твои вкусы.
А индийская кухня — на уровне лучших гастрономий мира.
5. Финансово
По ощущениям:
• Пхукет — X1
• Дубай — X2
• Сингапур — X3

Но в Сингапуре каждый цент оправдан.
Ты реально чувствуешь, за что платишь — за комфорт, за экологичность, за продуманность.

Вывод для стартапов:
Не страшно начать как Дубай — с фасада, продаж, внешнего блеска.
Главное — не проморгать момент, когда нужно включить CTO и строить как Сингапур.
Когда всё должно работать даже под ливнем.
Когда зелень — не декор, а система.
Когда устойчивость — не модное слово, а основа.

А ты был в таких проектах? Где начинали с глянца, но потом или просели… или вовремя перестроились?
  • 👍 7
Post #23 103
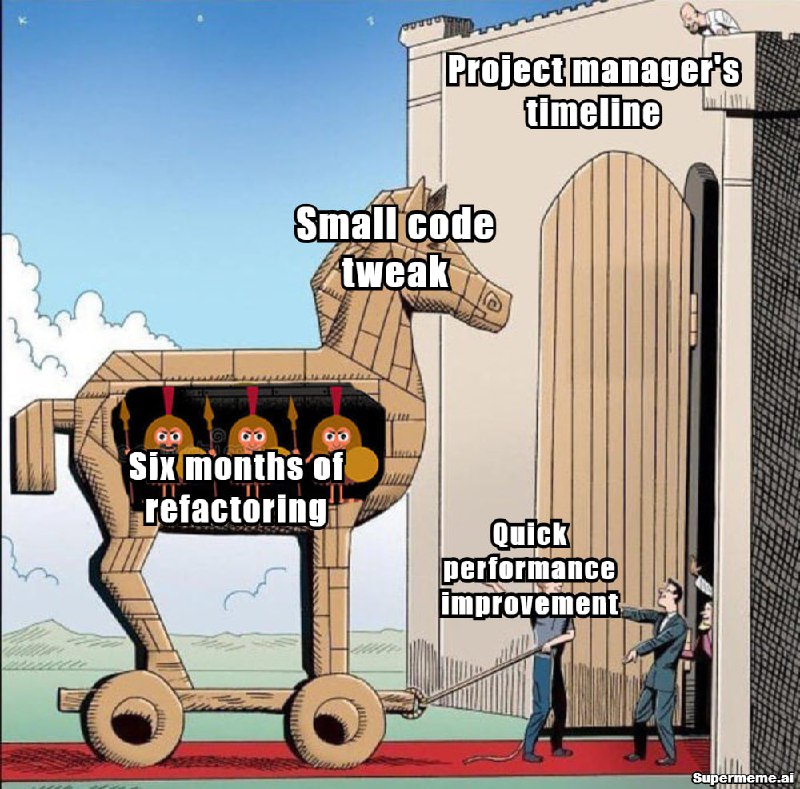
"Просто мелкий фикс" — а на деле полгода рефакторинга

На меме всё как в жизни:
PM видит небольшую задачу, обещающую быстрое улучшение производительности.
А внутри — шесть месяцев архитектурного рефакторинга, болезненных обсуждений и переносов сроков.
Никто не соврал. Просто взгляды разные.

И это повторяется чаще, чем кажется.

1️⃣ Разработчику больно смотреть на старый код.

Он хочет переписать «как надо». Это нормально — каждый инженер внутри себя борется за чистоту.
Но если фича только проверяется, и шансы на её выживание — 20%, такой рефакторинг превращается в роскошь.
Важно уметь задавать себе вопрос: это инвестиция или попытка почувствовать контроль?

2️⃣ PM видит задачу как точку в таймлайне.

Если ему не объяснить, сколько на самом деле стоит "улучшить процессинг", он не сможет адекватно планировать.
И не потому что глупый — просто внутри команды нет прозрачного механизма оценки глубины изменений.
А значит, нет доверия к аргументу "нам нужно пару недель, чтобы сделать нормально".

3️⃣ CTO — тот, кто держит рамку принятия решений.

Он не просто даёт ответ "да" или "нет". Он строит культуру, в которой:
— понятно, когда можно закостылить,
— когда стоит чуть переработать, чтобы код остался гибким,
— и когда пора закладывать архитектуру, потому что бизнес-модель почти доказана, и на этом фреймворке поедет весь следующий квартал.

Эта тема будет иметь продолжение. Потому что без таких рамок стартап быстро уходит в хаос, где «переделать» хочется каждый месяц — и никто не понимает, зачем это снова обсуждают.
  • 🔥 2
Post #22 125
Как я выбираю C-level партнёров (и почему часто отказываюсь)

Это не про найм — это про совместный полёт на нестабильном корабле, где каждый отвечает за свою часть панели управления.
Когда я думаю об инвестициях или вхожу в стартап как CTO, я первым делом смотрю не на продукт и даже не на рынок. Я смотрю на тех, с кем буду сидеть в кабине пилота, когда начнёт трясти.

1️⃣ Главное — кто с тобой в кабине и держит штурвал

Слишком много проектов рушится не потому, что идея была слабая. А потому что внутри команды — перекосы, туман в ожиданиях и старые обиды.
На уровне C-level это особенно критично. Нельзя просто "разойтись тихо". У каждого уже полномочия, репутация, ответственность, доля.
– Были ли у фаундеров конфликты в прошлом?
– Как они решают споры — через диалог или пассивную агрессию?
– Кто за них готов поручиться?
Удивительно, сколько можно узнать, просто копнув на два уровня глубже обычного общения.

2️⃣ Все формальности — это не про недоверие, а про уважение

– Самые разрушительные конфликты не из-за предательства — а из-за недосказанности. Один думал, что CTO «само собой» будет заниматься наймом, другой — что это задача CEO. И каждый был искренне уверен, что прав.
– Поэтому всё, что можно, мы фиксируем письменно на старте: как делим прибыль, кто принимает решения, что будет, если кто-то захочет выйти.
Важно проговаривать даже «неудобные» темы. Это не убивает доверие — это его создаёт.

3️⃣ Due diligence — не только для компаний, но и для людей

– В маркетинге давно поняли: чтобы продать, нужно 7 касаний. Чтобы доверять в партнёрстве — нужно больше. Я всегда стараюсь несколько раз поработать с человеком, прежде чем зайти в проект. Смотрю, как он ведёт себя в сжатые сроки, как реагирует на неопределённость, как слышит команду.
– И, конечно, подключаю нетворк: кто работал с ним раньше? Что говорят те, кто выходил из совместных проектов? Это мощнее любой презентации.

4️⃣ Доверие — это актив, а не эмоция

Все мы взрослые люди, и партнёрство — это не про то, чтобы всем было «по кайфу». Это про то, чтобы в любой момент можно было встать у белой доски и разложить всё по фактам.
Я ценю партнёров, которые не боятся говорить прямо: что их беспокоит, где не хватает ресурса, почему они хотят изменить направление. Такие разговоры — признак зрелости, а не конфликта.

5️⃣ Оцифровывайте не только продукт, но и отношения

Мы привыкли смотреть на метрики продукта: конверсии, retention, ARPU. Но для C-level команды метрики отношений — не менее важны.
– Кто сколько вкладывает времени?
– Кто сколько инвестирует?
– Какие KPI берёт на себя каждый?
Это не про контроль — это про прозрачность. Оцифровка помогает не искать виноватых, а держать курс.


📌 Где кейсы?
Они не для этого случая 🙂 Раскрывать такое на конкретных примерах было бы неэтично — слишком узнаваемо.
Но могу сказать честно: каждый поинт в этом посте — не теоретический. Всё было пройдено на практике, выстрадано, проверено и принято мной как правило.

Если хоть один из этих принципов отзывается — значит, мы с тобой уже на одной волне.
  • 🔥 5
Post #21 61
Стартап только на бумаге — а команда уже нужна. Что делать?

Один из самых простых (и в то же время недешёвых на старте) путей — это собрать свою собственную команду. Такой путь хорошо работает, если у вас уже есть инвестиции, вы нашли рабочую бизнес-модель и уверенно движетесь к проверке гипотез и первым продажам.

Это — классика жанра. Особенно на российском рынке: нанимаете 2–5 ключевых людей — разработчиков, тестировщиков, продакта — и строите продукт вместе. Всё под контролем, команда вовлечена, атмосфера старта чувствуется с первых дней. В следующих постах я покажу и альтернативы, но сегодня хочу подробно пройтись именно по этой классической схеме.

Главное условие успеха: стек технологий у вас должен быть понятный и популярный. Не стоит в начале придумывать что-то экзотическое, если вы не готовы тратить месяцы на найм. Если CTO не перемудрил, и рынок предлагает нормальных специалистов под ваш стек — идите по прямой. Собирайте свою команду.

Но тут же встаёт вопрос:
а как найти сильных кандидатов, если у вас ещё нет репутации, проекта на слуху и мощного HR-бренда?

На первом этапе всё зависит от фаундеров. Нетворк и ручной найм — вот два основных инструмента. У нас в проектах почти всегда фаундеры (или кто-то из C-level) уже давно сидят на HH. Сильный профиль, хорошие отзывы, релевантные вакансии — и вы начинаете привлекать внимание.

Я не публикую вакансии просто в "любой точке страны". Есть список городов, где сильная база по ИТ-школам и хороший поток кандидатов. Публикация идёт в этих регионах с удалёнкой. Хотите — напишите в личку, поделюсь этим списком, в открытую не выкладываю, чтобы никого не обидеть.

Сразу включаем продвижение: 1000₽ на старте, чтобы не ждать откликов неделями. Цена за клик — хороший ориентир: если она в пределах 5–10₽, значит, вы в рынке. Всё, что выше — уже тревожный звоночек. Возможно, вакансия плохо написана или выбрана не та площадка.

Теперь — самый недооценённый инструмент: авторазбор кандидатов.
У многих соискателей отклик автоматизирован, и просто "пара откликов" вам ничего не даст. Поэтому в саму вакансию включаем пару простых, но точных вопросов — по стеку и по зарплате.
Если вы можете, читая анкету и эти ответы, с 80% уверенностью понять, хотите ли общаться с кандидатом — вы сделали хорошую воронку.
Если нет — стоит переформулировать вопросы.

После авторазбора у нас остаются "тёплые" кандидаты. Те, с кем хочется поговорить, и кто максимально замотивирован. Для этого мы используем Reclaim — кандидат сам бронирует удобное время из ваших вариантов.
Первый созвон — технический, если речь о разработчике. Его проводит CTO.
Если это не техническая роль — выходит CEO.
На второй итерации оба фаундера общаются с кандидатом. На старте важно, чтобы каждый нанимаемый человек был "своим".

Когда выбор сделан, оффер отправляет CEO. Это не только про деньги, это про доверие, культуру, ощущения. И да — закрытие одной позиции обычно занимает не больше недели-двух. Главное — не тормозить, иначе лучшие уходят первыми.

Что я хочу донести этим постом:

Если у вас понятный стек, и вы точно знаете, кого хотите нанять — не бойтесь собирать команду сами. Вам пока не нужен HR. Но вам нужна система: авторазбор, быстрые звонки, внятная воронка и готовность быстро делать офферы.

И да, это только первый способ. В следующих постах покажу, как действовать, если времени нет, бюджета мало, а MVP нужен «на вчера».
  • 👍 3
Post #20 76
Писать или не писать документацию в стартапе

Когда только запускаешь проект — всё кажется важнее, чем документация. MVP, гипотезы, поддержка пользователей. Документация всегда «потом».

Но вот приходят новые разработчики — и тратят неделю, чтобы просто разобраться. Появляется баг — и никто не помнит, как должно было работать. И даже продуктовая гипотеза, которую провалили, остаётся без объяснения «почему так сделали».

Даже пару абзацев про то, что и зачем мы делаем — уже могут спасти ситуацию.

Какие есть варианты:

1. В Notion/Confluence — полная спека. В JIRA — задачи по реализации.

2. На каждую задачу — отдельная страница в Confluence, с ссылкой из JIRA.

Первый вариант даёт целостную картину, но быстро устаревает. Второй — проще поддерживать, но фокус теряется. В любом случае, информация устаревает. Это нормально. Стартап — это про быстрые повороты. И это надо учитывать.

Как оформлять документацию:

Или она отражает целевое состояние (куда идём — как бы «будущее»).

Или она фиксирует текущее состояние (что уже реализовано).

Если документация = «будущее», тогда это компас.
Если документация = «настоящее», тогда это карта.

Важно одно: если обновился продукт — обновилась и документация. Иначе всё быстро ломается.

А что с ресурсами?

Ресурсов нет. Ни времени, ни отдельного человека. Все работают с продуктом. Это норма.

Но даже в этом режиме можно:

- Нарисовать схему архитектуры.
- Описать направление развития.
- Сделать короткий гайд для новичков.
- Составить список ключевых задач и ссылок.

Этого хватит, чтобы:

- Снизить входной порог.
- Упростить обсуждения.
- Не теряться при смене приоритетов.

Если даже на верхнем уровне фиксировать, что мы хотели сделать и почему, — через год получится настоящая ретроспектива. Видно, какие гипотезы запускались, какие решения принимались, и как на это влияли метрики.

Получается, документация — не только «про сейчас». Это уже инструмент управления на основе данных. Источник решений. Вехи роста. Основание, чтобы объяснить выборы и избежать повторов.

Как вы подходите к документации? Или пока обходитесь без неё? Поделитесь, как у вас — интересно сравнить.
  • 👍 6
Post #16 164
[НАЧНИ ОТСЮДА ]

Канал для фаундеров, которые хотят вырастить стартап без костылей

В канале разбираю:
– как пройти путь от MVP до масштабируемого бизнеса, не сливая деньги и время
– как балансировать между скоростью, стоимостью и надёжностью разработки
– как не влезать в технический долг, который невозможно закрыть

Подписывайся на канал и забирай материалы по ведению технической части стартапа от CTO с 8-летним опытом и 20-ю стартапами

Что почитать:
• как выбрать архитектуру стартапа, которую недорого поддерживать
• какие тесты писать, чтобы ничего не падало
• как управлять техническим долгом, чтобы не тормозить развитие стартапа

———

Если ты хочешь, чтобы твой стартап стабильно рос и масштабировался, приходи ко мне на бесплатный аудит технологического стека и процессов

Для чего тебе этот аудит:
• понять, какие есть технические риски в процессах
• сформировать план, как можно оптимизировать свой стек
• ответить на вопросы по команде разработки

Мы с тобой созвонимся, обсудим техничку и у тебя появится план, что тебе делать со своим стартапом дальше

А после решишь — нужна тебе моя помощь или ты сделаешь всё силами своей команды 🙂

Для записи пиши мне в ЛС @DmitryCTO слово «аудит» и мы договоримся о встрече
Telegram CTO для стартапов | Дмитрий Гончаров 🚀 Архитектура стартапа: резиновая лодка, масштабируемый плот или флот кораблей? Когда запускаешь стартап, выбор инфраструктуры — это как решение, каким способом выйти в открытое море. Можно сесть в резиновую лодку, построить плот, который масштабируется…
  • 👍 3
  • 🔥 3
Post #15 85
Почему стресс-тесты и автотесты спасают стартапы

Недавно столкнулся с ситуацией, которая отлично иллюстрирует, почему технический долг может стать головной болью для CTO, а автотесты — настоящим спасением.

📌 Кейс
Мы разрабатывали систему без автотестов, небольшая команда, быстрый рост. Всё шло нормально, пока не пришло время обновления фреймворка. И тут началась гонка:
1️⃣ Поддержка старой версии — клиенты продолжают пользоваться продуктом, баги нужно фиксить.
2️⃣ Разработка новой версии
— переписываем всё с нуля, но новые фичи приходится добавлять сразу на обе версии.

Это похоже на ситуацию с рельсами и поездами 🚆:
Старые рельсы ещё в деле, поезда (пользователи) ездят, ломаются, их надо чинить.
Новые рельсы строятся, но если всех сразу пересадить на них, есть риск, что первые баги выкинут клиентов из системы.

💡 Как мы вышли из ситуации:

✅ Инвестировали в автотесты перед началом рефакторинга. UI-тесты и интеграционные тесты позволили сократить время до продакшна, ведь бизнес не может ждать годами. Они же уберегли нас от скрытых багов, которые сложнее найти вручную.

✅ Градусный переход клиентов. В микросервисной архитектуре можно постепенно переводить лояльных пользователей на новую систему, собирая фидбэк. Если что-то идёт не так — возвращаем их на старую версию.

⚖️ Вывод: CTO — это про баланс скорости и рисков. Даже если выбранная технология оказалась ошибкой, управляемый выход из ситуации возможен.

❓ А у вас были случаи, когда пришлось поддерживать старую систему, пока строили новую? Делитесь в комментах!
👇
  • 👍 3
  • ❤ 2
Post #14 100
Почему стресс-тесты — первый шаг к выживанию стартапа

Когда стартап выходит в прод, это всегда русская рулетка. Код писали в спешке, фичи выкатывали на «авось», и никто точно не знает, выдержит ли система нагрузку, если завтра в продукт зайдёт толпа пользователей.

Стресс-тесты — это ваш шанс не облажаться.

Как запустить стресс-тесты без боли
Чтобы не делать это в последний момент, просто сразу добавьте стресс-тесты в процесс. Делается это так:

- Выбираем ключевые сценарии
Что в вашем продукте самое критичное? Логин? Оформление заказа? Оплата? Выберите 2–3 самых важных пути пользователя.

- Определяем инструменты
Я люблю K6 + TypeScript — минимальный вход, хорошая интеграция с Prometheus/Grafana.
Если вам ближе Python — возьмите JMeter, но готовьтесь к боли в настройке.

- Встраиваем в CI/CD
Это важно! Стресс-тесты должны гоняться перед релизом, а не по настроению.
После каждого теста у вас появляются метрики: RPS, среднее время ответа, перцентили 95/99. Всё это загоняется в Grafana, и вы видите, как система реагирует на нагрузку.

Почему это окупается?

💰 Исправить баг до релиза дешевле, чем разбираться с упавшим продом.
📊 Вы накапливаете статистику и можете заранее спрогнозировать проблемы.
🚀 Убираете человеческий фактор — если что-то сломалось, вы узнаете об этом до пользователей.

Добавьте стресс-тесты в свою DevOps-практику, и ваш стартап будет готов к любой нагрузке.

А как у вас с этим? Тестируете нагрузку перед релизами?
  • 🔥 5
Post #13 83
Cloud-Agnostic против Проприетарных Ловушек: Разбираем на Примере Elastic Beanstalk

Вы когда-нибудь оказывались в ситуации, когда решение, которое должно упрощать вам жизнь, делает всё наоборот? Мы вот уже три недели боремся с AWS Elastic Beanstalk (хостинг Web-приложений), пытаясь настроить warm pool – механизм, который по идее должен ускорять масштабирование.

🔧 Задача: быстрое масштабирование системы.
⚙️ Решение: используем warm pool в Elastic Beanstalk, чтобы заранее подготовленные инстансы не ждали загрузки с нуля.
💥 Реальность: инстансы поднимаются, но при включении в пул ловят 500 ошибки, не позволяя системе корректно работать.

Что мы сделали?
– Подключили AWS поддержку.
– Провели десятки стресс тестов, создавая изолированные приложения без зависимостей.
– Выяснили, что разобраться сможет один инженер в AWS (либо через посредников типа DoIT), который будет ковырять сетап вручную.

В чем проблема?
Проприетарные облачные сервисы типа Elastic Beanstalk заманчиво выглядят на старте: автоскейлинг, упрощенная настройка, минимум DevOps-рутины. Но когда дело доходит до реальных кейсов, вы внезапно оказываетесь в клетке маркетинговых обещаний:

🚫 Проблема, которую можно было бы решить за пару дней в cloud-agnostic решении, здесь превращается в трехнедельный ад.
🚫 Вы жестко ограничены в инструментах – в отличие от Kubernetes, нельзя просто докинуть нужные плагины.
🚫 Вопросы, которые в Open-Source сообществе решаются тикетом в GitHub или Stack Overflow, здесь требуют дорогой поддержки от провайдера.

Это как купить Tesla и обнаружить, что зарядные станции есть только в вашей стране, а на выезде за границу – удачи, ищите розетку сами.

Cloud-Agnostic – это не про «чтобы было модно», а про свободу
Использование Kubernetes и других cloud-agnostic решений даёт ключевые преимущества:

✅ Гибкость – при проблеме с autoscaling мы просто нашли бы другой подход или плагин.
✅ Большое комьюнити – вместо одного AWS-инженера была бы армия разработчиков, уже решивших похожие кейсы.
✅ Экономия бюджета – стартовое вложение может быть выше, но в долгосрочной перспективе вы не платите за поддержку и несменяемый стек.

💡 Вопрос для CTO и основателей:
Вы выбираете шашечки (красивую маркетинговую обёртку) или ехать (реальную работоспособность и масштабируемость)?

Этот кейс – всего лишь одна из ситуаций, где закрытые решения создают технический и финансовый долг. В следующих статьях я разберу ещё нюансы, которые помогут стартапам экономить деньги уже на ранних этапах.

❓ Если хотите разобраться, какой сетап лучше для вашего проекта – напишите в личку, обсудим.
  • 🔥 1
Post #10 128
🔥 Когда хакеры не спят, а ты катаешь в Японии

История про то, как одно упущение может превратить ночь в экстренный разбор полётов.

Был январь, я катал в Японии. Отличный день, сил почти не осталось, швырнул телефон рядом с кроватью и отрубился.

Но… случайно не включил авиарежим.

📲 3 ночи. Телефон начинает вибрировать. Сообщение от команды.

🔴 Аларм от антивируса — уязвимость нулевого дня на одном из виртуальных серверов (EC2).

🤨 Но стоп. У нас же всё EC2 в приватной сети, порты закрыты! Откуда оно проникло?!

🚪 Открытые двери там, где их не должно быть
Пока экстренно гасили заражённый сервер, нужно было понять три вещи:
✅ Проник ли вирус на другие машины?
✅ Ушли ли переменные окружения наружу? Есть ли среди них критические секреты?
✅ Как вообще вирус попал внутрь? Какие порты были раскрыты?

💀 Итог:
EC2 по ошибке оказался в публичной сети. Представьте, что вы сняли офис в закрытом бизнес-центре, у вас охрана, пропускная система, всё по правилам… но вдруг оказывается, что одна дверь (порт) в ваш кабинет открыта прямо на улицу. Без замка. И первый же проходящий нашёл, чем воспользоваться.

Мы моментально скрыли машину за балансировщиками, но вывод был очевиден – ошибка в конфигурации чуть не стоила нам данных.

🛡 Когда к вам стучатся — лучше знать, кто за дверью
После этого мы сразу внедрили WAF – веб-экран, который проверяет, кто и зачем пытается зайти в систему. Правда, его нельзя просто включить на проде — это как поставить строгого охранника на входе в бизнес-центр, который может начать разворачивать не только злоумышленников, но и клиентов. Поэтому сначала тестили WAF на стейдже, проверяли, какие механизмы защиты можно применять без ложных срабатываний.

⚠️ Когда твоя система становится интересна хакерам?
Этот случай — напоминание, что чем успешнее ваш сервис, тем больше он привлекает внимание не только пользователей, но и злоумышленников.

Если у вас ещё не было аудита угроз и оценки рисков утечки данных – самое время этим заняться. Проверьте:
🔹 Какие "двери" у вас могут быть открыты?
🔹 Какие секреты лежат на "столе" в зоне видимости?
🔹 Есть ли "камеры", которые вовремя дадут сигнал об угрозе?

🚀 Вывод: Безопасность — это не то, чем стоит заниматься "потом". Если не хакеры, то случайное упущение может устроить вам бодрое утро в 3 ночи 😅

P.S. После этого случая я немного пересмотрел свой подход к "режиму не беспокоить". Теперь у меня специальный фильтр, который пропускает только суперважные звонки от ключевых людей и сервис ilert.com . Так что баланс между отдыхом и безопасностью — возможен 😉

А у вас есть уверенность, что все "двери" закрыты? Делитесь в комментах 👇
  • 👍 4
Post #9 59
🔥 Когда Elastic Beanstalk говорит: «I have a surprise for you»

За пару минут до старта масштабной маркетинговой кампании с «именем, которое называть нельзя» (NDA, дружище) казалось, что всё продумано до мелочей. Инфраструктура подготовлена, стресс-тесты пройдены, автоскейлинг настроен.

Но, как это бывает, жизнь внесла свои коррективы.

🟢 Картинка идеального мира
📞 Общий созвон с партнёрами, DevOps-ами и контракторами. Всё работает, все системы взаимосвязаны, сквозная аналитика по таймингам – красота!

Elastic Beanstalk (AWS-сервис для автоматического развертывания и масштабирования веб-приложений) должен был сделать всю работу за нас: если трафик растёт, он поднимет новые инстансы, балансировщик всё раскидает, и пользователи ничего не заметят.

Мы готовимся к плавному росту нагрузки, словно пилоты перед взлётом – полный контроль, приборы в норме.

Но потом...

🔴 БАХ!
📈 Нагрузка выстрелила экспоненциально за 3 минуты вместо ожидаемых 5–10. Наши триггеры автоскейлинга были настроены на 5-минутные интервалы.

Elastic Beanstalk начал поднимать новые серверы (EC2 – виртуальные машины в AWS), но тут начались сюрпризы:

❌ Поднятые инстансы оказались с некорректными правами – они не могли подключаться к критичным сервисам.
❌ Балансировщик не добавлял их в рабочую группу, потому что они не проходили Health Check.

🕰️ Результат: трафик растёт, а мощностей для обработки нет.

Это как если бы вы открыли новый аэропорт, но забыли нанять диспетчеров. Самолёты прилетают один за другим, но никто не говорит им, куда рулить.

⚡ План B (а потом C, D, E…)
В экстренном режиме пришлось:
🔹 Поднять клон окружения, отключить Enhanced Health Check, чтобы пропускать инстансы быстрее.
🔹 Врубить туда дополнительную мощность с запасом и оперативно перевести трафик.
🔹 Переключить балансировщик, чтобы нагрузка распределилась равномерно.

Elastic Beanstalk – штука крутая, когда всё идёт по плану. Но когда он начинает "думать за тебя", иногда проще перехватить управление вручную.

🎯 Не учебник, а чистый боевой экспромт. Но этот манёвр спас нас от катастрофы. Контракт в безопасности, клиенты довольны, а мы – почти без нервных срывов.

🛠 Выводы для CTO и DevOps
✅ Нагрузка может вырасти мгновенно – моделируйте жёсткие сценарии.
✅ Держите в запасе несколько планов действий. Если бы у нас не было второго плана, последствия были бы печальными.
✅ Elastic Beanstalk – удобно, но требует контроля. Не надейтесь на "мы же тестили" – в проде всё сложнее.

🚀 В общем, будь готов к любым сюрпризам. Лёгких и плавных запусков твоим проектам!

А у тебя было такое, что облако неожиданно подкинуло проблем? Делись в комментах! 💬
Older posts →

About this channel

How can I read @ctoforstartups without a Telegram account?
TGViewer shows the public web preview Telegram publishes for CTO для стартапов | Дмитрий Гончаров: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does CTO для стартапов | Дмитрий Гончаров have?
CTO для стартапов | Дмитрий Гончаров (@ctoforstartups) has 34 subscribers on Telegram, refreshed roughly every 30 minutes.
Does CTO для стартапов | Дмитрий Гончаров know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →