TGViewer
Channel Public Channel
C# Geeks (.NET)

C# Geeks (.NET)

@csharpgeeks

Subscribers
550
Photos
157
Videos
4
Links
177

Showing posts older than #714 · Back to latest

Older Posts 20 shown
Post #713 347
Post #712 440
یک متنی خواندم که خیلی نظرمو جلب کرد.
تا حالا دقت کرده‌ای چرا پل‌ها را برای روزهای عادی طراحی نمی‌کنند؟
در بیشتر روزهای سال، پل فقط وزن چند خودرو را تحمل می‌کند.
اما مهندس سازه، پل را برای همان روز طراحی نمی‌کند. او به روزی فکر می‌کند که ترافیک سنگین باشد.باران شدید ببارد.باد شدید بوزد.یا یک کامیون سنگین از روی آن عبور کند.

اگر پل فقط برای شرایط عادی طراحی شود،
در اولین شرایط غیرعادی، ارزشش را از دست می‌دهد.

آیا نرم‌افزار هم دقیقاً همین‌طور است؟
یعنی مهندس نرم افزار از اول تمام نیاز هارو شناسایی و همشون رو پیاده سازی میکنه؟
برداشتتون از این موضوع چیه؟
نظراتتون واقعا برام ارزشمنده🫶🏻
Post #711 359
🔍 چرا شرکت‌های بزرگ یک Search Service جداگانه می‌سازند؟

اوایل پروژه همه چیز ساده است.
کاربر عبارتی را جستجو می‌کند و با یک LIKE یا ()Contains روی دیتابیس، نتیجه برمی‌گردد.
اما وقتی حجم داده‌ها زیاد می‌شود، ناگهان هر سرویس شروع می‌کند به پیاده‌سازی Search، Pagination، Ranking، Filter، Autocomplete و Full-Text Search.
همین‌جاست که مفهوم Search Service وارد می‌شود.
به جای اینکه هر سرویس خودش مسئول جستجو باشد، یک سرویس مرکزی فقط روی Search و Indexing تمرکز می‌کند.
هر سرویس منطق Search خودش را دارد.
🏗 معماری با Search Service
                    Search Query
↓
Search Service
↓
Elasticsearch / OpenSearch
↑
Search Index

┌──────────┼──────────┐
↓ ↓ ↓
Service A Service B Service C
│ │ │
└──── Publish Events ─────┘

تمام سرویس‌ها فقط داده‌های خود را به Search Service ارسال می‌کنند و کاربران نیز تمام جستجوهای خود را از طریق همین سرویس انجام می‌دهند.
✅ مزایا
1️⃣ سرعت بسیار بالا

ءSearch Engineها برای جستجو طراحی شده‌اند، نه Databaseهای رابطه‌ای.
حتی روی میلیون‌ها رکورد نیز پاسخ در چند میلی‌ثانیه برمی‌گردد.
2️⃣ Full-Text Search

امکاناتی مانند:
• Fuzzy Search
• Typo Tolerance
• Stemming
• Synonym
• Ranking
• Relevance Score
به صورت پیش‌فرض در اختیار شما قرار می‌گیرد.
3️⃣ حذف بار از Database

دیگر Queryهای سنگین Search روی دیتابیس اصلی اجرا نمی‌شوند.
در نتیجه:
• Load کمتر
• Response Time بهتر
• Performance بیشتر
4️⃣ جستجوی یکپارچه

فرض کنید سیستم شما شامل:
• Articles
• Products
• Users
• Orders
باشد.
کاربر فقط یک بار Search انجام می‌دهد و نتایج از تمام سرویس‌ها برمی‌گردد.
5️⃣ قابلیت توسعه بالا

به راحتی می‌توانید اضافه کنید:
• Autocomplete
• Suggestion
• Highlight
• Faceted Search
• Geo Search
• Semantic Search
بدون اینکه Business Serviceها تغییری کنند.
6️⃣ قابلیت Ranking
می‌توانید تعیین کنید:
• محبوب‌ترین نتایج
• جدیدترین
• مرتبط‌ترین
• پربازدیدترین
در ابتدای لیست نمایش داده شوند.
❌ معایب
1️⃣
Eventual Consistency

نتایج Search همیشه لحظه‌ای به‌روز نیستند.
ممکن است چند ثانیه طول بکشد تا Indexها بروزرسانی شوند.
2️⃣ پیچیدگی بیشتر

باید مفاهیمی مانند:
• Index
• Mapping
• Analyzer
• Shard
• Replica
• Reindex
را مدیریت کنید.
3️⃣ نیاز به همگام‌سازی داده‌ها

هر تغییری در دیتابیس باید وارد Search Index نیز شود.
4️⃣ هزینه بیشتر

نگهداری Elasticsearch یا OpenSearch منابع سخت‌افزاری قابل توجهی نیاز دارد.

🚀 ءFlow اصولی پیاده‌سازی
مرحله 1️⃣
کاربر اطلاعات جدید ثبت می‌کند.
POST /articles

مرحله 2️⃣
ءBusiness Service اطلاعات را داخل Database ذخیره می‌کند.
مرحله 3️⃣
یک Domain Event منتشر می‌شود.
ArticleCreated

مرحله 4️⃣
ءSearch Service این Event را دریافت می‌کند.
مرحله 5️⃣
اطلاعات داخل Search Index ذخیره می‌شود.
Elasticsearch
OpenSearch

مرحله 6️⃣
کاربر درخواست Search ارسال می‌کند.
GET /search?q=DDD

مرحله 7️⃣
ءSearch Service نتایج را از Index خوانده و به Client برمی‌گرداند.

📋 نکاتی که حتماً باید رعایت شوند
🔸 ءSearch Database را جایگزین Database اصلی نکنید.
🔸 از Event-Driven Architecture برای بروزرسانی Index استفاده کنید.
🔸 ءQueryهای Search مستقیماً روی Database اجرا نشوند.
🔸 ءIndexها Version داشته باشند.
🔸 برای عملیات Reindex برنامه مشخصی داشته باشید.
🔸 ءMappingها را از ابتدا با دقت طراحی کنید.
🔸 از Analyzer مناسب برای زبان‌های مختلف استفاده کنید.
🔸 ءShard و Replicaها بر اساس حجم داده تنظیم شوند.
🔸 ءMonitoring برای وضعیت Indexها فعال باشد.
🔸 در صورت خطا، عملیات Indexing قابلیت Retry داشته باشد.

⭐️ برای بهتر شدن Search Service چه کارهایی انجام دهیم؟
✅ Incremental Indexing
✅ Background Indexing
✅ Event-Driven Synchronization
✅ Autocomplete
✅ Search Suggestions
✅ Highlight Search Results
✅ Faceted Search
✅ Geo Search
✅ Semantic Search با AI
✅ Synonym Dictionary
✅ Spell Correction
✅ Cache نتایج پرتکرار
✅ Distributed Search Cluster
✅ Zero-Downtime Reindex

🔖هشتگ‌ها:
#search #elasticsearch #opensearch #eventdriven #fulltextsearch
Post #710 322
#تصمیم‌های_مهندسی (Engineering Decisions)
یکی از تصمیم‌هایی که تقریباً هر تیمی دیر یا زود با آن روبه‌رو می‌شود، این است:
«آیا برای این قابلیت، از Cache استفاده کنیم یا نه؟»
جالب است که در بسیاری از تیم‌ها، این سؤال زمانی مطرح می‌شود که Performance افت کرده است.
اما سؤال درست، چیز دیگری است.
«آیا اصلاً مشکل ما، نداشتن Cache است؟»
بارها دیده‌ام اولین راه‌حل پیشنهادی برای کاهش زمان پاسخ، اضافه کردن Redis یا Memory Cache بوده است.
در حالی که بعد از اندازه‌گیری مشخص شده:
ءQuery اشتباه نوشته شده است.
ءN+1 Query رخ می‌دهد.
یک API خارجی گلوگاه سیستم است.
یا حتی بخش زیادی از زمان صرف Serialization می‌شود.
در چنین شرایطی، Cache فقط صورت مسئله را پنهان می‌کند.
نه اینکه آن را حل کند.
به همین دلیل، تصمیم استفاده از Cache نباید یک تصمیم Performance باشد.
باید یک تصمیم معماری باشد.
یعنی قبل از هر چیز باید بدانیم:
آیا داده به اندازه کافی پایدار است؟
آیا Consistency لحظه‌ای برای Business اهمیت دارد؟
هزینه Invalidating Cache چقدر است؟
اگر Cache از دسترس خارج شود، سیستم چه رفتاری خواهد داشت؟
اگر جواب این سؤال‌ها روشن نباشد،
اضافه کردن Cache، بیشتر شبیه قرض گرفتن از آینده است تا بهینه‌سازی.
چون در مهندسی نرم‌افزار،
بهترین تصمیم همیشه این نیست که سیستم را سریع‌تر کنیم.
گاهی بهترین تصمیم این است که اول دلیل کند بودن آن را بفهمیم.
Post #709 330
Post #708 358
#مهندس_فکر_کن
قسمت:5️⃣

🎯مصاحبه‌کننده:
فرض کنید مسئول طراحی یک Notification Platform هستید.
این سیستم از یک Provider برای ارسال SMS استفاده می‌کند و تمام پیامک‌ها از طریق یک Message Broker پردازش می‌شوند.
سناریو
هر روز ساعت 17:00 باید برای حدود 7 میلیون کاربر پیامک واریز سود ارسال شود.
معماری فعلی به شکل زیر است:
                Producer
│
▼
SMS Queue (FIFO)
│
▼
SMS Consumers
│
▼
SMS Provider

هم‌زمان با شروع ارسال این 7 میلیون پیامک، کاربران نیز وارد اپلیکیشن می‌شوند و درخواست OTP Login می‌دهند.
اما کاربران متوجه می‌شوند که کد OTP بعد از 20 تا 40 دقیقه به دستشان می‌رسد، چون پیام OTP پشت صف 7 میلیون پیامک قرار گرفته است.
سؤال
اگر معمار این سیستم باشید، چگونه آن را طراحی می‌کنید تا:
ءOTP حداکثر در چند ثانیه ارسال شود.
ارسال 7 میلیون پیامک نیز متوقف نشود.
هیچ دسته‌ای از پیام‌ها باعث Starvation دسته دیگر نشود.
سیستم در آینده بتواند انواع Notificationهای جدید را نیز پشتیبانی کند.
Post #707 333
🛡 اگر تیمت از اشتباه کردن جلوی تو می‌ترسد، از قبل سقف رشدش را مشخص کرده‌ای.
من به Psychological Safety به چشم یک واژه‌ی مد روز نگاه نمی‌کنم. وقتی مسئول هدایت یک تیم هستی، این یکی از ملموس‌ترین وظایفی است که بر عهده داری.
افراد باید بتوانند ایده‌ای را امتحان کنند، اشتباه کنند و دوباره بلند شوند؛ بدون اینکه نتیجه‌اش تحقیر شدن باشد. 🤝
نکته‌ای که همیشه سعی می‌کنم فراموش نکنم این است:
ساختن اعتمادبه‌نفس یک نفر، به زمان، انرژی و تلاش زیادی نیاز دارد؛ اما نابود کردنش، گاهی فقط به یک واکنش اشتباه نیاز دارد.
یک برخورد نامناسب جلوی اعضای تیم، می‌تواند اعتمادی را که ماه‌ها برای ساختنش زحمت کشیده‌ای، در چند ثانیه از بین ببرد. 💔
به‌عنوان یک رهبر، چه بخواهی و چه نخواهی، تو فرهنگ تیم را شکل می‌دهی.
واکنش تو به یک اشتباه، مخصوصاً زمانی که در مقابل دیگران اتفاق می‌افتد، به تمام اعضای تیم این پیام را می‌دهد که:
«آیا اینجا واقعاً جای امنی برای ریسک کردن و یاد گرفتن هست یا نه؟»
این به معنی نبود مسئولیت‌پذیری (Accountability) نیست.
اشتباه کردن با تحقیر شدن، دو مفهوم کاملاً متفاوت هستند.
وقتی افراد بدانند که می‌توانند بدون ترس از سرزنش یا تحقیر شکست بخورند، حاضر می‌شوند ریسک‌های هوشمندانه‌ای انجام دهند که باعث پیشرفت تیم و محصول می‌شود. 🚀
اما اگر احساس امنیت نداشته باشند، همیشه محافظه‌کارانه عمل می‌کنند، از ایده‌های جدید فاصله می‌گیرند و فقط کاری را انجام می‌دهند که مطمئن هستند بابتش مورد قضاوت قرار نمی‌گیرند.
در نهایت، کیفیت یک تیم را فقط مهارت‌های فنی اعضایش تعیین نمی‌کند؛ بلکه محیطی که رهبر آن تیم می‌سازد نیز به همان اندازه مهم است.
❓ اگر مسئول هدایت یک تیم هستید، وقتی یکی از اعضای تیمتان اشتباه می‌کند، اولین واکنش شما چیست؟
Post #706 416
📚 مسیر یادگیری یک برنامه‌نویس NET. در هر سطح

بیشتر توسعه‌دهنده‌ها نمی‌دانند در هر مرحله از مسیر حرفه‌ای خود باید روی چه موضوعاتی تمرکز کنند. به همین دلیل ممکن است سال‌ها تجربه داشته باشند، اما هنوز برای موقعیت‌های Senior یا Architect آماده نباشند.

اگر بخواهم مسیر یادگیری یک برنامه‌نویس NET. را به چهار مرحله تقسیم کنم، این نقشه راه را پیشنهاد می‌دهم:
1️⃣ Junior Developer

در این مرحله هدف، یادگیری اصول برنامه‌نویسی و ساخت پروژه‌های واقعی است.

✅ C# Syntax, Types & OOP
✅ Collections & Basic LINQ
✅ Async/Await Basics
✅ Exception Handling
✅ Building Basic APIs with Controllers & EF Core
✅ Configuration with appsettings.json
✅ Git Basics & IDE Debugging

2️⃣ Middle Developer

در این مرحله دیگر فقط کدنویسی مهم نیست؛ باید یاد بگیرید چرا یک راه‌حل از راه‌حل دیگر بهتر است.

✅ Advanced LINQ, IQueryable vs IEnumerable
✅ Async/Await, CancellationToken & Deadlocks
✅ EF Core Migrations, Relationships & Query Performance
✅ SOLID Principles & Common Design Patterns
✅ Clean Architecture & Layered Architecture
✅ Authentication & Authorization
✅ Middleware, Filters & Model Binding
✅ Validation, Mapping & Dependency Injection
✅ Scheduling & Caching
✅ Structured Logging
✅ Integration Testing
✅ Docker & Containerization

3️⃣ Senior Developer

در این سطح تمرکز روی طراحی سیستم‌های قابل اعتماد، مقیاس‌پذیر و قابل نگهداری است.

✅ Performance, Memory & Allocation Profiling
✅ Concurrency, Threading & Thread Safety
✅ Distributed Systems Fundamentals
✅ RabbitMQ, Kafka & Azure Service Bus
✅ Resilience with Polly (Retry & Circuit Breaker)
✅ OpenTelemetry (Metrics, Tracing & Observability)
✅ CQRS & Event-Driven Architecture
✅ Database Transactions & Concurrency Control
✅ Security Best Practices (OWASP & Secret Management)
✅ CI/CD Pipelines & Cloud Deployment
✅ Domain Modeling & DDD Tactical Patterns
✅ Code Review & Mentoring
✅ Trade-off Analysis & Technology Selection
✅ Modular Monolith & Service Boundaries

4️⃣ Software Architect

در این مرحله دیگر مسئله فقط نوشتن کد نیست؛ بلکه طراحی سیستم‌هایی است که سال‌ها قابل توسعه و نگهداری باشند.
✅ System Design (Scalability, Availability & Reliability)
✅ Monolith vs Modular Monolith vs Microservices vs Serverless
✅ Strategic DDD (Bounded Context & Context Mapping)
✅ Consistency, Idempotency & Saga Pattern
✅ Data Architecture, Event Sourcing & Polyglot Persistence
✅ CAP Theorem & PACELC Trade-offs
✅ Zero Trust Security & Identity
✅ Non-Functional Requirements (NFRs) & Quality Attributes
✅ ADRs (Architecture Decision Records) & C4 Model
✅ Migration & Modernization Strategy
✅ Standards, Guardrails & Governance
✅ Business-Driven Architecture
✅ Conway's Law & Team Topologies
✅ Stakeholder Communication & Trade-off Analysis
✅ Cloud Cost Optimization
✅ Platform Engineering & Developer Experience (DevEx)
✅ Disaster Recovery & Business Continuity
✅ Multi-Tenancy & Data Isolation Patterns

🎯 نکته مهم

این مسیر یک نردبان نیست که بعد از رسیدن به مرحله بعدی، مطالب قبلی را کنار بگذارید.
هرچه جلوتر می‌روید، عمق دانشتان در موضوعات قبلی بیشتر می‌شود و مفاهیم جدیدی به آن اضافه می‌کنید.
یک Architect خوب، هنوز هم #C را عمیق می‌شناسد؛ فقط نگاهش از «نوشتن کد» به «طراحی سیستم» تغییر کرده است.
Post #704 426
در یکی از پروژه‌ ها، قرار بود یک قابلیت جدید به سیستم اضافه کنیم.
یکی از اعضای تیم گفت:
«اگر از همین الان این بخش را Generic طراحی کنیم، بعدا برای چند سناریوی دیگر هم قابل استفاده است.»
پیشنهاد جذابی بود. شروع کردیم به طراحی. Interface اضافه شد. چند لایه Abstraction ایجاد شد. تنظیمات مختلف اضافه شدند.
قابلیتی که قرار بود در دو روز آماده شود، نزدیک دو هفته زمان برد.
چند ماه بعد، برگشتیم و نگاهی به آن بخش انداختیم.
از تمام سناریو هایی که برای آینده پیش‌ بینی کرده بودیم، فقط همان سناریوی اول استفاده شده بود.
بقیه هیچ‌ وقت اتفاق نیفتادند.آن روز یک درس مهم گرفتم.
بزرگ‌ ترین خطر در طراحی نرم‌ افزار، همیشه «طراحی ضعیف» نیست.
گاهی «طراحی برای آینده‌ ای است که هنوز وجود ندارد.»
از آن به بعد، هر وقت وسوسه میشوم چیزی را بیش از نیاز امروز Generalize کنم، از خودم یک سوال میپرسم:
«اگر این نیاز هیچ‌ وقت به وجود نیاید، آیا باز هم حاضر بودم هزینه امروز را پرداخت کنم؟»
خیلی وقت‌ها جواب، «نه» است.
و همان «نه»، باعث میشود سیستم ساده‌ تر بماند.
چون تجربه به من یاد داد که آینده، همیشه آن‌طور که ما طراحی میکنیم پیش نمیرود.
اما پیچیدگی‌ ای که امروز وارد سیستم میکنیم، همین امروز شروع به گرفتن هزینه میکند.
Post #703 425
Post #702 442
کانال یک برنامه نویس تنبل

🔥لینوکس
🔥برنامه نویسی فرانت‌اند
🔥برنامه نویسی بک‌اند
🔥اخبار تکنولوژی و...

@TheRaymondDev
Post #701 429
گاهی فکر می‌کنیم دلیل اینکه یک توسعه‌دهنده بعد از چند سال بهتر می‌شود، این است که تکنولوژی‌های بیشتری یاد گرفته است.
اما همیشه این‌طور نیست.یک اتفاق مهم‌تر هم می‌افتد.
کم‌کم یاد می‌گیرد به هر مشکلی جواب ندهد.
اوایل مسیر، وقتی یک مشکل می‌بینی، اولین واکنش این است:
«باید سریع یک راه‌حل پیدا کنم.»
اما بعد از چند سال، واکنش تغییر می‌کند.
اول می‌پرسی:
«اصلاً مطمئنیم این همان مسئله‌ای است که باید حل شود؟»
جالب است که در خیلی از پروژه‌ها، ساعت‌ها صرف حل کردن مسئله‌ای می‌شود که از ابتدا، مسئله اصلی نبوده است.
ءQuery را بهینه می‌کنیم.بعد می‌فهمیم گلوگاه، شبکه بوده است.
ءCaching اضافه می‌کنیم.بعد مشخص می‌شود مشکل از طراحی درخواست‌ها بوده است.
ءService جدید می‌نویسیم.بعد می‌بینیم با حذف یک وابستگی، کل مسئله حل می‌شد.
به مرور متوجه می‌شوی ارزش یک مهندس، فقط به تعداد راه‌حل‌هایی که بلد است نیست.
به تعداد مسئله‌هایی است که قبل از شروع، درست تشخیص می‌دهد. چون در مهندسی نرم‌افزار،اشتباه‌ترین جواب، جواب اشتباه به یک سؤال درست نیست.
جواب کاملاً درست به یک سؤال اشتباه است.
Post #700 297

Forwarded from thisisnabi.dev [Farsi]

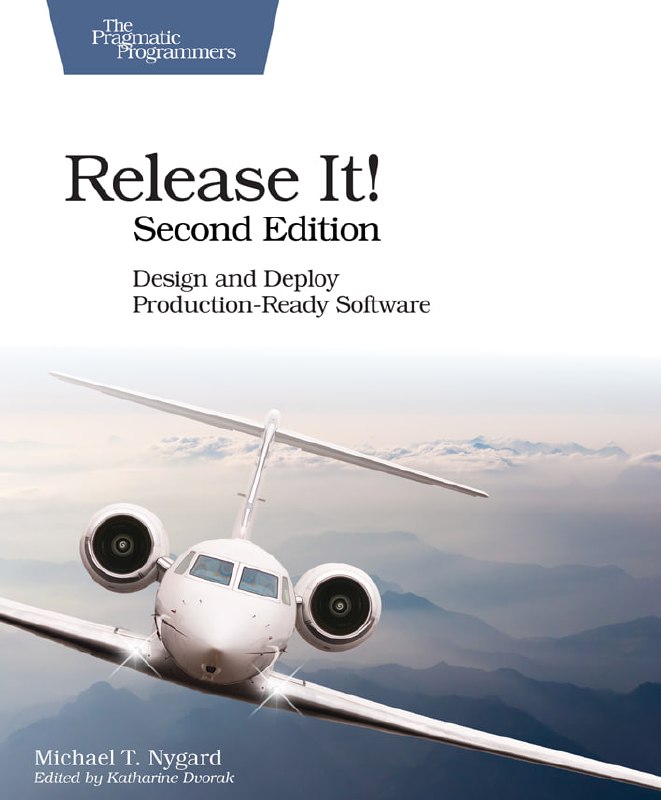
کتاب خوب بخونیم.

این کتابه کمی گم هست و کم دیدم در موردش صحبت کنن، ولی واقعا کتاب خوبی هست. دیشب توی میت های 10x developer معرفیش کردم، گفتم اینجا هم برای شما هم بذارمش شاید کسی علاقه داشت بخوندش.

کلا این سری کتاب های pragmatic خیلی ارزش خوندن دارن و نگاه آدم رو نسبت به موضوعی که قرار هست مطرح کنن، تغییر می دن.

@thisisnabi_dev
Post #699 324

Forwarded from Learning With M

دستور مصرف: هر صبح، حداقل یک بار بلافاصله بعد از بیدار شدن از خواب

پ.ن: الان تو کدوم ظرف برنجیم؟
یا شاید ظرف ها؟
Post #698 356
"صرفا فقط برای اینکه لیبل خارج خورده روش"😑
Post #697 1.35K
#مهندس_فکر_کن
قسمت:4️⃣

🎯مصاحبه‌کننده:
ءCache Stampede چیست؟
فرض کن یک کلید در Cache داری:
Product:123

و TTL آن 5 دقیقه است.
در لحظه‌ای که این کلید منقضی می‌شود، همزمان 5000 درخواست برای همان محصول می‌آید.
اتفاقی که می‌افتد:
Client 1 ----\
Client 2 -----\
Client 3 -------> Cache Miss
Client 4 -----/
Client 5 ----/
...
5000 Requests

همه همزمان Cache Miss می‌خورند.
سپس همه به Database می‌روند.
5000 Query
↓
Database

در نتیجه Database Overload، افزایش شدید Latency ،احتمال Down شدن سرویس.
به این حالت Cache Stampede می‌گویند.

حالا بگو ببینم برای حل این مشکل چه راهکار هایی میدی؟🤔
Post #696 322
Post #695 359
تا حالا دقت کرده‌ای چرا بعضی کتابخانه‌ها این‌قدر آرام هستند؟
نه به خاطر اینکه کسی آنجا کتاب نمی‌خواند.
به خاطر اینکه هر کتاب، جای مشخصی دارد.
اگر دنبال کتابی باشی، لازم نیست از ده نفر سؤال بپرسی.
لازم نیست حدس بزنی کدام قفسه مناسب است.
همه چیز بر اساس یک نظم مشخص پیدا می‌شود.
حالا یک پروژه نرم‌افزاری را تصور کن که بعد از چند سال توسعه، هر کلاس می‌تواند هر چیزی را صدا بزند.
هر ماژول به هر ماژول دیگری وابسته است.
برای تغییر یک قابلیت ساده، باید پنج بخش مختلف را بررسی کنی.
پروژه هنوز کار می‌کند.
اما دیگر شبیه کتابخانه نیست.
بیشتر شبیه انباری است.
انباری که همه چیز داخل آن هست.
اما پیدا کردن هر چیزی، زمان می‌برد.
جالب اینجاست که هیچ پروژه‌ای از روز اول انباری نبوده است.
فقط هر بار یک وابستگی کوچک اضافه شده.
یک میانبر دیگر.
یک دسترسی مستقیم دیگر.
تا جایی که مرزها از بین رفته‌اند.
در مهندسی نرم‌افزار،معماری فقط برای این نیست که سیستم امروز کار کند.
برای این است که شش ماه بعد،هنوز بدانی هر چیز دقیقاً باید کجا باشد.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →