TGViewer
Channel Public Channel
مهندسی و علم داده

مهندسی و علم داده

@bimining

در مورد ادمین کانال :
- محمد عالیشاهی
- دکترای هوش مصنوعی دانشگاه تهران
- مدیر ارشد پروژه های هوش مصنوعی و علم داده
-دبیر شورای حکمرانی داده انجمن هوش مصنوعی ایران
Subscribers
3.98K
Photos
393
Videos
174
Links
113
Recent Posts 20 shown
Post #1313 663
مهندسی و علم داده چطور ClickHouse روی 100 میلیون رکورد Query اجرا می‌کند، بدون اینکه 100 میلیون رکورد را بخواند؟ وقتی صحبت از Performance در سیستم‌های تحلیلی می‌شود، معمولاً ذهنمان می‌رود سمت: • CPU • RAM • سرعت Disk اما در ClickHouse یک سؤال مهم‌تر وجود دارد: چقدر از داده…
نکته مهم همین‌جاست:

100M Records ≠ 100M Records Read

به همین دلیل:

• Partitioning
• ORDER BY
• Data Layout

در ClickHouse فقط تصمیم‌های مربوط به Storage نیستند؛ مستقیماً روی Performance Query اثر می‌گذارند.

پس وقتی یک Query کند است، قبل از اینکه سراغ CPU و RAM برویم، بهتر است یک سؤال ساده بپرسیم:

«چرا این همه داده دارد خوانده می‌شود؟»

در بسیاری از سیستم‌های تحلیلی، سریع‌تر شدن Query از پردازش بیشتر شروع نمی‌شود؛ از خواندن کمتر داده شروع می‌شود.
Less Data Read → Less I/O → Less CPU Work → Faster Query

@BIMining
  • ❤ 10
  • 👍 5
  • 👏 2
  • 🔥 1
Post #1312 632
چطور ClickHouse روی 100 میلیون رکورد Query اجرا می‌کند، بدون اینکه 100 میلیون رکورد را بخواند؟

وقتی صحبت از Performance در سیستم‌های تحلیلی می‌شود، معمولاً ذهنمان می‌رود سمت:

• CPU
• RAM
• سرعت Disk

اما در ClickHouse یک سؤال مهم‌تر وجود دارد:

چقدر از داده واقعاً لازم است خوانده شود؟

فرض کنید Query فقط به اطلاعات 24 ساعت اخیر و چند Column مشخص نیاز دارد.

و ClickHouse قرار نیست کل داده را بخواند و بعد دنبال رکوردهای موردنظر بگردد.

در این فرآیند:

• ابتدا Partitionهای نامرتبط حذف می‌شوند.
• سپس Partهای غیرضروری کنار گذاشته می‌شوند.
• با Data Skipping و Metadata، بخش‌هایی که احتمالاً هیچ Matchای ندارند Skip می‌شوند.
• به دلیل Columnar Storage، فقط Columnهای موردنیاز خوانده می‌شوند.
• و Compression حجم I/O را کاهش می‌دهد.
• در نهایت Vectorized Execution داده‌ها را به‌صورت Batch پردازش می‌کند.

مسیر اجرای Query می‌تواند چیزی شبیه این باشد:

100M Records → Pruning → Data Skipping → Required Columns → Execution → Result

@BIMining
  • ❤ 9
  • 👍 7
  • 🔥 1
Post #1311 1.05K
قراردادی برای اینکه داده، قابل اعتماد بماند؛ Data Contract.

در یک سیستم داده، ممکن است یک تیم بدون اطلاع تیم‌های دیگر ساختار یا معنای یک فیلد را تغییر دهد؛ Pipeline هم شاید همچنان سبز باشد، اما خروجی Dashboard یا مدل ML دیگر درست نباشد.

در چنین شرایطی، Data Contract انتظارات را از قبل مشخص می‌کند: ساختار داده، معنا، کیفیت، Freshness، مالکیت و قوانین تغییرات.

در واقع، می‌توان Data Contract را مثل یک API برای داده‌ها در نظر گرفت؛ یک توافق مشخص بین کسی که داده را تولید می‌کند و تیم‌هایی که به آن داده وابسته‌اند.

نکته مهم اینجاست که Data Contract فقط مستندات نیست؛ می‌تواند به‌صورت machine-readable تعریف شود و بخشی از کنترل‌های کیفیت و CI/CD را به‌صورت خودکار اجرا کند.

در نهایت، داده خوب فقط داده‌ای نیست که منتقل می‌شود؛ داده‌ای است که می‌دانیم قرار است چه تعهداتی را برآورده کند.

@BIMining
  • 👍 9
  • ❤ 2
Post #1310 1.51K
۵ الگوی معماری داده برای ۲۰۲۶
بحث ابزار نیست، بحث الگوست. الگوی غلط = خط لولهٔ مرده.
۱. لامبدا — دسته‌ای + جریانی
↳ کاربرد: دقت تاریخی + تازگی بی‌درنگ
↳ هزینه: ۲ خط لوله = پیچیدگی دوبرابر
↳ مثال: تبلیغات دیجیتال
۲. کاپا — فقط جریانی
↳ کاربرد: وقتی جریانی به بلوغ کافی رسیده
↳ هزینه: بازپردازش سخت‌تر، عملیات ساده‌تر
↳ مثال: تشخیص تقلب، IoT
۳. مدالیون — برنز→نقره→طلا
↳ کاربرد: دریاچه‌خانه (Databricks, Snowflake, BigQuery)
↳ هزینه: ۳× هزینه، اما کیفیت عالی
↳ مثال: Databricks مدرن
۴. مش داده — غیرمتمرکز، هر حوزه مالک داده
↳ کاربرد: تیم‌های متعدد، پلتفرم مرکزی گلوگاه
↳ هزینه: تغییر سازمانی سنگین
↳ مثال: Netflix, Zalando
۵. معماری Lakehouse دریاچه + انبار
↳ کاربرد: SQL انبار با هزینهٔ دریاچه
↳ هزینه: اکوسیستم در حال بلوغ
↳ مثال: Databricks, Snowflake, BigLake

@BIMining
  • 👍 6
  • ❤ 3
Post #1309 3.35K
ابزار dbt (Data Build Tool) در حال تسخیر دنیای مهندسی داده است. در ادامه لینک قیلمهای آموزشی در سال ۲۰۲۶ به شرح ذیل اعلام میگردد:
1. دوره جامع dbt (Data Build Tool) | از مبتدی تا پیشرفته | گام به گام
🔗 https://lnkd.in/gHVpEXZf

۲. دوره فشرده dbt برای مبتدیان | از صفر تا قهرمان در dbt Core
🔗 https://lnkd.in/g5e_R9DB

۳. راهنمای جامع dbt به همراه CI/CD | آموزش کامل ۵ ساعته
🔗 https://lnkd.in/gGNsGF_n

۴. تحلیل داده‌های نتفلیکس | آموزش پروژه محور و سرتاسری (End-to-End) با dbt
🔗 https://lnkd.in/gZwqh_-y

۵. از مبتدی تا حرفه‌ای در dbt | خط لوله (Pipeline) سرتاسری با Airflow + Snowflake
🔗 https://lnkd.in/gf7npsyp

۶. پروژه سرتاسری بازار بورس | Snowflake + dbt + Airflow
🔗 https://lnkd.in/gcDeGrbp

۷. پروژه مهندسی داده Airbnb | دیتابیس dbt + Snowflake + AWS (شش ساعت)
🔗 https://lnkd.in/g-yivU55

۸. سوالات و جواب‌های مصاحبه dbt | آمادگی برای مصاحبه dbt + Snowflake
🔗 https://lnkd.in/gxthsqPv
  • ❤ 7
  • 👍 2
  • 🙏 1
Post #1308 4K
معماری مدالیون(Medallion Architecture)، سیر تحول داده‌ها را از حالت خام اولیه تا نسخه‌ای که آمادهٔ پشتیبانی از تصمیم‌گیری است، سازماندهی می‌کند.

لایهٔ برنز (Bronze)، فایل‌ها، رویدادها و رکوردها را دقیقاً به همان صورتی که از سیستم‌های مبدأ دریافت می‌شوند، حفظ می‌کند. این لایه، سطحی از جزئیات را نگهداری می‌کند که برای ردیابی خطاها و بازسازی فرایندها ضروری است.

لایهٔ نقره (Silver)، داده‌ها را پالایش، استانداردسازی، پاکسازی (deduplicate) و اعتبارسنجی می‌کند. در این مرحله، فرمت‌ها اصلاح، کدها یکسان‌سازی و بررسی‌های کیفی روی داده‌ها اعمال می‌شوند.

لایهٔ طلا (Gold)، قوانین کسب‌وکار را به داده‌ها اضافه کرده و جداول، معیارها و محصولات داده‌ای را برای داشبوردها، تحلیل‌ها و مدل‌های پیش‌بینی آماده می‌سازد.

@BIMining
  • 👍 4
  • ❤ 1
Post #1307 3.57K
در سال ۲۰۲۶، رویکرد اصلی در دیتا انجینیرینگ ELT است، نه ETL قدیمی.


- روش قدیمی (ETL): اول دیتا رو تبدیل (Transform) میکردی بعد بارگذاری (Load) میکردی، چون انبارهای داده قدیمی فقط دیتای ساختاریافته قبول میکردند.
- تغییر بزرگ: انبارهای مدرن مثل Snowflake و BigQuery الان دیتای نیمه‌ساختاریافته (مثل JSON) و بدون ساختار (مثل لاگ) رو هم قبول میکنند. نیازی به تبدیل قبلی نیست.
- روش جدید (ELT): اول دیتا رو بارگذاری خام (Load) میکنی، بعد با DBT تبدیل (Transform) انجام میدی. سریع‌تر، ساده‌تر و ارزان‌تر.
- چرا DBT مهم شده؟ تو اکثر آگهی‌های شغلی دیتا انجینیرینگ هست، SQL رو به یک فرآیند مهندسی نرم‌افزار تبدیل کرده (کنترل نسخه، تست، مستندات).
- کی هنوز ETL بهتره؟ توی خطوط بلادرنگ (مثل Kafka → Flink)، تبدیل‌های سنگین غیر SQL، یا سیستم‌های قدیمی که عوض کردنشان هزینه‌بالایی دارد.

نتیجه نهایی: پیش‌فرض ۲۰۲۶ برای اکثر پروژه‌ها، ELT با DBT است، اما بسته به نیاز خاص خودت انتخاب کن.

@BIMining
  • 🙏 4
  • ❤ 2
Post #1306 5.26K
🔺ورود چین به عصر ایجنت‌های هوش مصنوعی

🔹شرکت چینی بایت‌ دنس با معرفی مدل Doubao 2.0 رسماً به عصر ایجنت‌ها وارد شده و تلاش دارد جایگاه خود را در بازار رقابتی هوش مصنوعی حفظ کند. این مدل فراتر از یک چت‌بات است و برای انجام وظایف پیچیده دنیای واقعی طراحی شده است. نسخه Pro آن با مدل‌هایی مانند OpenAI و گوگل رقابت می‌کند.
🔹بایت‌دنس می‌گوید هزینه استفاده از Doubao 2.0 حدود ۱۰ برابر کمتر از رقبا است و این موضوع برای پردازش‌های پرمصرف مزیت مهمی به شمار می‌رود. این شرکت پس از غافلگیری از ظهور DeepSeek حالا می‌خواهد از تکرار آن تجربه جلوگیری کند. در بازار چین، Doubao با ۱۵۵ میلیون کاربر هفتگی در صدر قرار دارد و سایر رقبا نیز با سرعت در حال رشد هستند.

@BIMining
  • ❤ 5
  • 👍 1
Post #1305 5.31K
در پشت صحنۀ پلتفرم‌هایی که هر روز مورد استفاده قرار می‌گیرند، همواره این پرسش مطرح بوده است که چه رویدادهایی رخ می‌دهد. همچنین، این سؤال مطرح می‌شود که پلتفرم‌های مشهور جهان با چه زبان‌هایی ساخته شده‌اند.


@BIMining
  • 👍 8
Post #1304 4.36K
تحلیل داده ترکیبی متعادل از مبانی اصلی و مهارت‌های پشتیبان است.

🔹اسکریپت SQL ستون فقرات تحلیل (31%)
داده‌های کسب‌وکار عمدتاً در پایگاه‌داده‌ها ذخیره می‌شوند. تسلط بر SQL برای استخراج، پاکسازی و تبدیل داده ضروری است.
🔹 ابزارهای BI (15%)
ابزارهایی مثل Power BI یا Tableau داده‌های خام را به داستان‌های قابل‌فهم برای ذینفعان تبدیل می‌کنند.
🔹ابزار Excel (14%)
از تحلیل سریع تا گزارش‌گیری، Excel هنوز یک ابزار روزمره در سازمان‌هاست. یادگیری فرمول‌ها، پیوت‌ها و پاکسازی داده بسیار مفید است.
🔹زبان برنامه نویسی پایتون (14%)
پایتون از تحلیل‌های پیچیده، خودکارسازی و کار با حجم بزرگ داده پشتیبانی می‌کند.
🔹زبان R (10%)
اغلب در نقش‌های پژوهشی یا آماری استفاده می‌شود و برای مدل‌سازی عمیق مناسب است.
🔹ابزار و فرایند ETL (11% در مجموع)
درک جریان داده ETL و مبانی آماری، صحت و قابلیت اطمینان بینش‌ها را تضمین می‌کند.
🔹 کنترل نسخه، NoSQL، SAS مهارت‌های تکمیلی (%5 در مجموع)
این ابزارها در محیط‌ها و پروژه‌های خاص، به‌ویژه در مقیاس بزرگ، ارزش افزوده دارند.
@BIMining
  • 👍 9
  • 👏 3
  • ❤ 1
Post #1303 3.44K
برگزاری پنل هوش مصنوعی با عنوان
سنجش داده تا سناریوسازی ،زیرساخت های فناورانه،داده کاوی و طراحی مدل های پیش بینی با هوش مصنوعی

دوشنبه 24 آذرماه 1404 پاویون هوش مصنوعی مصلی امام خمینی
ساعت 11-12:15

@BIMining
  • 👏 2
  • 👍 1
Post #1302 5.95K
✅نتفلیکس هر روز ۵ پتابایت لاگ (۱۰.۶ میلیون رویداد در ثانیه) را با ClickHouse پردازش می‌کند و نتایج را در کمتر از ۱ ثانیه برمی‌گرداند – مناسب برای ۴۰ هزار سرویس کوچک و ۳۰۰ میلیون کاربر.

📕سه ترفند کلیدی نتفلیکس
۱. ارسال سریع داده‌ها: به جای روش معمولی JDBC، کد مخصوص ساختند که داده‌ها را فشرده (LZ4) و با پروتکل native می‌فرستد. نتیجه: CPU و RAM کمتر، سرعت بیشتر از روش‌های آماده.

۲. گروه‌بندی لاگ‌ها بدون تأخیر: regex جستجوی متنی پیچیده را با lexer کامپایل‌شده (JFlex) جایگزین کردند – ۸–۱۰ برابر سریع‌تر، چون regex در ۱۰ میلیون رویداد در ثانیه قفل می‌کند.

۳. جستجوی سریع در برچسب‌ها: برچسب‌ها مثل ID سرویس را در ۳۱ جدول کوچک با LowCardinality تقسیم کردند به جای یک map بزرگ . زمان جستجو از ۳ ثانیه به ۰.۷ ثانیه رسید.
✅ کاربرد برای بانک‌ها
داده‌های تازه (hot tier) در ClickHouse، داده‌های قدیمی در Iceberg، و API هوشمند. برای ۴۰ میلیون تراکنش روزانه بانکی، همین ترفندها (ارسال سریع + schema بهینه + تقسیم داده) کلید fraud detection و تحلیل realtime است.

@BIMining
  • 👍 11
  • ❤ 2
Post #1301 4.03K
ابزار ClickGraph v0.5.2 ؛ وقتی ClickHouse به یک موتور گراف تحلیلی تبدیل می‌شود:

تحلیل گرافی سال‌ها در قلمرو دیتابیس‌هایی مثل Neo4j بود؛ اما در سازمان‌هایی که همه‌چیز روی ClickHouse متمرکز است، انتقال داده به یک موتور جداگانه هزینه و ریسک بالایی دارد. ClickGraph برای همین متولد شده است: یک لایه تحلیلی گراف، سبک و stateless که روی ClickHouse سوار می‌شود، کوئری‌های Cypher را به SQL بهینه ترجمه می‌کند و آن‌ها را مستقیماً روی همان داده‌های موجود اجرا می‌کند؛ یعنی بدون مهاجرت داده، می‌توان یک دید گرافی قدرتمند از داده‌های ستونی ساخت و از اکوسیستم Neo4j مثل درایورها، cypher-shell، Browser و Bolt 5.8 استفاده کرد، در حالی که اجرا روی ClickHouse می‌ماند.
نسخه 0.5.2 روی همین ایده سوار است و آن را به بلوغ اینترپرایزی نزدیک کرده: پشتیبانی از الگوهای پیچیدهٔ اسکیمای گراف از پلی‌مورفیک تا denormalized و coupled edges، بهینه‌سازی مسیرهای چندمرحله‌ای و حفظ هم‌خوانی با ابزارهای Neo4j در کنار معماری سبک و تست‌شده، با تمرکز بر انعطاف در مدل‌سازی گراف و پرفورمنس قابل‌اتکا روی دیتاست‌های بزرگ.
@BIMining
  • 👍 4
Post #1300 3.44K
📚 6 کتابخانه برتر AutoML برای پروژه‌ها

1️⃣ کتابخونه FLAML

💬 ساخت مایکروسافته و کلی وظیفه مثل دسته‌بندی و رگرسیون رو خودش سریع انجام می‌ده. فقط با چند خط کد!

2️⃣ کتابخونه PyCaret

💬 از صفر تا صد مدل‌سازی رو برات آسون می‌کنه. با این کتابخونه، راحت مدل آموزش می‌دی و خروجی می‌گیری.

3️⃣ کتابخونه MLJAR-Supervised

💬 کافی یه دیتا بهش بدی، خودش بهترین مدل رو با هوشمندی انتخاب و آموزش می‌ده؛ مهندسی ویژگی هم داره.

4️⃣ کتابخونه AutoGluon

💬 ساخت AWS و می‌تونی باهاش دیتای جدولی و سری زمانی رو هندل کنی و مدل‌های پایه رو هم فاین‌تون کنی.

5️⃣ کتابخونه AutoViML

💬 با حداقل ویژگی‌ها بهترین مدل رو پیدا می‌کنه و دیتا رو هم تمیز و آماده می‌کنه.

6️⃣ کتابخونه AutoKeras

💬 بر پایه Keras و برای کار با تصویر و متن خیلی کاربردیه.
@BIMining
  • 👍 6
  • ❤ 2
Post #1299 6.62K
سخنرانی با عنوان افزایش کارایی هوش مصنوعی با معماری توزیع شده کلیک هاوس
در الکامپ تاکز

@BIMining
  • 👍 6
  • ❤ 1
Post #1298 4.68K
📢 تحولی بزرگ در دنیای داده‌ها!

قدرت Chat-GPT با قدرت ClickHouse همگام شد!

🌐 بالاخره بعد از ماه‌ها تلاش بی‌وقفه، موفق به تلفیق قدرتمند هوش مصنوعی Chat-GPT با کلاستر ClickHouse شدیم. این دستاورد یک قدم بزرگ در مسیر دموکراتیک‌سازی دسترسی به داده‌هاست و ارائه گزارشات هوشمند را به سطح کاملاً جدیدی می‌برد.

💡 تحول عظیم در ارائه گزارشات هوشمند
دیگر نیازی به دانش فنی عمیق یا نوشتن کوئری‌های پیچیده نیست. با این تلفیق بی‌نظیر، شما می‌توانید تنها با استفاده از زبان طبیعی و یک جمله ساده، دقیق‌ترین و عمیق‌ترین گزارشات را از داده‌های خود استخراج کنید.

گزارشات مبتنی بر زبان طبیعی: کافیست سوال خود را به زبان ساده بپرسید: "بیشترین فروش ماه گذشته مربوط به کدام محصول بود؟" یا "عملکرد فروش در منطقه شمال شرق نسبت به سال قبل چگونه است؟" و سیستم، فوراً پاسخ را به صورت یک گزارش دقیق به شما ارائه می‌دهد.

سرعت بی‌نظیر: ClickHouse به عنوان موتور تحلیل داده، با سرعت فوق‌العاده بالا به پردازش میلیون‌ها و میلیاردها ردیف داده می‌پردازد و اطمینان می‌دهد که پاسخ شما در لحظه آماده است.
بزودی اطلاعات تکمیلی در همین کانال....
@BIMining
  • 👍 8
  • ❤ 4
  • 👏 1
Post #1297 5.23K
🎓 ۱۴ ابزار هوش مصنوعی برتر که هر پژوهشگر باید در سال ۲۰۲۵ بشناسد
🔍 ۱. شناسایی خلأهای تحقیق
https://lnkd.in/dX9eJ9Tk

2📝-کمک در نگارش مقاله و افزودن منابع
https://lnkd.in/dikYmxEF

🎧 ۳ – تبدیل مقاله‌های پژوهشی به فایل صوتی
https://lnkd.in/dJUE375U

📚 ۴– یاری‌رسان در نگارش مقاله و پایان‌نامه
https://lnkd.in/d6mWCJQb

🔄 ۵– بازنویسی متن و بهینه‌سازی مسیر تحقیق
https://lnkd.in/d-PpN6Rh

📊 ۶ – تحلیل داده و تولید نمودارهای حرفه‌ای
https://lnkd.in/dEqebz8v

🚫 ۷– شناسایی سرقت ادبی و محتوای تولیدشده با AI
https://lnkd.in/dPzsVcqD

📖 ۸ – استخراج داده از مقالات برای مرور ادبیات
https://lnkd.in/d_rDXkNU

🧠 ۹– کشف و تحلیل مقالات برای چارچوب نظری
https://lnkd.in/db3vttW9

🔍 ۱۰– ویرایش گرامری و نگارشی مقاله
https://lnkd.in/dwQsyXVV

🧾 ۱۱– خلاصه‌سازی چند مقاله برای یافتن خلأ پژوهشی
https://lnkd.in/dKN3Yyxn

🎓 ۱۲– ارزیابی کیفیت پایان‌نامه
https://lnkd.in/dFrzuY25

🧭 ۱۳ – تجسم ایده‌ها و ایجاد ارتباط بین مفاهیم
https://lnkd.in/d4Q4pxS8

🗣 ۱۴– بازخورد انسانی برای مقاله‌ها
https://www.review-it.ai

@BIMining
  • 👍 4
  • 🙏 1
Post #1296 3.04K
مقایسه پلتفرم های بیگ دیتا CLICKHOUSE ، Apache Druid , Apache Doris بر اساس سایت معتبر DBEngines

ClickHouse :
به وضوح بر کارایی فوق‌العاده بالا و پردازش کوئری‌های OLAP با حداقل زمان ممکن تمرکز دارد. استفاده از C++ و معماری ستونی (Column-oriented) این امکان را فراهم می‌کند.

نقطه قوت: بهترین عملکرد را برای تجمیع‌های پیچیده و کوئری‌های تحلیلی بر روی داده‌های عظیم ارائه می‌دهد. پشتیبانی گسترده از زبان‌های برنامه‌نویسی و انواع API، آن را بسیار انعطاف‌پذیر می‌کند.

نقاط متمایز: تنها پلتفرمی است که در این مقایسه قابلیت‌های In-memory و DBaaS (سرویس ابری مدیریت شده) را ارائه می‌دهد و از replication فیزیکی همزمان و غیرهمزمان با پشتیبانی از ذخیره‌سازهای ابجکت بهره می‌برد.

Apache Druid:
به صورت خاص برای کوئری‌های OLAP زیر ثانیه بر روی داده‌های با ابعاد بالا و کاردینالیتی بالا (High Dimensionality & High Cardinality) طراحی شده است.

نقطه قوت: بسیار مناسب برای داده‌های سری زمانی (Time Series Data) و داشبوردهای لحظه‌ای (Real-time Dashboards) که نیاز به پاسخگویی بسیار سریع دارند. موتور اصلی آن جاوا است.
@BIMining
  • 👍 5
  • ❤ 1
Post #1295 3.68K
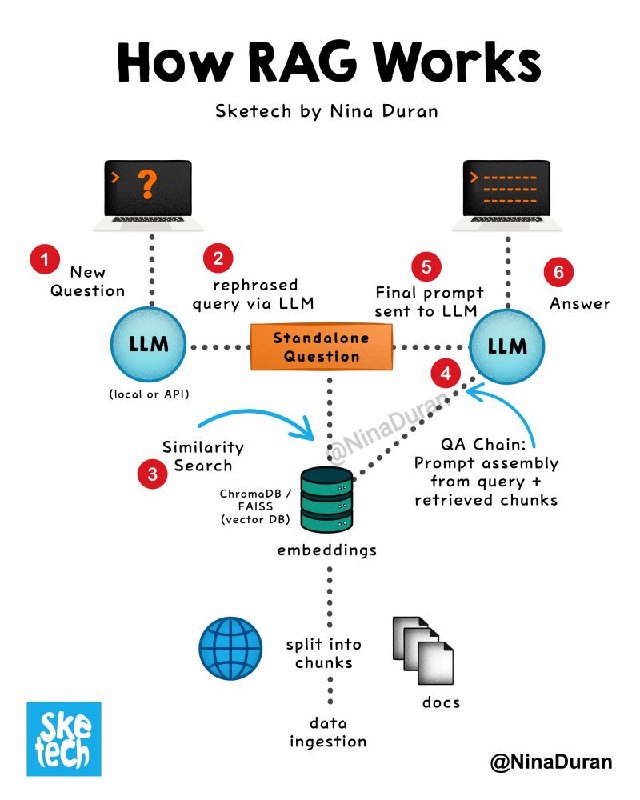
چگونه RAG کار می‌کند:
تولید تقویت‌شده با بازیابی یا RAG به مدل زبان اجازه می‌دهد تا پاسخ‌ها را بر اساس دانش خارجی ارائه دهد، نه فقط آنچه که روی آن آموزش دیده است:
1️⃣ کاربر یک سؤال می‌پرسد.
ممکن است ورودی فاقد زمینه کافی باشد، مثلاً: «آیا امکان خروجی PDF دارد؟»
2️⃣ مدل زبان بزرگ (LLM) سؤال را بازنویسی می‌کند.
با استفاده از تاریخچه گفتگو، سؤال را به یک پرسش مستقل تبدیل می‌کند:
«ویژگی‌های پلن Pro چیست؟ آیا می‌تواند PDF صادر کند؟»
3️⃣ جستجوی معنایی فعال می‌شود.
پرسش مستقل به صورت برداری تبدیل شده و با بخش‌های موجود در اسناد از طریق شباهت برداری مقایسه می‌شود.

4️⃣ پرامپت (ورودی مدل) ساخته می‌شود.
سیستم مرتبط‌ترین بخش‌ها را جمع‌آوری و آنها را در قالب پرامپتی ساختارمند قرار می‌دهد. این مرحله توسط یک زنجیره پرسش و پاسخ (QA Chain) انجام می‌شود که ترکیب می‌کند:
▪️ پرسش مستقل
▪️ زمینه بازیابی شده
▪️ قالب پاسخ
5️⃣ مدل زبان بزرگ پرامپت کامل را با دانش خارجی استدلال کند، حتی اگر روی آن آموزش ندیده باشد.
6️⃣ پاسخ نهایی تولید می‌شود.
پاسخ بر اساس اسناد بازیابی شده است، نه فقط حافظه داخلی مدل.
  • 👍 6
  • ❤ 2
Post #1294 3.01K
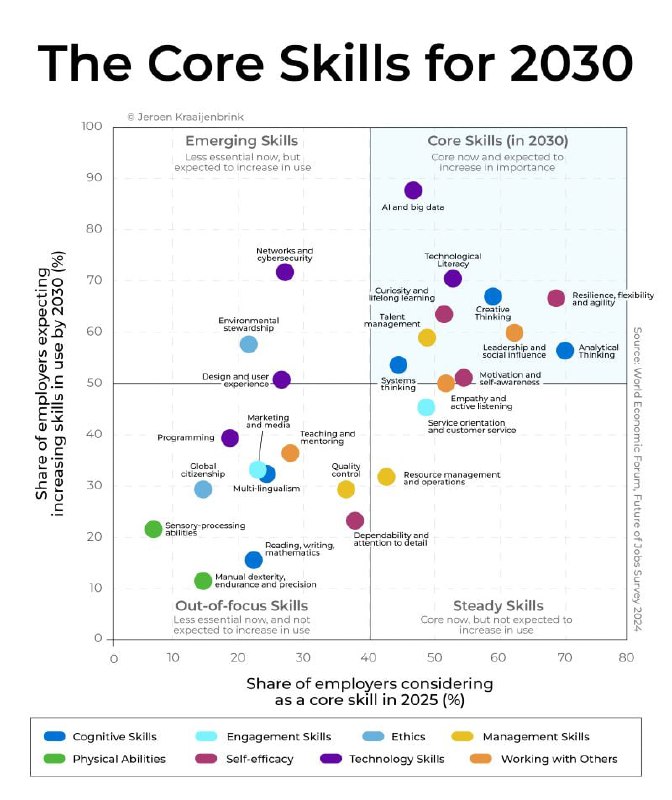
در سال ۲۰۳۰ واقعاً چه چیزی اهمیت خواهد داشت؟
این نمودار یک تغییر چشمگیر را نشان می‌دهد:
راهبرد، سازگاری و تسلط بر فناوری به سرعت در حال رشد هستند ، در حالی که مهارت‌های سنتی مانند کنترل کیفیت، آموزش و حتی برنامه‌نویسی در اولویت پایین‌تری قرار می‌گیرند.
چرا؟ چون هوش مصنوعی در حال بازنویسی قواعد بازی است.
کارفرمایان دیگر فقط به دنبال «مهارت» به معنای سنتی آن نیستند آن‌ها به دنبال افرادی هستند که در این موارد برجسته باشند:
→ تفکر تحلیلی
→ تاب‌آوری، انعطاف‌پذیری و چابکی
→ رهبری و تأثیرگذاری اجتماعی
→ انگیزه و خودآگاهی
→ تفکر خلاق
→ تفکر سیستمی
→ کنجکاوی و یادگیری مادام‌العمر
این دقیقاً همان جایی است که چارچوب شایستگی جدید ما با عنوان «پنج‌گانه بزرگ راهبردی» وارد می‌شود. این فقط یک چارچوب یا مجموعه‌ای از مهارت‌های نرم و سخت نیست—بلکه مجموعه‌ای متمرکز از مهارت‌های قدرت‌مند است که برای دنیای پر از عدم قطعیت و تغییر طراحی شده‌اند.

@BIMining
  • 👌 3
  • ❤ 2
  • 👍 2
Older posts →

About this channel

How can I read @bimining without a Telegram account?
TGViewer shows the public web preview Telegram publishes for مهندسی و علم داده: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does مهندسی و علم داده have?
مهندسی و علم داده (@bimining) has 3.98K subscribers on Telegram, refreshed roughly every 30 minutes.
Does مهندسی و علم داده know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →